PostgreSQL 技术内幕
PostgreSQL 技术内幕
《PostgreSQL 技术内幕》由 Hironobu Suzuki 原著,中文版经正规出版引进。本站以冯若航、刘阳明和张文升完成的 2018 年中文译稿为主体,并持续补译英文原著新增内容。
全书从数据库集簇、进程和查询处理出发,依次进入并发控制、VACUUM、缓冲区、WAL、备份、时间点恢复、物理流复制与逻辑复制。
阅读本书
版本说明
这份中文译稿主体反映 PostgreSQL 9.x 至 11 前后的实现;本站另补译了英文原著后来加入、涉及 PostgreSQL 10 至 19 的章节。第 12 章在英文原著中仍标为 Beta/WIP,PostgreSQL 19相关内容也属于发布前描述。涉及当前 PostgreSQL 行为时,请同时查阅持续更新的英文原著、PostgreSQL 官方文档与源码。
作者序
中国的PostgreSQL用户们,你们好!
本书详细解释了PostgreSQL的内部工作细节,目标读者为DBA与系统开发人员。理解数据库内部机制很有挑战,愿本书能在您精通PostgreSQL的道路上有所助益。
本书能出中文版,我真的感到非常高兴,我这样认为是有原因的。
这是我的书中第一本被翻译成外语的作品。当自己的书出版时,心情愉悦自不必说,而自己的一部作品能翻译成外语出版,更是一件非常令人激动的事情。
其次,我收到了来自世界各地的电子邮件,请求将这本书翻译成各种外语。实际上,至少有一半的邮件来自中国。许多邮件跟我说“这本书对中国PostgreSQL用户很有必要”,因此,我很高兴终于能对他们的要求作出回应。
而最重要的原因与我的家族史有关。先父于多年前去世,他在中国的哈尔滨住过好几年。此后他回到日本,而我出生了。他患心脏病已经很长时间了,因此脾气很差。我对他的印象很差,除了一件事。当我还是孩子的时候,父亲每晚睡觉前都会给我和妹妹讲他在中国的经历。在讲这些时,他总是显得非常高兴,经常说中国人民帮助了他。
他的故事给我留下了深刻的印象,当然也影响了我的人生。因为这些故事,我从小就对这个世界和未知的事物有强烈的好奇心,而我的好奇心也引领我走向软件工程的道路。而现在,我已经在中国出版了我的第一本书。简而言之,这是一个关于日本家庭与中国之间让爱接力传递的故事。
我很高兴终于能把这份情还给中国人民了。当然,这本书是一份很小的礼物。然而,我愿充满感激之情地将它献给您。
2017年,我有幸访问中国,亲眼目睹了中国令人惊叹的发展。对我而言,这是一次非常难忘的经历。我希望能再去中国,如果有机会,我也想在中国工作。
无论如何,让我们享受PostgreSQL吧!
2018年11月
致谢
本书的出版离不开出版社工作人员与译者们巨大的努力与付出,对此我深表感激。
作者
Hironobu Suzuki 日语:鈴木 啓修
我毕业于信息工程研究生院 (信息工程硕士),曾在多家公司担任软件开发人员和技术经理/技术主管。我在数据库和系统集成领域出版了七本书(3本PostgreSQL书和3本MySQL书)。
作为日本PostgreSQL用户组的主任(2010-2016),我连续六年组织了日本规模最大的 (非商业)PostgreSQL技术研讨会,并担任日本2013年PostgreSQL大会的委员会主席,以及2008年和2009年的委员会成员。
当我年轻时,曾在厄瓜多尔住了两年,有时我会回到那里去。
目前我住在爱尔兰,都柏林。
译者序
各位读者你们好,相信能选择这本书的读者,大多已经对PostgreSQL有所了解了。本书从PostgreSQL的整体架构展开,依次介绍了各个功能模块的来龙去脉,对于DBA与数据库系统开发人员了解数据库内部原理,阅读学习PostgreSQL源码是不可多得的一本好书。
数据库是信息系统的核心组件,关系型数据库则是数据库皇冠上的明珠,而PostgreSQL的官方口号是“世界上最先进的开源关系型数据库”。PostgreSQL在各行各业、各种场景下都有着广泛应用。但会用只是“知其然”,知道背后的原理,才能“知其所以然”。对数据库原理及其具体实现的理解,能让架构师以最小的复杂度代价实现所需的功能,能让程序员以最少的复杂度代价写出更可靠高效的代码,也能让DBA在遇到疑难杂症时获得精准的直觉与深刻的洞察。
数据库是一个博大精深的领域,存储、I/O、计算无所不包。PostgreSQL可以视作关系型数据库实现的典范,用不到100万行C代码实现如此丰富的软件系统,可谓凝练无比。它的每一个功能模块都值得用一本甚至几本书的篇幅去介绍。本书限于篇幅,虽无法一一深入所有细节,但它为读者进一步理解PostgreSQL提供了一幅全局概念地图。读者完全可以顺着各章线索,以点带面,深入挖掘源码背后的设计思路。
我偶然发现了这本书,读完之后感觉受益匪浅。这么好的书没有中文翻译,实在是遗憾,遂萌生了翻译的念头。某不才,愿为PostgreSQL在中国的发展贡献一份力量。译者水平有限,翻译如有疏漏,还望读者海涵。
译者
冯若航,刘阳明,张文升
探探 PostgreSQL DBA Team
1 数据库集簇、数据库与数据表
第一章和第二章简单介绍了一些 PostgreSQL 的基础知识,有助于读者理解后续章节的内容。本章包括以下几个主题:
- 数据库集簇(database cluster) 的逻辑结构
- 数据库集簇的物理结构
- 堆表(heap table) 文件的内部布局
- 从表中读写数据的方式
如果你已经熟悉这些内容,可以跳过本章。
1.1 数据库集簇的逻辑结构
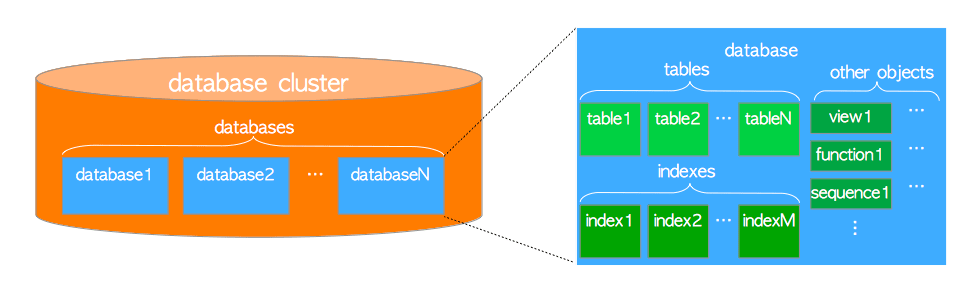
数据库集簇(database cluster)是一组数据库(database) 的集合,由一个PostgreSQL服务器管理。第一次听到这个定义也许会令人疑惑,PostgreSQL中的术语“数据库集簇”,并非 意味着“一组数据库服务器”。 一个PostgreSQL服务器只会在单机上运行并管理单个数据库集簇。
图1.1展示了一个数据库集簇的逻辑结构。 数据库(database) 是 数据库对象(database objects) 的集合。 在关系型数据库理论中,数据库对象是用于存储或引用数据的数据结构。 (堆)表是一个典型的例子,还有更多种对象,例如索引,序列,视图,函数等。 在PostgreSQL中数据库本身也是数据库对象,并在逻辑上彼此分离。 所有其他的数据库对象(例如表,索引等)归属于各自相应的数据库。
在 PostgreSQL 内部,所有的数据库对象都通过相应的 对象标识符(Object Identifiers, OID) 进行管理,这些标识符是无符号的4字节整型。数据库对象与相应OID之间的关系存储在相应的系统目录中,依具体的对象类型而异。 例如数据库和堆表对象的OID分别存储在pg_database和pg_class中,因此当你希望找出OID时,可以执行以下查询:
1.2 数据库集簇的物理结构
数据库集簇在本质上就是一个文件目录,名曰 基础目录(base directory),包含着一系列子目录与文件。 执行 initdb 命令会在指定目录下创建基础目录从而初始化一个新的数据库集簇。 通常会将基础目录的路径配置到环境变量PGDATA中,但这并不是必须的。
图1.2 展示了一个PostgreSQL数据库集簇的例子。 base子目录中的每一个子目录都对应一个数据库,数据库中每个表和索引都会在相应子目录下存储为(至少)一个文件;还有几个包含特定数据的子目录,以及配置文件。 虽然PostgreSQL支持表空间(Tablespace),但该术语的含义与其他RDBMS不同。 PostgreSQL中的表空间对应一个包含基础目录之外数据的目录。
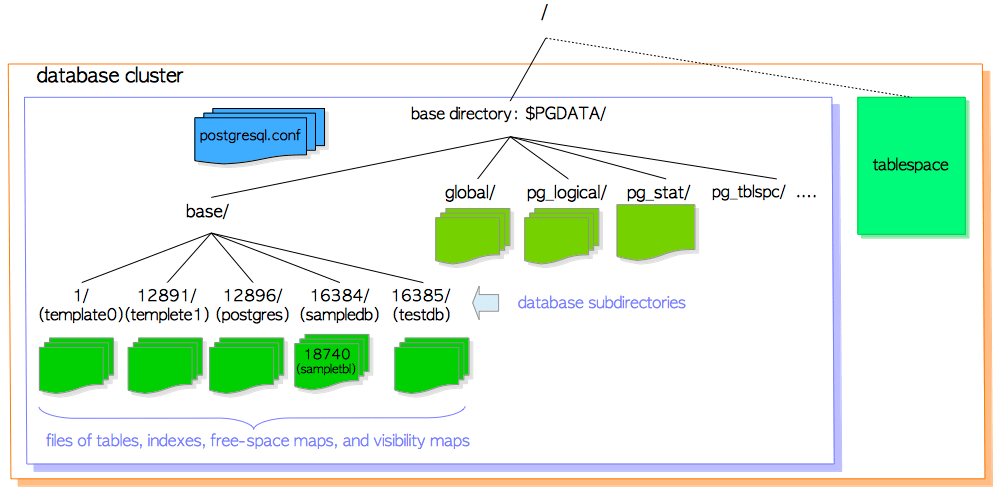
后续小节将描述数据库集簇的布局,数据库的布局,表和索引对应的文件布局,以及PostgreSQL中表空间的布局。
1.2.1 数据库集簇的布局
官方文档 中描述了数据库集簇的布局。 表1.1中列出了主要的文件与子目录:
| 文件 | 描述 |
|---|---|
PG_VERSION |
包含PostgreSQL主版本号 |
pg_hba.conf |
控制PosgreSQL客户端认证 |
pg_ident.conf |
控制PostgreSQL用户名映射 |
postgresql.conf |
配置参数 |
postgresql.auto.conf |
存储使用ALTER SYSTEM修改的配置参数(9.4或更新版本) |
postmaster.opts |
记录服务器上次启动的命令行选项 |
| 子目录 | 描述 |
|---|---|
base/ |
每个数据库对应的子目录存储于此 |
global/ |
数据库集簇范畴的表(例如pg_database),以及pg_control文件。 |
pg_commit_ts/ |
事务提交的时间戳数据(9.5及更新版本)。 |
pg_clog/ (9.6-) |
事务提交状态数据(9.6及更老版本),在版本10中被重命名为pg_xact。CLOG将在5.4节中描述 |
pg_dynshmem/ |
动态共享内存子系统中使用的文件(9.4或更新版本)。 |
pg_logical/ |
逻辑解码的状态数据(9.4或更新版本)。 |
pg_multixact/ |
多事务状态数据 |
pg_notify/ |
LISTEN/NOTIFY状态数据 |
pg_repslot/ |
复制槽数据(9.4或更新版本)。 |
pg_serial/ |
已提交的可串行化事务相关信息(9.1或更新版本) |
pg_snapshots/ |
导出快照(9.2或更新版本)。 PostgreSQL函数pg_export_snapshot在此子目录中创建快照信息文件。 |
pg_stat/ |
统计子系统的永久文件 |
pg_stat_tmp/ |
统计子系统的临时文件 |
pg_subtrans/ |
子事务状态数据 |
pg_tblspc/ |
指向表空间的符号链接 |
pg_twophase/ |
两阶段事务(prepared transactions)的状态文件 |
pg_wal/ (10+) |
WAL( Write Ahead Logging)段文件(10或更新版本),从pg_xlog重命名而来。 |
pg_xact/ (10+) |
事务提交状态数据,(10或更新版本),从pg_clog重命名而来。CLOG将在5.4节中描述。 |
pg_xlog/ (9.6-) |
WAL(Write Ahead Logging) 段文件(9.6及更老版本),它在版本10中被重命名为 pg_wal。 |
1.2.2 数据库布局
一个数据库与base子目录下的一个子目录对应;且该子目录的名称与相应数据库的OID相同。 例如当数据库sampledb的OID为16384时,它对应的子目录名称即为16384。
1.2.3 表与索引相关文件的布局
每个小于1GB的表或索引都在相应的数据库目录中存储为单个文件。在数据库内部,表和索引作为数据库对象是通过OID来管理的,而这些数据文件则由变量relfilenode管理。 表和索引的relfilenode值通常与其OID一致,但也有例外,下面将详细展开。
让我们看一看表sampletbl的oid和relfilenode:
从上面的结果可以看出oid和relfilenode值相等。还可以看到表sampletbl的数据文件路径是base/16384/18740。
表和索引的relfilenode值会被一些命令(例如TRUNCATE,REINDEX,CLUSTER)所改变。 例如对表 sampletbl执行TRUNCATE,PostgreSQL会为表分配一个新的relfilenode(18812),删除旧的数据文件(18740),并创建一个新的数据文件(18812)。
在9.0或更高版本中,内建函数
pg_relation_filepath能够根据OID或名称返回关系对应的文件路径,非常实用。
当表和索引的文件大小超过1GB时,PostgreSQL会创建并使用一个名为relfilenode.1的新文件。如果新文件也填满了,则会创建下一个名为relfilenode.2的新文件,依此类推。
译者注:数据库系统中的 表(Table) 与关系代数中的 关系(Relation) 关系紧密但又不尽相同。在PostgreSQL中,表,索引,TOAST表都归类为关系。
在构建PostgreSQL时,可以使用配置选项
--with-segsize更改表和索引的最大文件大小。
仔细观察数据库子目录就会发现,每个表都有两个与之相关联的文件,后缀分别为_fsm和_vm。这些实际上是空闲空间映射(free space map)和可见性映射(visibility map) 文件,分别存储了表文件每个页面上的空闲空间信息与可见性信息(更多细节见第5.3.4节和第6.2节)。索引没有可见性映射文件,只有空闲空间映射文件。
一个具体的示例如下所示:
在数据库系统内部,这些文件(主体数据文件,空闲空间映射文件,可见性映射文件等)也被称为相应关系的分支(fork);空闲空间映射是表/索引数据文件的第一个分支(分支编号为1),可见性映射表是数据文件的第二个分支(分支编号为2),数据文件的分支编号为0。
译者注:每个 关系(relation) 可能会有四种分支,分支编号分别为0,1,2,3,0号分支
main为关系数据文件本体,1号分支fsm保存了main分支中空闲空间的信息,2号分支vm保存了main分支中可见性的信息,3号分支init是很少见的特殊分支,通常用于不被日志记录(unlogged)的表与索引。每个分支都会被存储为磁盘上的一到多个文件:PostgreSQL会将过大的分支文件切分为若干个段,以免文件的尺寸超过某些特定文件系统允许的大小,也便于一些归档工具进行并发复制,默认的段大小为1GB。
1.2.4 表空间
PostgreSQL中的 表空间(Tablespace) 是基础目录之外的附加数据区域。 在8.0版本中引入了该功能。
图1.3展示了表空间的内部布局,以及表空间与主数据区域的关系。
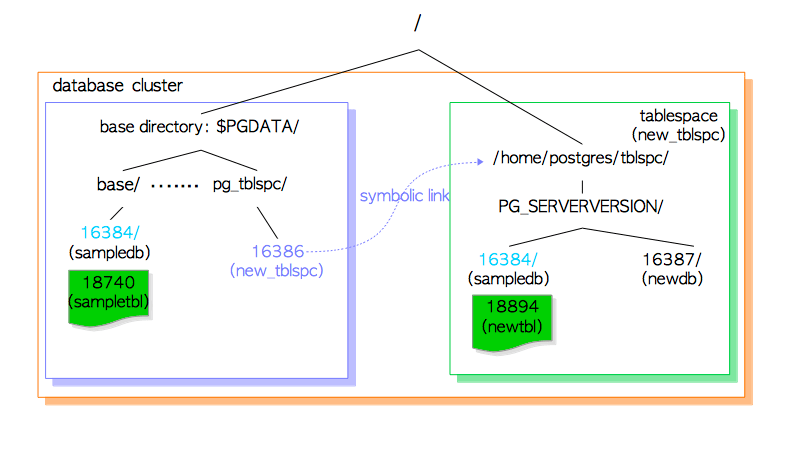
执行CREATE TABLESPACE语句会在指定的目录下创建表空间。而在该目录下还会创建版本特定的子目录(例如PG_9.4_201409291)。版本特定的命名方式为:
举个例子,如果在/home/postgres/tblspc中创建一个表空间new_tblspc,其oid为16386,则会在表空间下创建一个名如PG_9.4_201409291的子目录。
表空间目录通过pg_tblspc子目录中的符号链接寻址,链接名称与表空间的OID值相同。
如果在该表空间下创建新的数据库(OID为16387),则会在版本特定的子目录下创建相应目录。
如果在该表空间内创建一个新表,但新表所属的数据库却创建在基础目录下,那么PG会首先在版本特定的子目录下创建名称与现有数据库OID相同的新目录,然后将新表文件放置在刚创建的目录下。
1.3 堆表文件的内部布局
1.3.1 堆表页面的内部布局
在数据文件(堆表,索引,也包括空闲空间映射和可见性映射)内部,它被划分为固定长度的页(pages),或曰 区块(blocks),大小默认为8192字节(8KB)。 每个文件中的页从0开始按顺序编号,这些数字称为区块号(block numbers)。 如果文件已填满,PostgreSQL通过在文件末尾追加一个新的空页来增长文件。
页面内部的布局取决于数据文件的类型。本节会描述表的页面布局,因为理解接下来的几章需要这些知识。
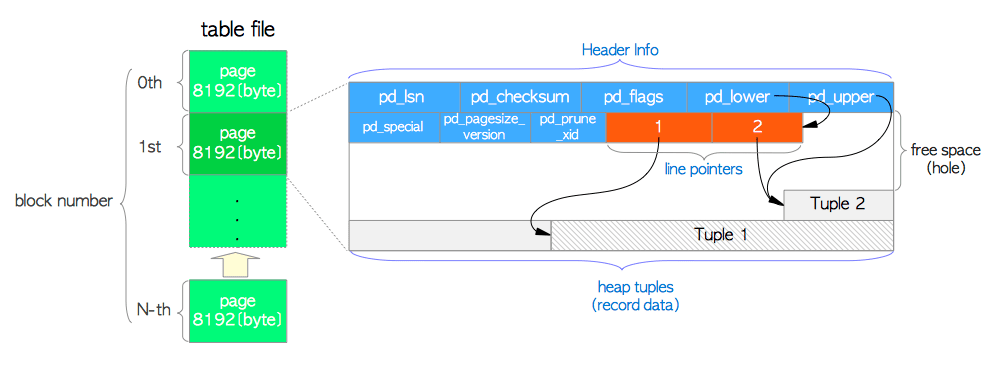
表的页面包含了三种类型的数据:
-
堆元组(heap tuples) —— 堆元组就是数据记录本身。它们从页面底部开始依序堆叠。第5.2节与第9章会描述元组的内部结构,这一知识对于理解PostgreSQL并发控制与WAL机制是必须的。
-
行指针(line pointer) —— 每个行指针占4个字节,保存着指向堆元组的指针。它们也被称为项目指针(item pointer)。行指针简单地组织为一个数组,扮演了元组索引的角色。每个索引项从1开始依次编号,称为偏移号(offset number)。当向页面中添加新元组时,一个相应的新行指针也会被放入数组中,并指向新添加的元组。
-
首部数据(header data) —— 页面的起始位置分配了由结构
PageHeaderData定义的首部数据。它的大小为24个字节,包含关于页面的元数据。该结构的主要成员变量为:pd_lsn—— 本页面最近一次变更所写入XLOG记录对应的LSN。它是一个8字节无符号整数,与WAL机制相关,第9章将详细展开。pd_checksum—— 本页面的校验和值。(注意只有在9.3或更高版本才有此变量,早期版中该字段用于存储页面的时间线标识)pd_lower,pd_upper——pd_lower指向行指针的末尾,pd_upper指向最新堆元组的起始位置。pd_special—— 在索引页中会用到该字段。在堆表页中它指向页尾。(在索引页中它指向特殊空间的起始位置,特殊空间是仅由索引使用的特殊数据区域,包含特定的数据,具体内容依索引的类型而定,如B树,GiST,GiN等。
行指针的末尾与最新元组起始位置之间的空余空间称为空闲空间(free space)或空洞(hole)。
为了识别表中的元组,数据库内部会使用元组标识符(tuple identifier, TID)。TID由一对值组成:元组所属页面的区块号,及指向元组的行指针的偏移号。TID的一种典型用途是索引,更多细节参见第1.4.2节。
结构体
PageHeaderData定义于src/include/storage/bufpage.h中。
1.3.2 TOAST(超大属性存储技术)
大小超过约2 KB的堆元组——更准确地说,超过默认TOAST_TUPLE_THRESHOLD所规定的2032字节——会使用一种称为TOAST(The Oversized-Attribute Storage Technique,超大属性存储技术)的机制来管理。
如果一个数据项经过压缩后仍超过2 KB,PostgreSQL会为该表创建专用的TOAST表及相应的TOAST索引。实际数据存放在TOAST表中,原表中只保留一个指向TOAST条目的指针。
1.3.2.1 实际示例
下面创建一张名为tbl_toast的表来演示这一机制:
第一行插入一个能直接放入普通页面的小字符串abc,第二行和第三行则分别插入约10 KB的数据:
本例中,tbl_toast的OID为16406:
相应的TOAST表及其索引分别命名为pg_toast_16406与pg_toast_16406_index:
可以用下面的查询取得这些关系的OID与物理文件路径。本例中的路径分别为base/16384/16411和base/16384/16412:
关于元组压缩: 为了直接观察TOAST机制,本例通过
ALTER TABLE调整存储参数,禁用了数据压缩。通常情况下,PostgreSQL会尝试压缩超过2 KB的数据,默认压缩算法为pglz(PostgreSQL Lempel-Ziv)。
1.3.2.2 结构分析
图1.3-1展示了主表tbl_toast与TOAST表pg_toast_16406之间的关系。该图对应新版英文原著的图1.5;为避免与中文旧译本已有的图1.5冲突,这里采用补充编号。
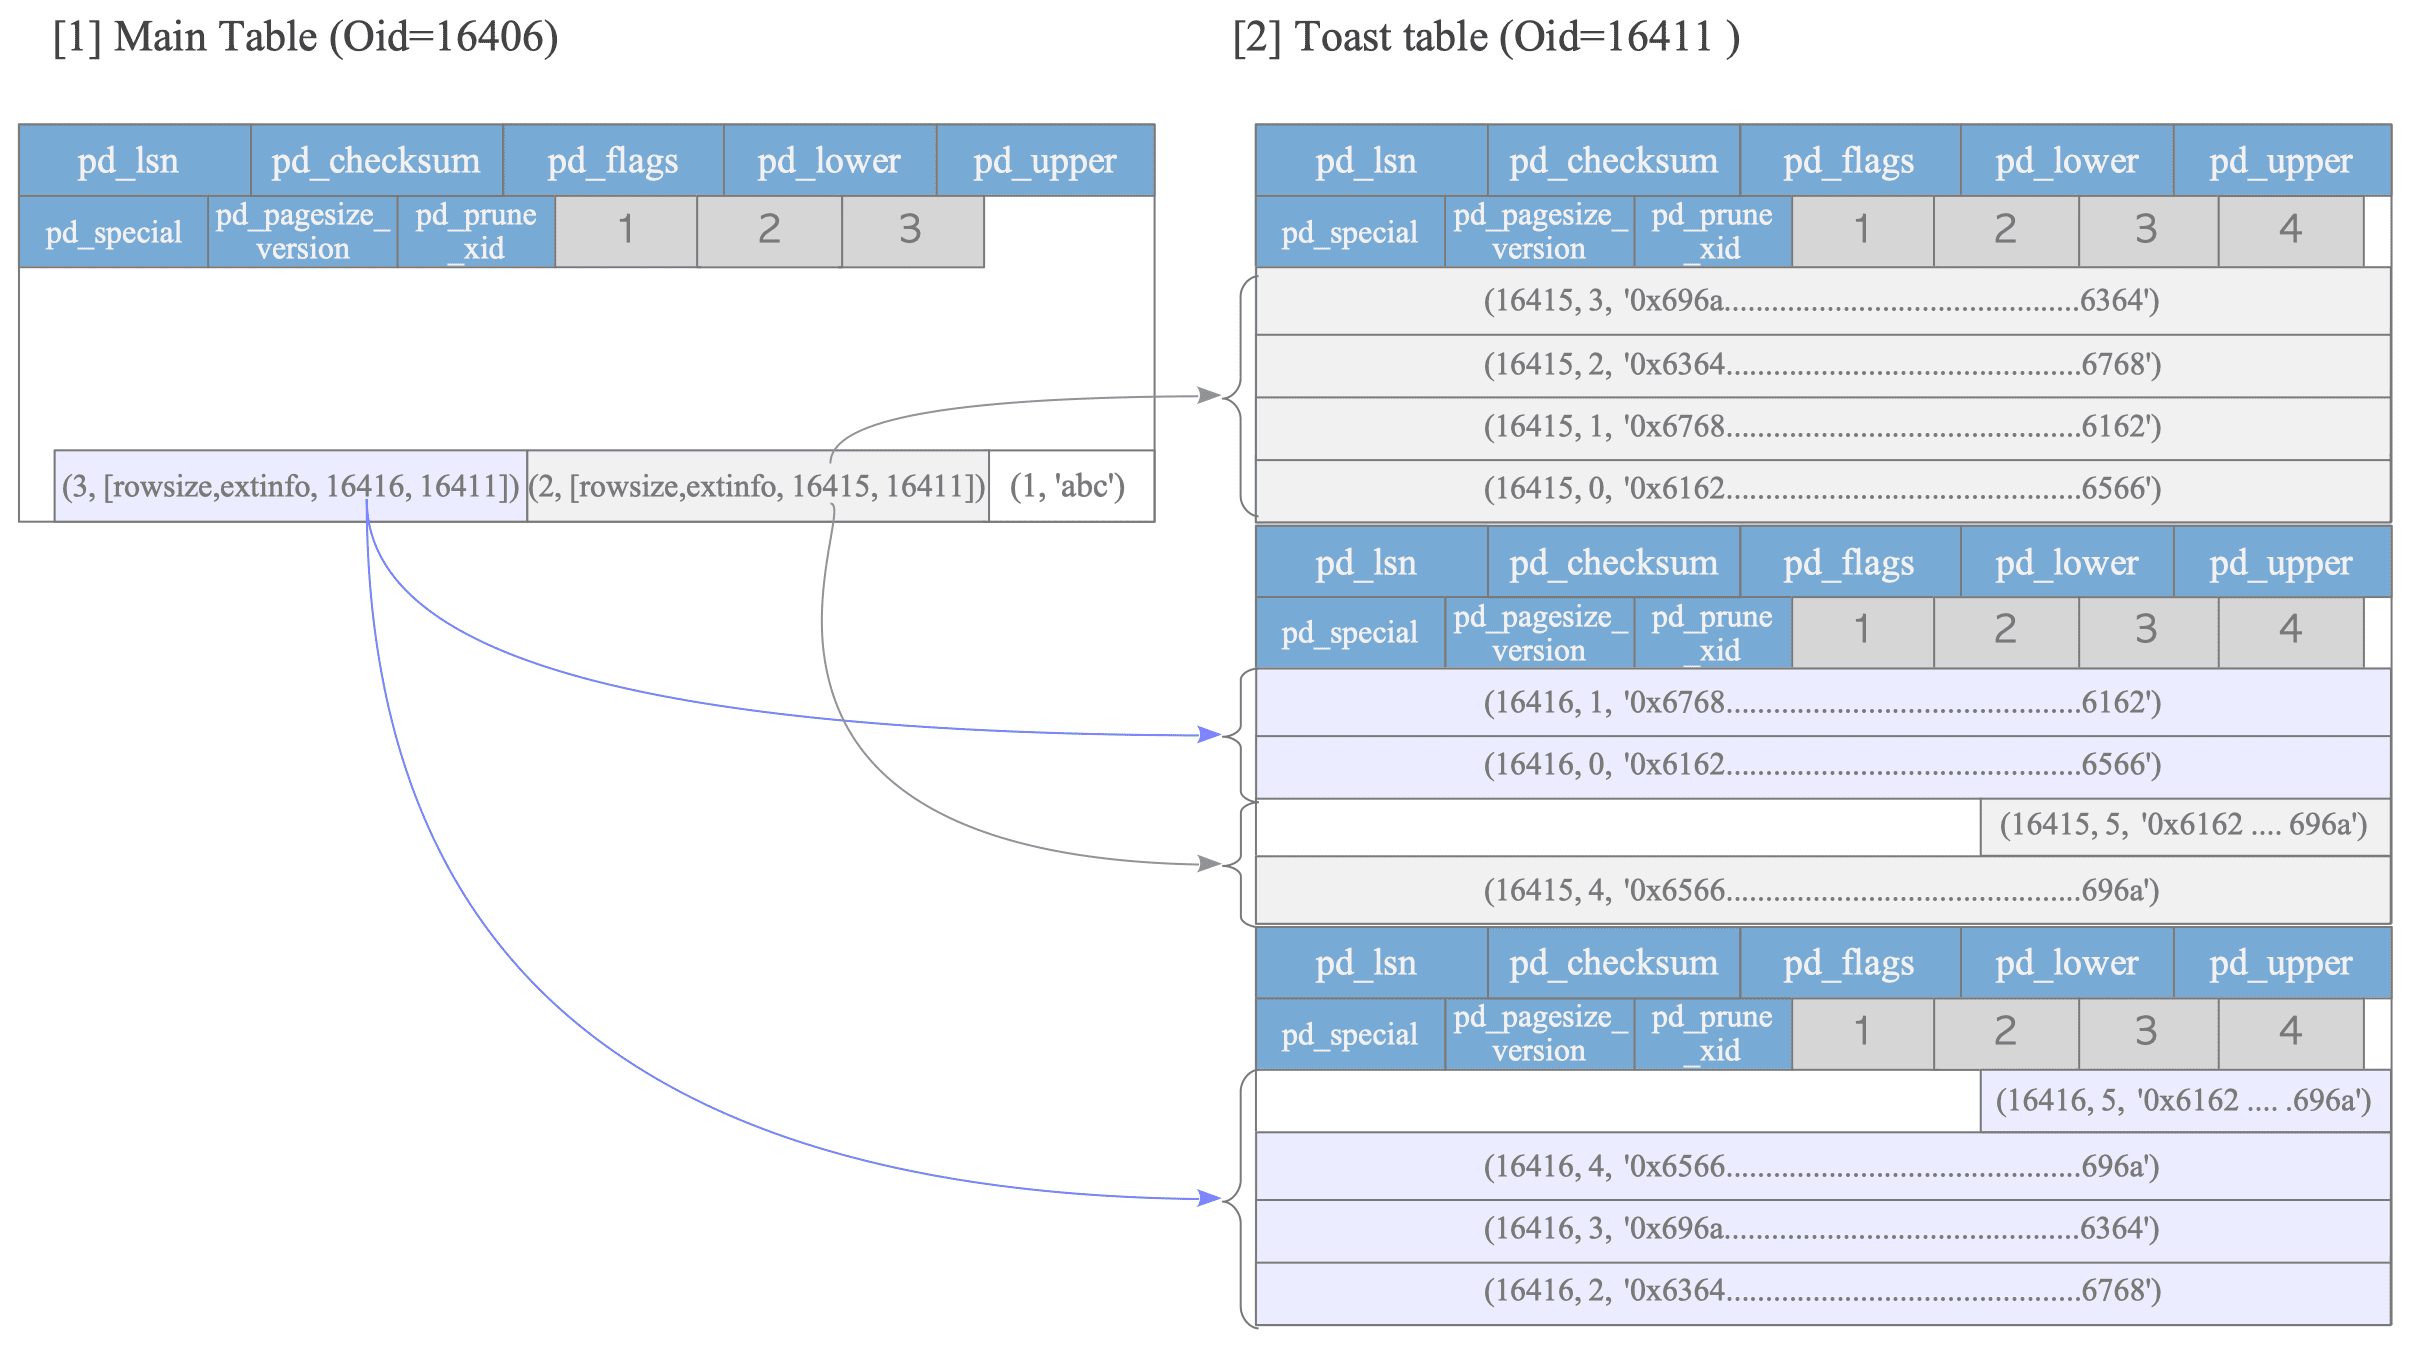
由于tbl_toast第二行和第三行中的data项均为10 KB,它们不会以内联原始数据的形式保存,而是使用varatt_external结构存储为TOAST指针:
这四个字段的含义如下:
va_rawsize: 包含首部在内的原始数据大小。va_extinfo: 外部存储的实际大小(不含首部)及所用压缩方法。va_valueid: 该值在TOAST表中的唯一标识,内部称为chunk_id。va_toastrelid: 存放该数据的TOAST表OID。
va_valueid(即chunk_id)与va_toastrelid的组合构成了指向外部数据的实际指针。本例中,第二个和第三个元组的va_valueid分别为16415与16416,va_toastrelid则为16411,也就是TOAST表的OID。
1.3.2.3 TOAST表的内容
TOAST表包含三列:chunk_id、chunk_seq与chunk_data。
chunk_id: 原表中被TOAST化数据项的标识。chunk_seq: 数据项被拆成多个片段后,各片段的顺序号。chunk_data: 实际的二进制数据片段。
pg_toast_16406中的内容如下:
TOAST索引以chunk_id与chunk_seq作为复合键。读取TOAST化数据时,系统会扫描TOAST索引,按正确顺序取得对应的chunk_data片段,再重组成原始数据项。
1.4 读写元组的方式
本章的最后将描述读取与写入堆元组的方式。
1.4.1 写入堆元组
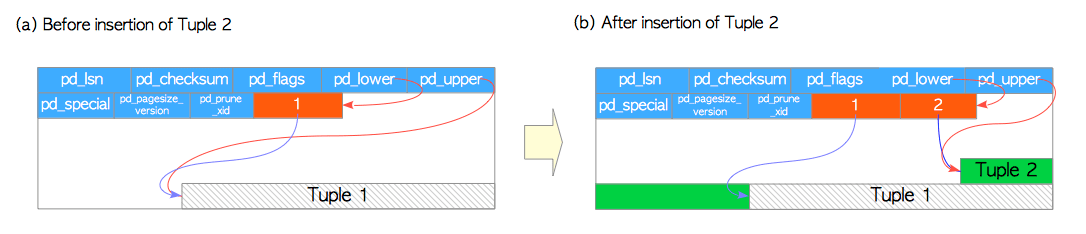
让我们假设有一个表,仅由一个页面组成,且该页面只包含一个堆元组。 此页面的pd_lower指向第一个行指针,而该行指针和pd_upper都指向第一个堆元组。 如图1.5(a)所示。
当第二个元组被插入时,它会被放在第一个元组之后。第二个行指针被插入到第一个行指针的后面,并指向第二个元组。 pd_lower更改为指向第二个行指针,pd_upper更改为指向第二个堆元组,如图1.5(b)。 页面内的首部数据(例如pd_lsn、pd_checksum和pd_flags)也会被改写为适当的值,细节在第5.3节和第9章中描述。
1.4.2 读取堆元组
这里简述两种典型的访问方式:顺序扫描与B树索引扫描:
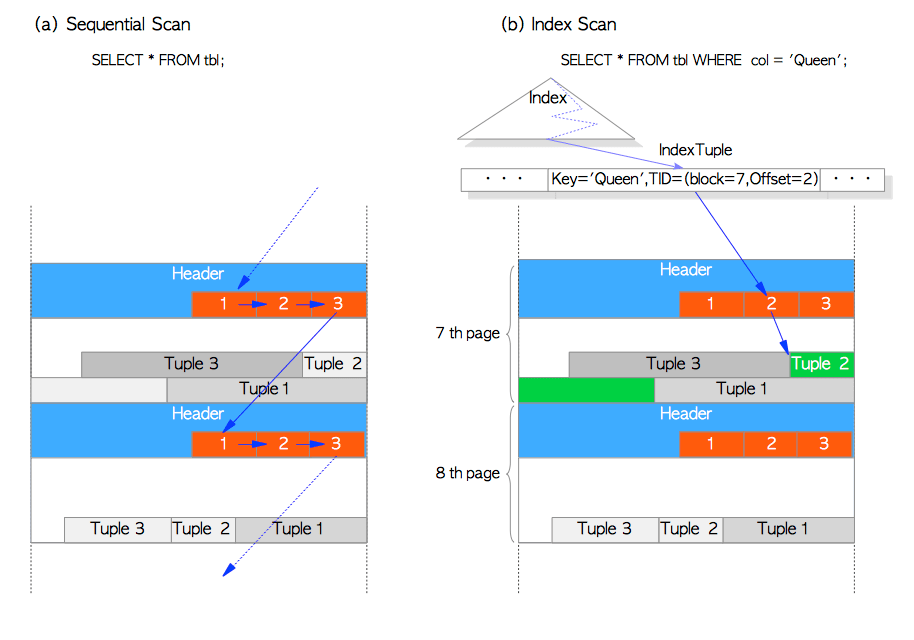
- 顺序扫描 —— 通过扫描每一页中的行指针,依序读取所有页面中的所有元组,如图1.6(a)。
- B树索引扫描 —— 索引文件包含着索引元组,索引元组由一个键值对组成,键为被索引的列值,值为目标堆元组的TID。进行索引查询时,首先使用键进行查找,如果找到了对应的索引元组,PostgreSQL就会根据相应值中的TID来读取对应的堆元组 (使用B树索引找到索引元组的方法请参考相关资料,这一部分属于数据库系统的通用知识,限于篇幅这里不再详细展开)。例如在图1.6(b)中,所获索引元组中TID的值为(区块号 = 7,偏移号 = 2), 这意味着目标堆元组是表中第7页的第2个元组,因而PostgreSQL可以直接读取所需的堆元组,而避免对页面做不必要的扫描。
PostgreSQL还支持TID扫描,位图扫描(Bitmap-Scan)和仅索引扫描(Index-Only-Scan)。
TID扫描是一种通过使用所需元组的TID直接访问元组的方法。 例如要在表中找到第0个页面中的第1个元组,可以执行以下查询:
仅索引扫描将在第7章中详细介绍。
2 进程和内存架构
本章总结了PostgreSQL中进程与内存的架构,有助于读者理解后续章节。 如果读者已经熟悉这些内容,可以直接跳过本章。
2.1 进程架构
PostgreSQL是一个客户端/服务器风格的关系型数据库管理系统,采用多进程架构,运行在单台主机上。
我们通常所谓的 “PostgreSQL服务器(PostgreSQL Server)” 实际上是一系列协同工作的进程集合,包含着下列进程:
-
Postgres服务器进程(Postgres Server Process) 是所有数据库集簇管理进程的父进程。
-
每个 后端进程(Backend Process) 负责处理客户端发出的查询和语句。
-
各种 后台进程(Background Process) 负责执行各种数据库管理任务(例如清理过程与检查点过程)。
-
各种 复制相关(Replication Associated Process) 的进程负责流复制,流复制的细节会在第11章中介绍。
-
后台工作进程(Background Worker Process) 在 9.3 版被引入,它能执行任意由用户实现的处理逻辑。这里不详述,请参阅官方文档。
以下几小节将详细描述前三种进程。
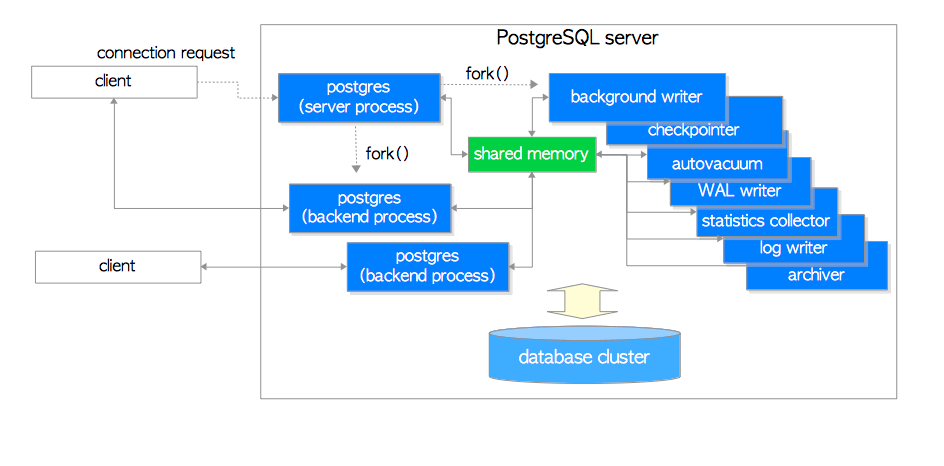
本图展示了PostgreSQL服务器包含的进程:postgres服务器进程,两个后端进程,七个后台进程,以及两个客户端进程。 也画出了数据库集簇,共享内存,以及两个客户端。
2.1.1 Postgres服务器进程
如上所述,Postgres服务器进程(postgres server process) 是 PostgreSQL 服务器中所有进程的父进程,在早期版本中它被称为 “postmaster”。
带start参数执行pg_ctl实用程序会启动一个postgres服务器进程。它会在内存中分配共享内存区域,启动各种后台进程,如有必要还会启动复制相关进程与后台工作进程,并等待来自客户端的连接请求。 每当接收到来自客户端的连接请求时,它都会启动一个后端进程 (然后由启动的后端进程处理该客户端发出的所有查询)。
一个postgres服务器进程只会监听一个网络端口,默认端口为5432。如果要在同一台主机上运行多个PostgreSQL服务器,则应为每个服务器配置不同的监听端口,如5432,5433等。
2.1.2 后端进程
每个后端进程(也称为 “postgres”)由postgres服务器进程启动,并处理连接另一侧的客户端发出的所有查询。它通过单条TCP连接与客户端通信,并在客户端断开连接时终止。
因为一条连接只允许操作一个数据库,因此必须在连接到PostgreSQL服务器时显式指定要连接的数据库。
PostgreSQL允许多个客户端同时连接;配置参数max_connections用于控制最大客户端连接数(默认为100)。
因为PostgreSQL没有原生的连接池功能,因此如果许多客户端频繁地重复与PostgreSQL服务器建立、断开连接(譬如Web应用),则会导致建立连接与创建后端进程的开销变大。这种情况对数据库服务器的性能有负面影响,通常可以使用池化中间件(PgBouncer或Pgpool-II)来避免该问题。
2.1.3 后台进程
表2.1是后台进程的列表。比起postgres服务器和后端进程,后台进程的种类要多很多。想要简单地解释每种后台进程的具体功能是不现实的,因为这些功能有赖PostgreSQL的内部机制与特定的独立特性。依赖于各个特定的特性以及PostgreSQL的内部机制。 因此在本章中仅做简要介绍。 细节将在后续章节中描述。
| 进程 | 概述 | 参考 |
|---|---|---|
| background writer | 本进程负责将共享缓冲池中的脏页逐渐刷入持久化存储中(例如,HDD,SSD)(在9.1及更旧版本中,它还负责处理检查点(checkpoint)) | 8.6 |
| checkpointer | 在9.2及更新版本中,该进程负责处理检查点。 | 8.6, 9.7 |
| autovacuum launcher | 周期性地启动自动清理工作进程(更准确地说,它向Postgres服务器请求创建自动清理工作进程) | 6.5 |
| WAL writer | 本进程周期性地将WAL缓冲区中的WAL数据刷入持久存储中。 | 9.9 |
| statistics collector | 本进程负责收集统计信息,用于诸如pg_stat_activity,pg_stat_database等系统视图。 |
|
| logging collector (logger) | 本进程负责将错误消息写入日志文件。 | |
| archiver | 本进程负责将日志归档。 | 9.10 |
这里展示了PostgreSQL服务器包含的实际进程。 在以下示例中有一个postgres服务器进程(pid为9687),两个后端进程(pid为9697和9717),以及表2.1中列出的几个后台进程正在运行,亦见图2.1。
2.2 内存架构
PostgreSQL的内存架构可以分为两部分:
- 本地内存区域 —— 由每个后端进程分配,供自己使用。
- 共享内存区域 —— 供PostgreSQL服务器的所有进程使用。
下面一小节简要介绍了这两部分架构。
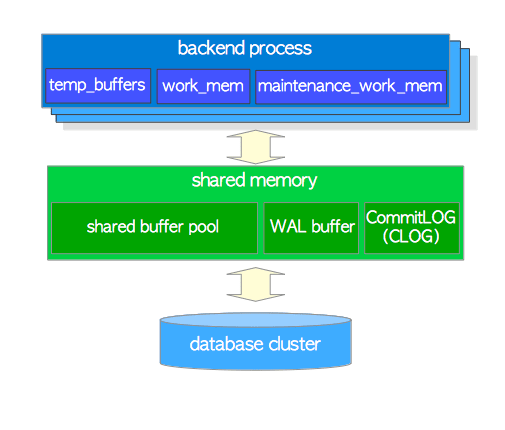
2.2.1 本地内存区域
每个后端进程都会分配一块本地内存区域用于查询处理。该区域会分为几个子区域 —— 子区域的大小有的固定,有的可变。 表2.2列出了主要的子区域。 详细信息将在后续章节中介绍。
2.2.2 共享内存区域
PostgreSQL服务器启动时会分配共享内存区域。该区域分为几个固定大小的子区域。 表2.3列出了主要的子区域。 详细信息将在后续章节中介绍。
除了上面这些,PostgreSQL还分配了这几个区域:
- 用于访问控制机制的子区域(例如信号量,轻量级锁,共享和排他锁等)。
- 各种后台进程使用的子区域,例如
checkpointer和autovacuum。 - 用于事务处理的子区域,例如保存点(save-point) 与 两阶段提交(2PC)。
诸如此类。
3 查询处理
查询处理是PostgreSQL中最为复杂的子系统。如PostgreSQL官方文档所述,PostgreSQL支持SQL2011标准中的大多数特性,查询处理子系统能够高效地处理这些SQL。本章概述了查询处理的流程,特别关注了查询优化的部分。
本章包括下列三个部分:
-
第一部分:3.1节
这一节会简单介绍PostgreSQL中查询处理的流程。
-
第二部分:3.2~3.4节
这一部分会描述获取单表查询上最优执行计划的步骤。3.2节讨论代价与基数估计,3.3节描述创建计划树的过程,3.4节介绍执行器、聚合函数与约束检查。
-
第三部分:3.5~3.6节
这一部分会描述获取多表查询上最优执行计划的步骤。3.5节介绍了三种连接算法:嵌套循环连接(Nested Loop Join)、归并连接(Merge Join)、散列连接(Hash Join)。3.6节将介绍为多表查询创建计划树的过程。
PostgreSQL支持三种技术上很有趣,而且也很实用的功能:外部数据包装(Foreign Data Wrapper, FDW),并行查询,以及版本11即将支持的JIT编译。前两者将在第4章中描述,JIT编译超出本书范围,详见官方文档。
3.1 概览
尽管PostgreSQL在9.6版本后有了基于多个后台工作进程的并行查询,但大体上来讲,还是每个连接对应一个后端进程。后端进程由五个子系统组成,如下所示:
-
解析器(Parser)
解析器根据SQL语句生成一棵语法解析树(parse tree)。
-
分析器(Analyzer)
分析器对语法解析树进行语义分析,生成一棵查询树(query tree)。
-
重写器(Rewriter)
重写器按照规则系统中存在的规则,对查询树进行改写。
-
计划器(Planner)
计划器基于查询树,生成一棵执行效率最高的计划树(plan tree)。
-
执行器(Executor)
执行器按照计划树中的顺序访问表和索引,执行相应查询。
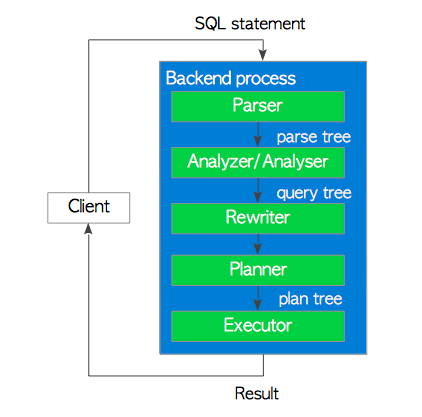
本节将概述这些子系统。计划器和执行器很复杂,后面的章节会对这些函数的细节进行描述。
PostgreSQL的查询处理在官方文档中有详细的描述
3.1.1 解析器(Parser)
解析器基于SQL语句的文本,生成一棵后续子系统可以理解的语法解析树。下面是一个具体的例子。
考虑以下查询:
语法解析树的根节点是一个定义在parsenodes.h中的SelectStmt数据结构。图3.2(a)展示了一个查询,而图3.2(b)则是该查询对应的语法解析树。
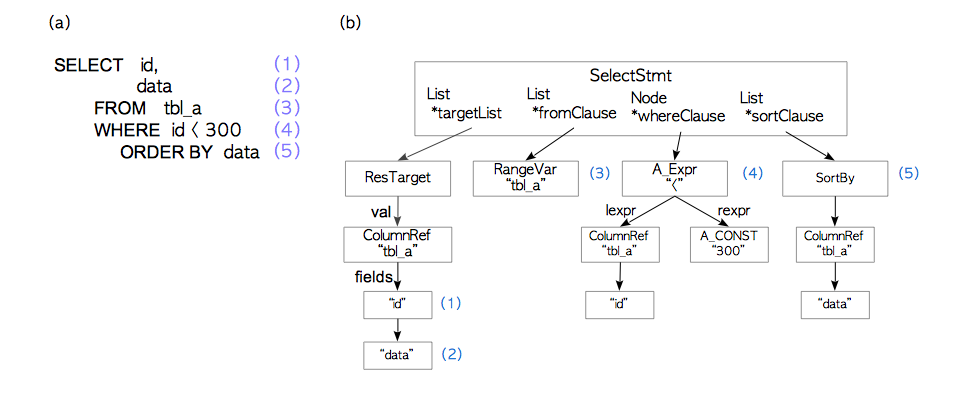
SELECT查询中的元素和语法解析树中的元素有着对应关系。比如,(1)是目标列表中的一个元素,与目标表的'id'列相对应,(4)是一个WHERE子句,诸如此类。
当解析器生成语法分析树时只会检查语法,只有当查询中出现语法错误时才会返回错误。解析器并不会检查输入查询的语义,举个例子,如果查询中包含一个不存在的表名,解析器并不会报错,语义检查由分析器负责。
3.1.2 分析器(Analyzer)
分析器对解析器产出的语法解析树(parse tree)进行语义分析,并产出一棵查询树(query tree)。
查询树的根节点是parsenode.h中定义的Query数据结构,这个结构包含着对应查询的元数据,比如命令的类型(SELECT/INSERT等),还包括了一些叶子节点,叶子节点由列表或树组成,包含了特定子句相应的数据。
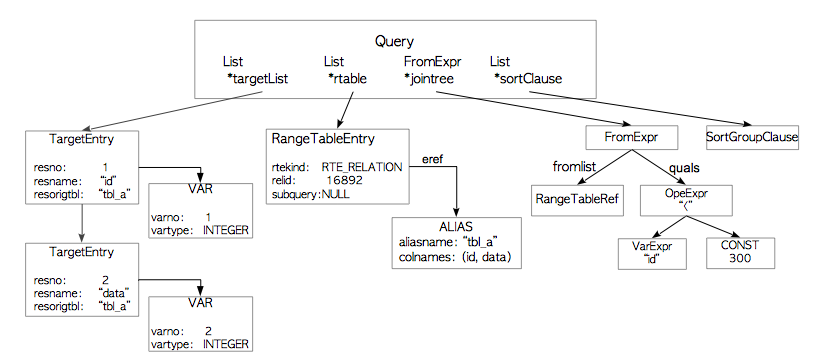
简要介绍一下上图中的查询树:
targetlist是查询结果中 列(Column) 的列表。在本例中该列表包含两列:id和data。如果在输入的查询树中使用了*(星号),那么分析器会将其显式替换为所有具体的列。- 范围表
rtable是该查询所用到关系的列表。本例中该变量包含了表tbl_a的信息,如该表的表名与oid。 - 连接树
jointree存储着FROM和WHERE子句的相关信息。 - 排序子句
sortClause是SortGroupClause结构体的列表。
官方文档描述了查询树的细节。
3.1.3 重写器(Rewriter)
PostgreSQL的规则系统正是基于重写器实现的;当需要时,重写器会根据存储在pg_rules中的规则对查询树进行转换。规则系统本身也是一个很有趣的系统,不过本章略去了关于规则系统和重写器的描述,以免内容过于冗长。
视图
在PostgreSQL中,视图是基于规则系统实现的。当使用
CREATE VIEW命令定义一个视图时,PostgreSQL就会创建相应的规则,并存储到系统目录中。假设下面的视图已经被定义,而
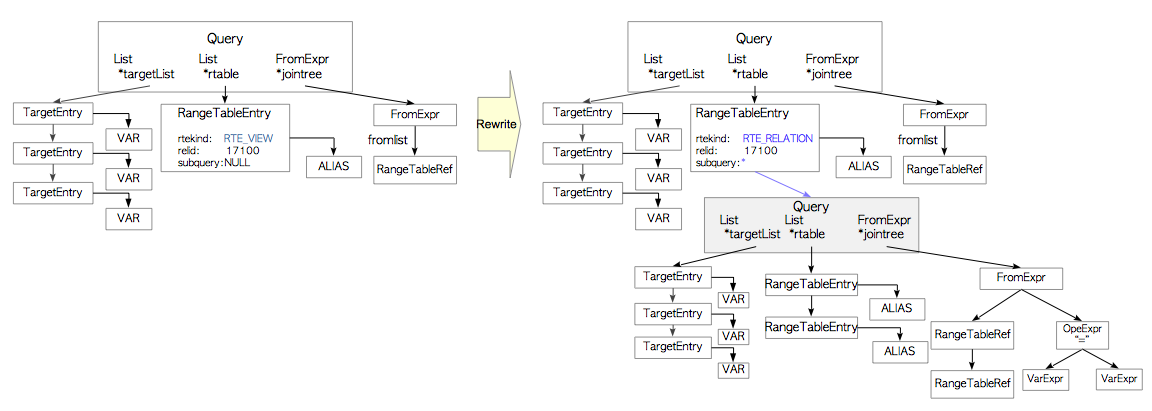
pg_rule中也存储了相应的规则。当执行一个包含该视图的查询,解析器会创建一棵如图3.4(a)所示的语法解析树。
在该阶段,重写器会基于
pg_rules中存储的视图规则将rangetable节点重写为一棵查询子树,与子查询相对应。图3.4 重写阶段一例
因为PostgreSQL使用这种机制实现视图,直到9.2版本,视图都是不能更新的。虽然9.3版本后可以对视图进行更新,但对视图的更新仍然存在很多限制,具体细节请参考官方文档。
3.1.4 计划器与执行器
计划器从重写器获取一棵查询树(query tree),基于查询树生成一棵能被执行器高效执行的(查询)计划树(plan tree)。
在PostgreSQL中,计划器是完全基于代价估计(cost-based)的;它不支持基于规则的优化与提示(hint)。计划器是RDBMS中最为复杂的部分,因此本章的后续内容会对计划器做一个概述。
pg_hint_planPostgreSQL不支持SQL中的提示(hint)。如果你想在查询中使用提示,可以考虑使用
pg_hint_plan扩展,细节请参考项目文档。
与其他RDBMS类似,PostgreSQL中的EXPLAIN命令会显示命令的计划树。下面给出了一个具体的例子。
图3.5展示了结果相应的计划树。
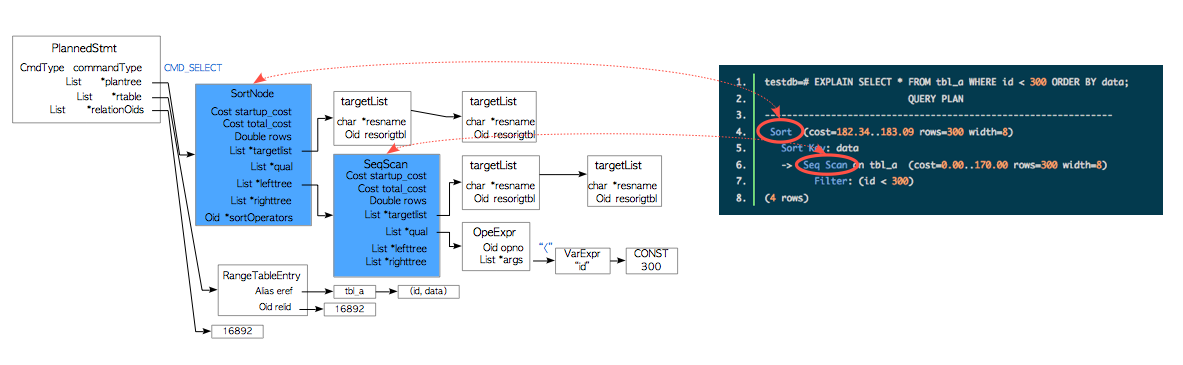
计划树由许多称为 计划节点(plan node) 的元素组成,这些节点挂在PlannedStmt结构对应的计划树上。这些元素定义在plannodes.h中,第3.3.3节与第3.5.4.2会解释相关细节。
每个计划节点都包含着执行器进行处理所必需的信息,在单表查询的场景中,执行器会按照从终端节点往根节点的顺序依次处理这些节点。
比如图3.5中的计划树就是一个列表,包含一个排序节点和一个顺序扫描节点;因而执行器会首先对表tbl_a执行顺序扫描,并对获取的结果进行排序。
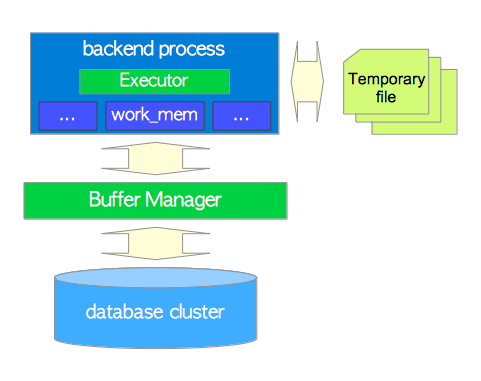
执行器会通过第8章将介绍的缓冲区管理器来访问数据库集簇的表和索引。当处理一个查询时,执行器会使用预先分配的内存空间,比如temp_buffers和work_mem,必要时还会创建临时文件。
除此之外,当访问元组的时候,PostgreSQL还会使用并发控制机制来维护运行中事务的一致性和隔离性。第五章介绍了并发控制机制。
3.2 单表查询的代价估计
PostgreSQL的查询优化是基于 代价(Cost) 的。代价是一个无量纲的值,它并不是一种绝对的性能指标,但可以作为比较各种操作代价时的相对性能指标。
costsize.c中的函数用于估算各种操作的代价。所有被执行器执行的操作都有着相应的代价函数。例如,函数cost_seqscan() 和 cost_index()分别用于估算顺序扫描和索引扫描的代价。
在PostgreSQL中有三种代价:启动(start-up) , 运行(run)和总和(total)。总代价是启动代价和运行代价的和;因此只有启动代价和运行代价是单独估计的。
- 启动代价(start-up):在读取到第一条元组前花费的代价,比如索引扫描节点的启动代价就是读取目标表的索引页,取到第一个元组的代价
- 运行代价(run): 获取全部元组的代价
- 总代价(total):前两者之和
EXPLAIN命令显示了每个操作的启动代价和总代价,下面是一个简单的例子:
在第4行显示了顺序扫描的相关信息。代价部分包含了两个值:0.00和145.00。在本例中,启动代价和总代价分别为0.00和145.00。
在本节中,我们将详细介绍顺序扫描,索引扫描和排序操作的代价是如何估算的。
在接下来的内容中,我们使用下面这个表及其索引作为例子。
3.2.1 顺序扫描
顺序扫描的代价是通过函数cost_seqscan()估计的。本节将研究顺序扫描代价是如何估计的,以下面的查询为例:
在顺序扫描中,启动代价等于0,而运行代价由以下公式定义:
其中seq_page_cost,cpu_tuple_cost和cpu_operator_cost是在postgresql.conf 中配置的参数,默认值分别为1.0,0.01和0.0025。 和 分别是表中的元组总数与页面总数,这两个值可以使用以下查询获取。
因此:
最终:
作为验证,下面是该查询的EXPLAIN结果:
在第4行中可以看到,启动代价和总代价分别是0.00和170.0,且预计全表扫描返回行数为8000条(元组)。
在第5行显示了一个顺序扫描的过滤器Filter:(id < 8000)。更精确地说,它是一个表级过滤谓词(table level filter predicate)。注意这种类型的过滤器只会在读取所有元组的时候使用,它并不会减少需要扫描的表页面数量。
从优化运行代价的角度来看,PostgreSQL假设所有的物理页都是从存储介质中获取的;即,PostgreSQL不会考虑扫 描的页面是否来自共享缓冲区。
3.2.2 索引扫描
尽管PostgreSQL支持很多索引方法,比如B树,GiST,GIN和BRIN,不过索引扫描的代价估计都使用一个共用的代价函数:cost_index()。
本节将研究索引扫描的代价是如何估计的,以下列查询为例。
在估计该查询的代价之前,下面的查询能获取和的值:
3.2.2.1 启动代价
索引扫描的启动代价就是读取索引页以访问目标表的第一条元组的代价,由下面的公式定义:
其中是索引树的高度。
在本例中,套用公式(3),是10000;是1;是0.0025(默认值)。因此
3.2.2.2 运行代价
索引扫描的运行代价是表和索引的CPU代价与IO代价之和。
前三个代价(即index_cpu_cost,table_cpu_cost和index_io_cost)如下所示:
以上公式中的cpu_index_tuple_cost和random_page_cost在postgresql.conf中配置(默认值分别为0.005和4.0)。粗略来说就是索引求值的代价,默认值是0.0025,这里不再展开。选择率(Selectivity) 是一个0到1之间的浮点数,代表查询指定的WHERE子句在索引中搜索范围的比例。举个例子,就是需要读取的表元组数量,就是需要读取的索引元组数量,诸如此类。
选择率
查询谓词的选择率是通过 直方图界值(histogram_bounds) 与 高频值(Most Common Value, MCV) 估计的,这些信息都存储在系统目录
pg_statistics中,并可通过pg_stats视图查询。这里通过一个具体的例子来简要介绍选择率的计算方法,细节可以参考官方文档。表中每一列的高频值都在
pg_stats视图的most_common_vals和most_common_freqs中成对存储。
- 高频值(most_common_vals):该列上最常出现的取值列表
- 高频值频率(most_common_freqs):高频值相应出现频率的列表
下面是一个简单的例子。表
countries有两列:一列country存储国家名,一列continent存储该国所属大洲。考虑下面的查询,该查询带有
WHERE条件continent = 'Asia'。这时候,计划器使用
continent列上的高频值来估计索引扫描的代价,列上的most_common_vals与most_common_freqs如下所示:与
most_common_vals中Asia值对应的most_common_freqs为0.227979。因此0.227979会在估算中被用作选择率。如果高频值不可用,就会使用目标列上的直方图界值来估计代价。
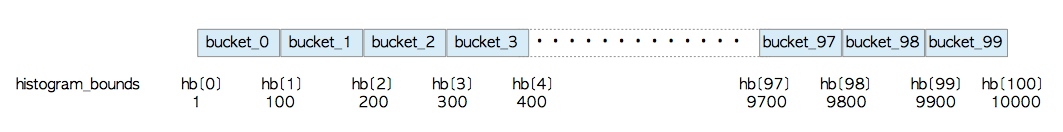
- 直方图值(histogram_bounds) 是一系列值,这些值将列上的取值划分为数量大致相同的若干个组。
下面是一个具体的例子。这是表
tbl中data列上的直方图界值;默认情况下,直方图界值会将列上的取值划分入100个桶。图3.7展示了这些桶及其对应的直方图界值。桶从0开始编号,每个桶保存了(大致)相同数量的元组。直方图界值就是相应桶的边界。比如,直方图界值的第0个值是1,意即这是
bucket_0中的最小值。第1个值是100,意即bucket_1中的最小值是100,等等。图3.7 桶和直方图界值
然后本节例子中选择率计算如下所示。假设查询带有
WHERE子句data < 240,而值240落在第二个桶中。在本例中可以通过线性插值推算出相应的选择率。因此查询中data列的选择率可以套用下面的公式计算:
因此,根据公式(1),(3),(4)和(6),有
由下面的公式定义:
是最差情况下的I/O代价,即,随机扫描所有数据页的代价;这个代价由以下公式定义:
在本例中,由(2),,得
是最优情况下的I/O代价,即,顺序扫描选定的数据页;这个代价由以下公式定义:
在本例中,
下文详细介绍,在本例中,
由(10),(11)和(12),得
综上,由(7),(8),(9)和(13)得
索引相关性(index correlation)
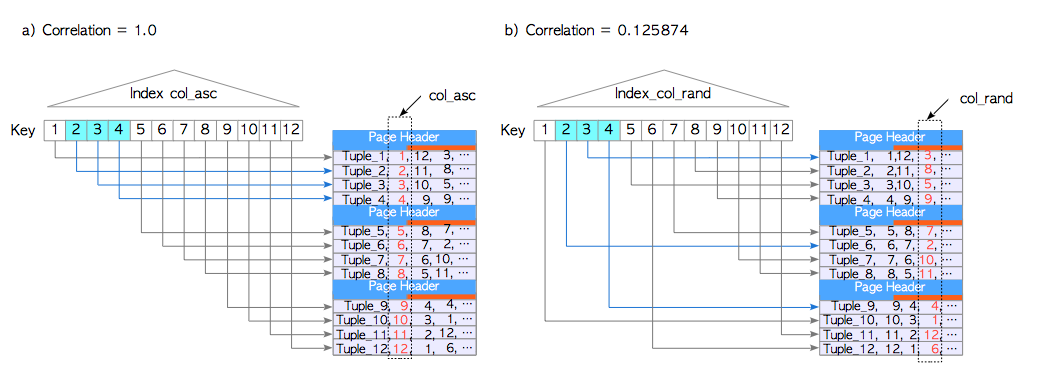
索引相关性是列值在物理上的顺序和逻辑上的顺序的统计相关性(引自官方文档)。索引相关性的取值范围从到。下面的例子有助于理解索引扫描和索引相关性的关系。
表
tbl_corr有5个列:两个列为文本类型,三个列为整数类型。这三个整数列保存着从1到12的数字。在物理上表tbl_corr包含三个页,每页有4条元组。每个数字列有一个名如index_col_asc的索引。这些列的索引相关性如下:
当执行下列查询时,由于所有的目标元组都在第一页中,PostgreSQL只会读取第一页,如图3.8(a)所示。
而执行下列查询时则不然,PostgreSQL需要读所有的页,如图3.8(b)所示。
如此可知,索引相关性是一种统计上的相关性。在索引扫描代价估计中,索引相关性体现了索引顺序和物理元组顺序扭曲程度给随机访问性能造成的影响大小。
图3.8 索引相关性
3.2.2.3 整体代价
由(3)和(14)可得
作为确认,上述SELECT查询的EXPLAIN结果如下所示:
在第4行可以看到启动代价和总代价分别是0.29和13.49,预估有240条元组被扫描。
在第5行显示了一个索引条件Index Cond:(data < 240)。更准确地说,这个条件叫做访问谓词(access predicate),它表达了索引扫描的开始条件与结束条件。
根据这篇文章,PostgreSQL中的
EXPLAIN命令不会区分访问谓词(access predicate)和索引过滤谓词(index filter predicate)。因此当分析EXPLAIN的输出时,即使看到了“IndexCond”,也应当注意一下预估返回行数。
seq_page_cost和random_page_cost
seq_page_cost和random_page_cost的默认值分别为1.0和4.0。这意味着PostgreSQL假设随机扫描比顺序扫描慢4倍;显然,PostgreSQL的默认值是基于HDD(普通硬盘)设置的。另一方面,近年来SSD得到了广泛的应用,
random_page_cost的默认值就显得太大了。使用SSD时如果仍然采用random_page_cost的默认值,则计划器有可能会选择低效的计划。因此当使用SSD时最好将random_page_cost的值设为1.0。这篇文章报告了使用
random_page_cost默认值导致的问题。
3.2.3 排序
排序路径(sort path) 会在排序操作中被使用。排序操作包括ORDER BY,归并连接的预处理操作,以及其他函数。函数cost_sort()用于估计排序操作的代价。
如果能在工作内存中放下所有元组,那么排序操作会选用快速排序算法。否则的话则会创建临时文件,使用文件归并排序算法。
排序路径的启动代价就是对目标表的排序代价,因此代价就是,这里就是待排序的元组数。排序路径的运行代价就是读取已经排好序的元组的代价,因而代价就是。
本节将研究以下查询排序代价的估计过程。假设该查询只使用工作内存,不使用临时文件。
在本例中,启动代价由以下公式定义:
这里就是上一次扫描的总代价,即上次索引扫描的总代价;由(15)可得C等于13.485;; 定义为。因此有
运行代价是在内存中读取排好序的元组的代价,即:
综上:
作为确认,以上SELECT查询的EXPLAIN命令结果如下:
在第4行可以看到启动代价和运行代价分别为22.97和23.57。
3.2.4 基数估计
前面的讨论都假设选择率可以被精确计算。然而在现实中,选择率估计从数据库系统诞生之初便一直是最棘手、最持久的问题之一。
3.2.4.1 选择率与基数
PostgreSQL内部主要使用选择率(Selectivity),而数据库领域通常更多讨论基数(Cardinality)。基数是一个整数,两者之间的关系为:
其中是表中的元组(行)总数。下文将主要使用“基数”这个术语。
3.2.4.2 基数估计为何困难
下面用一个具体例子说明基数估计的难点。假设数据库中记录着100名村民,residents表包含年龄类别age(未满18岁、青年、中年、老年)和驾照状态license(无驾照、普通驾照、金色驾照)。这里的“金色驾照”是日本的一种称谓,授予连续五年无事故、无违章的驾驶者。
数据库设置
表结构如下:
载入100行测试数据后执行ANALYZE:
测试数据的年龄分布如下:
| 年龄类别 | 频率 | 人数 |
|---|---|---|
under18 |
0.20 | 20 |
young |
0.25 | 25 |
middle |
0.35 | 35 |
elder |
0.20 | 20 |
驾照状态分布如下:
| 驾照状态 | 频率 | 人数 |
|---|---|---|
none |
0.40 | 40 |
standard |
0.55 | 55 |
gold |
0.05 | 5 |
可以从pg_stats中取得这些最常见值(MCV)及其频率:
未考虑相关性时的估计错误
下面查询未满18岁且没有驾照的居民,并用EXPLAIN ANALYZE比较计划器的估计值与实际结果:
估计基数为,实际行数却是。现实约束决定了未满18岁的人不能取得驾照,因此所有20名未成年人都必然属于none类别。
根本原因:错误地假设列相互独立
PostgreSQL计划器在默认假设两列相互独立的情况下,把under18的比例与none的比例相乘,得到:
大多数关系数据库的计划器在没有额外信息时都会假设各列相互独立,从而忽略数据之间可能存在的相关性。列之间的相关性越强,这种估计通常就越不准确。因此,基数估计至今仍是数据库研究中的活跃领域。
3.2.4.3 部分解决方案:扩展统计信息
PostgreSQL 10引入了多列扩展统计信息;PostgreSQL 12又加入了这里所使用的多列MCV统计。通过CREATE STATISTICS可以把age与license之间的相关性记录在一个统计对象中:
生成扩展统计信息后,未满18岁人群的估计结果与现实更加接近:
-
age = 'under18' AND license = 'none' -
age = 'under18' AND license = 'standard' -
age = 'under18' AND license = 'gold'
其中none的估计值为,与实际值完全一致;standard和gold仍被估为,可能来自取整或平滑处理,但已经比独立性假设下的估计明显更好。
扩展统计信息的限制: PostgreSQL扩展统计信息只能针对同一张表中的列建立,不能直接应用于多表连接。因此,连接操作的基数估计仍然很困难;尽管相关研究很多,目前仍没有普遍适用的实用方案。
3.3 创建单表查询的计划树
计划器非常复杂,故本节仅描述最简单的情况,即单表查询的计划树创建过程。更复杂的查询,换而言之即多表查询,其计划树创建过程将在第3.6节中阐述。
PostgreSQL中的计划器会执行三个处理步骤:
- 执行预处理
- 在所有可能的访问路径中,找出代价最小的访问路径
- 按照代价最小的路径,创建计划树
访问路径(access path)是估算代价时的处理单元;比如,顺序扫描,索引扫描,排序以及各种连接操作都有其对应的路径。访问路径只在计划器创建查询计划树的时候使用。最基本的访问路径数据结构就是pathnodes.h中定义的Path结构体。它就相当于是顺序扫描。所有其他的访问路径都基于该结构,下面会介绍细节。
计划器为了处理上述步骤,会在内部创建一个PlannerInfo数据结构。在该数据结构中包含着查询树,查询所涉及关系信息,访问路径等等。
本节会通过一个具体的例子,来描述如何基于查询树创建计划树。
3.3.1 预处理
在创建计划树之前,计划器对先PlannerInfo中的查询树进行一些预处理。
预处理有很多步骤,本节只讨论和单表查询处理相关的主要步骤。其他预处理操作将在3.6节中描述。
-
简化目标列表(target list),
LIMIT子句等;例如,表达式
2+2会被重写为4,这是由clauses.c中eval_const_expressions()函数负责的。 -
布尔表达式的规范化
例如,
NOT(NOT a)会被重写为a -
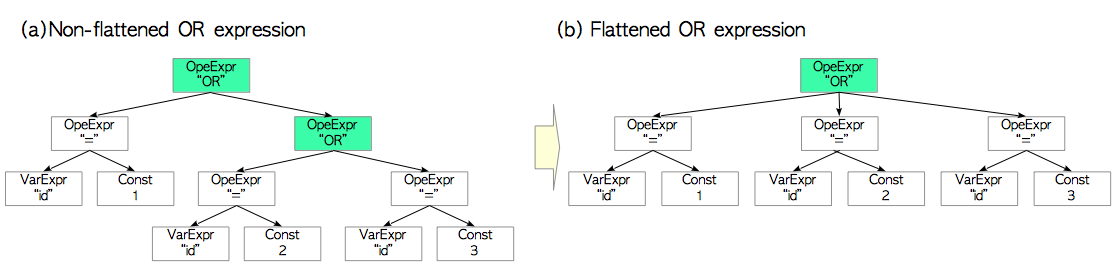
压平与/或表达式
SQL标准中的AND/OR是二元操作符;但在PostgreSQL内部它们是多元操作符。而计划器总是会假设所有的嵌套AND/OR都应当被压平。
这里有一个具体的例子。考虑这样一个布尔表达式
(id = 1) OR (id = 2) OR (id = 3),图3.9(a) 展示了使用二元表达式时的查询树,预处理会将这些二元算子简化压平为一个三元算子,如图3.9(b)所示。
3.3.2 找出代价最小的访问路径
计划器对所有可能的访问路径进行代价估计,然后选择代价最小的那个。具体来说,计划器会执行以下几个步骤:
-
创建一个
RelOptInfo数据结构,存储访问路径及其代价。RelOptInfo结构体是通过make_one_rel()函数创建的,并存储于PlannerInfo结构体的simple_rel_array字段中,如图3.10所示。在初始状态时RelOptInfo持有着baserestrictinfo变量,如果存在相应索引,还会持有indexlist变量。baserestrictinfo存储着查询的WHERE子句,而indexlist存储着目标表上相关的索引。 -
估计所有可能访问路径的代价,并将访问路径添加至
RelOptInfo结构中。这一处理过程的细节如下:
- 创建一条路径,估计该路径中顺序扫描的代价,并将其写入路径中。将该路径添加到
RelOptInfo结构的pathlist变量中。 - 如果目标表上存在相关的索引,则为每个索引创建相应的索引访问路径。估计所有索引扫描的代价,并将代价写入相应路径中。然后将索引访问路径添加到
pathlist变量中。 - 如果可以进行位图扫描,则创建一条位图扫描访问路径。估计所有的位图扫描的代价,并将代价写入到路径中。然后将位图扫描路径添加到
pathlist变量中。
- 创建一条路径,估计该路径中顺序扫描的代价,并将其写入路径中。将该路径添加到
-
从
RelOptInfo的pathlist中,找出代价最小的访问路径。 -
如有必要,估计
LIMIT,ORDER BY和AGGREGATE操作的代价。
为了更加清晰的理解计划器的执行过程,下面给出了两个具体的例子。
3.3.2.1 例1
首先来研究一个不带索引的简单单表查询;该查询同时包含WHERE和ORDER BY子句。
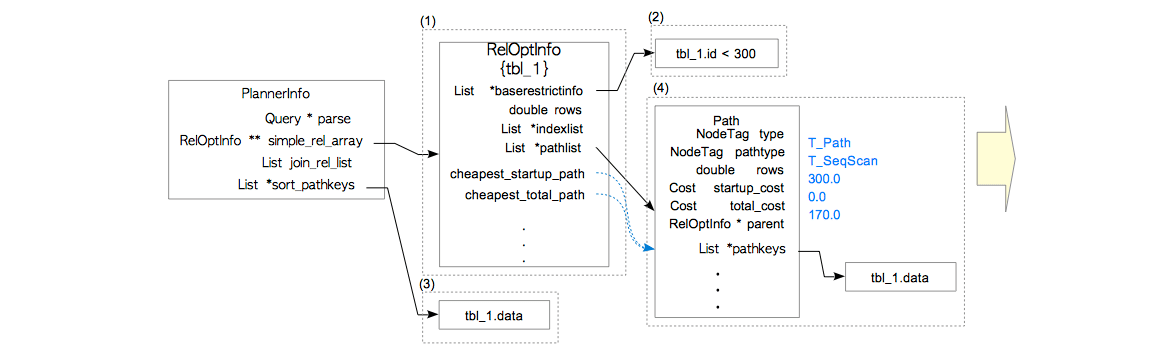
-
创建一个
RelOptInfo结构,将其保存在PlannerInfo结构的simple_rel_array字段中。 -
在
RelOptInfo结构的baserestrictinfo字段中,添加一条WHERE子句。WHERE子句id<300会经由initsplan.c中定义的distribute_restrictinfo_to_rels()函数,添加至列表变量baserestrictinfo中。另外由于目标表上没有相关索引,RelOptInfo的indexlist字段为空。 -
为了满足排序要求,
planner.c中的standard_qp_callback()函数会在PlannerInfo的sor_pathkeys字段中添加一个pathkey。Pathkey是表示路径排序顺序的数据结构。本例因为查询包含一条ORDER BY子句,且该子句中的列为data,故data会被包装为pathkey,放入列表变量sort_pathkeys中。 -
创建一个
Path结构,并使用cost_seqscan函数估计顺序扫描的代价,并将代价写入Path中。然后使用pathnode.c中定义的add_path()函数,将该路径添加至RelOptInfo中。如之前所提到过的,
Path中同时包含启动代价和总代价,都是由cost_seqscan函数所估计的。
在本例中,因为目标表上没有索引,计划器只估计了顺序扫描的代价,因此最小代价是自动确定的。
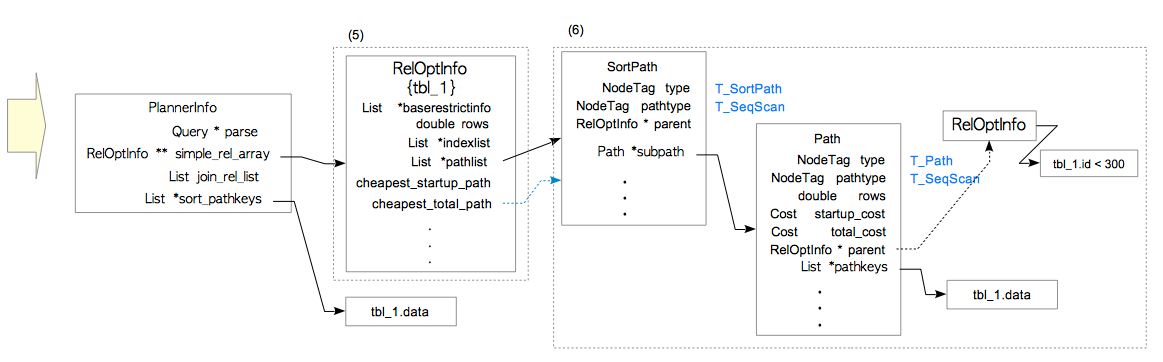
-
创建一个新的
RelOptInfo结构,用于处理ORDER BY子句。注意新的
RelOptInfo没有baserestrictinfo字段,该信息已经被WHERE子句所持有。 -
创建一个排序路径,并添加到新的
RelOptInfo中;然后让SortPath的subpath字段指向顺序扫描的路径。SortPath结构包含两个Path结构:path与subpath;path中存储了排序算子本身的相关信息,而subpath则指向之前得到的代价最小的路径。注意顺序扫描路径中
parent字段,该字段指向之前的RelOptInfo结构体(也就是在baserestrictinfo中存储着WHERE子句的那个RelOptInfo)。因此在下一步创建计划树的过程中,尽管新的RelOptInfo结构并未包含baserestrictinfo,但计划器可以创建一个包含Filter的顺序扫描节点,将WHERE子句作为过滤条件。
这里已经获得了代价最小的访问路径,然后就可以基于此生成一棵计划树。3.3.3节描述了相关的细节。
3.3.2.2 例2
下面我们将研究另一个单表查询的例子,这一次表上有两个索引,而查询带有一个WHERE子句。
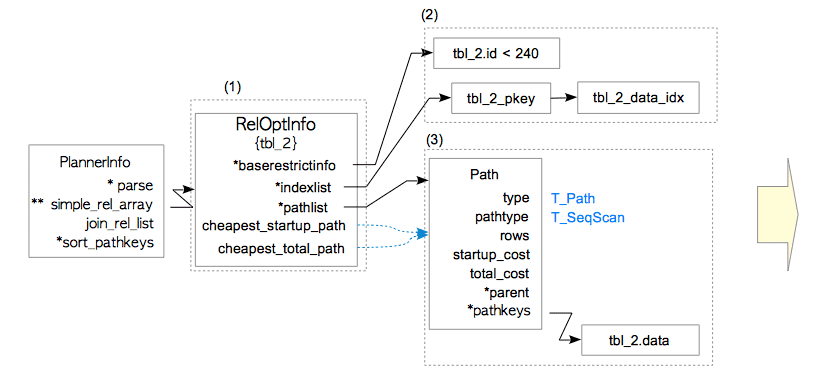
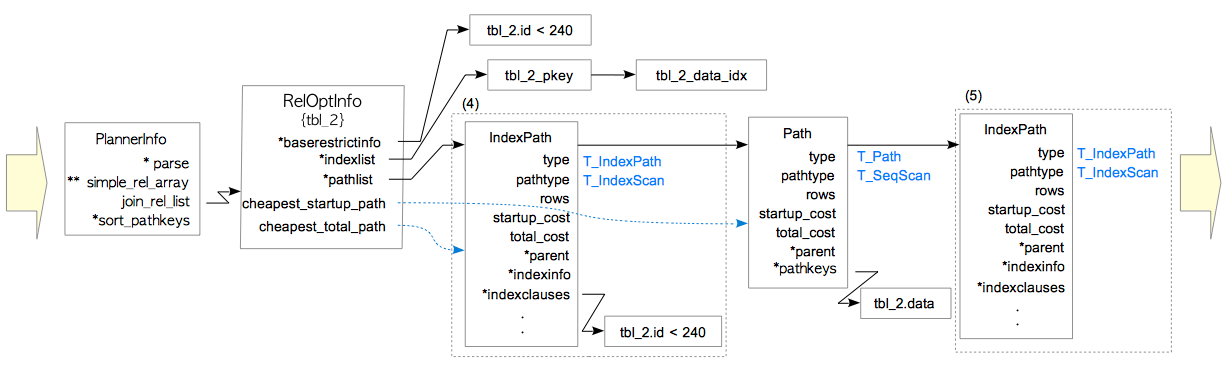
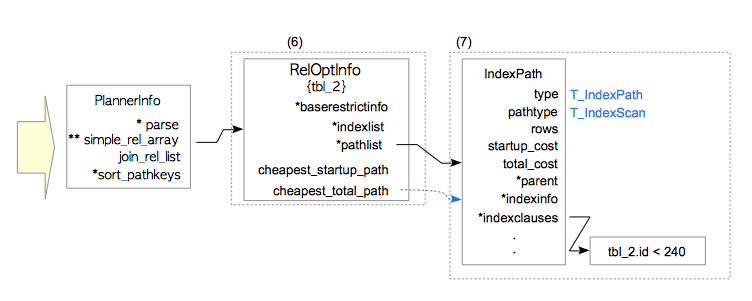
图3.12到3.14展示了本例中计划器的处理过程。
-
创建一个
RelOptInfo结构体 -
在
baserestrictinfo中添加一个WHERE子句;并将目标表上的索引(们)添加到indexlist中。在本例中,
WHERE子句'id <240'会被添加至baserestrictinfo中,而两个索引:tbl_2_pkey和tbl_2_data_idx会被添加至RelOptInfo的列表变量indexlist中。 -
创建一条路径,估计其顺序扫描代价,并添加到
RelOptInfo的pathlist中。
-
创建一个
IndexPath,估计索引扫描的代价,并通过add_path()函数将IndexPath添加到RelOptInfo的pathlist中。在本例中有两个索引:
tbl_2_pkey与tbl_2_data_index,这些索引会按先后顺序依次处理。一条针对
tbl_2_pkey的IndexPath会先被创建出来,并进行启动代价与总代价的评估。在本例中,tbl_2_pkey是id列上的索引,而WHERE子句也包含该id列;因此WHERE子句会被存储在IndexPath的indexclauses字段中。 -
创建另一个
IndexPath,估计另一种索引扫描的代价,并将该IndexPath添加到RelOptInfo的pathlist中。接下来,与
tbl_2_data_idx相应的IndexPath会被创建出来,并进行代价估计。本例中tbl_2_data_idx并没有相关的WHERE子句;因此其indexclauses为空。
注意
add_path()函数并不总是真的会将路径添加到路径列表中。这一操作相当复杂,故这里就省去了具体描述。详细细节可以参考add_path()函数的注释。
-
创建一个新的
RelOptInfo结构 -
将代价最小的路径,添加到新
RelOptInfo的pathlist中。本例中代价最小的路径是使用
tbl_2_pkey的索引路径;故将该路径添加到新的RelOptInfo中。
3.3.3 创建计划树
在最后一步中,计划器按照代价最小的路径生成一棵计划树。
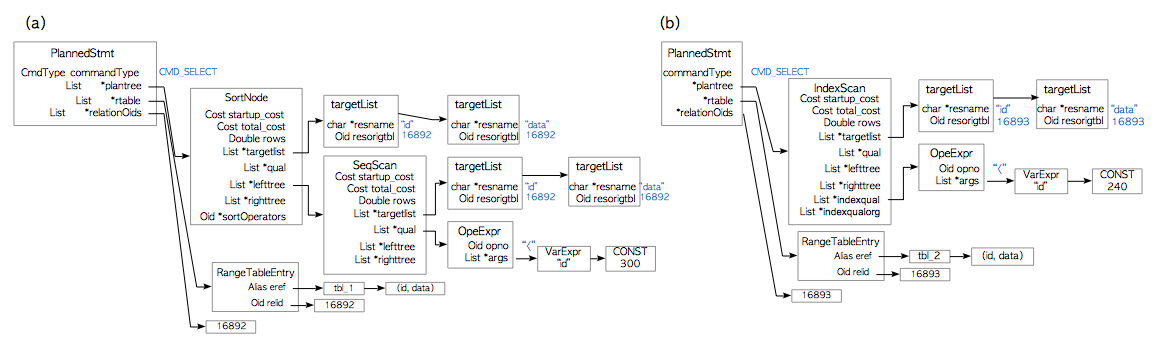
计划树的根节点是定义在plannodes.h中的PlannedStmt结构,包含19个字段,其中有4个代表性字段:
commandType存储操作的类型,诸如SELECT,UPDATE和INSERT。rtable存储范围表的列表(RangeTblEntry的列表)。relationOids存储与查询相关表的oid。plantree存储着一棵由计划节点组成的计划树,每个计划节点对应着一种特定操作,诸如顺序扫描,排序和索引扫描。
如上所述,计划树包含各式各样的计划节点。PlanNode是所有计划节点的基类,其他计划节点都会包含PlanNode结构。比如顺序扫描节点SeqScanNode,包含一个PlanNode和一个整型变量scanrelid。PlanNode包含14个字段。下面是7个代表性字段:
startup_cost和total_cost是该节点对应操作的预估代价。rows是计划器预计扫描的行数。targetlist保存了该查询树中目标项的列表。qual储存了限定条件的列表。lefttree和righttree用于添加子节点。
下面是两颗计划树,分别与前一小节中的两个例子对应。
3.3.3.1 例1
第一个例子是3.3.2.1节例1对应的计划树。图3.11所示的代价最小的路径,是由一个排序路径和一个顺序扫描路径组合而成。根路径是排序路径,而其子路径为顺序扫描路径。尽管这里忽略了大量细节,但是从代价最小的路径中生成计划树的过程是显而易见的。在本例中,一个 SortNode被添加到PlannedStmt结构中,而SortNode的左子树上则挂载了一个SeqScanNode,如图3.15(a)所示。
在SortNode中,左子树lefttree指向SeqScanNode。
在SeqScanNode中,qual保存了WHERE子句:'id<300'。
3.3.3.2 例2
第二个例子是3.3.2.2节例2对应的计划树。其代价最小的路径为索引扫描路径,如图3.14所示。因此计划树由单个IndexScanNode独立组成,如图3.15(b)所示。
在本例中,WHERE子句id < 240是一个访问谓词,它储存在IndexScanNode的indexqual字段中。
3.4 执行器如何工作
3.4.1 执行器的基本工作方式
在单表查询的例子中,执行器从计划树中取出计划节点,按照自底向上的顺序进行处理,并调用节点相应的处理函数。
每个计划节点都有相应的函数,用于执行节点对应的操作。这些函数位于src/backend/executor目录中。例如,执行顺序扫描的函数(SeqScan)定义于nodeSeqscan.c;执行索引扫描的函数(IndexScan)定义于nodeIndexscan.c;Sort节点对应的排序函数定义于nodeSort.c。
当然,理解执行器如何工作的最好方式,就是阅读EXPLAIN命令的输出。因为PostgreSQL的EXPLAIN命令几乎就是照着计划树输出的。下面以3.3.3节的例1为例。
我们可以自底向上阅读EXPLAIN的结果,来看一看执行器是如何工作的。
第6行:首先,执行器通过nodeSeqscan.c中定义的函数执行顺序扫描操作。
第4行:然后,执行器通过nodeSort.c中定义的函数,对顺序扫描的结果进行排序。
临时文件
执行器在处理查询时会使用工作内存(
work_mem)和临时缓冲区(temp_buffers),两者都于内存中分配。如果查询无法在内存中完成,就会用到临时文件。使用带有
Analyze选项的EXPLAIN,待解释的命令会真正执行,并显示实际结果行数,实际执行时间和实际内存用量。下面是一个具体的例子:在第6行,
EXPLAIN命令显示出执行器使用了10000KB的临时文件。临时文件会被临时创建于
base/pg_tmp子目录中,并遵循如下命名规则比如,临时文件
pgsql_tmp8903.5是pid为8903的postgres进程创建的第6个临时文件
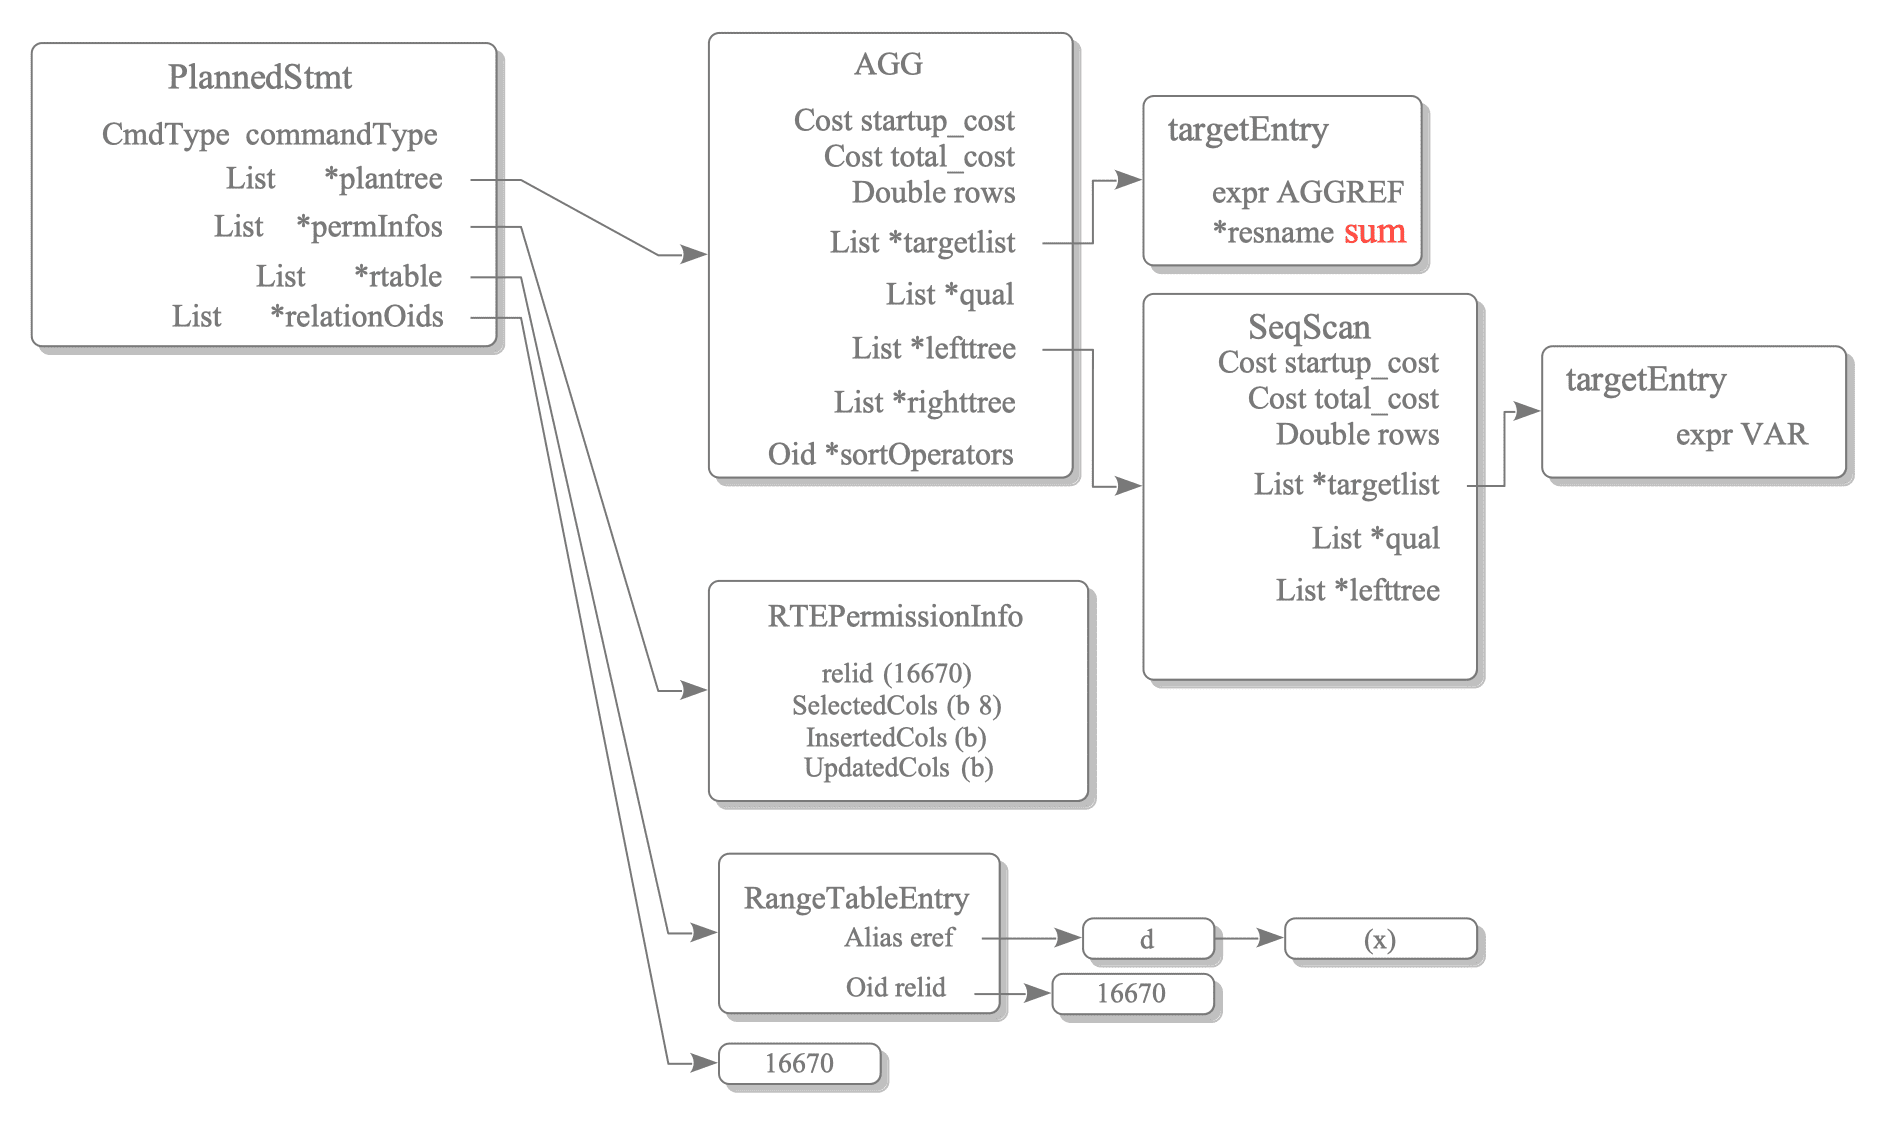
3.4.2 聚合函数
以下面的表和查询为例:
图3.4-1对应新版英文原著的图3.17。为避免与中文旧译本已有图号冲突,这里采用补充编号。
SeqScan顺序扫描目标表并把列x交给Aggregate节点;Aggregate再按sum、avg、variance或count等指定聚合执行处理。
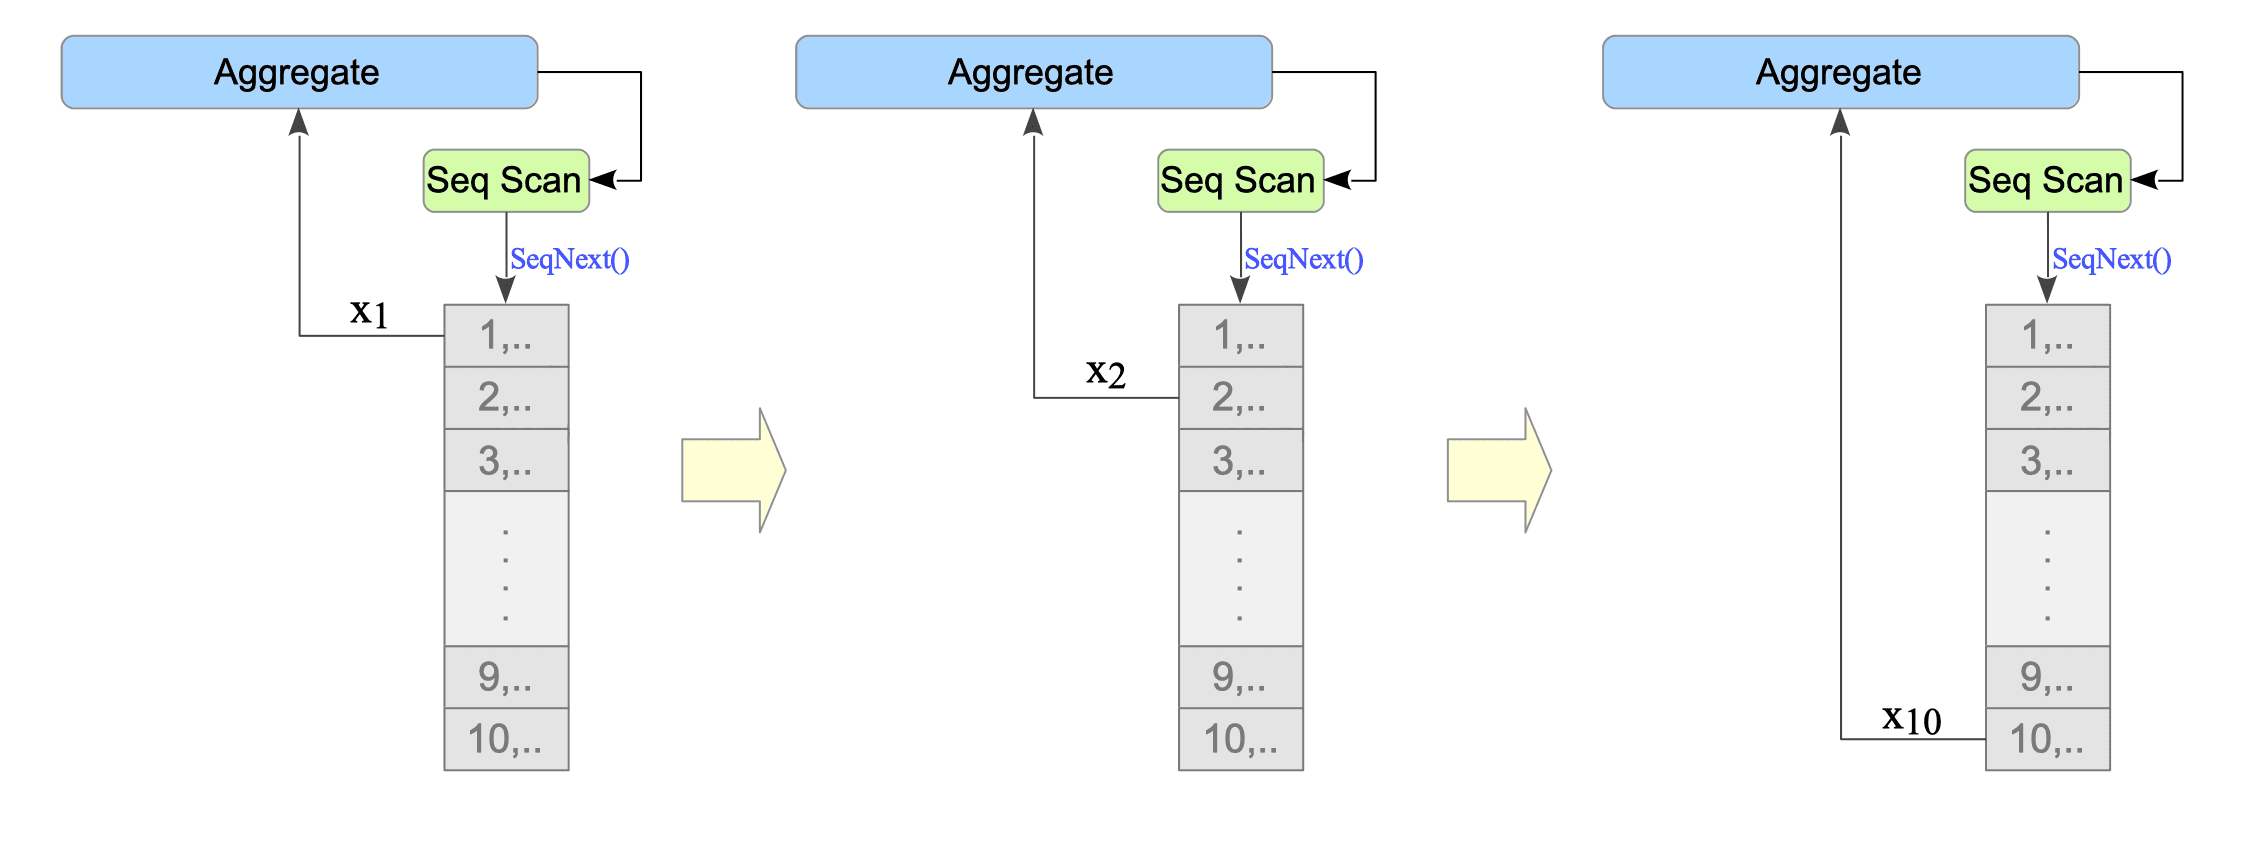
3.4.2.1 求和与平均值
和与平均值定义为:
Aggregate节点逐个累积扫描值;求和在最后直接返回累积值,平均值则再除以处理过的行数:
3.4.2.2 方差
把平方离差和定义为:
PostgreSQL提供样本方差var_samp()和总体方差var_pop()。
3.4.2.2.1 PostgreSQL 11及以前的单遍算法
直接按定义计算需要先求平均值,再扫描一次求平方离差。旧版本使用以下恒等式把计算缩减为一遍:
执行器同时维护与,但浮点数相减时可能发生灾难性消去,影响精度。
3.4.2.2.2 PostgreSQL 12及以后的Youngs与Cramer算法
PostgreSQL 12采用数值稳定性更好的递推算法:
完整公式推导见附录A.1。
3.4.3 约束
执行INSERT、UPDATE或DELETE时,执行器会检查目标表约束。以插入单个元组为例,ExecInsert()的主要流程为:
3.4.3.1 NOT NULL与CHECK
ExecConstraints()检查NOT NULL,并通过ExecRelCheck()求值CHECK表达式。约束定义保存在pg_constraint;PostgreSQL把定义加载到内存,为每个插入或更新元组求值。
3.4.3.2 PRIMARY KEY与UNIQUE
向唯一索引插入索引元组时,PostgreSQL直接检查索引中是否已有冲突键。B-tree由_bt_check_unique()执行,复杂度约为。UPDATE使用相同机制。
3.4.3.3 FOREIGN KEY
外键需要检查另一张表,实现更加复杂:
PostgreSQL 18及以前,插入子表时外键触发器会通过SPI生成并执行类似查询:
FOR KEY SHARE锁住被引用行,防止并发事务在检查期间删除该行或修改引用键。内部SQL仍需经过查询处理,因此每次外键检查都有额外开销。
PostgreSQL 19开发版增加了直接外键验证路径:若被引用的主键或唯一约束有合适索引,就直接探测索引,无需经SPI执行内部SELECT;仍会获取必要的行锁。没有合适索引时退回传统SPI路径。语义不变,但能降低许多INSERT和UPDATE工作负载中的检查成本。
3.5 连接
PostgreSQL 中支持三种 连接(JOIN) 操作:嵌套循环连接(Nested Loop Join)、归并连接(Merge Join)、散列连接(Hash Join)。在PostgreSQL中,嵌套循环连接与归并连接有几种变体。
在下文中,我们会假设读者已经对这三种操作的基本行为有了解。如果读者对这些概念不熟悉,可以参阅[1, 2]。PostgreSQL支持一种针对数据倾斜的混合散列连接(hybrid hash join),关于这方面的资料不多,因此这里会详细描述该操作。
需要注意的是,这三种 连接方法(join method) 都支持PostgreSQL中所有的连接操作,诸如INNER JOIN,LEFT/RIGHT OUTER JOIN,FULL OUTER JOIN等;但是为了简单起见,这里只关注NATURAL INNER JOIN。
3.5.1 嵌套循环连接(Nested Loop Join)
嵌套循环连接是最为基础的连接操作,任何 连接条件(join condition) 都可以使用这种连接方式。PostgreSQL支持嵌套循环连接及其五种变体。
3.5.1.1 嵌套循环连接
嵌套循环连接无需任何启动代价,因此:
运行代价与内外表尺寸的乘积成比例;即是,这里和分别是外表和内表的元组条数。更准确的说,的定义如下:
这里和分别是内表和外表顺序扫描的代价;
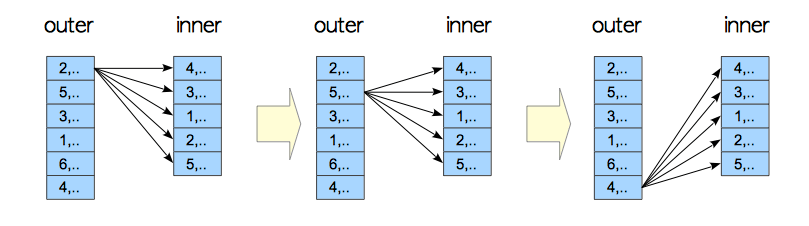
嵌套循环连接的代价总是会被估计,但实际中很少会使用这种连接操作,因为它有几种更高效的变体,下面将会讲到。
3.5.1.2 物化嵌套循环连接
在上面描述的嵌套循环连接中,每当读取一条外表中的元组时,都需要扫描内表中的所有元组。为每条外表元组对内表做全表扫描,这一过程代价高昂,PostgreSQL支持一种物化嵌套循环连接(materialized nested loop join) ,可以减少内表全表扫描的代价。
在运行嵌套循环连接之前,执行器会使用 临时元组存储(temporary tuple storage) 模块对内表进行一次扫描,将内表元组加载到工作内存或临时文件中。在处理内表元组时,临时元组存储比缓冲区管理器更为高效,特别是当所有的元组都能放入工作内存中时。
图 3.17说明了物化嵌套循环连接的处理过程。扫描物化元组在内部被称为重扫描(rescan)。
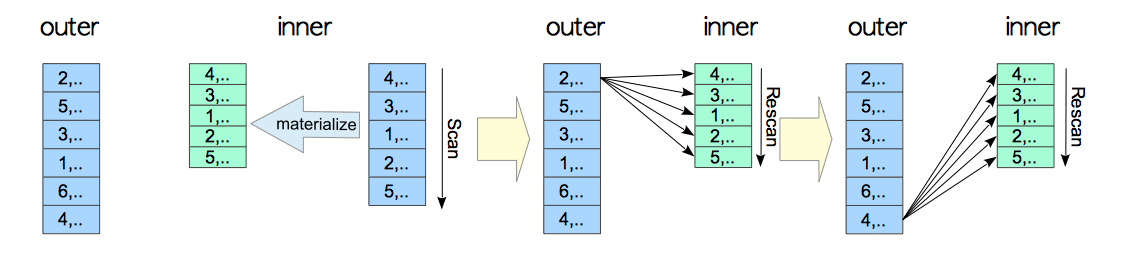
临时元组存储
PostgreSQL内部提供了临时元组存储的模块,可用于各种操作:物化表,创建混合散列连接的批次,等等。该模块包含一系列函数,都在
tuplestore.c中。这些函数用于从工作内存或临时文件读写元组。使用工作内存还是临时文件取决于待存储元组的总数。
下面给出一个具体的例子,并研究一下执行器是如何处理物化嵌套循环连接的计划树并估计其代价的。
上面显示了执行器要进行的操作,执行器对这些计划节点的处理过程如下:
第7行:执行器使用顺序扫描,物化内部表tbl_b。
第4行:执行器执行嵌套循环连接操作,外表是tbl_a,内表是物化的tbl_b。
下面来估算“物化”操作(第7行)与“嵌套循环”(第4行)的代价。假设物化的内部表元组都在工作内存中。
物化(Materialize):
物化操作没有启动代价;因此,
其运行代价定义如下:
因此:
此外,
因此,
(物化)嵌套循环:
嵌套循环没有启动代价,因此:
在估计运行代价之前,先来看一下重扫描的代价,重扫描的代价定义如下:
这本例中:
运行代价由以下公式定义:
这里外部表的全部扫描代价为:
而物化代价表示为:
因此最终带入求得:
3.5.1.3 索引嵌套循环连接
如果内表上有索引,且该索引能用于搜索满足连接条件的元组。那么计划器在为外表的每条元组搜索内表中的匹配元组时,会考虑使用索引进行直接搜索,以替代顺序扫描。这种变体叫做索引嵌套循环连接(indexed nested loop join),如图3.18所示。尽管这种变体叫做索引"嵌套循环连接",但该算法基本上只需要在在外表上循环一次,因此连接操作执行起来相当高效。
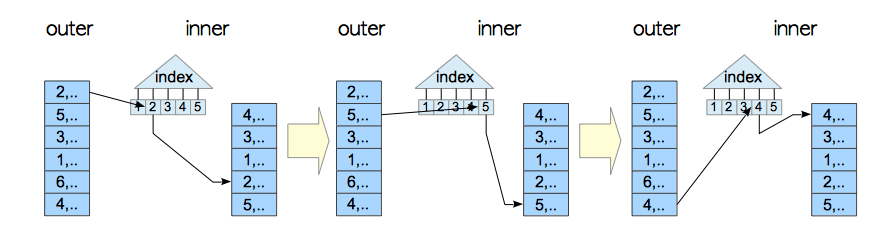
下面是索引嵌套循环连接的一个具体例子。
第6行展示了访问内表中元组的代价。即在内表中查找满足第七行连接条件(id = b.id)的元组的代价。
在第7行的索引条件(id = b.id)中,b.id是连接条件中的外表属性的值。每当顺序扫描外表取回一条元组时,就会依第6行所示的索引搜索路径,查找内表中需要与之连接的元组。换而言之,外表元组的值作为参数传入内表的索引扫描中,索引扫描路径会查找满足连接条件的内表元组。这种索引路径被称为参数化(索引)路径(parameterized (index) path),细节见PostgreSQ源码:backend/optimizer/README。
该嵌套循环连接的启动代价,等于第6行中索引扫描的代价,因此:
索引嵌套循环扫描的总代价由下列公式所定义:
这里是参数化内表索引扫描的整体代价,
在本例中:
而运行代价为:
如上所示,索引嵌套扫描的整体代价是。
3.5.1.4 其他变体
如果在外表上存在一个与连接条件相关的索引,那么在外表上也可以以索引扫描替代顺序扫描。特别是,当WHERE子句中的访问谓词可以使用该索引时,能缩小外表上的搜索范围,嵌套循环连接的代价可能会急剧减少。
当使用外表索引扫描时,PostgreSQL支持三种嵌套循环连接的变体,如图3.19所示。
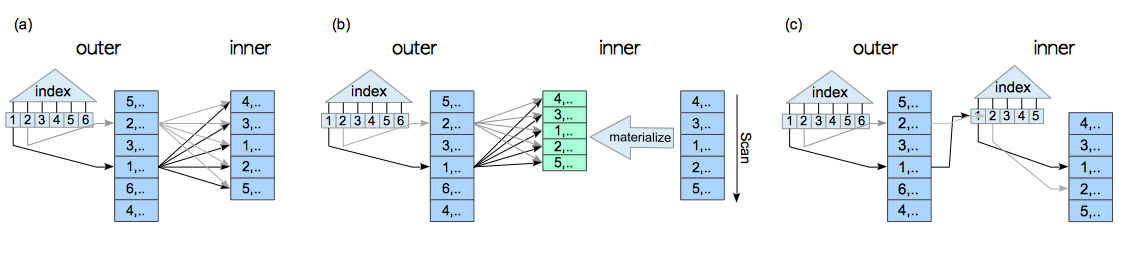
这些连接的EXPLAIN结果如下:
-
使用外表索引扫描的嵌套循环连接
-
使用外表索引扫描的物化嵌套循环连接
-
使用外表索引扫描的索引嵌套循环连接
3.5.2 归并连接(Merge Join)
与嵌套循环连接不同的是,归并连接(Merge Join) 只能用于自然连接与等值连接。
函数initial_cost_mergejoin()和final_cost_mergejoin()用于估计归并连接的代价。
因为精确估计归并连接的代价非常复杂,因此这里略过不提,只会说明归并连接算法的工作流程。归并连接的启动成本是内表与外表排序成本之和,因此其启动成本为:
这里和是分别是外表和内表的元组条数,而运行代价是。
与嵌套循环连接类似,归并连接在PostgreSQL中有4种变体。
3.5.2.1 归并连接
图3.20是归并连接的概念示意图。
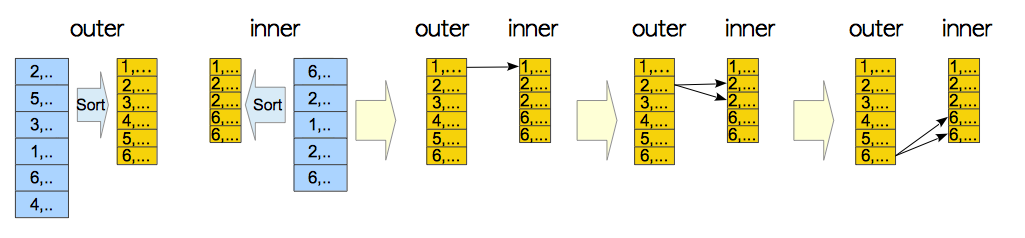
如果所有元组都可以存储在内存中,那么排序操作就能在内存中进行,否则会使用临时文件。
下面是一个具体的例子,一个归并连接的EXPLAIN输出如下所示。
- 第9行:执行器对内表
tbl_b进行排序,使用顺序扫描(第11行)。 - 第6行:执行器对外表
tbl_a进行排序,使用顺序扫描(第8行)。 - 第4行:执行器执行归并连接操作,外表是排好序的
tbl_a,内表是排好序的tbl_b。
3.5.2.2 物化归并连接
与嵌套循环连接类似,归并连接还支持物化归并连接(Materialized Merge Join),物化内表,使内表扫描更为高效。
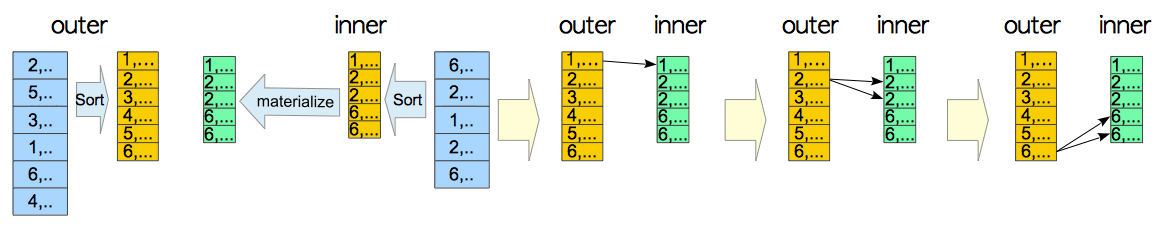
这里是物化归并连接的EXPLAIN结果,很容易发现,与普通归并连接的差异是第9行:Materialize。
- 第10行:执行器对内表
tbl_b进行排序,使用顺序扫描(第12行)。 - 第9行:执行器对
tbl_b排好序的结果进行物化。 - 第6行:执行器对外表
tbl_a进行排序,使用顺序扫描(第8行)。 - 第4行:执行器执行归并连接操作,外表是排好序的
tbl_a,内表是物化的排好序的tbl_b。
3.5.2.3 其他变体
与嵌套循环连接类似,当外表上可以进行索引扫描时,归并连接也存在相应的变体。
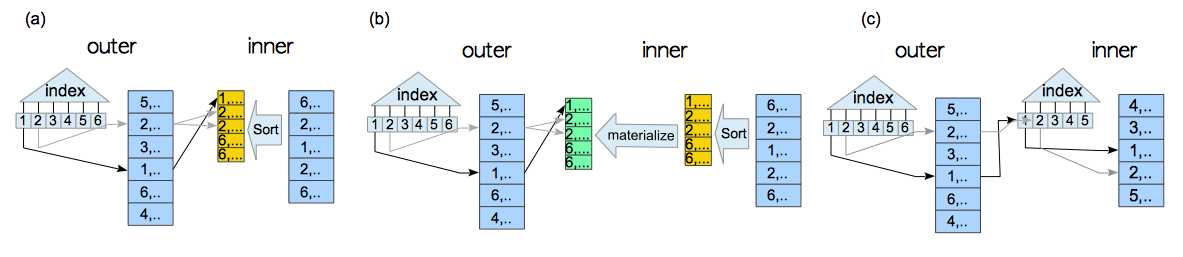
这些连接的EXPLAIN结果如下。
-
使用外表索引扫描的归并连接
-
使用外表索引扫描的物化归并连接
-
使用外表索引扫描的索引归并连接
3.5.3 散列连接(Hash Join)
与归并连接类似,散列连接(Hash Join) 只能用于自然连接与等值连接。
PostgreSQL中的散列连接的行为因表的大小而异。 如果目标表足够小(确切地讲,内表大小不超过工作内存的25%),那么散列连接就是简单的两阶段内存散列连接(two-phase in-memory hash join) ; 否则,将会使用带倾斜批次的混合散列连接(hybrid hash join)。
本小节将介绍PostgreSQL中这两种散列连接的执行过程。
这里省略了代价估算的部分,因为它很复杂。粗略来说,假设向散列表插入与搜索时没有遇到冲突,那么启动和运行成本复杂度都是。
3.5.3.1 内存散列连接
下面将描述内存中的散列连接。
内存中的散列连接是在work_mem中处理的,在PostgreSQL中,散列表区域被称作处理批次(batch)。 一个处理批次会有多个散列槽(hash slots),内部称其为桶(buckets),桶的数量由nodeHash.c中定义的ExecChooseHashTableSize()函数所确定。 桶的数量总是2的整数次幂。
内存散列连接有两个阶段:构建(build) 阶段和 探测(probe) 阶段。 在构建阶段,内表中的所有元组都会被插入到batch中;在探测阶段,每条外表元组都会与处理批次中的内表元组比较,如果满足连接条件,则将两条元组连接起来。
为了理解该操作的过程,下面是一个具体的例子。 假设该查询中的连接操作使用散列连接。
散列连接的过程如图3.23和3.24所示。
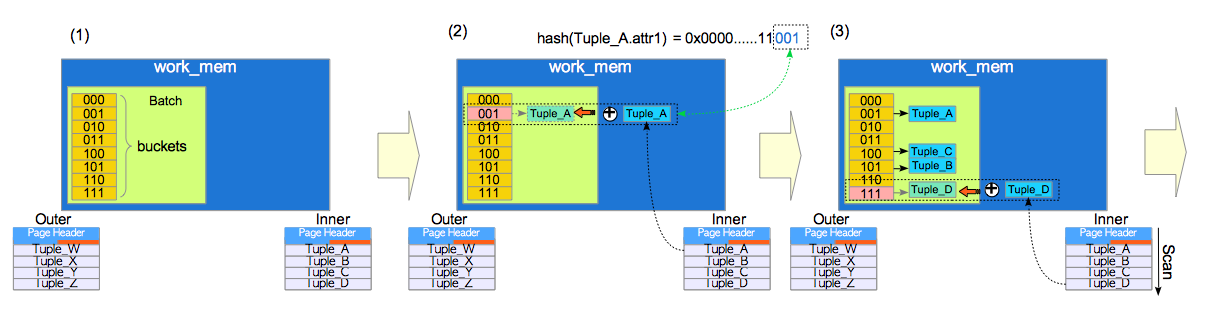
-
在工作内存上创建一个处理批次。
在本例中,处理批次有八个桶;即桶的数量是2的3次方。
-
将内表的第一个元组插入批次的相应的桶中。
具体过程如下:
-
找出元组中涉及连接条件的属性,计算其散列键。
在本例中,因为
WHERE子句是inner.attr1 = outer.attr2,因此内置的散列函数会对第一条元组的属性attr1取散列值,用作散列键。 -
将第一条元组插入散列键相应的桶中。
假设第一条元组的散列键以二进制记法表示为
0x000 ... 001,即其末三 位(bit) 为001。 在这种情况下,该元组会被插入到键为001的桶中。
在本文中,构建处理批次的插入操作会用运算符 ⊕ 表示。
-
-
插入内表中的其余元组。
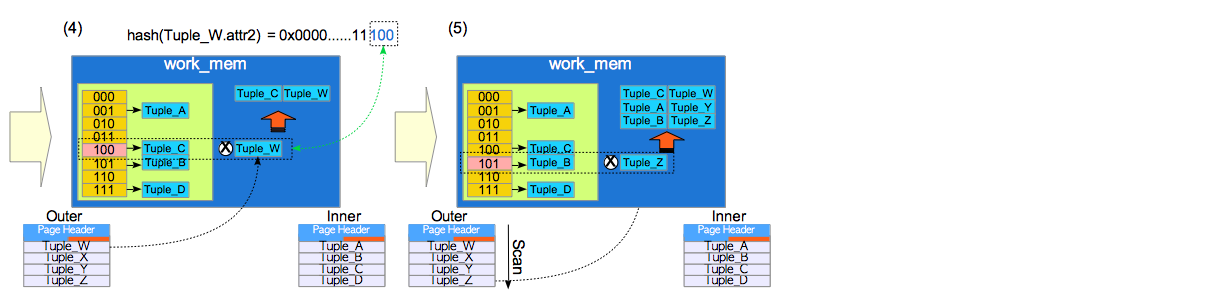
-
依外表的第一条元组进行探测。
详情如下:
-
找出第一条外表元组中涉及连接条件的属性,计算其散列键。
在这个例子中,假设第一条元组的属性
attr2的散列键是0x000 ... 100,即其末三 位(bit) 为100。 最后三位是100。 -
将外表中第一条元组与批次中的内表元组进行比较。如果满足连接条件,则连接内外表元组。
因为第一个元组的散列键的末三位为
100,执行器找出键为100的桶中的所有内表元组,并对内外表元组两侧相应的属性进行比较。这些属性由连接条件(在WHERE子句中)所指明。如果满足连接条件,执行器会连接外表中的第一条元组与内表中的相应元组。如果不满足则执行器不做任何事情。
在本例中,键为
100的桶中有Tuple_C。如果Tuple_C的attr1等于第一条元组(Tuple_W)的attr2,则Tuple_C和Tuple_W将被连接,并保存至内存或临时文件中。
在本文中,处理批次的探测操作用运算符 ⊗ 表示。
-
-
依次对外表中的其他元组执行探测。
3.5.3.2 带倾斜的混合散列连接
当内表的元组无法全部存储在工作内存中的单个处理批次时,PostgreSQL使用带倾斜批次的混合散列连接算法,该算法是混合散列连接的一种变体。
首先,这里会描述混合散列连接的基本概念。在第一个构建和探测阶段,PostgreSQL准备多个批次。与桶的数目类似,处理批次的数目由函数ExecChooseHashTableSize()决定,也总是2的整数次幂。工作内存中只会分配一个处理批次,而其他批次作都以临时文件的形式创建。属于这些批次的元组将通过临时元组存储功能,被写入到相应的文件中。
图3.25说明了如何将元组存储在四个()处理批次中。在本例中元组散列键的最后五个比特位决定了元组所属的批次与桶,因为处理批次的数量为,而桶的数量为,因此需要5个比特位来表示,其中前两位决定了元组所属的批次,而后三位决定了元组在该批次中所属的桶。例如:Batch_0存储着散列键介于与的元组;而Batch_1存储着散列键介于与的元组,依此类推。
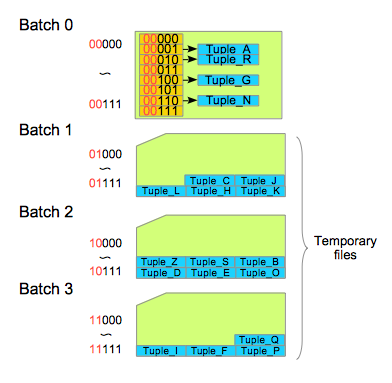
在混合散列连接中,构建与探测阶段的执行次数与处理批次的数目相同,因为内外表元组都被存至相同数量的处理批次中。在第一轮构建与探测阶段中,除了处理第一个处理批次,还会创建所有的处理批次。另一方面,第二轮及后续的处理批次都需要读写临时文件,这属于代价巨大的操作。因此PostgreSQL还准备了一个名为skew的特殊处理批次,即倾斜批次,以便在第一轮中高效处理尽可能多的元组。
这个特殊的倾斜批次中的内表元组在连接条件内表一侧属性上的取值,会选用外表连接属性上的高频值(MCV)。因此在第一轮处理中能与外表中尽可能多的元组相连接。这种解释不太好理解,因此下面给出了一个具体的例子。
假设有两个表:客户表customers与购买历史表purchase_history。customers由两个属性组成:name和address; purchase_history由两个属性组成:customer_name和buying_item。customers有10,000行,而purchase_history表有1,000,000行。前10%的客户进行了70%的购买。
理解了这些假设,让我们考虑当执行以下查询时,带倾斜的混合散列连接的第一轮是如何执行的。
如果customers是内表,而purchase_history是外表,则PostgreSQL将使用purchase_history表的高频值值,将前10%的customers元组存储于倾斜批次中。 请注意这里引用的是外表上的高频值,而插入倾斜批次的是内表元组。 在第一轮的探测阶段,外表(purchase_history)中70%的元组将与倾斜批次中存储的元组相连接。 因此,外表分布越是不均匀,第一轮中越是可以处理尽可能多的元组。
接下来会介绍带倾斜批次的混合散列连接的工作原理,如图3.26至3.29所示。
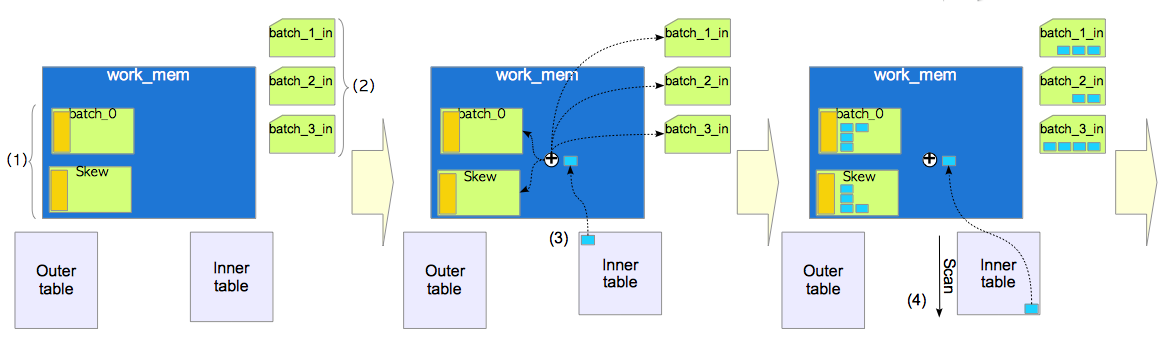
-
在工作内存中创建一个处理批次,以及一个倾斜批次。
-
创建处理批次相应的临时文件,用于存储排好序的内表元组。
在本例中,内表被分割为四个批次,因此创建了三个批次文件。
-
为内表的第一条元组执行构建操作。
细节如下:
-
如果第一条元组应当插入倾斜批次中,则将其插入倾斜批次;否则继续下一步。
在该例中,如果第一条元组属于前10%的客户,则将其插入到倾斜批次中。
-
计算第一条元组的散列键,然后将其插入相应的处理批次。
-
-
对内表其余元组依次执行构建操作。
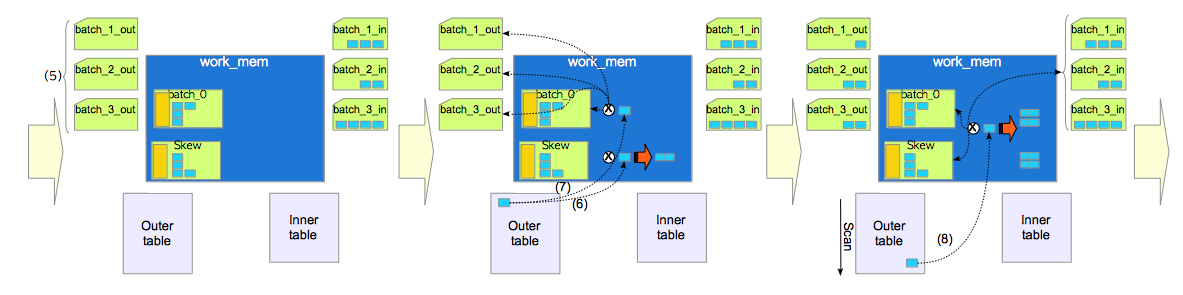
-
创建临时处理批次文件,用于外表排序。
-
为外表的第一条元组执行探测操作,如果外表第一条元组上相应字段取值为MCV,则在倾斜批次上进行探测,否则进行第七步。
在本例中,如果第一条元组是前10%客户的购买数据,则它会与倾斜批次中的内表元组进行比较。
-
为外表的第一条元组执行探测操作。
操作的内容取决于该元组散列键的取值。如果该元组属于
Batch_0则直接完成探测操作;否则将其插入相应的外表处理批次中。 -
为外表的其余元组执行探测操作。
注意在本例中,外表中70%的元组已经在第一轮中的倾斜批次中处理了。
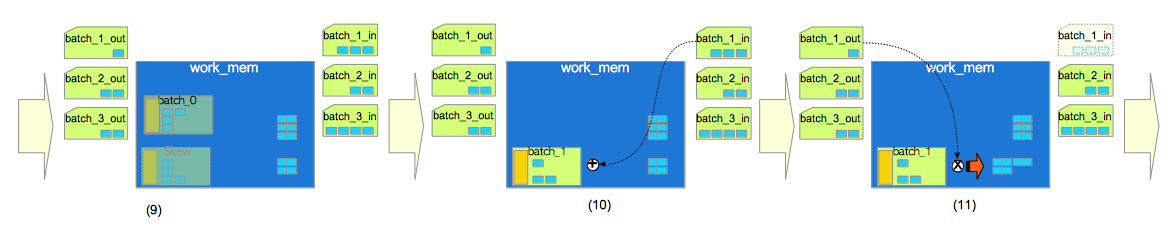
-
移除倾斜批次与
Batch_0,为下一轮处理批次腾地方。 -
为批次文件
batch_1_in中的内表元组执行构建操作。 -
为批次文件
batch_1_out中的外表元组依次执行探测操作。
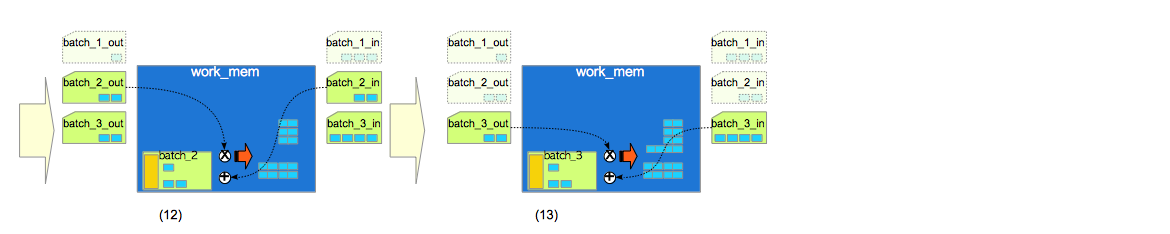
-
为批次文件
batch_2_in与batch_2_out执行构建操作与探测操作。 -
为批次文件
batch_3_in与batch_3_out执行构建操作与探测操作。
3.5.3.3 哈希连接中的索引扫描
只要条件允许,PostgreSQL也会在哈希连接的探测端使用索引扫描:
探测阶段根据aid索引只取出满足范围条件的pgbench_accounts元组,减少需要与哈希表比较的外表元组数,从而提高整体性能。
3.5.4 连接访问路径与连接节点
3.5.4.1 连接访问路径
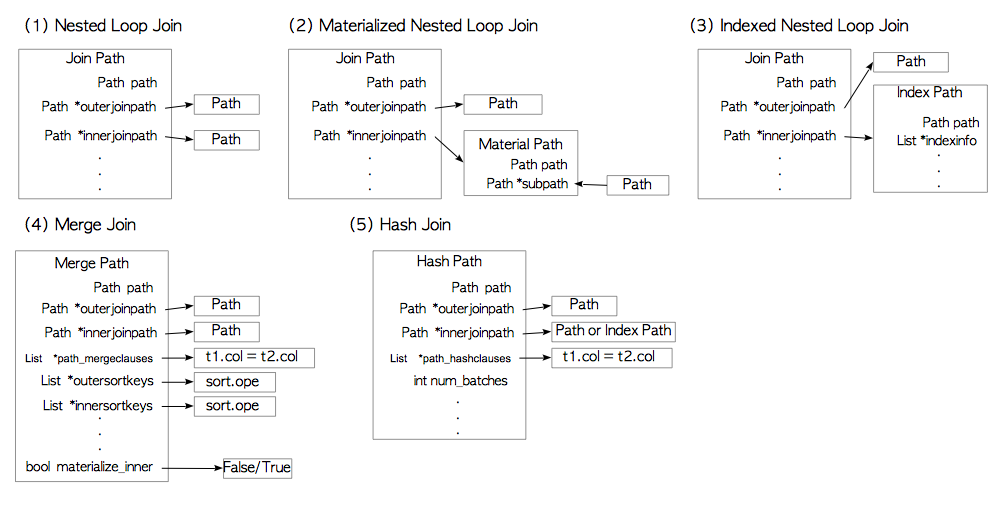
嵌套循环连接的访问路径由JoinPath结构表示,其他连接访问路径,诸如MergePath与HashPath都基于其实现。
下图列出了所有的连接访问路径,细节略过不提。
3.5.4.2 连接节点
本小节列出了三种连接节点:NestedLoopNode,MergeJoinNode 和HashJoinNode,它们都基于JoinNode实现,细节略过不提。
3.6 创建多表查询计划树
本节将说明多表查询计划树的创建过程。
3.6.1 预处理
预处理由planner.c中定义的subquery_planner()函数执行。第3.3.1节已经描述了单表查询的预处理。本节将描述多表查询的预处理;尽管这块内容很多,但这里只会挑其中一部分来讲。
-
对CTE进行计划与转换
如果存在
WITH列表,计划器就会通过SS_process_ctes()函数对每个WITH查询进行处理。 -
上拉子查询
如果
FROM子句带有一个子查询,且该子查询没用用到GROUP BY,HAVING,ORDER BY,LIMIT和DISTINCT,INTERSECT或EXCEPT,那么计划器会使用pull_up_subqueries()函数将其转换为连接形式。例如下面一个FROM子句含子查询的查询就可以被转换为自然连接查询。自不必说,这种转换是在查询树上进行的。 -
将外连接转为内连接
如果可能的话,计划器会将
OUTER JOIN查询转换为INNER JOIN查询。
3.6.2 获取代价最小的路径
为了获取最佳计划树,计划器必须考虑各个索引与各种连接方法之间的所有可能组合。 如果表的数量超过某个水平,该过程的代价就会因为组合爆炸而变得非常昂贵,以至于根本不可行。
幸运的是,如果表的数量小于12张,计划器可以使用动态规划来获取最佳计划; 否则计划器会使用遗传算法。详情如下:
基因查询优化器
当执行一个多表连接查询时,大量时间耗费在了优化查询计划上。 为了应对这种情况,PostgreSQL实现了一个有趣的功能:基因查询优化器。 这种近似算法能在合理时间内确定一个合理的计划。 因此在查询优化阶段,如果参与连接的表数量超过参数
geqo_threshold指定的阈值(默认值为12),PostgreSQL将使用遗传算法来生成查询计划。
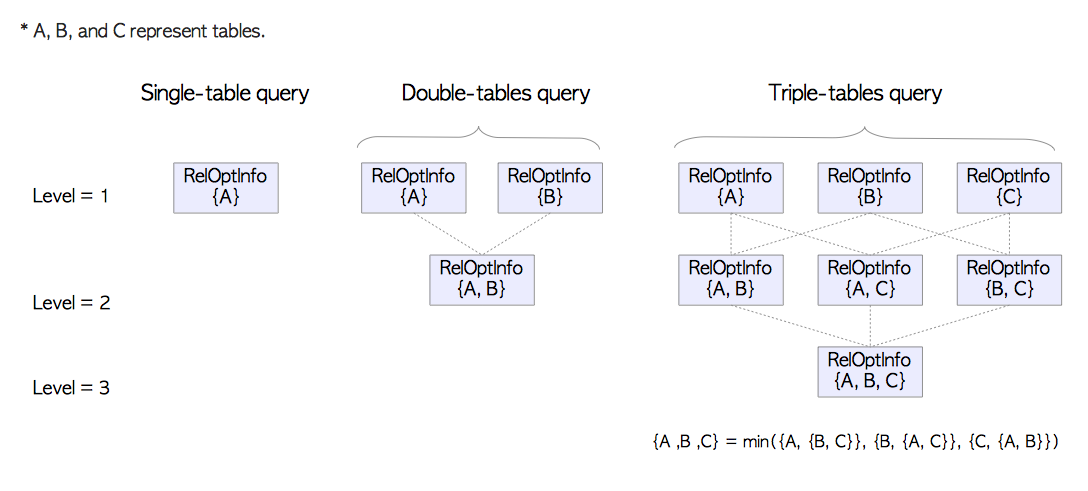
使用动态规划确定最佳计划树的过程,其步骤如下:
-
第一层
获得每张表上代价最小的路径,代价最小的路径存储在表相应的
RelOptInfo结构中。 -
第二层
从所有表中选择两个表,为每种组合找出代价最低的路径。
举个例子,如果总共有两张表,表
A与表B,则表A和B表连接的各种路径中,代价最小的那条即为最终想要的答案。在下文中,两个表的RelOptInfo记做。如果有三个表,则需要获取三种组合里各自代价最小的路径。
-
第三层及其后
继续进行同样的处理,直到层级等于表数量。
通过这种方式,在每个层级都能解决最小代价问题的一部分,且其结果能被更高层级的计算复用,从而使代价最小的计划树能够被高效地计算出来。
接下来会针对下面的查询,解释计划器是如何获取代价最小的计划的。
3.6.2.1 第一层的处理
在第一层中,计划器会为查询中涉及的关系创建相应的RelOptInfo结构,并估计每个关系上的最小代价。 在这一步中,RelOptInfo结构会被添加至该查询对应PlannerInfo的simple_rel_arrey数组字段中。
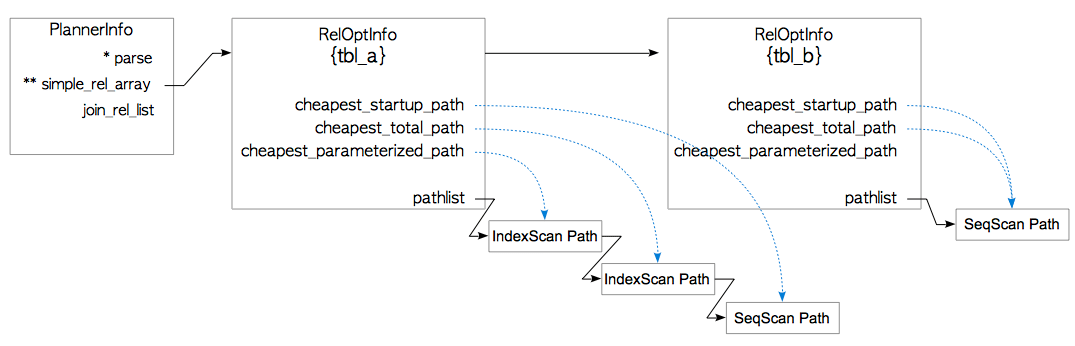
表tbl_a的RelOptInfo有三条访问路径,它们被添加至RelOptInfo的路径列表中。这三条路径分别被三个指针所链接,即三个指向代价最小路径的指针:启动代价最小的路径,总代价最小的路径,参数化代价最小的路径。 启动代价最小的路径与总代价最小的路径涵义显而易见,因此,这里只会说一下参数化索引扫描代价最小的路径(cheapest parameterized index scan path)。
如3.5.1.3节所述,计划器会考虑为索引嵌套循环连接使用参数化路径(parameterized path)(极少数情况下也会用于带外表索引扫描的索引化归并连接)。参数化索引扫描代价最小的路径,就是所有参数化路径中代价最小的那个。
表tbl_b的RelOptInfo仅有顺序扫描访问路径,因为tbl_b上没有相关索引。
3.6.2.2 第二层的处理
在第二层中,计划器会在PlannerInfo的join_rel_list字段中创建一个RelOptInfo结构。 然后估计所有可能连接路径的代价,并且选择代价最小的那条访问路径。 RelOptInfo会将最佳访问路径作为总代价最小的路径, 如图3.33所示。
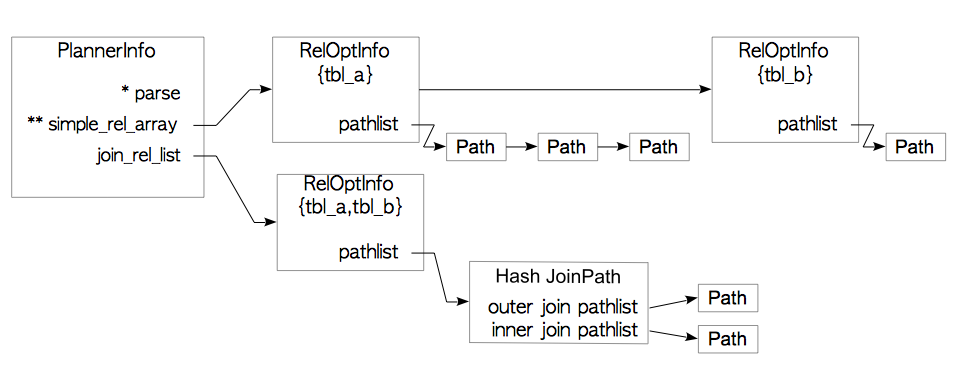
表3.1展示了本例中连接访问路径的所有组合。本例中查询的连接类型为等值连接(equi-join),因而对全部三种连接算法进行评估。 为方便起见,这里引入了一些有关访问路径的符号:
SeqScanPath(table)表示表table上的顺序扫描路径。Materialized -> SeqScanPath(table)表示表table上的物化顺序扫描路径。IndexScanPath(table,attribute)表示按表table中属性attribute上的索引扫描路径。ParameterizedIndexScanPath(table,attribute1,attribute2)表示表table中属性attribute1上的参数化索引路径,并使用外表上的属性attribute2参数化。
表 3.1 此示例中的所有连接访问路径组合
嵌套循环连接
| 外表路径 | 内表路径 | 备注 |
|---|---|---|
SeqScanPath(tbl_a) |
SeqScanPath(tbl_b) |
|
SeqScanPath(tbl_a) |
Materialized -> SeqScanPath(tbl_b) |
物化嵌套循环链接 |
IndexScanPath(tbl_a,id) |
SeqScanPath(tbl_b) |
嵌套循环连接,走外表索引 |
IndexScanPath(tbl_a,id) |
Materialized -> SeqScanPath(tbl_b) |
物化嵌套循环连接,走外表索引 |
SeqScanPath(tbl_b) |
SeqScanPath(tbl_a) |
|
SeqScanPath(tbl_b) |
Materialized -> SeqScanPath(tbl_a) |
物化嵌套循环连接 |
SeqScanPath(tbl_b) |
ParametalizedIndexScanPath(tbl_a, id, tbl_b.id) |
索引嵌套循环连接 |
归并连接
| 外表路径 | 内表路径 | 备注 |
|---|---|---|
SeqScanPath(tbl_a) |
SeqScanPath(tbl_b) |
|
IndexScanPath(tbl_a,id) |
SeqScanPath(tbl_b) |
用外表索引做归并连接 |
SeqScanPath(tbl_b) |
SeqScanPath(tbl_a) |
哈希连接
| 外表路径 | 内表路径 | 备注 |
|---|---|---|
SeqScanPath(tbl_a) |
SeqScanPath(tbl_b) |
|
SeqScanPath(tbl_b) |
SeqScanPath(tbl_a) |
例如在嵌套循环连接的部分总共评估了七条连接路径。 第一条表示在外表tbl_a和内表tbl_b上都使用顺序扫描路径;第二条表示在外表tbl_a上使用路径顺序扫描路径,而在内表tbl_b上使用物化顺序扫描路径,诸如此类。
计划器最终从估计的连接访问路径中选择代价最小的那条,并且将其添加至RelOptInfo{tbl_a,tbl_b}的路径列表中,如图3.33所示。
在本例中,如下面EXPLAIN的结果所示,计划器选择了在内表tbl_b和外表tbl_c上进行散列连接。
3.6.3 获取三表查询代价最小的路径
涉及三个表的查询,其代价最小的路径的获取过程如下所示:
-
第一层:
计划器估计所有表上各自开销最小的路径,并将该信息存储在表相应的
RelOptInfos结构{tbl_a},{tbl_b},{tbl_c}中。 -
第二层:
计划器从三个表中选出两个,列出所有组合,分别评估每种组合里代价最小的路径。然后,规划器将信息存储在组合相应的
RelOptInfos结构中:{tbl_a,tbl_b},{tbl_b,tbl_c}和{tbl_a,tbl_c}中。 -
第三层:
计划器根据所有已获取的
RelOptInfos,选择代价最小的路径。更确切地说,计划器会考虑三种RelOptInfos组合:{tbl_a,{tbl_b,tbl_c}},{tbl_b,{tbl_a,tbl_c}}和{tbl_c,{tbl_a,tbl_b}},而{tbl_a,tbl_b,tbl_c}如下所示:
计划器会估算这里面所有可能连接路径的代价。
在处理{tbl_c,{tbl_a,tbl_b}}对应的RelOptInfo时,计划器会估计tbl_c和{tbl_a,tbl_b}连接代价最小的路径。本例中{tbl_a,tbl_b}已经选定为内表为tbl_a且外表为tbl_b的散列连接。如先前小节所述,在估计时三种连接算法及其变体都会被评估,即嵌套循环连接及其变体,归并连接及其变体,散列连接及其变体。
计划器以同样的方式处理{tbl_a,{tbl_b,tbl_c}}与{tbl_b,{tbl_a,tbl_c}}对应的RelOptInfo,并最终从所有估好的路径中选择代价最小的访问路径。
该查询的 EXPLAIN 命令结果如图3.34所示:
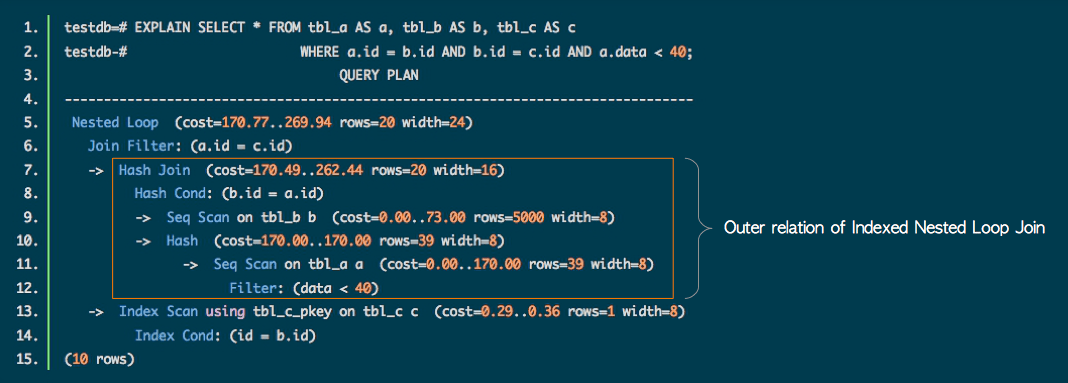
最外层的连接是索引嵌套循环连接(第5行),第13行显示了内表上的参数化索引扫描,外表则是一个散列连接的结果该散列连接的内表是tbl_a,外表是tbl_b(第7-12行)。 因此,执行程序首先执行tbl_a和tbl_b上的散列连接,再执行索引嵌套循环连接。
参考文献
- [1] Abraham Silberschatz, Henry F. Korth, and S. Sudarshan, “Database System Concepts”, McGraw-Hill Education, ISBN-13: 978-0073523323
- [2] Thomas M. Connolly, and Carolyn E. Begg, “Database Systems”, Pearson, ISBN-13: 978-0321523068
4 外部数据包装器与并行查询
本章将介绍两种相当实用,而且很有趣的特性:外部数据包装器(Foreign Data Wrapper FDW)与并行查询(Parallel Query)。
4.1 外部数据包装器(FDW)
2003年,SQL标准中添加了一个访问远程数据的规范,称为SQL外部数据管理(SQL/MED)。PostgreSQL在9.1版本开发出了FDW,实现了一部分SQL/MED中的特性。
在SQL/MED中,远程服务器上的表被称为外部表(Foreign Table)。 PostgreSQL的外部数据包装器(FDW) 使用与本地表类似的方式,通过SQL/MED来管理外部表。
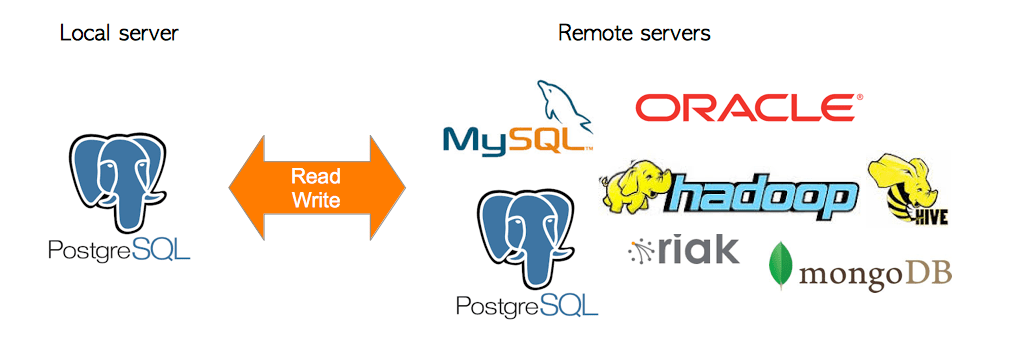
安装完必要的扩展并配置妥当后,就可以访问远程服务器上的外部表了。 例如假设有两个远程服务器分别名为postgresql和mysql,它们上面分别有两张表:foreign_pg_tbl和foreign_my_tbl。 在本例中,可以在本地服务器上执行SELECT查询以访问外部表,如下所示。
此外还可以在本地连接来自不同服务器中的外部表。
Postgres wiki中列出了很多现有的FDW扩展。但只有postgres_fdw 与file_fdw 是由官方PostgreSQL全球开发组维护的。postgres_fdw可用于访问远程PostgreSQL服务器。
以下部分将详细介绍PostgreSQL的FDW。 4.1.1节为概述,4.1.2节介绍了postgres_fdw扩展的工作方式。
Citus
Citus是由citusdata.com开发的开源PostgreSQL扩展,它能创建用于并行化查询的分布式PostgreSQL服务器集群。citus算是PostgreSQL生态中机制上最为复杂,且商业上最为成功的扩展之一,它也是一种FDW。
4.1.1 概述
使用FDW特性需要先安装相应的扩展,并执行一些设置命令,例如CREATE FOREIGN TABLE,CREATE SERVER 和CREATE USER MAPPING(细节请参阅官方文档)。
在配置妥当之后,查询处理期间,执行器将会调用扩展中定义的相应函数来访问外部表。
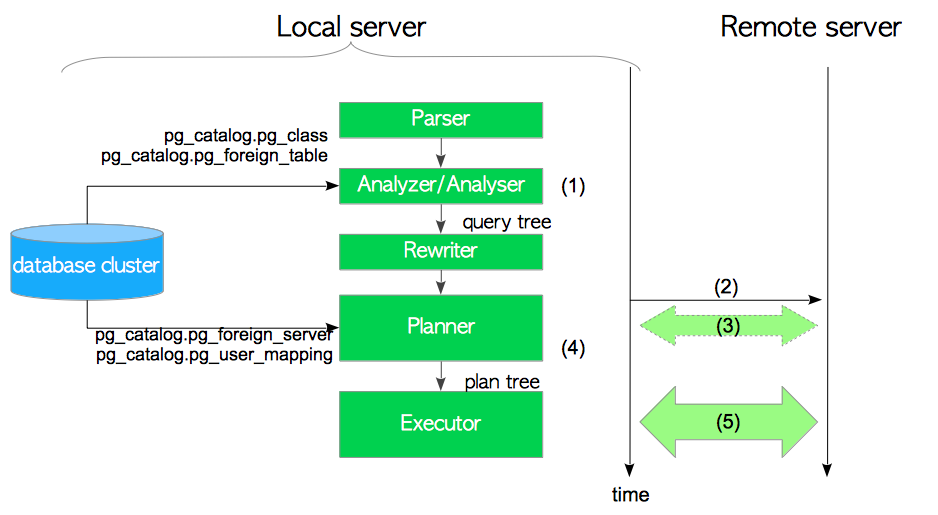
- 分析器为输入的SQL创建一棵查询树。
- 计划器(或执行器)连接到远程服务器。
- 如果启用了
use_remote_estimate选项(默认关闭),则计划器将执行EXPLAIN命令以估计每条计划路径的代价。 - 计划器按照计划树创建出纯文本SQL语句,在内部称该过程为逆解析(deparesing)。
- 执行器将纯文本SQL语句发送到远程服务器并接收结果。
如有必要,执行器会进一步处理接收到的结果。 例如执行多表查询时,执行器会将收到的数据与其他表进行连接。
以下各节介绍了每一步中的具体细节。
4.1.1.1 创建一棵查询树
分析器会根据输入的SQL创建一棵查询树,并使用外部表的定义。当执行命令CREATE FOREIGN TABLE 和IMPORT FOREIGN SCHEMA时,外部表的定义会被存储至系统目录pg_catalog.pg_class和pg_catalog.pg_foreign_table中。
4.1.1.2 连接至远程服务器
计划器(或执行器)会使用特定的库连接至远程数据库服务器。 例如要连接至远程PostgreSQL服务器时,postgres_fdw会使用libpq。 而连接到mysql服务器时,由EnterpriseDB开发的mysql_fdw使用libmysqlclient。
当执行CREATE USER MAPPING和CREATE SERVER命令时,诸如用户名,服务器IP地址和端口号等连接参数会被存储至系统目录pg_catalog.pg_user_mapping和pg_catalog.pg_foreign_server中。
4.1.1.3 使用EXPLAIN命令创建计划树(可选)
PostgreSQL的FDW机制支持一种特性:获取外部表上的统计信息,用于估计查询代价。一些FDW扩展使用了该特性,例如postgres_fdw,mysql_fdw,tds_fdw和jdbc2_fdw。
如果使用ALTER SERVER命令将use_remote_estimate选项设置为on,则计划器会向远程服务器发起查询,执行EXPLAIN命令获取执行计划的代价。否则在默认情况下,会使用默认内置常量值作为代价。
尽管一些扩展也会执行EXPLAIN命令,但目前只有postgres_fdw才能忠于EXPLAIN命令的真正意图,因为PostgreSQL的EXPLAIN命令会同时返回启动代价和总代价。而其他DBMS的FDW扩展一般无法使用EXPLAIN命令的结果进行规划。 例如MySQL的EXPLAIN命令仅仅返回估计的行数, 但如第3章所述,PostgreSQL的计划器需要更多的信息来估算代价。
4.1.1.4 逆解析
在生成执行计划树的过程中,计划器会为执行计划树上外部表的扫描路径创建相应的纯文本SQL语句。 例如图4.3展示了下列SELECT语句对应的计划树。
图4.3展示了一个存储着纯文本形式SELECT语句的ForeignScan节点,PlannedStmt是执行计划树对应的数据结构,包含指向ForeignScan节点的链接。 这里,postgres_fdw从查询树中重新创建出SELECT纯文本语句,该过程在PostgreSQL中被称为逆解析(deparsing)。
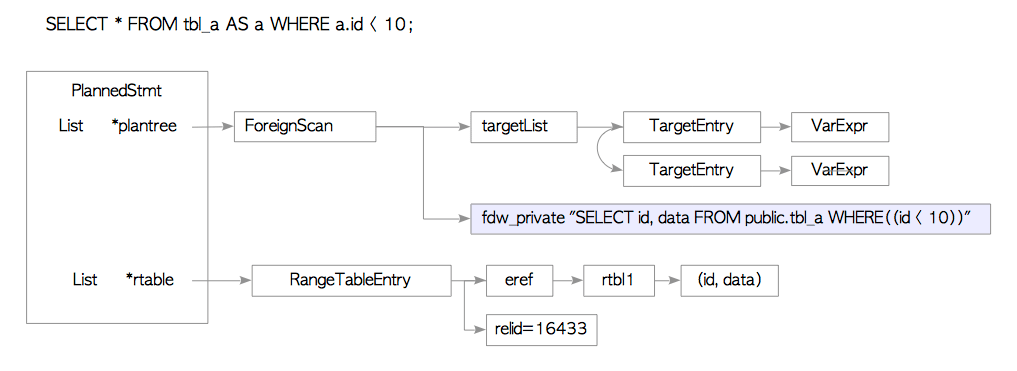
使用mysql_fdw时,则会从查询树中重新创建MySQL相应的SELECT语句。 使用redis_fdw或rw_redis_fdw会创建一条Redis中的SELECT命令。
4.1.1.5 发送SQL命令并接收结果
在进行逆解析之后,执行器将逆解析得到的SQL语句发送到远程服务器并接收结果。
扩展的开发者决定了将SQL语句发送至远程服务器的具体方法。 例如mysql_fdw在发送多条SQL语句时不使用事务。 在mysql_fdw中执行SELECT查询的典型SQL语句序列如下所示(图4.4)。
- (5-1)将
SQL_MODE设置为'ANSI_QUOTES'。 - (5-2)将
SELECT语句发送到远程服务器。 - (5-3)从远程服务器接收结果。这里
mysql_fdw会将结果转换为PostgreSQL可读的格式。所有FDW扩展都实现了将结果转换为PostgreSQL可读数据的功能。
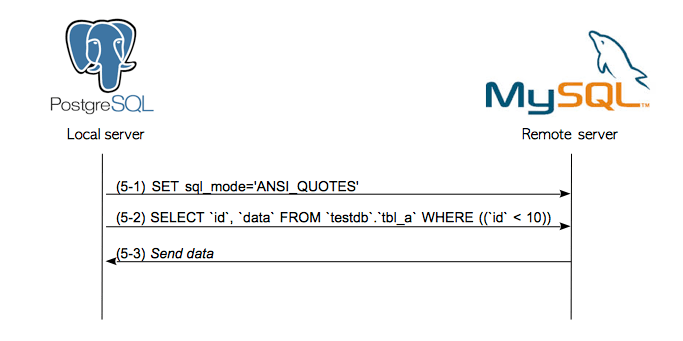
下面是远程服务器的日志,列出了实际接收到的语句。
postgres_fdw中的SQL命令顺序要更为复杂。在postgres_fdw中执行一个典型的SELECT查询,实际的语句序列如图4.5所示。
-
(5-1)启动远程事务。远程事务的默认隔离级别是
REPEATABLE READ;但如果本地事务的隔离级别设置为SERIALIZABLE,则远程事务的隔离级别也会设置为SERIALIZABLE。 -
(5-2)-(5-4)声明一个游标,SQL语句基本上以游标的方式来执行。
-
(5-5)执行
FETCH命令获取结果。默认情况下FETCH命令一次获取100行。 -
(5-6)从远程服务器接收结果。
-
(5-7)关闭游标。
-
(5-8)提交远程事务。
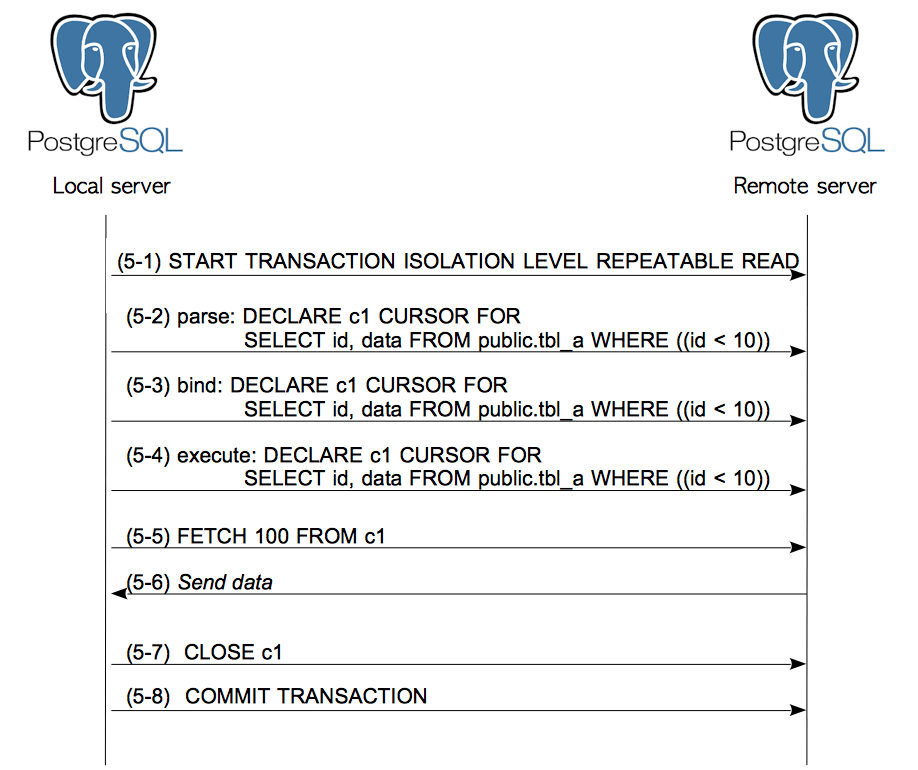
这里是远程服务器的实际日志。
postgres_fdw中远程事务的默认隔离级别远程事务的默认隔离级别为
REPEATABLE READ,官方文档给出了原因和说明:当本地事务使用
SERIALIZABLE隔离级别时,远程事务也会使用SERIALIZABLE隔离级别,否则使用REPEATABLE READ隔离级别。 这样做可以确保在远程服务器上执行多次扫表时,每次的结果之间都能保持一致。因此,即使其他活动在远程服务器上进行了并发更新,单个事务中的连续查询也将看到远程服务器上的一致性快照。
4.1.2 postgres_fdw的工作原理
postgres_fdw扩展是一个由PostgreSQL全球开发组官方维护的特殊模块,其源码包含在PostgreSQL源码树中。
postgres_fdw正处于不断改善的过程中。 表4.1列出了官方文档中与postgres_fdw有关的发行说明。
版本
描述
9.3
postgres_fdw模块正式发布
9.6
在远程服务器上执行排序
在远程服务器上执行连接
如果可行,在远程服务器上执行UPDATE与DELETE
允许在服务器与表的选项中设置批量拉取结果集的大小
10
如果可行, 将聚合函数下推至远程服务器
postgres_fdw如何处理单表查询,接下来的小节将介绍postgres_fdw如何处理多表查询,排序操作与聚合函数。
本小节重点介绍SELECT语句;但postgres_fdw还可以处理其他DML(INSERT,UPDATE和DELETE)语句。
PostgreSQL的FDW不会检测死锁
postgres_fdw与FDW功能并不支持分布式锁管理器与分布式死锁检测功能, 因此很容易产生死锁。 例如某客户端A更新了一个本地表tbl_local与一个外部表tbl_remote,而另一个客户端B以相反的顺序更新tbl_remote和tbl_local,则这两个事务陷入死锁。但PostgreSQL无法检测到这种情况, 因而无法提交这些事务。
4.1.2.1 多表查询
当执行多表查询时,postgres_fdw使用单表SELECT语句依次拉取每个外部表,并在本地服务器上执行连接操作。
在9.5或更早版本中,即使所有外部表都存储在同一个远程服务器中,postgres_fdw也会单独拉取每个表再连接。
在9.6或更高版本中,postgres_fdw已经有所改进,当外部表位于同一服务器上且use_remote_estimate选项打开时,可以在远程服务器上执行远程连接操作。
执行细节如下所述。
9.5及更早版本:
我们研究一下PostgreSQL如何处理以下查询:两个外部表的连接:tbl_a和tbl_b。
EXPLAIN的执行结果如下
结果显示,执行器选择了归并连接,并按以下步骤处理:
-
第8行:执行器使用外部表扫描拉取表
tbl_a。 -
第6行:执行器在本地服务器上对拉取的
tbl_a行进行排序。 -
第11行:执行器使用外表扫描拉取表
tbl_b。 -
第9行:执行器在本地服务器上对拉取的
tbl_b行进行排序。 -
第4行:执行器在本地服务器上执行归并连接操作。
下面描述执行器如何拉取行集(图4.6)。
-
(5-1)启动远程事务。
-
(5-2)声明游标
c1,其SELECT语句如下所示: -
(5-3)执行
FETCH命令以拉取游标c1的结果。 -
(5-4)声明游标
c2,其SELECT语句如下所示:注意原来双表查询中的WHERE子句是
tbl_a.id = tbl_b.id AND tbl_a.id <200;因而从逻辑上讲这条SELECT语句也可以添加上一条WHERE子句tbl_b.id <200。但postgres_fdw没有办法执行这样的推理,因此执行器必须执行不包含任何WHERE子句的SELECT语句,获取外部表tbl_b中的所有行。这种处理方式效率很差,因为必须通过网络从远程服务器读取不必要的行。此外,执行归并连接还需要先对接受到的行进行排序。
-
(5-5)执行
FETCH命令,拉取游标c2的结果。 -
(5-6)关闭游标
c1。 -
(5-7)关闭游标
c2。 -
(5-8)提交事务。
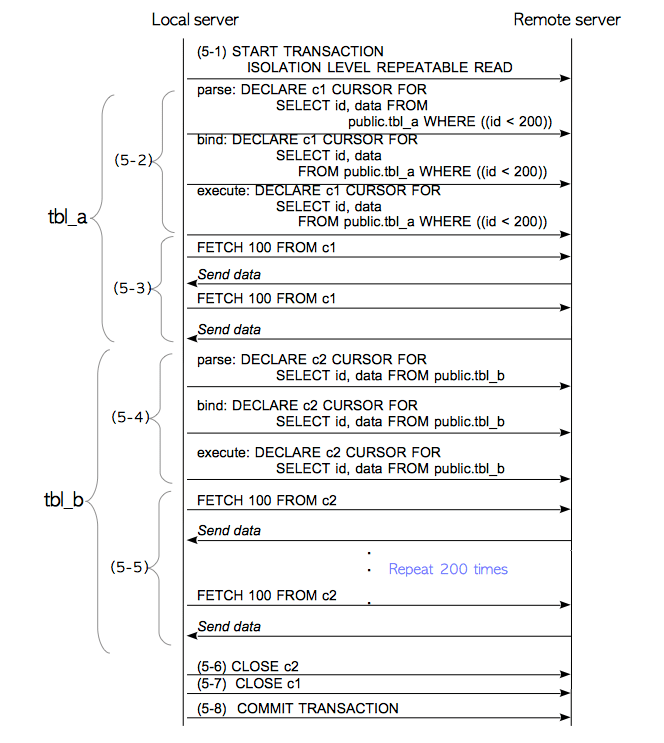
这里是远程服务器的实际日志。
在接收到行之后,执行器对接收到的tbl_a和tbl_b行进行排序,然后对已排序的行执行合并连接操作。
9.6或更高版本:
如果启用了use_remote_estimate选项(默认为关闭),则postgres_fdw会发送几条EXPLAIN命令,用于获取与外部表相关的所有计划的代价。
当发送EXPLAIN命令时,postgres_fdw将为每个单表查询执行EXPLAIN,也为执行远程连接操作时的SELECT语句执行EXPLAIN 。在本例中,以下七个EXPLAIN命令会被发送至远程服务器,用于估算每个SELECT语句的开销,从而选择开销最小的执行计划。
让我们在本地服务器上执行EXPLAIN命令,并观察计划器选择了哪一个计划。
结果显示,计划器选择了在远程服务器上进行INNER JOIN处理的执行计划,也是最有效率的执行计划。
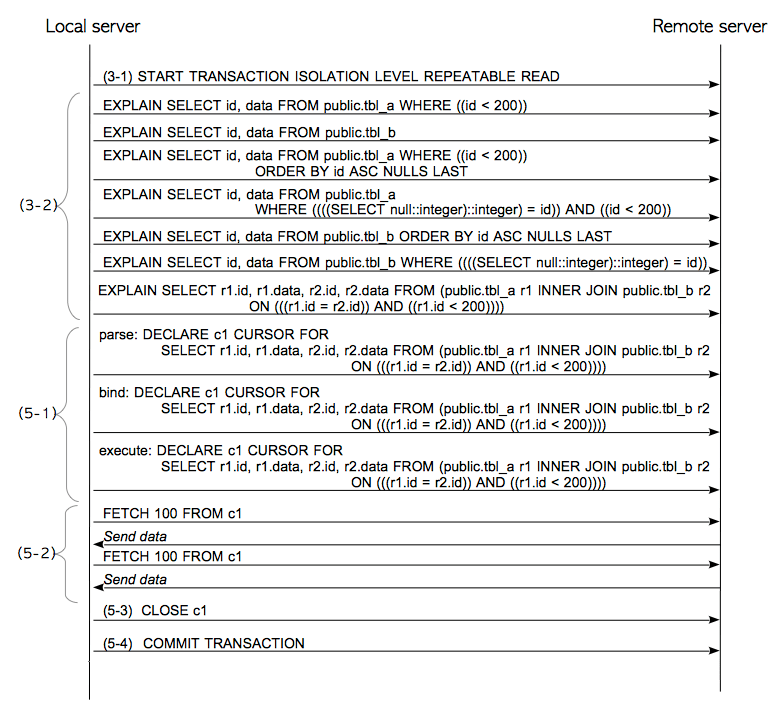
下面讲述postgres_fdw是如何执行这一过程的,如图4.7所示。
-
(3-1)启动远程事务。
-
(3-2)执行
EXPLAIN命令,估计每条计划路径的代价。在本例中执行了七条EXPLAIN命令。然后计划器根据EXPLAIN命令的结果,选取具有最低开销的SELECT查询。 -
(5-1)声明游标
c1,其SELECT语句如下所示: -
(5-2)从远程服务器接收结果。
-
(5-3)关闭游标
c1。 -
(5-4)提交事务。
这里是远程服务器的实际日志。
注意如果禁用use_remote_estimate选项(默认情况),则远程连接查询很少会被选择,因为这种情况下其代价会使用一个很大的预置值进行估计。
4.1.2.2 排序操作
在9.5或更早版本中,排序操作(如ORDER BY)都是在本地服务器上处理的。即,本地服务器在排序操作之前从远程服务器拉取所有的目标行。让我们通过EXPLAIN来看一个包含ORDER BY子句的简单查询是如何被处理的。
第6行:执行器将以下查询发送到远程服务器,然后获取查询结果。
第4行:执行器在本地服务器上对拉取的tbl_a中的行进行排序。
这里是远程服务器的实际日志。
在9.6或更高版本中,如果可行,postgres_fdw能在远程服务器上直接执行带ORDER BY子句的SELECT语句。
第4行:执行器将以下带ORDER BY子句的查询发送至远程服务器,然后拉取已排序的查询结果。
这里是远程服务器的实际日志。
4.1.2.3 聚合函数
在9.6及更早版本中,类似于前一小节中提到的排序操作,AVG()和COUNT()这样的聚合函数会在本地服务器上进行处理,如下所示。
第5行:执行器将以下查询发送到远程服务器,然后拉取查询结果。
第4行:执行器在本地服务器上对拉取的tbl_a行集求均值。
这一过程开销很大,因为发送大量的行会产生大量网络流量,而且需要很长时间。
这里是远程服务器的实际日志。
在10或更高版本中,如果可行的话,postgres_fdw将在远程服务器上执行带聚合函数的SELECT语句。
第4行:执行器将以下包含AVG()函数的查询发送至远程服务器,然后获取查询结果。
这种处理方式显然更为高效,因为远程服务器会负责计算均值,仅发送单行结果。
这里是远程服务器的实际日志。
下推
与上面的例子类似,下推(push-down) 指的是本地服务器允许一些操作在远程服务器上执行,例如聚合函数。
4.2 并行查询
编号说明: 英文原著当前把并行查询编为第3.7节;中文译稿保留原有第4.2节位置,以免破坏既有章节链接与图号。
并行查询由PostgreSQL 9.6(2016年)引入,使用多个后台worker共同处理一条查询。满足并行条件时,执行查询的postgres进程充当leader,最多启动max_parallel_workers_per_gather指定数量的worker。每个worker完成一部分扫描,把结果返回leader汇总。
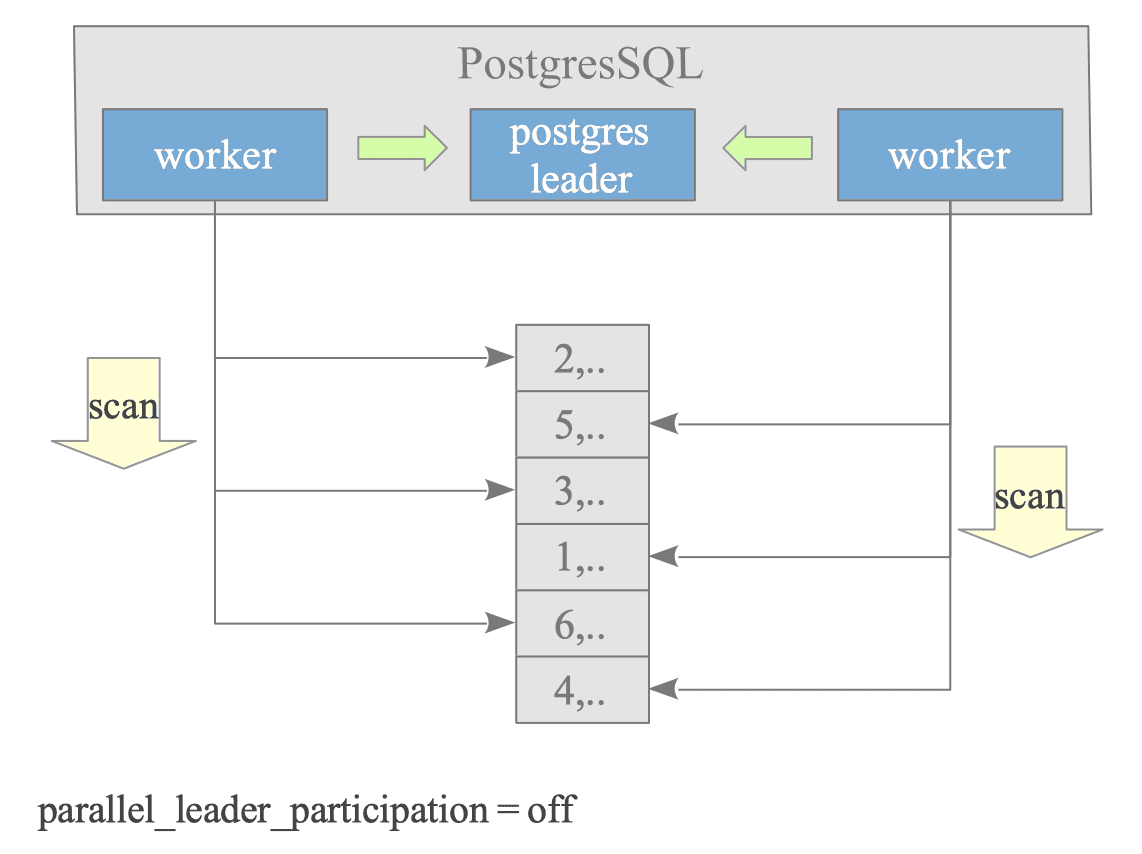
PostgreSQL 11起,默认开启的parallel_leader_participation允许leader在等待worker结果时也参与执行。为简化下文图示,假设该参数关闭,leader只负责协调与汇总。
并行查询能力持续演进:9.6支持并行顺序扫描、嵌套循环与哈希连接;10加入归并连接、B-tree索引扫描和位图堆扫描;11加入共享哈希表的并行哈希连接、并行建索引和更多并行DDL;后续版本继续扩展外表、DISTINCT及外连接等场景。
并行查询主要面向读取型工作负载,目前不支持游标操作。
4.2.1 并行查询概要
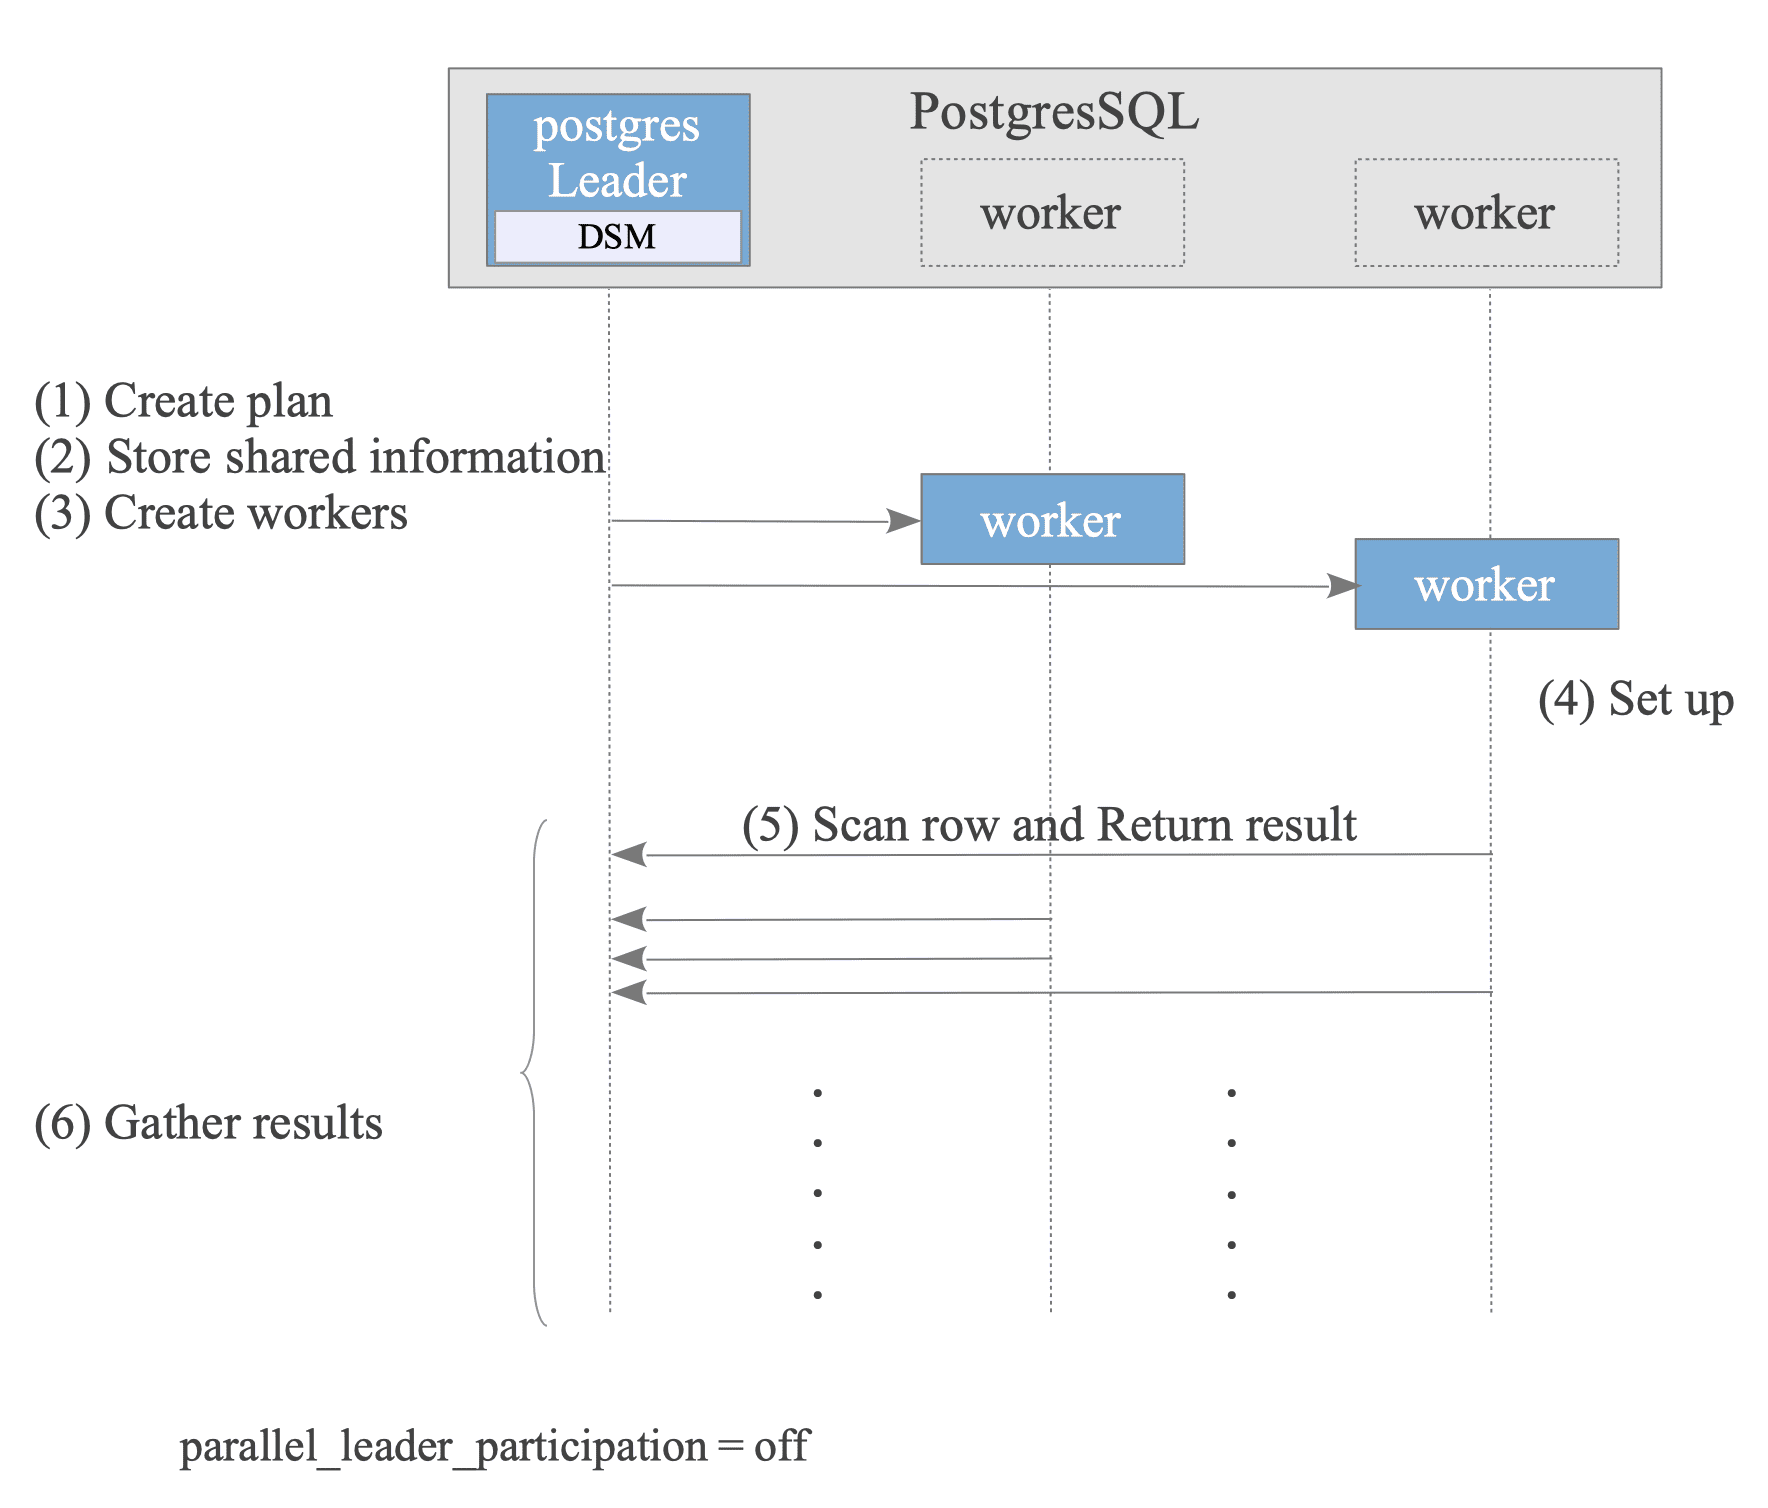
处理流程如下:
- leader创建计划: 优化器生成包含可并行执行节点的计划树。
- 保存共享信息: leader把计划树、会话状态等必要信息写入动态共享内存(DSM)。
- 创建worker: leader启动后台worker。
- worker初始化: 各worker读取DSM,建立与leader一致的执行环境。
- 扫描并返回结果: worker主动领取数据块,调用
SeqNext()、IndexNext()等函数扫描,并返回结果。 - leader汇总: leader收集所有worker结果。
- 清理: 查询结束后终止worker并释放DSM。
下面的示例使用一张包含100万行的表:
4.2.1.1 创建并行计划
优化器并不总会考虑并行执行。表大小通常需要达到min_parallel_table_scan_size(默认8 MB),索引则需达到min_parallel_index_scan_size(默认512 kB)。最简单的计划如下:
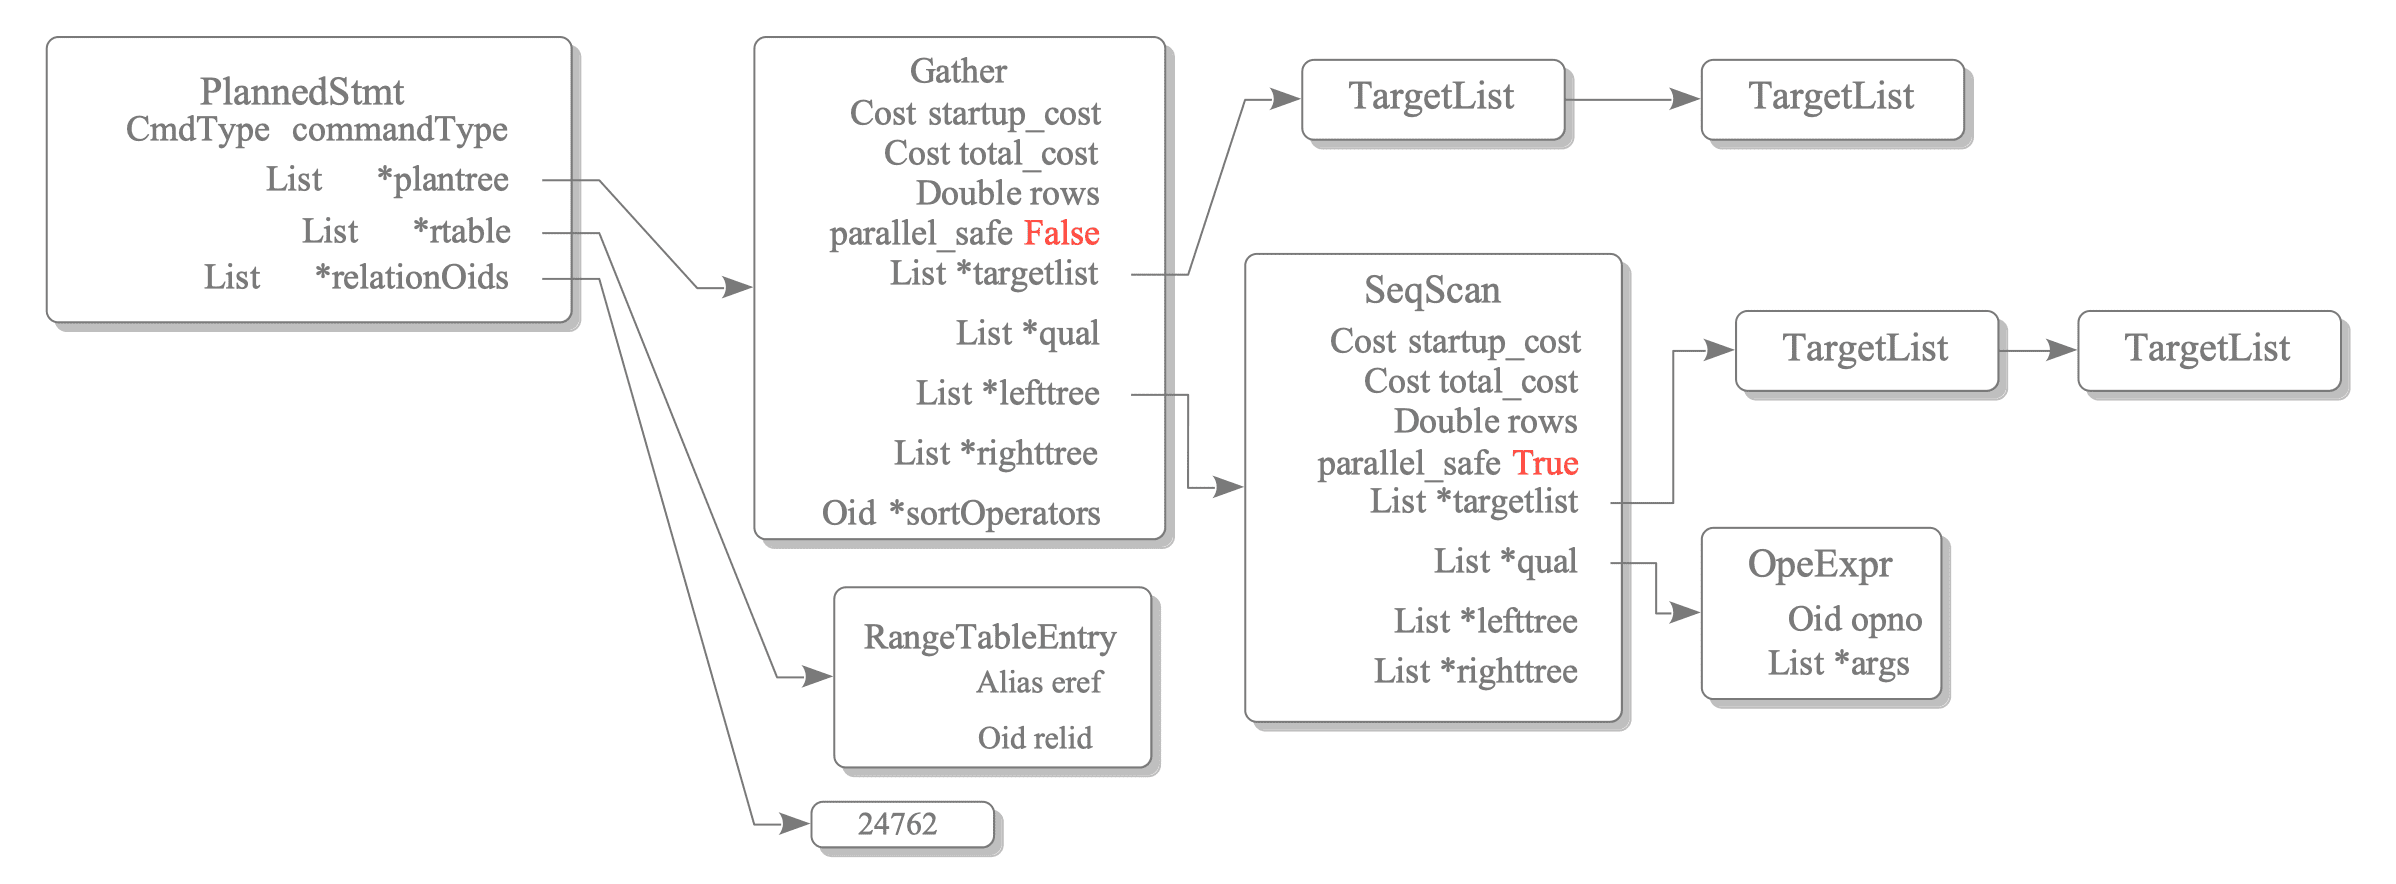
Gather收集worker结果;其他并行专用节点还包括保持排序的Gather Merge、并行扫描分区或UNION ALL的Parallel Append,以及并行聚合使用的Partial Aggregate和Finalize Aggregate。
只有parallel_safe=true的节点才能进入Gather以下、由worker执行的子计划。
4.2.1.2 保存共享信息
leader把两类信息写入DSM:
- 执行状态: GUC参数、事务快照、当前子事务ID、动态加载的库等,由
InitializeParallelDSM()保存。 - 查询信息:
PlannedStmt、ParamListInfo,并行扫描描述符、统计与资源使用结构等,由ExecInitParallelPlan()初始化。
leader还会在DSM中建立TupleQueue,作为读取worker结果的通信通道。
4.2.1.3 创建worker
计划中的worker数不一定等于实际启动数。全局max_parallel_workers会限制系统并行worker总数,其他并行查询也可能已经占用槽位。EXPLAIN ANALYZE同时显示Workers Planned与Workers Launched,可用于核对实际资源分配。
4.2.1.4 初始化worker
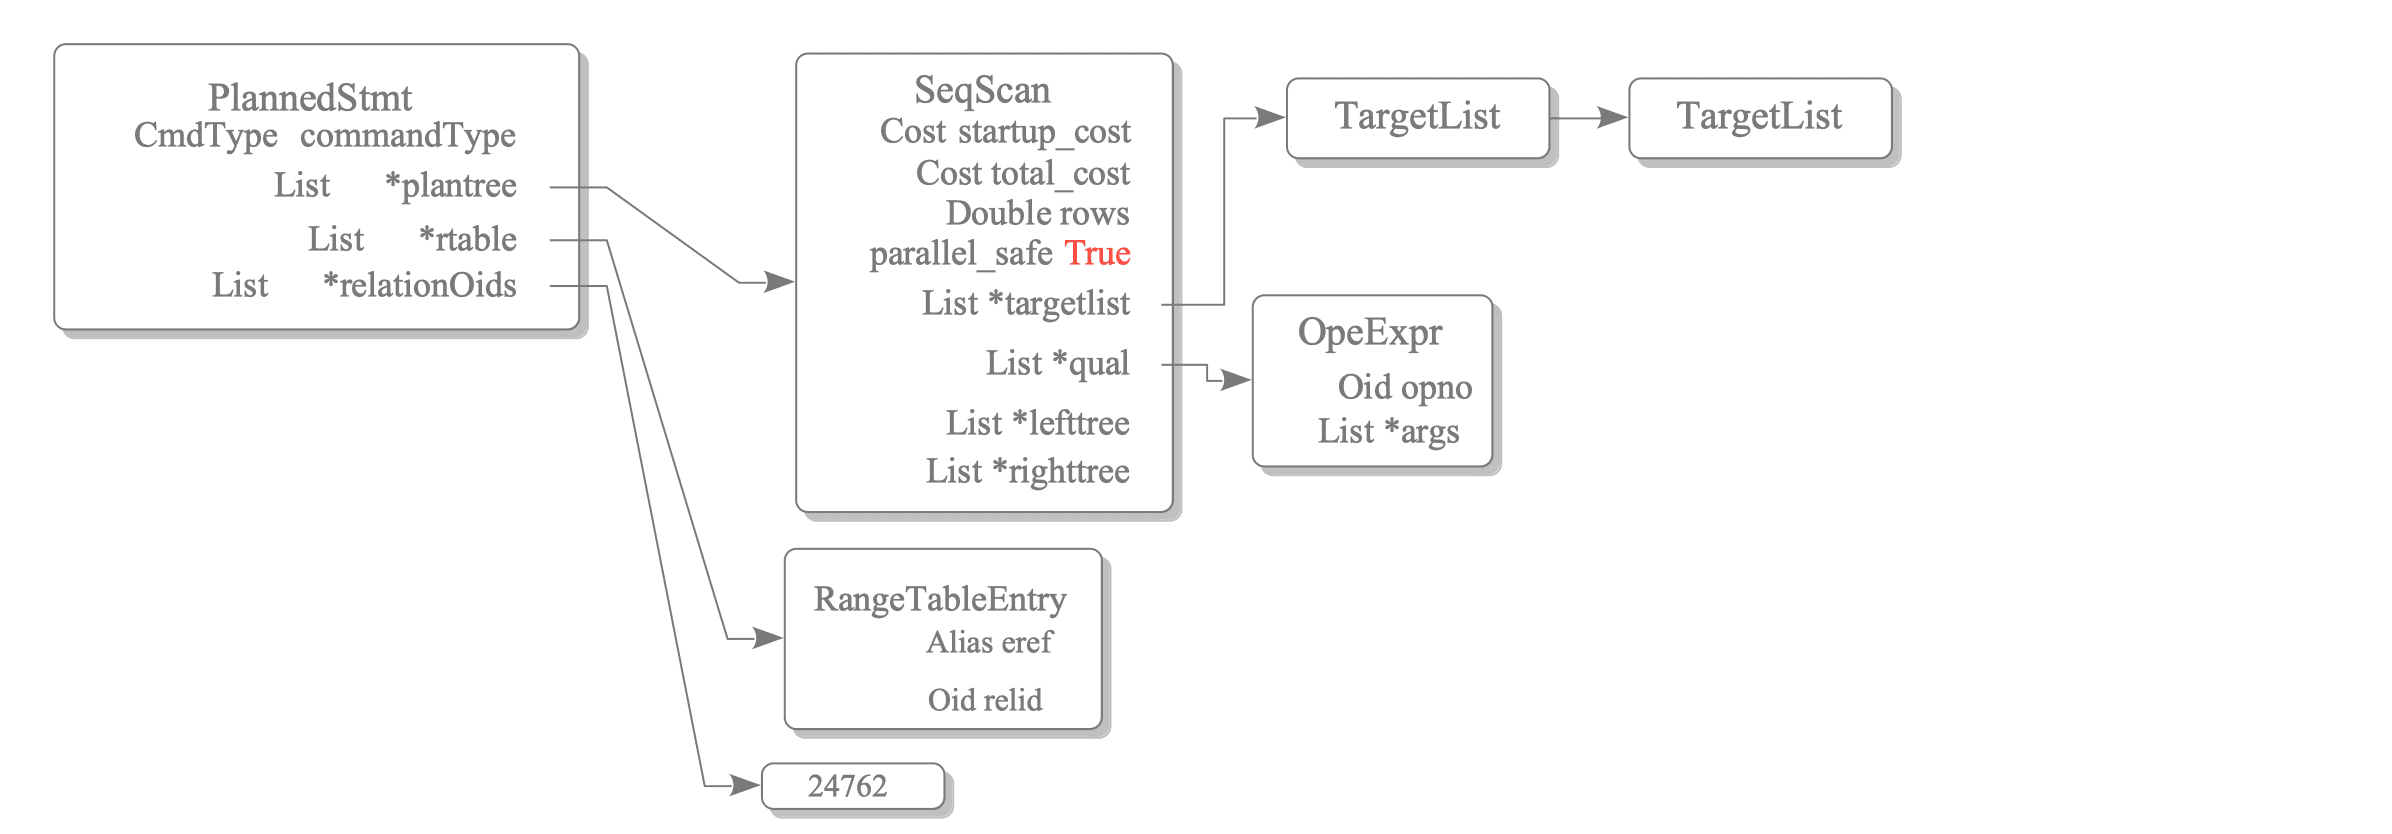
worker启动后从DSM读取执行状态和查询信息,使GUC、快照和动态库与leader一致。随后根据共享的PlannedStmt重建只包含parallel_safe节点的子计划,通常就是leader计划中Gather以下的部分。
4.2.1.5 扫描与返回结果
执行器对元组访问进行了高度抽象,这一点同样适用于并行查询。leader与worker共享DSM中的执行环境,因此多个进程可以通过SeqNext()按需领取不同数据块并执行同一次顺序扫描;结果通过DSM中的TupleQueue返回Gather。
4.2.1.6 汇总结果
Gather负责读取各worker的TupleQueue并向上层节点输出;需要保持全局排序时使用Gather Merge。
4.2.2 并行连接
PostgreSQL支持并行嵌套循环、归并与哈希连接。下面使用表d和f:
4.2.2.1 并行嵌套循环连接
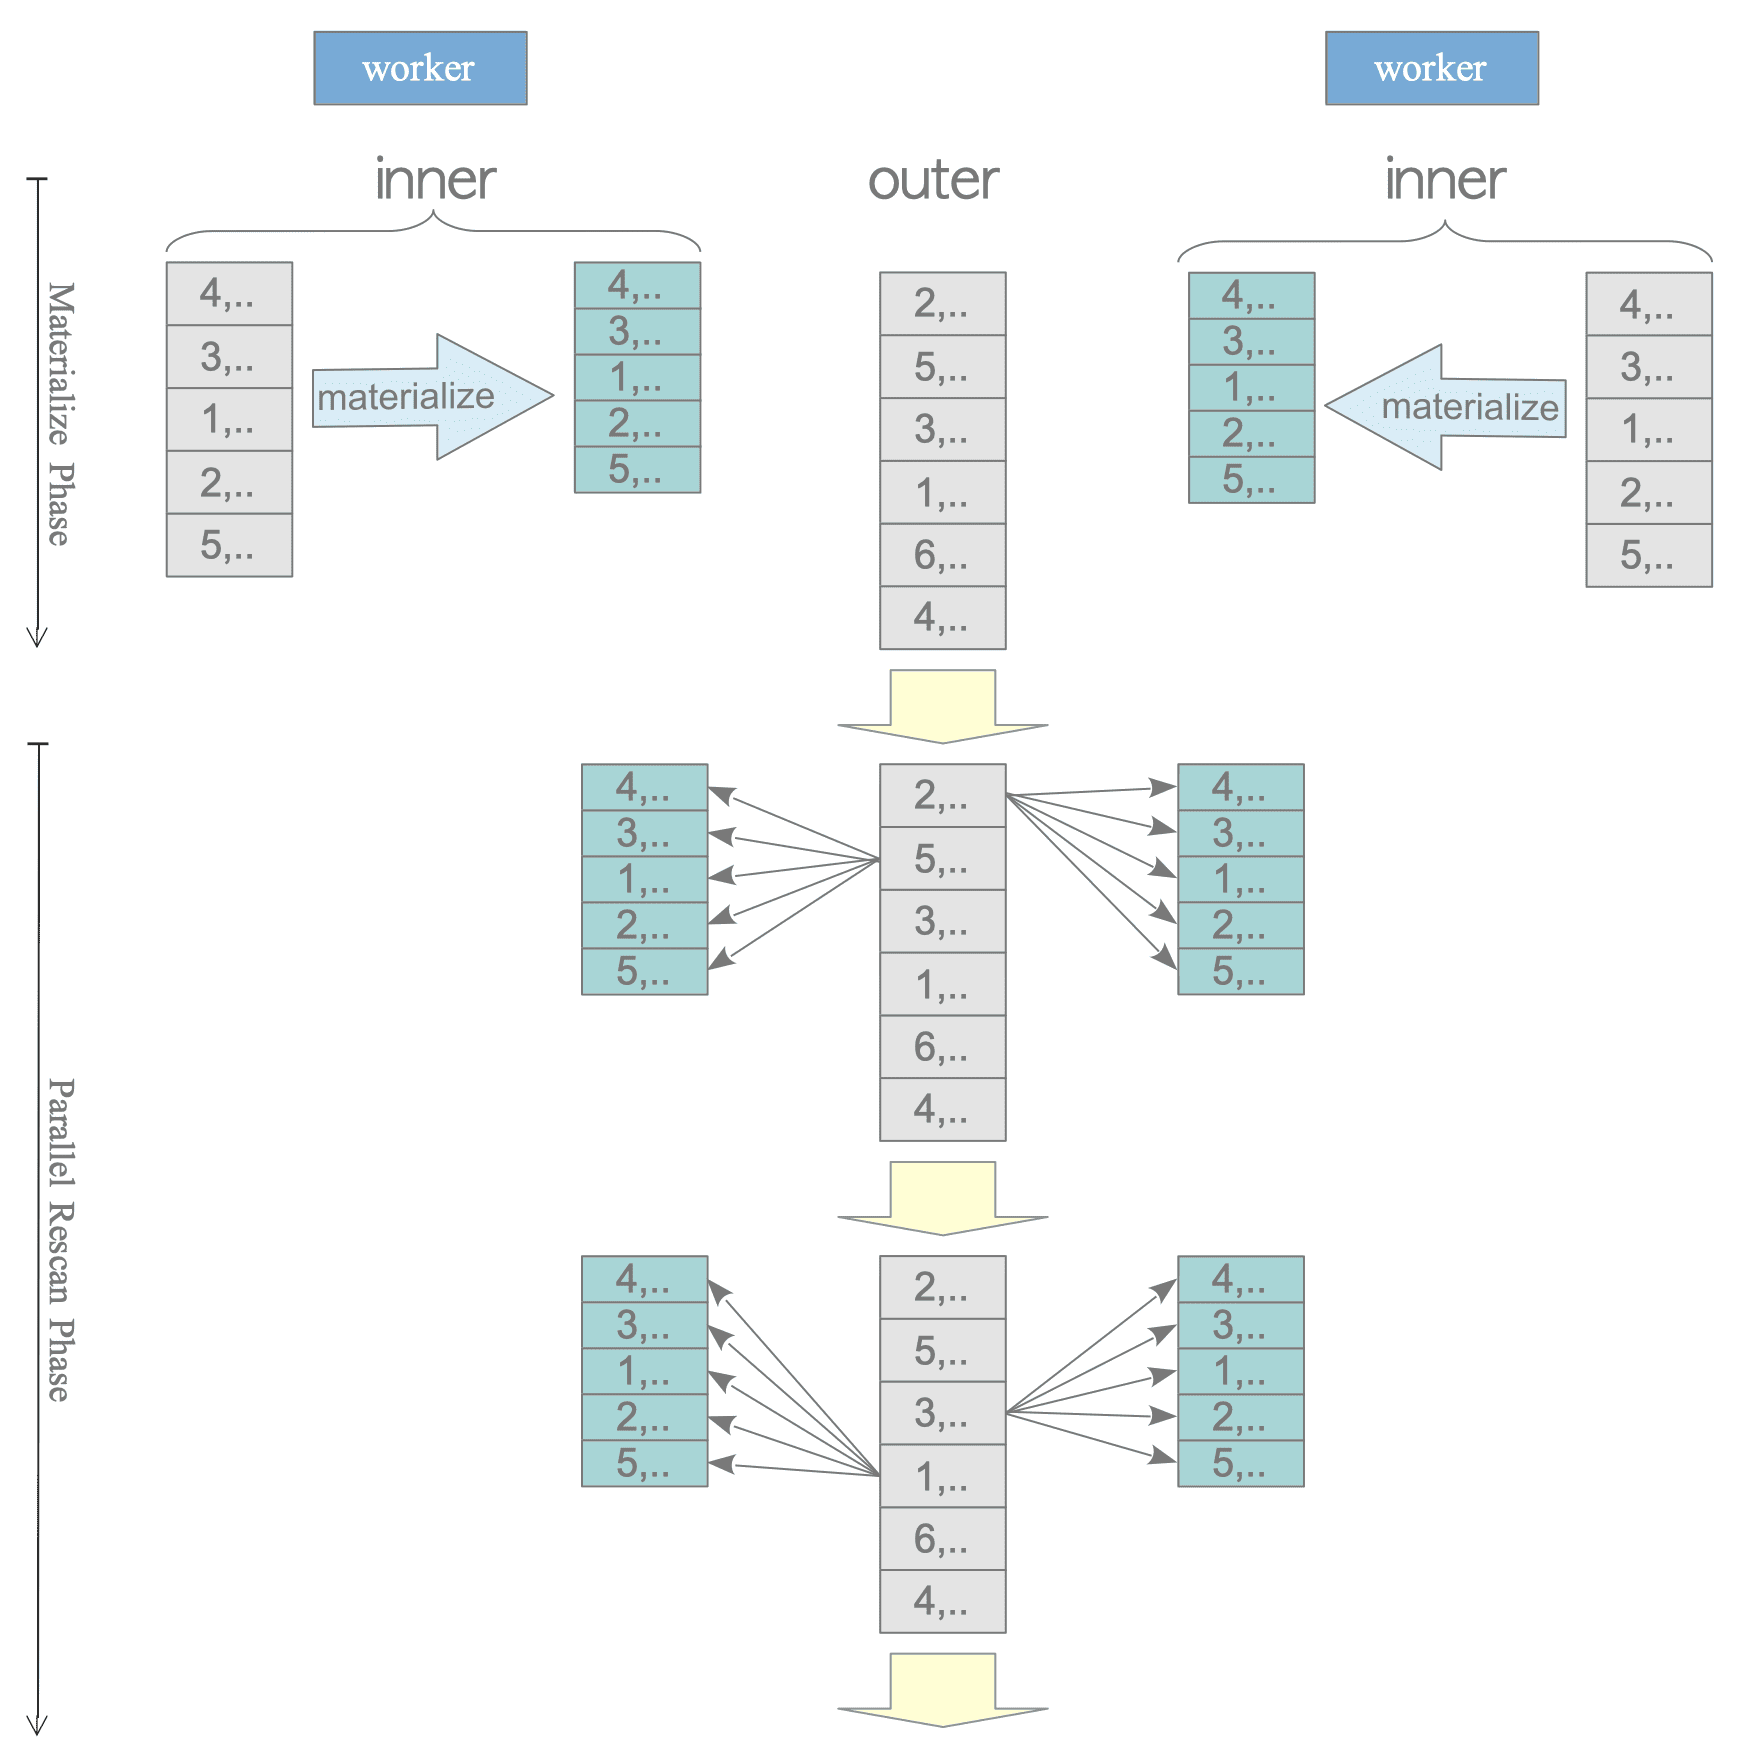
普通并行嵌套循环中,内表并不由worker共享处理;每个worker都要独立处理整个内表。物化嵌套循环会让每个worker各自物化一份内表,worker越多,重复工作越明显。
索引嵌套循环更高效:内表扫描仍不共享,但每个worker可用索引只取得匹配行。
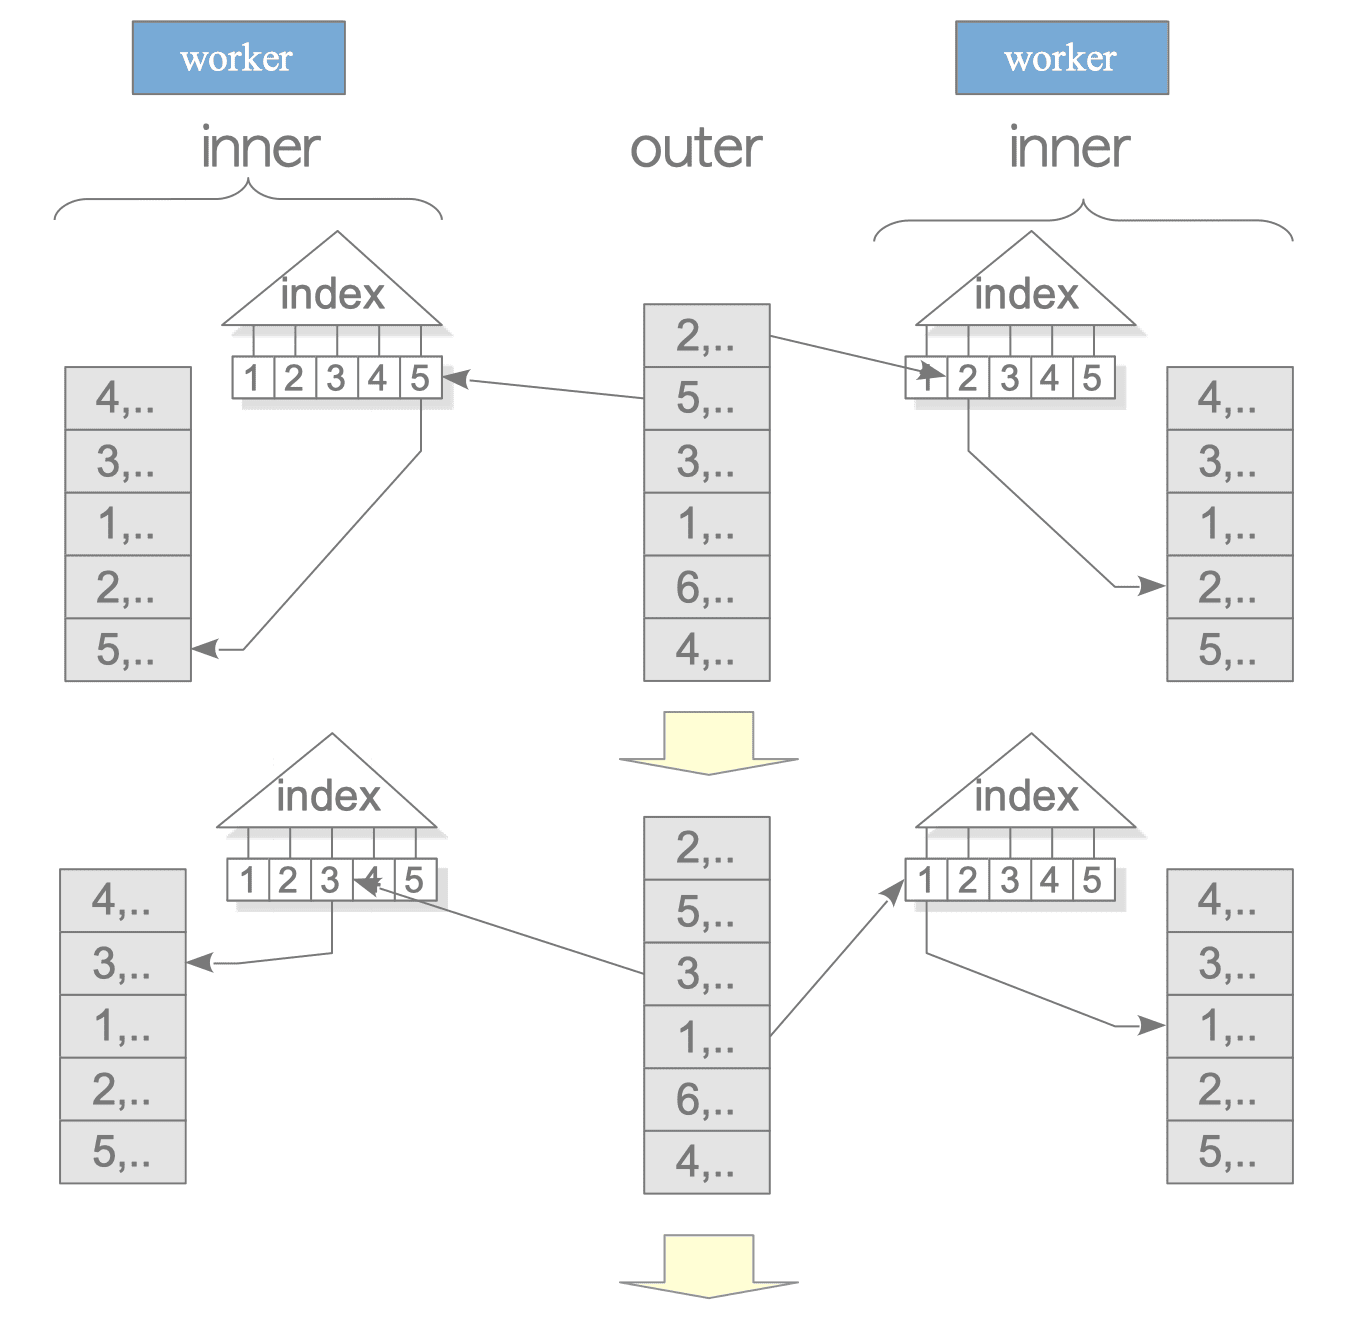
4.2.2.2 并行归并连接
与嵌套循环类似,普通归并连接要求每个worker独立处理并排序完整内表。若内表能通过有序索引扫描访问,则可避免重复排序,提高效率。
4.2.2.3 并行哈希连接
PostgreSQL 9.6和10中,每个worker都为内表构建自己的私有哈希表,造成重复工作与内存开销。PostgreSQL 11引入由enable_parallel_hash控制的Parallel Hash Join:所有worker协作在DSM中构建一张共享哈希表。
4.2.3 并行聚合
大多数聚合函数可以并行执行,具体函数是否支持取决于官方聚合函数表中的Partial Mode是否为YES。计划器根据预计目标行数选择两种主要策略。
4.2.3.1 少量行:leader直接聚合
预计行数很少时,worker负责扫描,Gather把原始行返回leader,再由普通Aggregate计算结果:
这样避免在每个worker上创建不必要的局部聚合状态。
4.2.3.2 大量行:Partial/Finalize聚合
预计行数很大时,先在worker端减少数据量更高效:
- 每个worker对本地扫描结果执行
Partial Aggregate。 Gather只收集中间聚合状态,而不是全部原始行。Finalize Aggregate合并中间结果。
4.2.3.3 并行聚合的数学基础
合并两个worker的局部结果时,设行数为、,和为、,平方离差和为、:
Finalize Aggregate用这些公式合并局部状态。三个或更多worker时重复两两合并,直至得到最终结果;推导见附录A.1.2。
5 并发控制
当多个事务同时在数据库中运行时,并发控制是一种用于维持一致性与隔离性的技术,一致性与隔离性是ACID的两个属性。
从宽泛的意义上来讲,有三种并发控制技术:多版本并发控制(Multi-version Concurrency Control, MVCC),严格两阶段锁定(Strict Two-Phase Locking, S2PL)和乐观并发控制(Optimistic Concurrency Control, OCC),每种技术都有多种变体。在MVCC中,每个写操作都会创建一个新版本的数据项,并保留其旧版本。当事务读取数据对象时,系统会选择其中的一个版本,通过这种方式来确保各个事务间相互隔离。 MVCC的主要优势在于“读不会阻塞写,而写也不会阻塞读”,相反的例子是,基于S2PL的系统在写操作发生时会阻塞相应对象上的读操作,因为写入者获取了对象上的排他锁。 PostgreSQL和一些RDBMS使用一种MVCC的变体,名曰快照隔离(Snapshot Isolation,SI)。
一些RDBMS(例如Oracle)使用回滚段来实现快照隔离SI。当写入新数据对象时,旧版本对象先被写入回滚段,随后用新对象覆写至数据区域。 PostgreSQL使用更简单的方法:新数据对象被直接插入到相关表页中。读取对象时,PostgreSQL根据可见性检查规则(visibility check rules),为每个事务选择合适的对象版本作为响应。
SI中不会出现在ANSI SQL-92标准中定义的三种异常:脏读,不可重复读和幻读。但SI无法实现真正的可串行化,因为在SI中可能会出现串行化异常:例如写偏差(write skew)和只读事务偏差(Read-only Transaction Skew)。需要注意的是:ANSI SQL-92标准中可串行化的定义与现代理论中的定义并不相同。为了解决这个问题,PostgreSQL从9.1版本之后添加了可串行化快照隔离(SSI,Serializable Snapshot Isolation),SSI可以检测串行化异常,并解决这种异常导致的冲突。因此,9.1版本之后的PostgreSQL提供了真正的SERIALIZABLE隔离等级(此外SQL Server也使用SSI,而Oracle仍然使用SI)。
本章包括以下四个部分:
-
第1部分:第5.1~5.3节。
这一部分介绍了理解后续部分所需的基本信息。
第5.1和5.2节分别描述了事务标识和元组结构。第5.3节展示了如何插入,删除和更新元组。
-
第2部分:第5.4~5.6节。
这一部分说明了实现并发控制机制所需的关键功能。
第5.4,5.5和5.6节描述了提交日志(clog),分别介绍了事务状态,事务快照和可见性检查规则。
-
第3部分:第5.7~5.9节。
这一部分使用具体的例子来介绍PostgreSQL中的并发控制。
这一部分说明了如何防止ANSI SQL标准中定义的三种异常。第5.7节描述了可见性检查,第5.8节介绍了如何防止丢失更新,第5.9节简要描述了SSI。
-
第4部分:第5.10节。
这一部分描述了并发控制机制持久运行所需的几个维护过程。维护过程主要通过 清理过程(vacuum processing) 进行,清理过程将在第6章详细阐述。
并发控制包含着很多主题,本章重点介绍 PostgreSQL 独有的内容。故这里省略了锁模式与死锁处理的内容(相关信息请参阅官方文档)。
PostgreSQL中的事务隔离等级
PostgreSQL实现的事务隔离等级如下表所示:
隔离等级 脏读 不可重复读 幻读 串行化异常 读已提交 不可能 可能 可能 可能 可重复读[1] 不可能 不可能 PG中不可能,见5.7.2小节
但ANSI SQL中可能可能 可串行化 不可能 不可能 不可能 不可能 [1]:在9.0及更早版本中,该级别被当做
SERIALIZABLE,因为它不会出现ANSI SQL-92标准中定义的三种异常。 但9.1版中SSI的实现引入了真正的SERIALIZABLE级别,该级别已被改称为REPEATABLE READ。
PostgreSQL对DML(
SELECT, UPDATE, INSERT, DELETE等命令)使用SSI,对DDL(CREATE TABLE等命令)使用2PL。
5.1 事务标识
每当事务开始时,事务管理器就会为其分配一个称为 事务标识(transaction id, txid) 的唯一标识符。 PostgreSQL的txid是一个32位无符号整数,总取值约42亿。在事务启动后执行内置的txid_current()函数,即可获取当前事务的txid,如下所示。
PostgreSQL保留以下三个特殊txid:
- 0表示 无效(Invalid) 的
txid。 - 1表示 初始启动(Bootstrap) 的
txid,仅用于数据库集群的初始化过程。 - 2表示 冻结(Frozen) 的
txid,详情参考第5.10.1节。
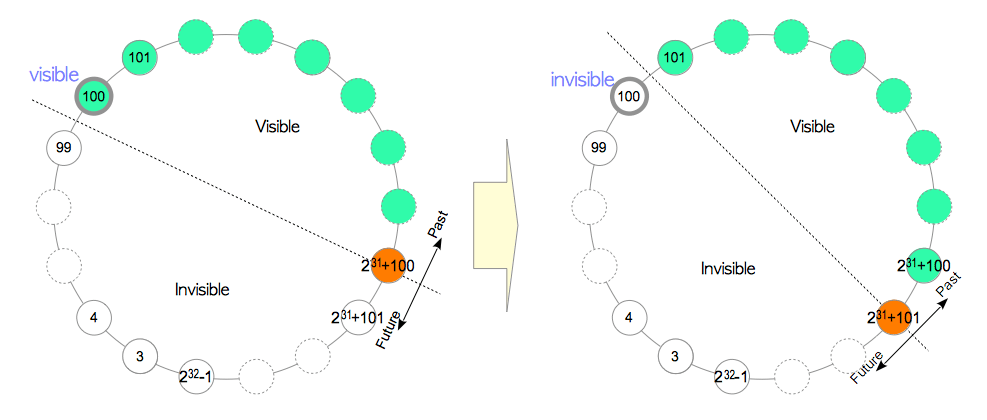
txid可以相互比较大小。例如对于txid=100的事务,大于100的txid属于“未来”,且对于txid=100的事务而言都是 不可见(invisible) 的;
小于100的txid属于“过去”,且对该事务可见,如图5.1(a)所示。
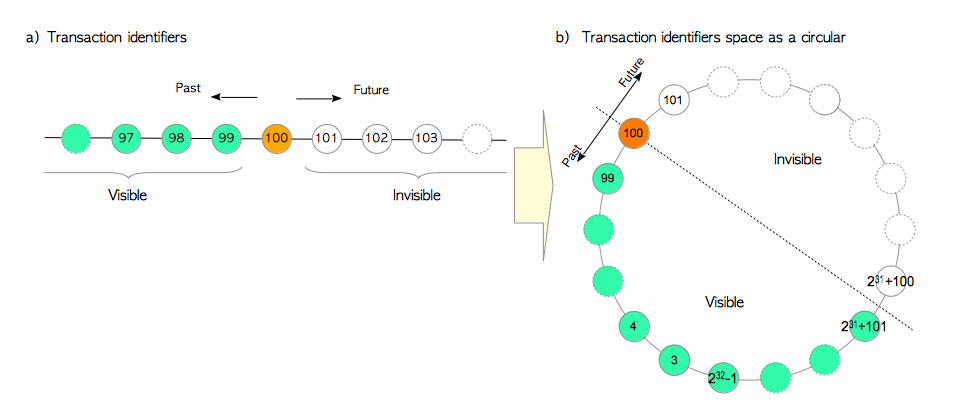
因为txid在逻辑上是无限的,而实际系统中的txid空间不足(4字节取值空间约42亿),因此PostgreSQL将txid空间视为一个环。对于某个特定的txid,其前约21亿个txid属于过去,而其后约21亿个txid属于未来。如图5.1(b)所示。
所谓的txid回卷问题将在5.10.1节中介绍。
请注意,
txid并非是在BEGIN命令执行时分配的。在PostgreSQL中,当执行BEGIN命令后的第一条命令时,事务管理器才会分配txid,并真正启动其事务。
5.2 元组结构
可以将表页中的堆元组分为两类:普通数据元组与TOAST元组。本节只会介绍普通元组。
堆元组由三个部分组成,即HeapTupleHeaderData结构,空值位图,以及用户数据,如图5.2所示。
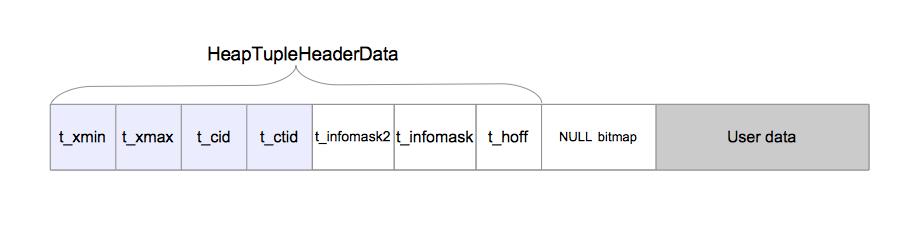
HeapTupleHeaderData结构在src/include/access/htup_details.h中定义。
虽然HeapTupleHeaderData结构包含七个字段,但后续部分中只需要了解四个字段即可。
t_xmin保存插入此元组的事务的txid。t_xmax保存删除或更新此元组的事务的txid。如果尚未删除或更新此元组,则t_xmax设置为0,即无效。t_cid保存命令标识(command id, cid),cid意思是在当前事务中,执行当前命令之前执行了多少SQL命令,从零开始计数。例如,假设我们在单个事务中执行了三条INSERT命令BEGIN;INSERT;INSERT;INSERT;COMMIT;。如果第一条命令插入此元组,则该元组的t_cid会被设置为0。如果第二条命令插入此元组,则其t_cid会被设置为1,依此类推。t_ctid保存着指向自身或新元组的元组标识符(tid)。如第1.3节中所述,tid用于标识表中的元组。在更新该元组时,其t_ctid会指向新版本的元组;否则t_ctid会指向自己。
5.3 元组的增删改
本节会介绍元组的增删改过程,并简要描述用于插入与更新元组的自由空间映射(Free Space Map, FSM)。
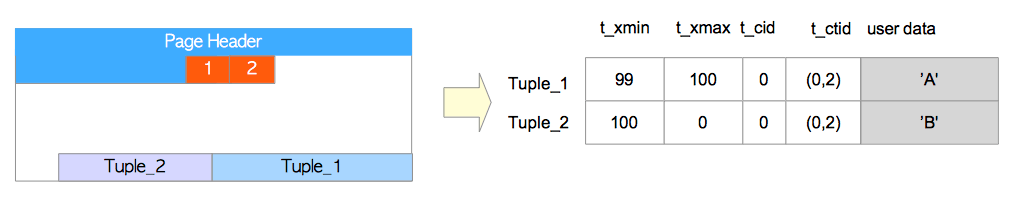
这里主要关注元组,页首部与行指针不会在这里画出来,元组的具体表示如图5.3所示。
5.3.1 插入
在插入操作中,新元组将直接插入到目标表的页面中,如图5.4所示。
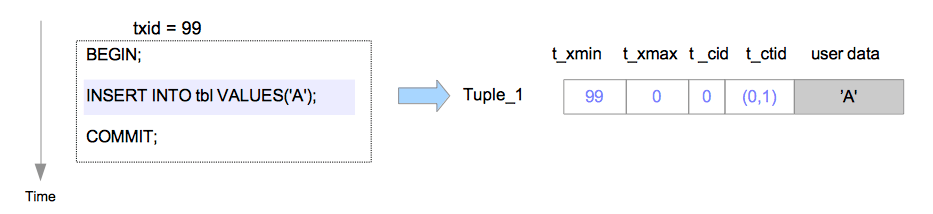
假设元组是由txid=99的事务插入页面中的,在这种情况下,被插入元组的首部字段会依以下步骤设置。
Tuple_1:
t_xmin设置为99,因为此元组由txid=99的事务所插入。t_xmax设置为0,因为此元组尚未被删除或更新。t_cid设置为0,因为此元组是由txid=99的事务所执行的第一条命令所插入的。t_ctid设置为(0,1),指向自身,因为这是该元组的最新版本。
pageinspectPostgreSQL自带了一个第三方贡献的扩展模块
pageinspect,可用于检查数据库页面的具体内容。
5.3.2 删除
在删除操作中,目标元组只是在逻辑上被标记为删除。目标元组的t_xmax字段将被设置为执行DELETE命令事务的txid。如图5.5所示。
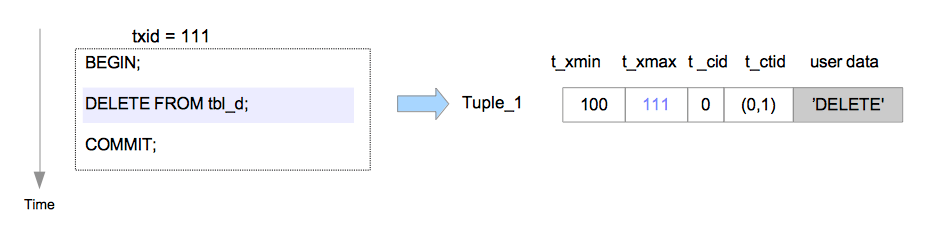
Tuple_1被txid=111的事务删除。在这种情况下,Tuple_1的首部字段会依以下步骤设置。
Tuple_1:
t_xmax被设为111。
如果txid=111的事务已经提交,那么Tuple_1就不是必需的了。通常不需要的元组在PostgreSQL中被称为死元组(dead tuple)。
死元组最终将从页面中被移除。清除死元组的过程被称为清理(VACUUM)过程,第6章将介绍清理过程。
5.3.3 更新
在更新操作中,PostgreSQL在逻辑上实际执行的是删除最新的元组,并插入一条新的元组(图5.6)。
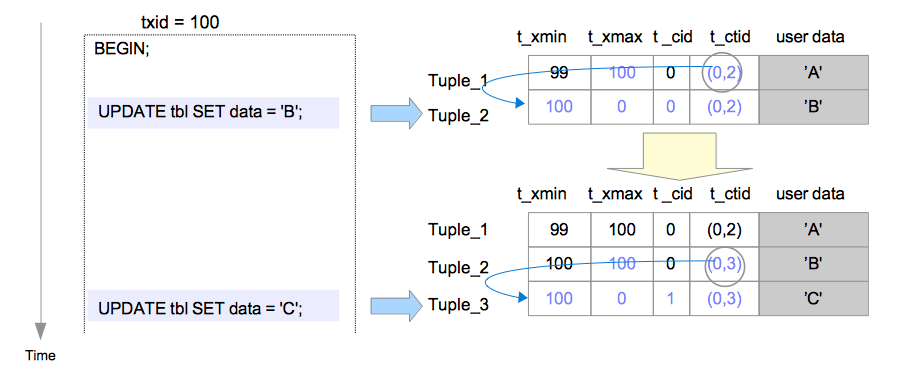
假设由txid=99的事务插入的行,被txid=100的事务更新两次。
当执行第一条UPDATE命令时,Tuple_1的t_xmax被设为txid 100,在逻辑上被删除;然后Tuple_2被插入;接下来重写Tuple_1的t_ctid以指向Tuple_2。Tuple_1和Tuple_2的头部字段设置如下。
Tuple_1:
t_xmax被设置为100。t_ctid从(0,1)被改写为(0,2)。
Tuple_2:
t_xmin被设置为100。t_xmax被设置为0。t_cid被设置为0。t_ctid被设置为(0,2)。
当执行第二条UPDATE命令时,和第一条UPDATE命令类似,Tuple_2被逻辑删除,Tuple_3被插入。Tuple_2和Tuple_3的首部字段设置如下。
Tuple_2:
t_xmax被设置为100。t_ctid从(0,2)被改写为(0,3)。
Tuple_3:
t_xmin被设置为100。t_xmax被设置为0。t_cid被设置为1。t_ctid被设置为(0,3)。
与删除操作类似,如果txid=100的事务已经提交,那么Tuple_1和Tuple_2就成为了死元组,而如果txid=100的事务中止,Tuple_2和Tuple_3就成了死元组。
5.3.4 空闲空间映射
插入堆或索引元组时,PostgreSQL使用表与索引相应的FSM来选择可供插入的页面。
如1.2.3节所述,表和索引都有各自的FSM。每个FSM存储着相应表或索引文件中每个页面可用空间容量的信息。
所有FSM都以后缀fsm存储,在需要时它们会被加载到共享内存中。
pg_freespacemap扩展
pg_freespacemap能提供特定表或索引上的空闲空间信息。以下查询列出了特定表中每个页面的空闲率。
5.4 提交日志(clog)
PostgreSQL在提交日志(Commit Log, clog)中保存事务的状态。提交日志(通常称为clog)分配于共享内存中,并用于事务处理过程的全过程。
本节将介绍PostgreSQL中事务的状态,clog的工作方式与维护过程。
5.4.1 事务状态
PostgreSQL定义了四种事务状态,即:IN_PROGRESS,COMMITTED,ABORTED和SUB_COMMITTED。
前三种状态涵义显而易见。例如当事务正在进行时,其状态为IN_PROGRESS,依此类推。
SUB_COMMITTED状态用于子事务,本文省略了与子事务相关的描述。
5.4.2 提交日志如何工作
提交日志(下称clog)在逻辑上是一个数组,由共享内存中一系列8KB页面组成。数组的序号索引对应着相应事务的标识,而其内容则是相应事务的状态。clog的工作方式如图5.7所示。
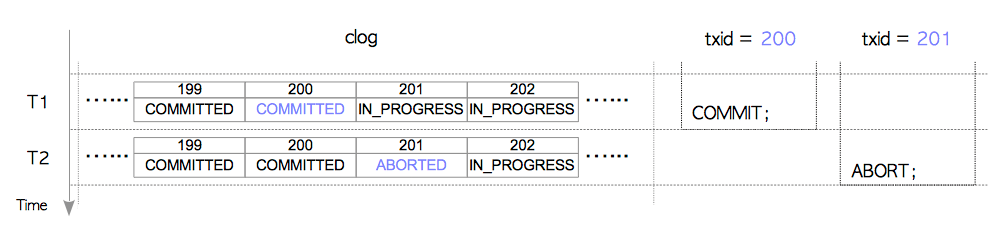
T1:
txid 200提交;txid 200的状态从IN_PROGRESS变为COMMITTED。 T2:txid 201中止;txid 201的状态从IN_PROGRESS变为ABORTED。
txid不断前进,当clog空间耗尽无法存储新的事务状态时,就会追加分配一个新的页面。
当需要获取事务的状态时,PostgreSQL将调用相应内部函数读取clog,并返回所请求事务的状态。(参见第5.7.1节中的提示位(Hint Bits))
5.4.3 提交日志的维护
当PostgreSQL关机或执行存档过程时,clog数据会写入至pg_clog子目录下的文件中(注意在10版本中,pg_clog被重命名为pg_xact)。这些文件被命名为0000,0001等等。文件的最大尺寸为256 KB。例如当clog使用八个页面时,从第一页到第八页的总大小为64 KB,这些数据会写入到文件0000(64 KB)中;而当clog使用37个页面时(296 KB),数据则会写入到0000和0001两个文件中,其大小分别为256 KB和40 KB。
当PostgreSQL启动时会加载存储在pg_clog(pg_xact)中的文件,用其数据初始化clog。
clog的大小会不断增长,因为只要clog一填满就会追加新的页面。但并非所有数据都是必需的。第6章中描述的清理过程会定期删除这些不需要的旧数据(clog页面和文件),有关删除clog数据的详情请参见第6.4节。
5.5 事务快照
事务快照(transaction snapshot) 是一个数据集,存储着某个特定事务在某个特定时间点所看到的事务状态信息:哪些事务处于活跃状态。这里活跃状态意味着事务正在进行中,或还没有开始。
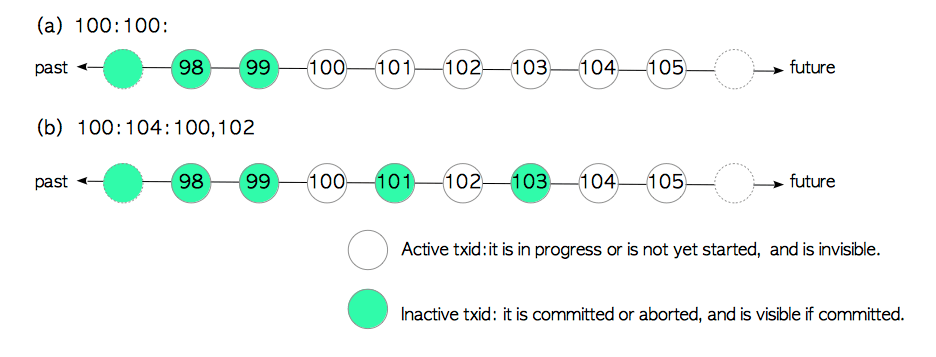
事务快照在PostgreSQL内部的文本表示格式定义为100:100:。举个例子,这里100:100:意味着txid < 100的事务处于非活跃状态,而txid ≥ 100的事务处于活跃状态。下文都将使用这种便利形式来表示。如果读者还不熟悉这种形式,请参阅下文。
内置函数
txid_current_snapshot及其文本表示函数
txid_current_snapshot显示当前事务的快照。
txid_current_snapshot的文本表示是xmin:xmax:xip_list,各部分描述如下。
xmin最早仍然活跃的事务的
txid。所有比它更早的事务txid < xmin要么已经提交并可见,要么已经回滚并生成死元组。
xmax第一个尚未分配的
txid。所有txid ≥ xmax的事务在获取快照时尚未启动,因而其结果对当前事务不可见。
xip_list获取快照时活跃事务的
txid列表。该列表仅包括xmin与xmax之间的txid。例如,在快照
100:104:100,102中,xmin是100,xmax是104,而xip_list为100,102。以下显示了两个具体的示例:
图5.8 事务快照的表示样例
第一个例子是
100:100:,如图图5.8(a)所示,此快照表示:
- 因为
xmin为100,因此txid < 100的事务是非活跃的- 因为
xmax为100,因此txid ≥ 100的事务是活跃的第二个例子是
100:104:100,102,如图5.8(b)所示,此快照表示:
txid < 100的事务不活跃。txid ≥ 104的事务是活跃的。txid等于100和102的事务是活跃的,因为它们在xip_list中,而txid等于101和103的事务不活跃。
事务快照是由事务管理器提供的。在READ COMMITTED隔离级别,事务在执行每条SQL时都会获取快照;其他情况下(REPEATABLE READ或SERIALIZABLE隔离级别),事务只会在执行第一条SQL命令时获取一次快照。获取的事务快照用于元组的可见性检查,如第5.7节所述。
使用获取的快照进行可见性检查时,所有活跃的事务都必须被当成IN PROGRESS的事务等同对待,无论它们实际上是否已经提交或中止。这条规则非常重要,因为它正是READ COMMITTED和REPEATABLE READ/SERIALIZABLE隔离级别中表现差异的根本来源,我们将在接下来几节中频繁回到这条规则上来。
在本节的剩余部分中,我们会通过一个具体的场景来描述事务与事务管理器,如图5.9所示。
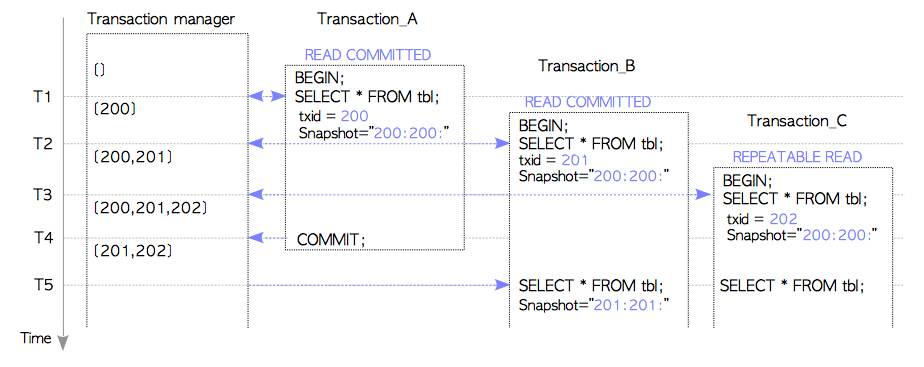
事务管理器始终保存着当前运行的事务的有关信息。假设三个事务一个接一个地开始,并且Transaction_A和Transaction_B的隔离级别是READ COMMITTED,Transaction_C的隔离级别是REPEATABLE READ。
-
T1:
Transaction_A启动并执行第一条SELECT命令。执行第一个命令时,Transaction_A请求此刻的txid和快照。在这种情况下,事务管理器分配txid=200,并返回事务快照200:200:。 -
T2:
Transaction_B启动并执行第一条SELECT命令。事务管理器分配txid=201,并返回事务快照200:200:,因为Transaction_A(txid=200)正在进行中。因此无法从Transaction_B中看到Transaction_A。 -
T3:
Transaction_C启动并执行第一条SELECT命令。事务管理器分配txid=202,并返回事务快照200:200:,因此不能从Transaction_C中看到Transaction_A和Transaction_B。 -
T4:
Transaction_A已提交。事务管理器删除有关此事务的信息。 -
T5:
Transaction_B和Transaction_C执行它们各自的SELECT命令。Transaction_B需要一个新的事务快照,因为它使用了READ COMMITTED隔离等级。在这种情况下,Transaction_B获取新快照201:201:,因为Transaction_A(txid=200)已提交。因此Transaction_A的变更对Transaction_B可见了。Transaction_C不需要新的事务快照,因为它处于REPEATABLE READ隔离等级,并继续使用已获取的快照,即200:200:。因此,Transaction_A的变更仍然对Transaction_C不可见。
5.6 可见性检查规则
可见性检查规则是一组规则,用于确定一条元组是否对一个事务可见,可见性检查规则会用到元组的t_xmin和t_xmax,提交日志clog,以及已获取的事务快照。这些规则太复杂,无法详细解释,故本书只列出了理解后续内容所需的最小规则子集。在下文中省略了与子事务相关的规则,并忽略了关于t_ctid的讨论,比如我们不会考虑在同一个事务中对一条元组多次重复更新的情况。
所选规则有十条,可以分类为三种情况。
5.6.1 t_xmin的状态为ABORTED
t_xmin状态为ABORTED的元组始终不可见(规则1),因为插入此元组的事务已中止。
该规则明确表示为以下数学表达式。
- 规则1:
If Status(t_xmin) = ABORTED ⇒ Invisible
5.6.2 t_xmin的状态为IN_PROGRESS
t_xmin状态为IN_PROGRESS的元组基本上是不可见的(规则3和4),但在一个条件下除外。
如果该元组被另一个进行中的事务插入(t_xmin对应事务状态为IN_PROGRESS),则该元组显然是不可见的(规则4)。
如果t_xmin等于当前事务的txid(即,是当前事务插入了该元组),且t_xmax ≠ 0,则该元组是不可见的,因为它已被当前事务更新或删除(规则3)。
例外是,当前事务插入此元组且t_xmax无效(t_xmax = 0)的情况。 在这种情况下,此元组对当前事务中可见(规则2)。
- 规则2:
If Status(t_xmin) = IN_PROGRESS ∧ t_xmin = current_txid ∧ t_xmax = INVAILD ⇒ Visible - 规则3:
If Status(t_xmin) = IN_PROGRESS ∧ t_xmin = current_txid ∧ t_xmax ≠ INVAILD ⇒ Invisible - 规则4:
If Status(t_xmin) = IN_PROGRESS ∧ t_xmin ≠ current_txid ⇒ Invisible
5.6.3 t_xmin的状态为COMMITTED
t_xmin状态为COMMITTED的元组是可见的(规则 6,8和9),但在三个条件下除外。
规则6是显而易见的,因为t_xmax为INVALID,或者t_xmax对应事务已经中止,相应元组可见。三个例外条件及规则8与规则9的描述如下。
第一个例外情况是t_xmin在获取的事务快照中处于活跃状态(规则5)。在这种情况下,这条元组是不可见的,因为t_xmin应该被视为正在进行中(取快照时创建该元组的事务尚未提交,因此对于REPEATABLE READ以及更高隔离等级而言,即使在判断时创建该元组的事务已经提交,但其结果仍然不可见)。
第二个例外情况是t_xmax是当前的txid(规则7)。这种情况与规则3类似,此元组是不可见的,因为它已经被此事务本身更新或删除。
相反,如果t_xmax的状态是IN_PROGRESS并且t_xmax不是当前的txid(规则8),则元组是可见的,因为它尚未被删除(因为删除该元组的事务尚未提交)。
第三个例外情况是t_xmax的状态为COMMITTED,且t_xmax在获取的事务快照中是非活跃的(规则10)。在这种情况下该元组不可见,因为它已被另一个事务更新或删除。
相反,如果t_xmax的状态为COMMITTED,但t_xmax在获取的事务快照中处于活跃状态(规则9),则元组可见,因为t_xmax对应的事务应被视为正在进行中,删除尚未提交生效。
- 规则5:
If Status(t_xmin) = COMMITTED ∧ Snapshot(t_xmin) = active ⇒ Invisible - 规则6:
If Status(t_xmin) = COMMITTED ∧ (t_xmax = INVALID ∨ Status(t_xmax) = ABORTED) ⇒ Visible - 规则7:
If Status(t_xmin) = COMMITTED ∧ Status(t_xmax) = IN_PROGRESS ∧ t_xmax = current_txid ⇒ Invisible - 规则8:
If Status(t_xmin) = COMMITTED ∧ Status(t_xmax) = IN_PROGRESS ∧ t_xmax ≠ current_txid ⇒ Visible - 规则9:
If Status(t_xmin) = COMMITTED ∧ Status(t_xmax) = COMMITTED ∧ Snapshot(t_xmax) = active ⇒ Visible - 规则10:
If Status(t_xmin) = COMMITTED ∧ Status(t_xmax) = COMMITTED ∧ Snapshot(t_xmax) ≠ active ⇒ Invisible
5.7 可见性检查
本节描述了PostgreSQL执行可见性检查的流程。可见性检查(Visiblity Check),即如何为给定事务挑选堆元组的恰当版本。本节还介绍了PostgreSQL如何防止ANSI SQL-92标准中定义的异常:脏读,可重读和幻读。
5.7.1 可见性检查
图5.10中的场景描述了可见性检查的过程。
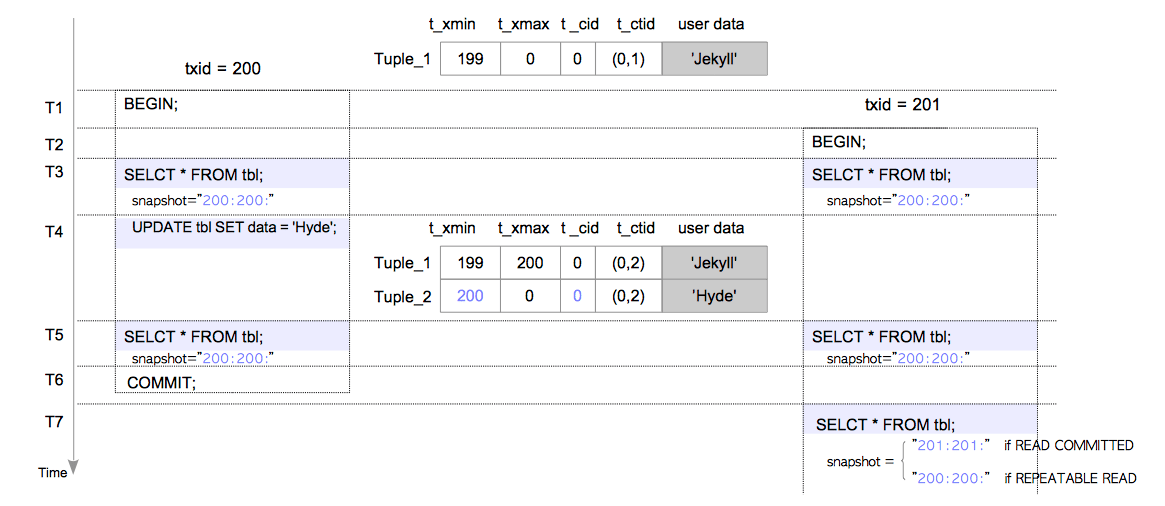
在图5.10所示的场景中,SQL命令按以下时序执行。
- T1:启动事务
(txid=200) - T2:启动事务
(txid=201) - T3:执行
txid=200和201的事务的SELECT命令 - T4:执行
txid=200的事务的UPDATE命令 - T5:执行
txid=200和201的事务的SELECT命令 - T6:提交
txid=200的事务 - T7:执行
txid=201的事务的SELECT命令
为了简化描述,假设这里只有两个事务,即txid=200和201的事务。txid=200的事务的隔离级别是READ COMMITTED,而txid=201的事务的隔离级别是READ COMMITTED或REPEATABLE READ。
我们将研究SELECT命令是如何为每条元组执行可见性检查的。
T3的SELECT命令:
在T3时间点,表tbl中只有一条元组Tuple_1,按照规则6,这条元组是可见的,因此两个事务中的SELECT命令都返回"Jekyll"。
-
Rule 6(Tuple_1) ⇒ Status(t_xmin:199) = COMMITTED ∧ t_xmax = INVALID ⇒ Visible创建元组
Tuple_1的事务199已经提交,且该元组并未被标记删除,因此根据规则6,对当前事务可见。
T5的SELECT命令
首先来看一下由txid=200的事务所执行的SELECT命令。根据规则7,Tuple_1不可见,根据规则2,Tuple_2可见;因此该SELECT命令返回"Hyde"。
-
Rule 7(Tuple_1): Status(t_xmin:199) = COMMITTED ∧ Status(t_xmax:200) = IN_PROGRESS ∧ t_xmax:200 = current_txid:200 ⇒ Invisible创建元组
Tuple_1的事务199已经提交,且该元组被当前事务标记删除,根据规则7,Tuple_1对当前事务不可见。 -
Rule 2(Tuple_2): Status(t_xmin:200) = IN_PROGRESS ∧ t_xmin:200 = current_txid:200 ∧ t_xmax = INVAILD ⇒ Visible创建元组
Tuple_2的事务200正在进行,而且就是当前事务自己,根据规则2,Tuple_2对当前事务可见。
另一方面,在由txid=201的事务所执行的SELECT命令中,Tuple_1基于规则8确定可见,而Tuple_2基于规则4不可见;因此该SELECT命令返回"Jekyll"。
-
Rule 8(Tuple_1): Status(t_xmin:199) = COMMITTED ∧ Status(t_xmax:200) = IN_PROGRESS ∧ t_xmax:200 ≠ current_txid:201 ⇒ Visible元组
Tuple_1由已提交事务199创建,由活跃事务200标记删除,但删除效果对当前事务201不可见。因此根据规则8,Tuple_1可见。 -
Rule 4(Tuple_2): Status(t_xmin:200) = IN_PROGRESS ∧ t_xmin:200 ≠ current_txid:201 ⇒ Invisible元组
Tuple_2由活跃事务200创建,且不是由当前事务自己创建的,故根据规则4,Tuple_2不可见。
如果更新的元组在本事务提交之前被其他事务看见,这种现象被称为脏读(Dirty Reads),也称为写读冲突(wr-conflicts)。 但如上所示,PostgreSQL中任何隔离级别都不会出现脏读。
T7的SELECT命令
在下文中,描述了T7的SELECT命令在两个隔离级别中的行为。
首先来研究txid=201的事务处于READ COMMITTED隔离级别时的情况。 在这种情况下,txid=200的事务被视为已提交,因为在这个时间点获取的事务快照是201:201:。因此Tuple_1根据规则10不可见,Tuple_2根据规则6可见,SELECT命令返回"Hyde"。
-
Rule 10(Tuple_1): Status(t_xmin:199) = COMMITTED ∧ Status(t_xmax:200) = COMMITTED ∧ Snapshot(t_xmax:200) ≠ active ⇒ Invisible元组
Tuple_1由已提交事务199创建,由非活跃的已提交事务200标记删除,Tuple_1按照规则10不可见。 -
Rule 6(Tuple_2): Status(t_xmin:200) = COMMITTED ∧ t_xmax = INVALID ⇒ Visible元组
Tuple_2由已提交事务200创建,且未被标记为删除,故Tuple_2按照规则6可见。
这里需要注意,事务201中的SELECT命令,在txid=200的事务提交前后中时的执行结果是不一样的,这种现象通常被称作不可重复读(Non-Repeatable Read)。
相反的是,当txid=201的事务处于REPEATABLE READ级别时,即使在T7时刻txid=200的事务实际上已经提交,它也必须被视作仍在进行,因而获取到的事务快照是200:200:。 根据规则9,Tuple_1是可见的,根据规则5,Tuple_2不可见,所以最后SELECT命令会返回"Jekyll"。 请注意在REPEATABLE READ(和SERIALIZABLE)级别中不会发生不可重复读。
-
Rule9(Tuple_1): Status(t_xmin:199) = COMMITTED ∧ Status(t_xmax:200) = COMMITTED ∧ Snapshot(t_xmax:200) = active ⇒ Visible元组
Tuple_1由已提交事务199创建,由已提交事务200标记删除,但因为事务200位于当前事物的活跃事务快照中(也就是在当前事物201开始执行并获取事务级快照时,事物200还未提交),因此删除对当前事务尚未生效,根据规则9,Tuple_1可见。Tuple_1按照规则10不可见。 -
Rule5(Tuple_2): Status(t_xmin:200) = COMMITTED ∧ Snapshot(t_xmin:200) = active ⇒ Invisible元组
Tuple_2由已提交事务200创建,但该事务在本事务快照中属于活跃事务(即在本事务开始前还未提交),因此事务200的变更对本事务尚不可见,按照规则5,Tuple_2不可见。
5.7.2 提示位(Hint Bits)
PostgreSQL在内部提供了三个函数TransactionIdIsInProgress、TransactionIdDidCommit和TransactionIdDidAbort来取得事务状态。这些函数已尽量减少对clog的频繁访问,但如果检查每条元组时都执行,仍可能成为性能瓶颈。
PostgreSQL因此使用提示位(hint bits):
读取或写入元组时,PostgreSQL会择机把提示位写入元组的t_infomask。例如,检查t_xmin对应事务后若发现它已提交,就设置HEAP_XMIN_COMMITTED。以后再检查该元组时,无需调用TransactionIdDidCommit或TransactionIdDidAbort,从而提高可见性判断效率。
5.7.3 PostgreSQL可重复读等级中的幻读
ANSI SQL-92标准中定义的REPEATABLE READ隔离等级允许出现幻读(Phantom Reads), 但PostgreSQL实现的REPEATABLE READ隔离等级不允许发生幻读。 在原则上,快照隔离中不允许出现幻读。
假设两个事务Tx_A和Tx_B同时运行。 它们的隔离级别分别为READ COMMITTED和REPEATABLE READ,它们的txid分别为100和101。两个事务一前一后接连开始,首先Tx_A插入一条元组,并提交。 插入的元组的t_xmin为100。接着,Tx_B执行SELECT命令;但根据规则5,Tx_A插入的元组对Tx_B是不可见的。因此不会发生幻读。
-
Rule5(new tuple): Status(t_xmin:100) = COMMITTED ∧ Snapshot(t_xmin:100) = active ⇒ Invisible新元组由已提交的事务
Tx_A创建,但Tx_A在Tx_B的事务快照中处于活跃状态,因此根据规则5,新元组对Tx_B不可见。Tx_A: txid = 100Tx_B: txid = 101START TRANSACTION ISOLATION LEVEL READ COMMITTED;START TRANSACTION ISOLATION LEVEL REPEATABLE READ;INSERT tbl(id, data)COMMIT;SELECT * FROM tbl WHERE id=1;(0 rows)
5.8 防止丢失更新
丢失更新(Lost Update),又被称作写-写冲突(ww-conflict),是事务并发更新同一行时所发生的异常,REPEATABLE READ和SERIALIZABLE隔离等级必须阻止该异常的出现。 本节将会介绍PostgreSQL是如何防止丢失更新的,并举一些例子来说明。
5.8.1 并发UPDATE命令的行为
执行UPDATE命令时,内部实际上调用了ExecUpdate函数。 ExecUpdate的伪代码如下所示:
伪代码:
ExecUpdate
- 获取被本
UPDATE命令更新的每一行,并对每一行依次执行下列操作。- 重复以下过程,直到目标行更新完成,或本事务中止。
- 如果目标行正在被更新则进入步骤(4),否则进入步骤(8)。
- 等待正在更新目标行的事务结束,因为PostgreSQL在SI中使用了 以先更新者为准(first-updater-win) 的方案。
- 如果更新目标行的事务已经提交,且当前事务的隔离等级为可重复读或可串行化则进入步骤(6),否则进入步骤(7)。
- 中止本事务,以防止丢失更新。(因为另一个事务已经对目标行进行了更新并提交)
- 跳转回步骤(2),并对目标行进行新一轮的更新尝试。
- 如果目标行已被另一个并发事务所更新则进入步骤(9),否则进入步骤(12)。
- 如果当前事务的隔离级别为读已提交则进入步骤(10),否则进入步骤(11)。
- 更新目标行,并回到步骤(1),处理下一条目标行。
- 中止当前事务,以防止丢失更新。
- 更新目标行,并回到步骤(1),因为目标行尚未被修改过,或者虽然已经被更新,但更新它的事务已经结束。已终止的事务更新,即存在写写冲突。
此函数依次为每个待更新的目标行执行更新操作。 它有一个外层循环来更新每一行,而内部while循环则包含了三个分支,分支条件如图5.11所示。
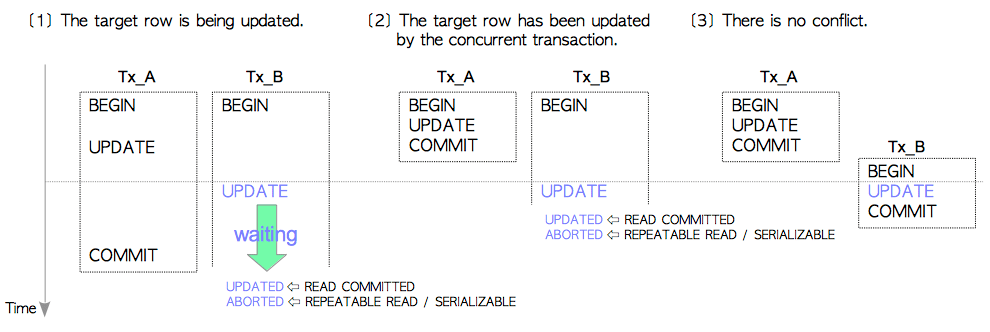
-
目标行正在被更新,如图5.11[1]所示
“正在被更新”意味着该行正在被另一个事务同时更新,且另一个事务尚未结束。在这种情况下,当前事务必须等待更新目标行的事务结束,因为PostgreSQL的SI实现采用 以先更新者为准(first-updater-win) 的方案。例如,假设事务
Tx_A和Tx_B同时运行,且Tx_B尝试更新某一行;但Tx_A已更新了这一行,且仍在进行中。在这种情况下Tx_B会等待Tx_A结束。在更新目标行的事务提交后,当前事务的更新操作将完成等待继续进行。如果当前事务处于
READ COMMITTED隔离等级,则会更新目标行;而若处于REPEATABLE READ或SERIALIZABLE隔离等级时,当前事务则会立即中止,以防止丢失更新。 -
目标行已经被另一个并发事务所更新,如图5.11[2]所示
当前事务尝试更新目标元组,但另一个并发事务已经更新了目标行并提交。在这种情况下,如果当前事务处于
READ COMMITTED级别,则会更新目标行;否则会立即中止以防止丢失更新。 -
没有冲突,如图5.11[3]所示
当没有冲突时,当前事务可以直接更新目标行。
以先更新者为准 / 以先提交者为准
PostgreSQL基于SI的并发控制机制采用 以先更新者为准(first-updater-win) 方案。 相反如下一节所述,PostgreSQL的SSI实现使用 以先提交者为准(first-commiter-win) 方案。
5.8.2 例子
以下是三个例子。 第一个和第二个例子展示了目标行正在被更新时的行为,第三个例子展示了目标行已经被更新的行为。
例1
事务Tx_A和Tx_B更新同一张表中的同一行,它们的隔离等级均为READ COMMITTED。
Tx_A |
Tx_B |
|---|---|
START TRANSACTION ISOLATION LEVEL READ COMMITTED; |
|
START TRANSACTION |
START TRANSACTION ISOLATION LEVEL READ COMMITTED; |
START TRANSACTION |
|
UPDATE tbl SET name = 'Hyde'; |
|
UPDATE 1 |
|
UPDATE tbl SET name = 'Utterson'; |
|
↓ – 本事务进入阻塞状态,等待Tx_A完成 |
|
COMMIT; |
↓ – Tx_A提交,阻塞解除 |
UPDATE 1 |
Tx_B的执行过程如下:
- 在执行
UPDATE命令之后,Tx_B应该等待Tx_A结束,因为目标元组正在被Tx_A更新(ExecUpdate步骤4) - 在
Tx_A提交后,Tx_B尝试更新目标行(ExecUpdate步骤7) - 在
ExecUpdate内循环第二轮中,目标行被Tx_B更新(ExecUpdate步骤2,8,9,10)。
例2
Tx_A和Tx_B更新同一张表中的同一行,它们的隔离等级分别为读已提交和可重复读。
Tx_A |
Tx_B |
|---|---|
START TRANSACTION ISOLATION LEVEL READ COMMITTED; |
|
START TRANSACTION |
START TRANSACTION ISOLATION LEVEL REPEATABLE READ; |
START TRANSACTION |
|
UPDATE tbl SET name = 'Hyde'; |
|
UPDATE 1 |
|
UPDATE tbl SET name = 'Utterson'; |
|
↓ – 本事务进入阻塞状态,等待Tx_A完成 |
|
COMMIT; |
↓ – Tx_A提交,阻塞解除 |
ERROR:couldn't serialize access due to concurrent update |
Tx_B的执行过程如下:
Tx_B在执行UPDATE命令后阻塞,等待Tx_A终止(ExecUpdate步骤4)。- 当
Tx_A提交后,Tx_B会中止以解决冲突。因为目标行已经被更新,且当前事务Tx_B的隔离级别为可重复读(ExecUpdate步骤5,6)。
例3
Tx_B(可重复读)尝试更新已经被Tx_A更新的目标行,且Tx_A已经提交。 在这种情况下,Tx_B会中止(ExecUpdate中的步骤2,8,9,11)。
Tx_A |
Tx_B |
|---|---|
START TRANSACTION ISOLATION LEVEL READ COMMITTED; |
|
START TRANSACTION |
START TRANSACTION ISOLATION LEVEL REPEATABLE READ; |
START TRANSACTION |
|
UPDATE tbl SET name = 'Hyde'; |
|
UPDATE 1 |
|
COMMIT; |
|
UPDATE tbl SET name = 'Utterson'; |
|
ERROR:couldn't serialize access due to concurrent update |
5.9 可串行化快照隔离
从版本9.1开始,可串行化快照隔离(SSI)已经嵌入到快照隔离(SI)中,用以实现真正的可串行化隔离等级。SSI解释起来过于复杂,故本书仅解释其概要,详细信息请参阅文献[2]。
下文使用了以下技术术语而未加定义。 如果读者不熟悉这些术语,请参阅[1,3]。
- 前趋图(precedence graph),亦称作依赖图(dependency graph)或串行化图(serialization graph)
- 串行化异常(serialization anomalies)(例如,写偏差(Write-Skew))
5.9.1 SSI实现的基本策略
如果前趋图中存在由某些冲突构成的环,则会出现串行化异常。 这里使用一种最简单的异常来解释,即写偏差(Write-Skew)。
图5.12(1)展示了一种调度方式。 这里Transaction_A读取了Tuple_B,Transaction_B读取了Tuple_A。 然后Transaction_A写Tuple_A,Transaction_B写Tuple_B。 在这种情况下存在两个读-写冲突(rw-conflict),它们在该调度的前趋图中构成了一个环,如图5.12(2)所示。 故该调度存在串行化异常,即写偏差。
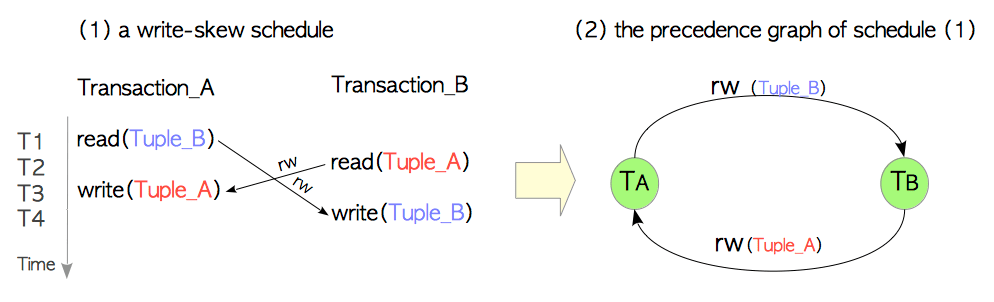
从概念上讲,存在三种类型的冲突:写-读冲突(wr-conflicts)(脏读),写-写冲突(ww-conflicts)(丢失更新),以及读写冲突(rw-conflicts)。 但是这里无需考虑写-读冲突与写-写冲突,因为如前所述,PostgreSQL可以防止此类冲突。 因此PostgreSQL中的SSI实现只需要考虑读-写冲突。
PostgreSQL在SSI实现中采用以下策略:
- 使用SIREAD锁记录事务访问的所有对象(元组,页面,关系)。
- 当写入任何堆元组/索引元组时,使用SIREAD锁检测读-写冲突。
- 如果从读-写冲突中检测出串行化异常,则中止事务。
5.9.2 PostgreSQL的SSI实现
为了实现上述策略,PostgreSQL实现了很多数据结构与函数。 但这里我们只会使用两种数据结构:SIREAD锁与读-写冲突来描述SSI机制。它们都储存在共享内存中。
为简单起见,本文省略了一些重要的数据结构,例如
SERIALIZABLEXACT。 因此对CheckTargetForConflictOut,CheckTargetForConflictIn和PreCommit_CheckForSerializationFailure等函数的解释也极为简化。比如本文虽然指出哪些函数能检测到冲突;但并没有详细解释如何检测冲突。 如果读者想了解详细信息,请参阅源代码:predicate.c。
SIREAD锁
SIREAD锁,在内部又被称为谓词锁(predicate lock),是一个由对象与(虚拟)事务标识构成的二元组,存储着哪个事务访问了哪个对象的相关信息。注意这里省略了对虚拟事务标识的描述,使用txid而非虚拟txid能大幅简化说明。
在SERIALIZABLE模式下只要执行DML命令,就会通过CheckTargetForConflictsOut函数创建出SIREAD锁。举个例子,如果txid=100的事务读取给定表的Tuple_1,则会创建一个SIREAD锁{Tuple_1,{100}}。如果是其他事务,例如txid=101读取了Tuple_1,则SIREAD锁会更新为{Tuple_1,{100,101}}。请注意,读取索引页时也会创建SIREAD锁,因为在使用了第7.2节中将描述的 仅索引扫描(Index-Only Scan) 时,数据库只会读取索引页而不读取表页。
SIREAD锁有三个级别:元组,页面,以及关系。如果单个页面内所有元组的SIREAD锁都被创建,则它们会聚合为该页上的单个SIREAD锁,原有相关元组上的SIREAD锁都会被释放(删除),以减少内存空间占用。对读取的页面也是同理。
当为索引创建SIREAD锁时,一开始会创建页级别的SIREAD锁。当使用顺序扫描时,无论是否存在索引,是否存在WHERE子句,一开始都会创建关系级别的SIREAD锁。请注意在某些情况下,这种实现可能会导致串行化异常的误报(假阳性(false-positive)),细节将在第5.9.4节中描述。
读-写冲突
读-写冲突是一个三元组,由SIREAD锁,以及两个分别读写该SIREAD锁的事务txid构成。
当在可串行化模式下执行INSERT,UPDATE或DELETE命令时,函数CheckTargetForConflictsIn会被调用,并检查SIREAD锁来检测是否存在冲突,如果有就创建一个读-写冲突。
举个例子,假设txid = 100的事务读取了Tuple_1,然后txid=101的事务更新了Tuple_1。在这种情况下,txid=101的事务中的UPDATE命令会调用CheckTargetForConflictsIn函数,并检测到在Tuple_1上存在txid=100,101之间的读-写冲突,并创建rw-conflict{r = 100, w = 101, {Tuple_1}}。
CheckTargetForConflictOut、CheckTargetForConflictIn函数,以及在可串行化模式中执行COMMIT命令会触发的PreCommit_CheckForSerializationFailure函数,都会使用创建的读写冲突来检查串行化异常。如果它们检测到异常,则只有先提交的事务会真正提交,其他事务会中止(依据 以先提交者为准(first-committer-win) 策略)。
5.9.3 SSI的原理
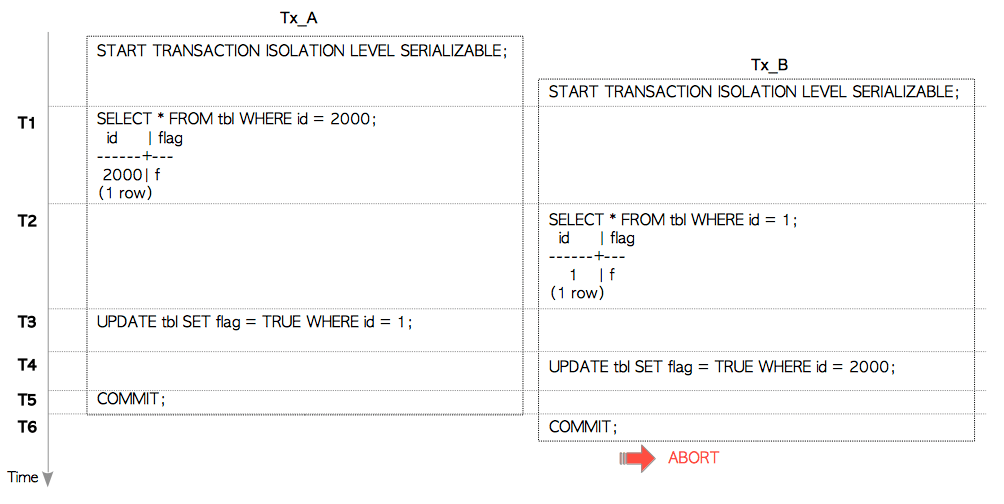
本节将描述SSI如何解决写偏差异常,下面将使用一个简单的表tbl为例。
事务Tx_A和Tx_B执行以下命令,如图5.13所示。
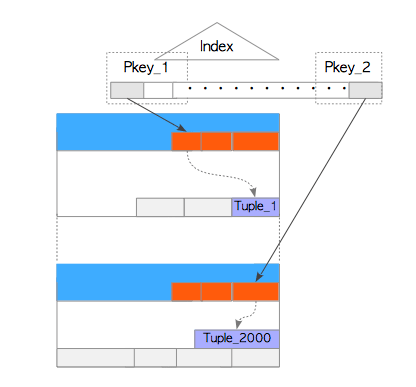
假设所有命令都使用索引扫描。 因此当执行命令时,它们会同时读取堆元组与索引页,每个索引页都包含指向相应堆元组的索引元组,如图5.14所示。
- T1:
Tx_A执行SELECT命令,该命令读取堆元组Tuple_2000,以及包含主键的索引页Pkey_2。 - T2:
Tx_B执行SELECT命令。 此命令读取堆元组Tuple_1,以及包含主键的索引页Pkey_1。 - T3:
Tx_A执行UPDATE命令,更新Tuple_1。 - T4:
Tx_B执行UPDATE命令,更新Tuple_2000。 - T5:
Tx_A提交。 - T6:
Tx_B提交,然而由于写偏差异常而被中止。
图5.15展示了PostgreSQL如何检测和解决上述场景中描述的写偏差异常。
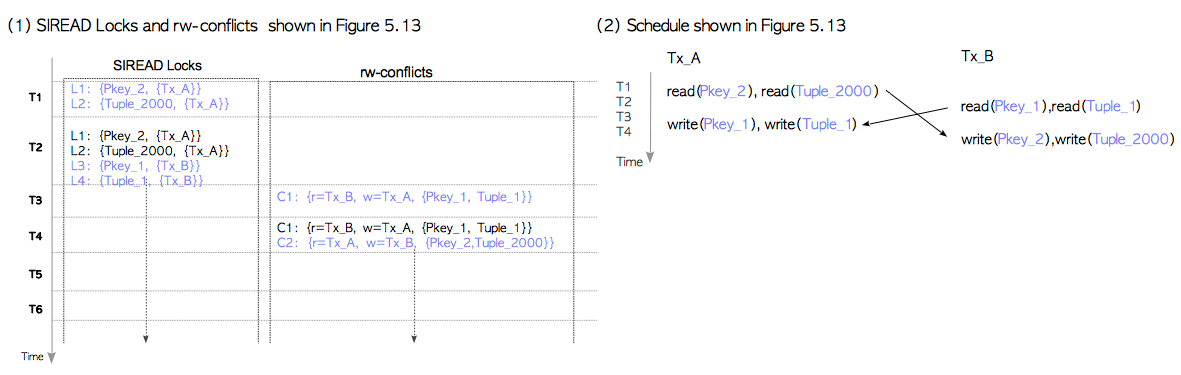
-
T1: 执行
Tx_A的SELECT命令时,CheckTargetForConflictsOut会创建SIREAD锁。在本例中该函数会创建两个SIREAD锁:L1与L2。L1和L2分别与Pkey_2和Tuple_2000相关联。 -
T2: 执行
Tx_B的SELECT命令时,CheckTargetForConflictsOut会创建两个SIREAD锁:L3和L4。L3和L4分别与Pkey_1和Tuple_1相关联。 -
T3: 执行
Tx_A的UPDATE命令时,CheckTargetForConflictsOut和CheckTargetForConflictsIN会分别在ExecUpdate执行前后被调用。在本例中,CheckTargetForConflictsOut什么都不做。而CheckTargetForConflictsIn则会创建读-写冲突C1,这是Tx_B和Tx_A在Pkey_1和Tuple_1上的冲突,因为Pkey_1和Tuple_1都由Tx_B读取并被Tx_A写入。 -
T4: 执行
Tx_B的UPDATE命令时,CheckTargetForConflictsIn会创建读-写冲突C2,这是Tx_A与Tx_B在Pkey_2和Tuple_2000上的冲突。在这种情况下,
C1和C2在前趋图中构成一个环;因此Tx_A和Tx_B处于不可串行化状态。但事务Tx_A和Tx_B都尚未提交,因此CheckTargetForConflictsIn不会中止Tx_B。注意这是因为PostgreSQL的SSI实现采用先提交者为准方案。 -
T5: 当
Tx_A尝试提交时,将调用PreCommit_CheckForSerializationFailure。此函数可以检测串行化异常,并在允许的情况下执行提交操作。在这里因为Tx_B仍在进行中,Tx_A成功提交。 -
T6: 当
Tx_B尝试提交时,PreCommit_CheckForSerializationFailure检测到串行化异常,且Tx_A已经提交;因此Tx_B被中止。
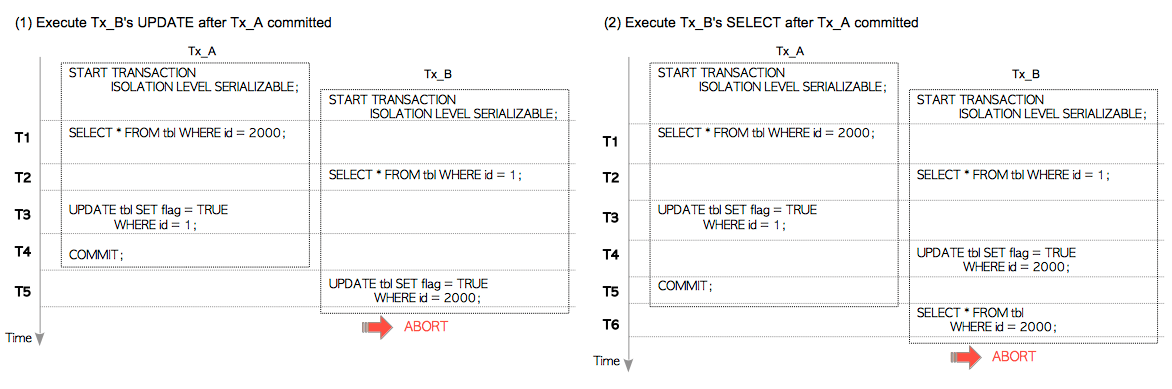
此外,如果在Tx_A提交之后(T5时刻),Tx_B执行了UPDATE命令,则Tx_B会立即中止。因为Tx_B的UPDATE命令会调用CheckTargetForConflictsIn,并检测到串行化异常,如图5.16(1)所示。
如果Tx_B在T6时刻执行SELECT命令而不是COMMIT命令,则Tx_B也会立即中止。因为Tx_B的SELECT命令调用的CheckTargetForConflictsOut会检测到串行化异常,如图5.16(2)所示。
这里的Wiki解释了几种更为复杂的异常。
5.9.4 假阳性的串行化异常
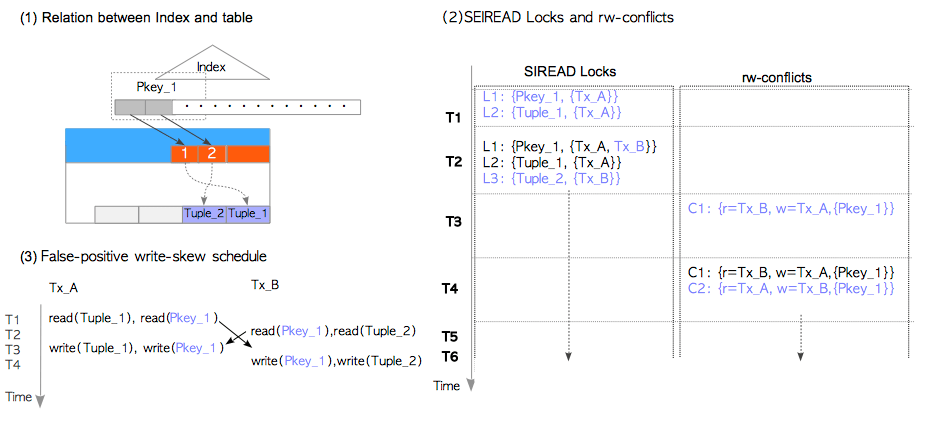
在可串行化模式下,因为永远不会检测到 假阴性(false-negative,发生异常但未检测到) 串行化异常,PostgreSQL能始终完全保证并发事务的可串行性。 但相应的是在某些情况下,可能会检测到假阳性异常(没有发生异常但误报发生),用户在使用SERIALIZABLE模式时应牢记这一点。 下文会描述PostgreSQL检测到假阳性异常的情况。
图5.17展示了发生假阳性串行化异常的情况。
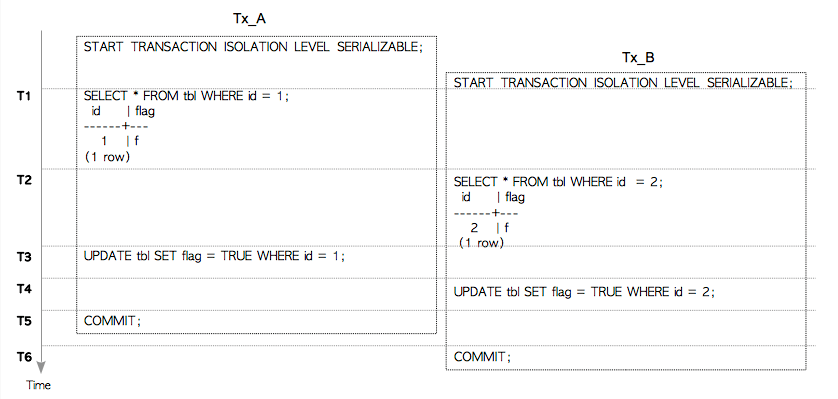
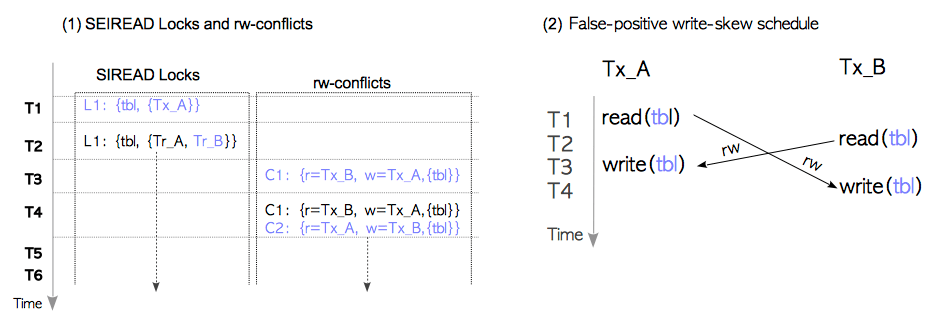
当使用顺序扫描时,如SIREAD锁的解释中所述,PostgreSQL创建了一个关系级的SIREAD锁。 图5.18(1)展示了PostgreSQL使用顺序扫描时的SIREAD锁和读-写冲突。 在这种情况下,产生了与tbl表上SIREAD锁相关联的读-写冲突:C1和C2,并且它们在前趋图中构成了一个环。 因此会检测到假阳性的写偏差异常(即,虽然实际上没有冲突,但Tx_A与Tx_B两者之一也将被中止)。
即使使用索引扫描,如果事务Tx_A和Tx_B都获取里相同的索引SIREAD锁,PostgreSQL也会误报假阳性异常。 图5.19展示了这种情况。 假设索引页Pkey_1包含两条索引项,其中一条指向Tuple_1,另一条指向Tuple_2。 当Tx_A和Tx_B执行相应的SELECT和UPDATE命令时,Pkey_1同时被Tx_A和Tx_B读取与写入。 这时候会产生Pkey_1相关联的读-写冲突:C1和C2,并在前趋图中构成一个环,因而检测到假阳性写偏差异常(如果Tx_A和Tx_B获取不同索引页上的SIREAD锁则不会误报,并且两个事务都可以提交)。
5.10 所需的维护进程
PostgreSQL的并发控制机制需要以下维护过程。
- 删除死元组及指向死元组的索引元组
- 移除 提交日志(clog) 中非必需的部分
- 冻结旧的 事务标识(txid)
- 更新FSM,VM,以及统计信息
第5.3.2和5.4.3节分别解释了为什么需要第一个和第二个过程。第三个过程与事务标识回卷问题有关,本小节将概述 事务标识回卷(txid wrap around) 问题。
在PostgreSQL中,清理过程(VACUUM)负责这些过程。 清理过程(VACUUM) 在第6章中描述。
5.10.1 事务标识回卷问题
接下来将介绍 事务标识回卷(txid wrap around) 问题。
假设元组Tuple_1是由txid = 100事务创建的,即Tuple_1的t_xmin = 100。服务器运行了很长时间,但Tuple_1一直未曾被修改。假设txid已经前进到了,这时候正好执行了一条SELECT命令。此时,因为对当前事务而言txid = 100的事务属于过去的事务,因而Tuple_1对当前事务可见。然后再执行相同的SELECT命令,此时txid步进至。但因对当前事务而言,txid = 100的事务是属于未来的,因此Tuple_1不再可见(图5.20)。这就是PostgreSQL中所谓的事务回卷问题。
5.10.2 冻结处理
为了解决这个问题,PostgreSQL引入了一个 冻结事务标识(Frozen txid) 的概念,并实现了一个名为FREEZE的过程。
在PostgreSQL中定义了一个冻结的txid,它是一个特殊的保留值txid = 2,在参与事务标识大小比较时,它总是比所有其他txid都旧。换句话说,冻结的txid始终处于非活跃状态,且其结果对其他事务始终可见。
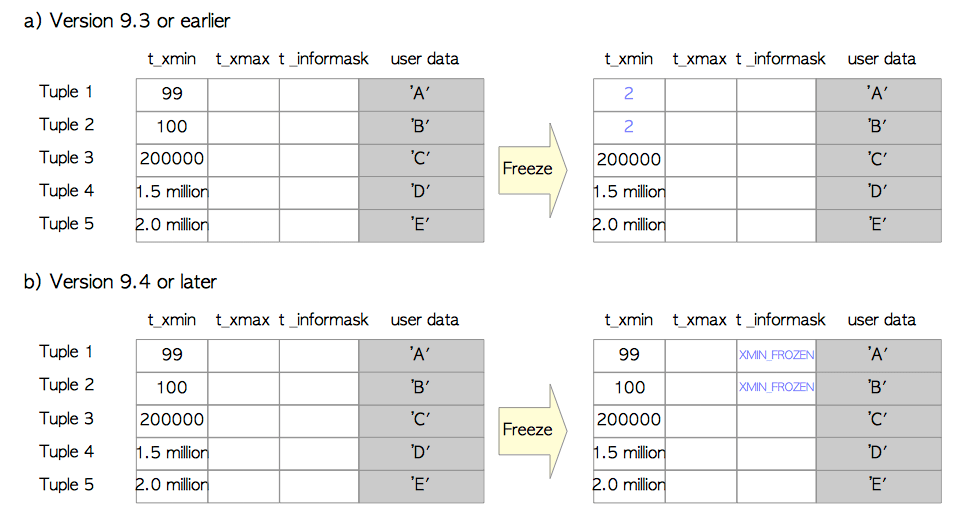
清理过程(VACUUM)会调用冻结过程(FREEZE)。冻结过程将扫描所有表文件,如果元组的t_xmin比当前txid - vacuum_freeze_min_age(默认值为5000万)更老,则将该元组的t_xmin重写为冻结事务标识。在第6章中会有更详细的解释。
举个例子,如图5.21(a)所示,当前txid为5000万,此时通过VACUUM命令调用冻结过程。在这种情况下,Tuple_1和Tuple_2的t_xmin都被重写为2。
在版本9.4或更高版本中使用元组t_infomask字段中的XMIN_FROZEN标记位来标识冻结元组,而不是将元组的t_xmin重写为冻结的txid,如图5.21(b)所示。
参考文献
- [1] Abraham Silberschatz, Henry F. Korth, and S. Sudarshan, “Database System Concepts”, McGraw-Hill Education, ISBN-13: 978-0073523323
- [2] Dan R. K. Ports, and Kevin Grittner, “Serializable Snapshot Isolation in PostgreSQL”, VLDB 2012
- [3] Thomas M. Connolly, and Carolyn E. Begg, “Database Systems”, Pearson, ISBN-13: 978-0321523068
6 清理过程
清理(VACUUM) 是一种维护过程,有助于 PostgreSQL 的持久运行。它的两个主要任务是删除死元组,以及冻结事务标识,两者都在第5.10节中简要提到过。
为了移除死元组,清理过程有两种模式:并发清理(Concurrent Vacuum) 与完整清理(Full Vacuum) 。并发清理(通常简称为VACUUM)会删除表文件每个页面中的死元组,而其他事务可以在其运行时继续读取该表。
相反,完整清理不仅会移除整个文件中所有的死元组,还会对整个文件中所有的活元组进行碎片整理。而其他事务在完整清理运行时无法访问该表。
尽管清理过程对PostgreSQL至关重要,但与其他功能相比,它的改进相对其他功能而言要慢一些。例如在8.0版本之前,清理过程必须手动执行(通过psql实用程序或使用cron守护进程)。直到2005年实现了autovacuum守护进程时,这一过程才实现了自动化。
由于清理过程涉及到全表扫描,因此该过程代价高昂。在版本8.4(2009)中引入了 可见性映射(Visibility Map, VM) 来提高移除死元组的效率。在版本 9.6(2016)中增强了VM,从而改善了冻结过程的表现。
6.1节概述了并发清理的过程,而后续部分的内容如下所示:
- 可见性映射
- 冻结(Freeze) 过程
- 移除不必要的clog文件
- 自动清理(AutoVacuum) 守护进程
- 回收表膨胀空间,包括完整清理与并发
REPACK
6.1 并发清理概述
清理过程为指定的表,或数据库中的所有表执行以下任务。
- 移除死元组
- 移除每一页中的死元组,并对每一页内的活元组进行碎片整理。
- 移除指向死元组的索引元组。
- 冻结旧的事务标识(
txid)- 如有必要,冻结旧元组的事务标识(txid)。
- 更新与冻结事务标识相关的系统视图(
pg_database与pg_class)。 - 如果可能,移除非必需的提交日志(clog)。
- 其他
- 更新已处理表的空闲空间映射(FSM)和可见性映射(VM)。
- 更新一些统计信息(
pg_stat_all_tables等)。
这里假设读者已经熟悉以下术语:死元组,冻结事务标识,FSM,clog;如果读者不熟悉这些术语的含义,请参阅第5章。VM将在第6.2节中介绍。
以下伪代码描述了清理的过程。
伪码:并发清理
- 从指定的表集中依次处理每一张表。
- 获取表上的
ShareUpdateExclusiveLock锁, 此锁允许其他事务对该表进行读取。- 扫描表中所有的页面,以获取所有的死元组,并在必要时冻结旧元组。
- 删除指向相应死元组的索引元组(如果存在)。
- 对表的每个页面执行步骤(6)和(7)中的操作
- 移除死元组,并重新分配页面中的活元组。
- 更新目标表对应的FSM与VM。
- 如果最后一个页面没有任何元组,则截断最后一页。
- 更新与目标表清理过程相关的统计数据和系统视图。
- 更新与清理过程相关的统计数据和系统视图。
- 如果可能,移除clog中非必需的文件与页面。
该伪码分为两大块:一块是依次处理表的循环,一块是后处理逻辑。而循环块又能分为三个部分,每一个部分都有各自的任务。接下来会描述这三个部分,以及后处理的逻辑。
6.1.1 第一部分
这一部分执行冻结处理,并删除指向死元组的索引元组。
首先,PostgreSQL扫描目标表以构建死元组列表,如果可能的话,还会冻结旧元组。该列表存储在本地内存中的maintenance_work_mem里(维护用的工作内存)。冻结处理将在第6.3节中介绍。
扫描完成后,PostgreSQL根据构建得到的死元组列表来删除索引元组。该过程在内部被称为“清除阶段(cleanup stage)”。不用说,该过程代价高昂。在10或更早版本中始终会执行清除阶段。在11或更高版本中,如果目标索引是B树,是否执行清除阶段由配置参数vacuum_cleanup_index_scale_factor决定。详细信息请参考此参数的说明。
当maintenance_work_mem已满,且未完成全部扫描时,PostgreSQL继续进行后续任务,即步骤4到7;完成后再重新返回步骤3并继续扫描。
6.1.2 第二部分
这一部分会移除死元组,并逐页更新FSM和VM。图6.1展示了一个例子:
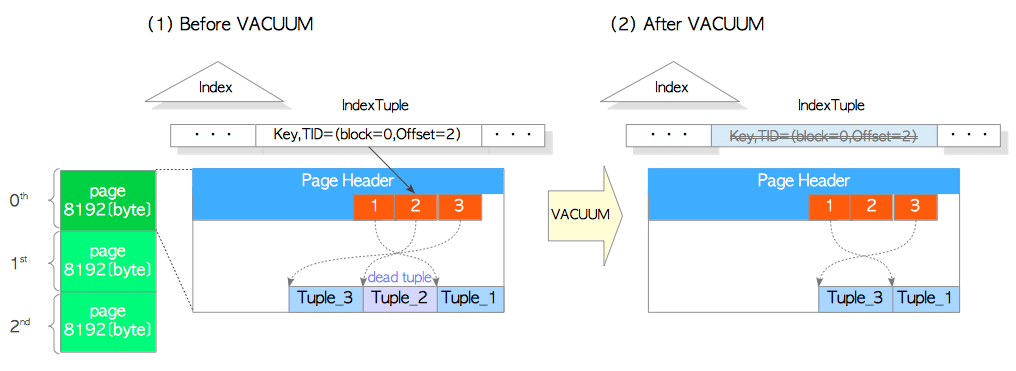
Tuple_2是一条死元组,如图6.1(1)所示。在这里PostgreSQL移除了Tuple_2,并重排剩余元组来整理碎片空间,然后更新该页面的FSM和VM,如图6.1(2)所示。 PostgreSQL不断重复该过程直至最后一页。
请注意,非必需的行指针是不会被移除的,它们会在将来被重用。因为如果移除了行指针,就必须同时更新所有相关索引中的索引元组。
6.1.3 第三部分
第三部分会针对每个表,更新与清理过程相关的统计信息和系统视图。
此外,如果最后一页中没有元组,则该页会从表文件中被截断。
6.1.4 后续处理
当处理完成后,PostgreSQL会更新与清理过程相关的几个统计数据,以及相关的系统视图;如果可能的话,它还会移除部分非必需的clog(第6.4节)。
清理过程使用第8.4.5节中描述的环形缓冲区(ring buffer)。因此处理过的页面不会缓存在共享缓冲区中。
6.2 可见性映射
清理过程的代价高昂,因此PostgreSQL在8.4版中引入了VM,用于减小清理的开销。
VM的基本概念很简单。 每个表都拥有各自的可见性映射,用于保存表文件中每个页面的可见性。 页面的可见性确定了每个页面是否包含死元组。清理过程可以跳过没有死元组的页面。
图6.2展示了VM的使用方式。 假设该表包含三个页面,第0页和第2页包含死元组,而第1页不包含死元组。 表的可见性映射中保存着哪些页面包含死元组的信息。 在这种情况下,清理过程可以参考VM中的信息,跳过第一个页面。
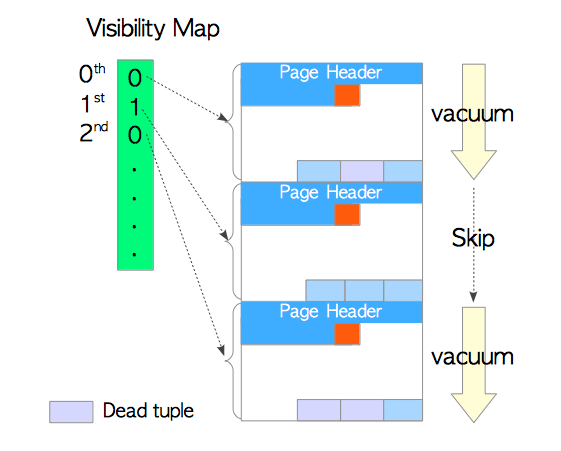
每个VM由一个或多个8 KB页面组成,文件以后缀_vm存储。 例如,一个表文件的relfilenode是18751,其FSM(18751_fsm)和VM(18751_vm)文件如下所示。
6.2.1 可见性映射的改进
可见性映射在9.6版中进行了加强,以提高冻结处理的效率。新的VM除了显示页面可见性之外,还包含了页面中元组是否全部冻结的信息,参见第6.3.3节。
6.3 冻结过程
冻结过程有两种模式,依特定条件而择其一执行。为方便起见,将这两种模式分别称为惰性模式(lazy mode)和迫切模式(eager mode)。
并发清理(Concurrent VACUUM) 通常在内部被称为“惰性清理(lazy vacuum)”。但是,本文中定义的惰性模式是 冻结过程(Freeze Processing) 执行的模式。
冻结过程通常以惰性模式运行;但当满足特定条件时,也会以迫切模式运行。在惰性模式下,冻结处理仅使用目标表对应的VM扫描包含死元组的页面。迫切模式相则反,它会扫描所有的页面,无论其是否包含死元组,它还会更新与冻结处理相关的系统视图,并在可能的情况下删除不必要的clog。
第6.3.1和6.3.2节分别描述了这两种模式;第6.3.3节描述了改进后的迫切模式冻结过程。
6.3.1 惰性模式
当开始冻结处理时,PostgreSQL计算freezeLimit_txid,并冻结t_xmin小于freezeLimit_txid的元组。
freezeLimit_txid定义如下:
而OldestXmin是当前正在运行的事务中最早的事务标识(txid)。 举个例子,如果在执行VACUUM命令时,还有其他三个事务正在运行,且其txid分别为100,101,102,那么这里OldestXmin就是100。如果不存在其他事务,OldestXmin 就是执行此VACUUM命令的事务标识。 这里vacuum_freeze_min_age是一个配置参数(默认值为50,000,000)。
图6.3给出了一个具体的例子。这里Table_1由三个页面组成,每个页面包含三条元组。 执行VACUUM命令时,当前txid为50,002,500且没有其他事务。在这种情况下,OldestXmin就是50,002,500;因此freezeLimit_txid为2500。冻结过程按照如下步骤执行。
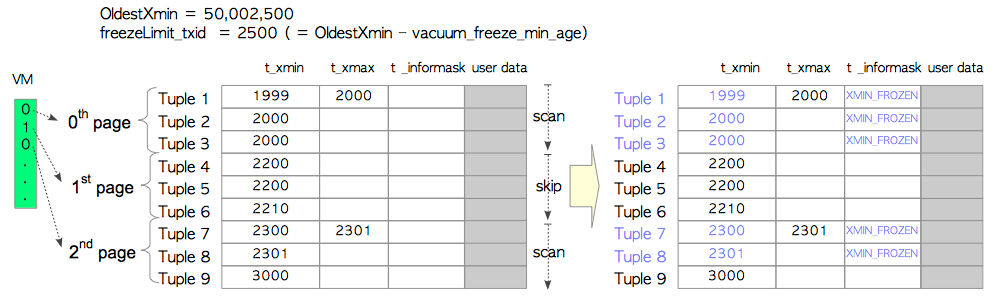
-
第0页:
三条元组被冻结,因为所有元组的
t_xmin值都小于freezeLimit_txid。此外,因为Tuple_1是一条死元组,因而在该清理过程中被移除。 -
第1页:
通过引用可见性映射(从VM中发现该页面所有元组都可见),清理过程跳过了对该页面的清理。
-
第2页:
Tuple_7和Tuple_8被冻结,且Tuple_7被移除。
在完成清理过程之前,与清理相关的统计数据会被更新,例如pg_stat_all_tables视图中的n_live_tup,n_dead_tup,last_vacuum,vacuum_count等字段。
如上例所示,因为惰性模式可能会跳过页面,它可能无法冻结所有需要冻结的元组。
6.3.2 迫切模式
迫切模式弥补了惰性模式的缺陷。它会扫描所有页面,检查表中的所有元组,更新相关的系统视图,并在可能时删除非必需的clog文件与页面。
当满足以下条件时,会执行迫切模式。
在上面的条件中,pg_database.datfrozenxid是系统视图pg_database中的列,并保存着每个数据库中最老的已冻结的事务标识。细节将在后面描述;因此这里我们假设所有pg_database.datfrozenxid的值都是1821(这是在9.5版本中安装新数据库集群之后的初始值)。 vacuum_freeze_table_age是配置参数(默认为150,000,000)。
图6.4给出了一个具体的例子。在表1中,Tuple_1和Tuple_7都已经被删除。Tuple_10和Tuple_11则已经插入第2页中。执行VACUUM命令时的事务标识为150,002,000,且没有其他事务。因此,OldestXmin=150,002,000,freezeLimit_txid=100,002,000。在这种情况下满足了上述条件:因为1821 < (150002000 - 150000000),因而冻结过程会以迫切模式执行,如下所示。
(注意,这里是版本9.5或更早版本的行为;最新版本的行为将在第6.3.3节中描述。)
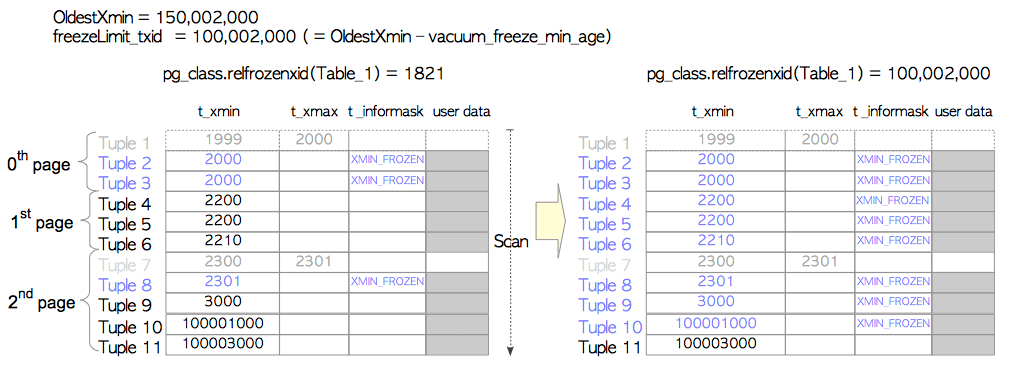
-
第0页:
即使所有元组都被冻结,也会检查
Tuple_2和Tuple_3。 -
第1页:
此页面中的三条元组都会被冻结,因为所有元组的
t_xmin值都小于freezeLimit_txid。注意在惰性模式下会跳过此页面。 -
第2页:
将
Tuple_10冻结,而Tuple_11没有冻结。
冻结一张表后,目标表的pg_class.relfrozenxid将被更新。 pg_class是一个系统视图,每个pg_class.relfrozenxid列都保存着相应表的最近冻结的事务标识。本例中表1的pg_class.relfrozenxid会被更新为当前的freezeLimit_txid(即100,002,000),这意味着表1中t_xmin小于100,002,000的所有元组都已被冻结。
在完成清理过程之前,必要时会更新pg_database.datfrozenxid。每个pg_database.datfrozenxid列都包含相应数据库中的最小pg_class.relfrozenxid。例如,如果在迫切模式下仅仅对表1做冻结处理,则不会更新该数据库的pg_database.datfrozenxid,因为其他关系的pg_class.relfrozenxid(当前数据库可见的其他表和系统视图)还没有发生变化,如图6.5(1)所示。如果当前数据库中的所有关系都以迫切模式冻结,则数据库的pg_database.datfrozenxid就会被更新,因为此数据库的所有关系的pg_class.relfrozenxid都被更新为当前的freezeLimit txid,如图6.5(2)所示。
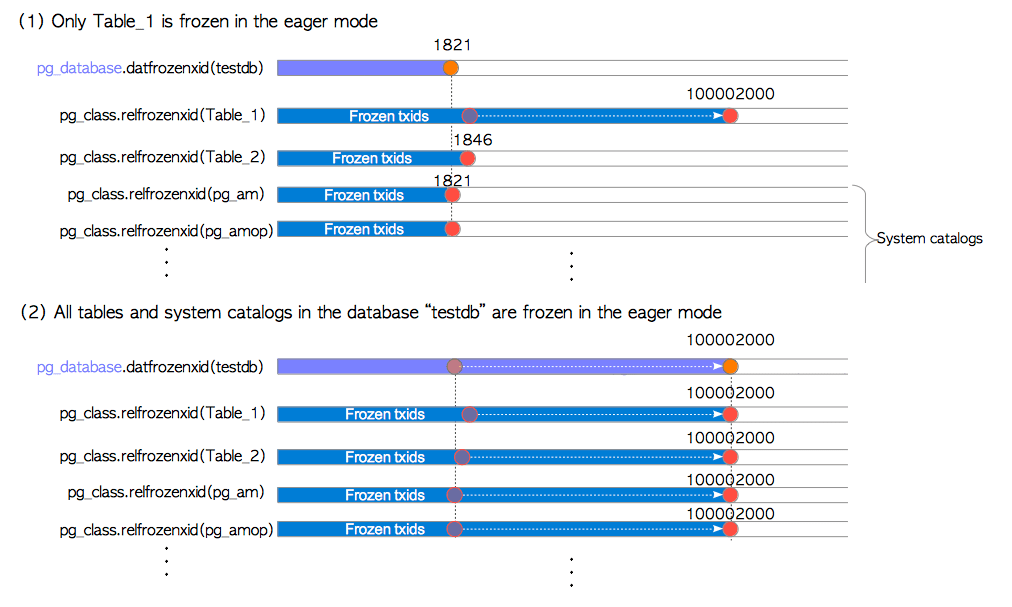
如何显示
pg_class.relfrozenxid与pg_database.datfrozenxid如下所示,第一个查询显示
testdb数据库中所有可见关系的relfrozenxid,第二个查询显示testdb数据库的pg_database.datfrozenxld。
FREEZE选项带有
FREEZE选项的VACUUM命令会强制冻结指定表中的所有事务标识。虽然这是在迫切模式下执行的,但这里freezeLimit会被设置为OldestXmin(而不是OldestXmin - vacuum_freeze_min_age)。 例如当txid=5000的事务执行VACUUM FULL命令,且没有其他正在运行的事务时,OldesXmin会被设置为5000,而t_xmin小于5000的元组将会被冻结。
6.3.3 改进迫切模式中的冻结过程
9.5或更早版本中的迫切模式效率不高,因为它始终会扫描所有页面。 比如在第6.3.2节的例子中,尽管第0页中所有元组都被冻结,但也会被扫描。
为了解决这一问题,9.6版本改进了可见性映射VM与冻结过程。如第6.2.1节所述,新VM包含着每个页面中所有元组是否都已被冻结的信息。在迫切模式下进行冻结处理时,可以跳过仅包含冻结元组的页面。
图6.6给出了一个例子。 根据VM中的信息,冻结此表时会跳过第0页。在更新完1号页面后,相关的VM信息会被更新,因为该页中所有的元组都已经被冻结了。
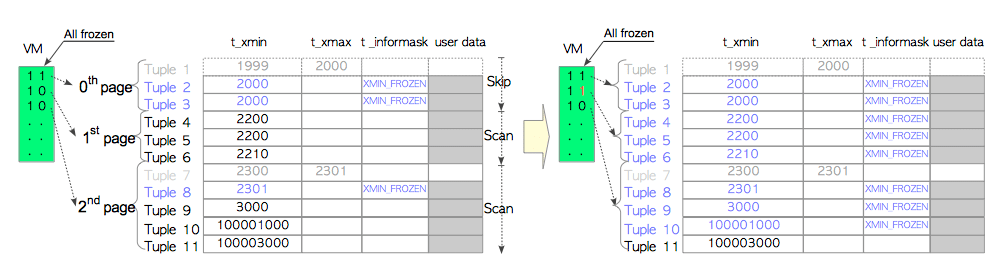
6.4 移除不必要的提交日志文件
如5.4节中所述,提交日志(clog) 存储着事务的状态。 当更新pg_database.datfrozenxid时,PostgreSQL会尝试删除不必要的clog文件。 注意相应的clog页面也会被删除。
图6.7给出了一个例子。 如果clog文件0002中包含最小的pg_database.datfrozenxid,则可以删除旧文件(0000和0001),因为存储在这些文件中的所有事务在整个数据库集簇中已经被视为冻结了。
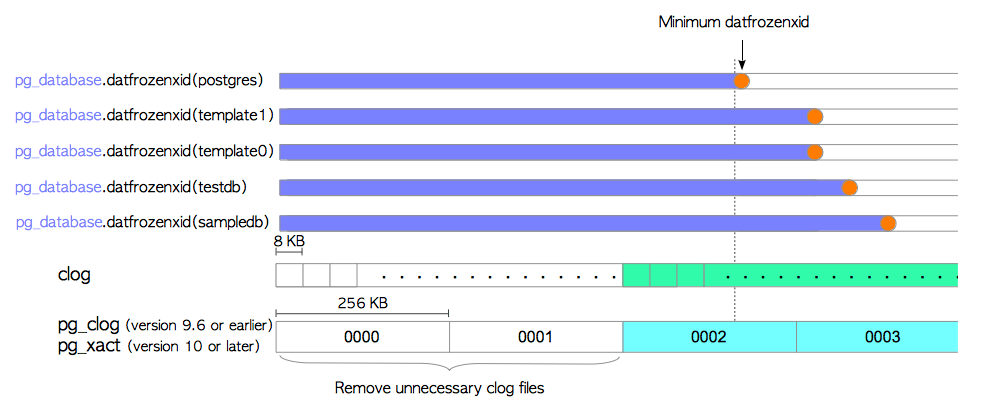
pg_database.datfrozenxid与clog文件下面展示了
pg_database.datfrozenxid与clog文件的实际输出
6.5 自动清理守护进程
**自动清理(AutoVacuum)**守护进程已经将清理过程自动化,因此PostgreSQL运维起来非常简单。
自动清理守护程序周期性地唤起几个autovacuum_worker进程,默认情况下会每分钟唤醒一次(由参数autovacuum_naptime定义),最多并发运行三个工作进程(由autovacuum_max_workers定义)。
自动清理守护进程唤起的autovacuum工作进程会依次对各个表执行并发清理,从而将对数据库活动的影响降至最低。
6.5.1 自动清理的触发条件
目标表满足以下任一条件时会触发自动清理或自动分析。
6.5.1.1 防止事务ID回卷
当前txid超过以下阈值时,对目标表执行冻结:
relfrozenxid来自pg_class,autovacuum_freeze_max_age默认2亿。
6.5.1.2 死元组数量
死元组数超过以下阈值时执行VACUUM:
默认阈值为50、比例因子为0.2。例如一张包含10000个元组的表有2100个死元组时,,因此触发清理。
6.5.1.3 插入元组数量(PostgreSQL 13及以后)
插入数量超过以下阈值时也会触发VACUUM:
默认插入阈值为1000,比例因子为0.2。
6.5.1.4 自动分析
自上次ANALYZE以来修改的元组数满足下式时执行自动分析:
$$ \text{mod_since_analyze}
\text{autovacuum_analyze_threshold} +\text{autovacuum_analyze_scale_factor}\times\text{reltuples} $$
默认阈值为50,比例因子为0.1。内部函数relation_needs_vacanalyze()负责判断目标表是否需要清理或分析。
6.5.2 维护建议
默认autovacuum_vacuum_scale_factor=0.2对大表往往过高:1000行、10万行和1亿行的表分别要积累约250、20050和20000050个死元组才会触发。表越大,清理越不频繁,越容易膨胀。
可以按表降低比例因子:
若希望触发条件与表总行数无关,例如固定在50000个死元组,可设:
6.6 回收表膨胀空间
6.6.1 REPACK(VACUUM FULL)
虽然并发清理对于运维至关重要,但光有它还不够。比如,即使删除了许多死元组,也无法压缩表大小的情况。
图6.8给出了一个极端的例子。假设一个表由三个页面组成,每个页面包含六条元组。执行以下DELETE命令以删除元组,并执行VACUUM命令以移除死元组:
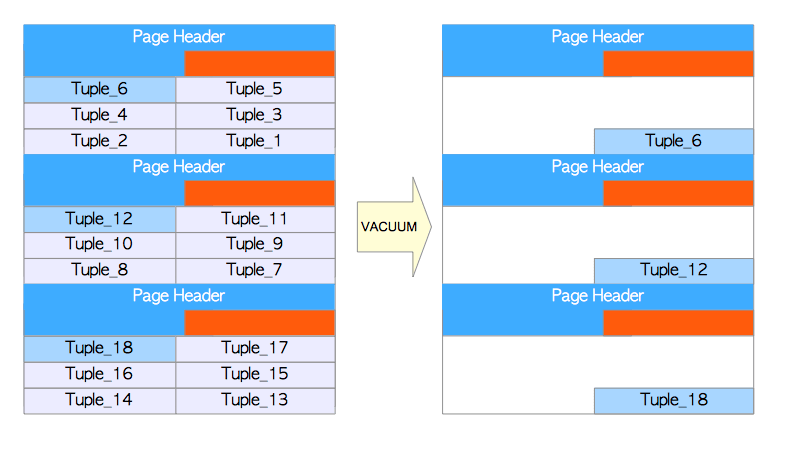
死元组虽然都被移除了,但表的尺寸没有减小。 这种情况既浪费了磁盘空间,又会对数据库性能产生负面影响。 例如在上面的例子中,当读取表中的三条元组时,必须从磁盘加载三个页面。
为了解决这种情况,PostgreSQL提供了完整清理模式。 图6.9概述了该模式。
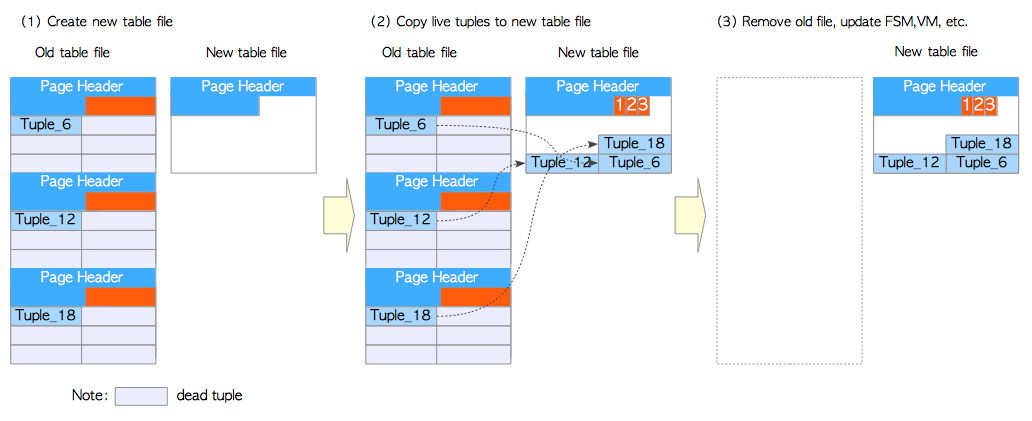
-
创建新的表文件:见图6.9(1)
当对表执行
VACUUM FULL命令时,PostgreSQL首先获取表上的AccessExclusiveLock锁,并创建一个大小为8 KB的新的表文件。AccessExclusiveLock锁不允许任何其他访问。 -
将活元组复制到新表:见图6.9(2)
PostgreSQL只将旧表文件中的活元组复制到新表中。
-
删除旧文件,重建索引,并更新统计信息,FSM和VM,见图6.9(3)
复制完所有活元组后,PostgreSQL将删除旧文件,重建所有相关的表索引,更新表的FSM和VM,并更新相关的统计信息和系统视图。
完整清理的伪代码如下所示:
伪代码:完整清理
使用VACUUM FULL命令时,应当考虑两点。
- 当执行完整清理时,没有人可以访问(读/写)表。
- 最多会临时使用两倍于表的磁盘空间;因此在处理大表时,有必要检查剩余磁盘容量。
什么时候该使用
VACUUM FULL?不幸的是,并没有关于什么时候该执行
VACUUM FULL的最佳实践。但是扩展pg_freespacemap可能会给出很好的建议。以下查询给出了表的平均空间空闲率。
从上面的结果可以看出,没有多少空闲空间。
如果删除几乎所有的元组,并执行
VACUUM命令,则可以发现每个页面几乎都是空的。以下查询检查特定表中每个页面的自由空间占比。
执行
VACUUM FULL后会发现表被压实了。
6.6.2 REPACK CONCURRENTLY
PostgreSQL 19开发版引入内置REPACK命令(不是pg_repack扩展),并让VACUUM FULL与CLUSTER使用同一底层实现。CONCURRENTLY选项只在最终文件切换时短暂获取AccessExclusiveLock,因此能以更高在线性重建表。
| 版本 | 全程持有AccessExclusiveLock |
大部分时间在线 |
|---|---|---|
| PostgreSQL 18及以前 | VACUUM FULL、CLUSTER |
无 |
| PostgreSQL 19及以后 | REPACK、REPACK ... USING INDEX |
REPACK (CONCURRENTLY) ...、REPACK (CONCURRENTLY) ... USING INDEX |
并发模式仍会创建新表并复制旧表中的活元组,但还会取得MVCC快照、使用WAL解码捕获复制期间的修改,并由repack_decoding_worker把目标表变更写入临时BufFile,再由REPACK后端应用到新表。
该机制要求wal_level至少为replica,目标表必须配置DEFAULT或USING INDEX副本标识。分区表、UNLOGGED表、TOAST表、没有适用副本标识的表和系统目录不能使用CONCURRENTLY;该选项也不能在事务块中执行,并且max_repack_replication_slots必须允许创建额外复制槽。
注意: PostgreSQL 19文档明确指出
REPACK (CONCURRENTLY)并非MVCC安全。实际使用前应阅读REPACK官方文档中的限制与资源需求。
6.6.2.1 捕获并应用并发变更
假设目标表tbl以主键tbl_pkey作为副本标识。图6.12展示了简化为两个阶段的过程。
阶段一:复制元组
- 执行
REPACK的backend_1启动repack_decoding_worker。 - worker开启事务并与
backend_1共享精确快照。 backend_1创建新表文件。- 并发
backend_2向旧表插入Tuple_B并生成相应WAL。 backend_1按快照复制Tuple_A等活元组;Tuple_B对该快照不可见,因而不会直接复制。
阶段二:应用变更
- 为新表建立全部索引,并调用
XLogFlush()确保阶段一WAL持久化。 repack_decoding_worker解码WAL,把INSERT Tuple_B写入BufFile。backend_1读取BufFile并通过正常插入路径把Tuple_B应用到新表,相关索引自动更新。
6.6.2.2 实际的三个阶段
真实实现分两次应用并发变更,以缩短最终AccessExclusiveLock阻塞时间。
- 复制元组: 按快照复制活元组。REPACK后端在旧表上持有
ShareUpdateExclusiveLock,在新表上持有AccessExclusiveLock。 - 应用阶段一变更: 把复制期间的修改应用到新表;其他后端仍可继续更新旧表。
- 应用阶段二变更并切换: 在旧表上取得
AccessExclusiveLock,阻止新修改;应用最后一批变更,终止解码worker,交换新旧表与索引文件,删除旧文件并更新FSM、VM和统计信息。
并发变更在第二、第三阶段应用时可能在新表中生成新的死元组,因此REPACK CONCURRENTLY不像非并发REPACK那样保证结果完全没有死元组。
7 堆内元组与仅索引扫描
本章中介绍两个和索引扫描有关的特性—— 堆内元组(heap only tuple, HOT)和仅索引扫描(index-only scan) 。
7.1 堆内元组(HOT)
在8.3版本中实现的HOT特性,使得更新行的时候,可以将新行放置在老行所处的同一个数据页中,从而高效地利用索引与表的数据页;HOT特性减少了不必要的清理过程。
在源码的README.HOT中有关于HOT的详细介绍,本章只是简短的介绍HOT。首先,7.1.1节描述了在没有HOT特性的时候,更新一行是怎样一个过程,以阐明要解决的问题。接下来,在7.1.2中将介绍HOT做了什么。
7.1.1 没有HOT时的行更新
假设表tbl有两个列:id和data;id是tbl的主键。
表tbl有1000条元组;最后一个元组的id是1000,存储在第五个数据页中。最后一条元组被相应的索引元组所引用,索引元组的key是1000,且tid是(5,1),如图7.1(a)所示。
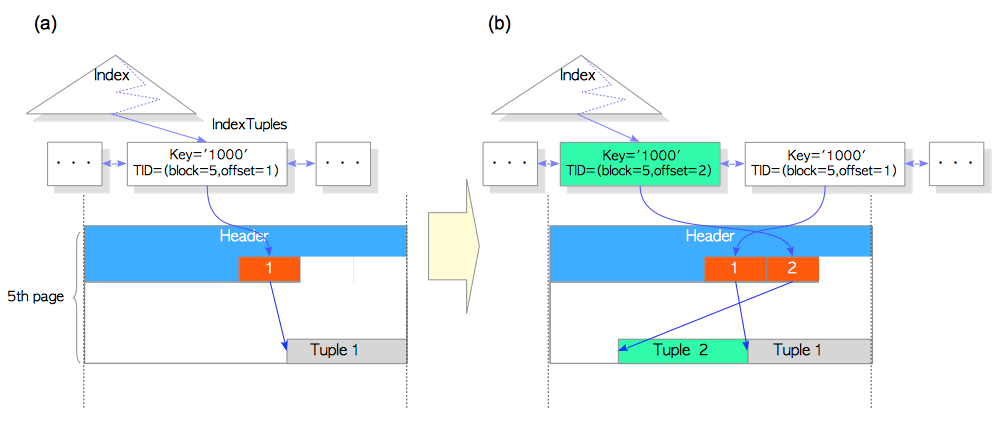
我们考虑一下,没有HOT特性时,最后一个元组是如何更新的。
在该场景中,PostgreSQL不仅要插入一条新的表元组,还需要在索引页中插入新的索引元组,如图7.1(b)所示。索引元组的插入消耗了索引页的空间,而且索引元组的插入和清理都是开销很大的操作。HOT的目的,就是降低这种影响。
7.1.2 HOT如何工作
当使用HOT特性更新行时,如果被更新的元组存储在老元组所在的页面中,PostgreSQL就不会再插入相应的索引元组,而是分别设置新元组的HEAP_ONLY_TUPLE标记位与老元组的HEAP_HOT_UPDATED标记位,两个标记位都保存在元组的t_informask2字段中。如图7.2和图7.3所示。
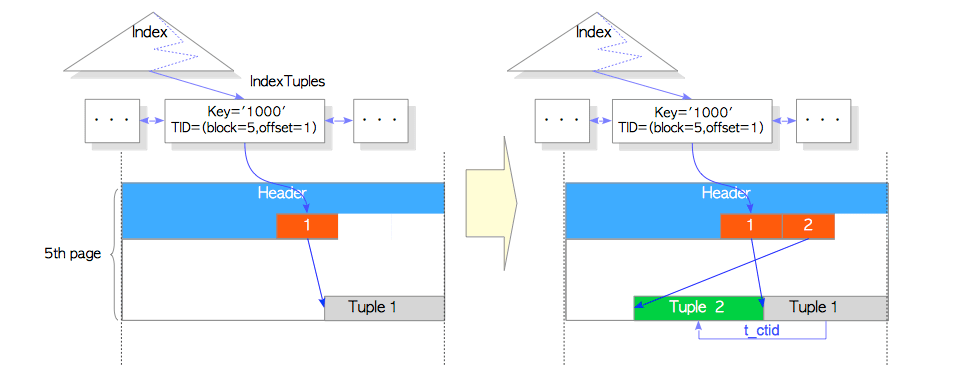
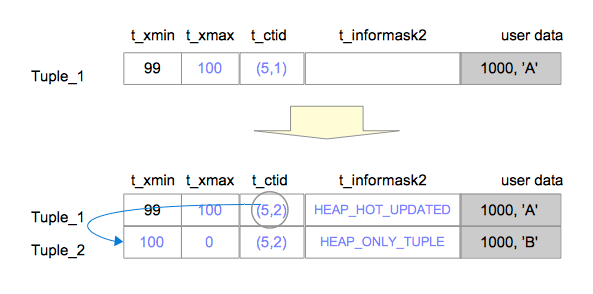
比如在这个例子中,Tuple_1和Tuple_2分别被设置成HEAP_HOT_UPDATED和HEAP_ONLY_TUPLE。
另外,在 修剪(pruning) 和 碎片整理(defragmentation) 处理过程中,都会使用下面介绍的HEAP_HOT_UPDATED和HEAP_ONLY_TUPLE标记位。
接下来会介绍,当基于HOT更新一个元组后,PostgreSQL是如何在索引扫描中访问这些被HOT更新的元组的,如图7.4(a)所示。
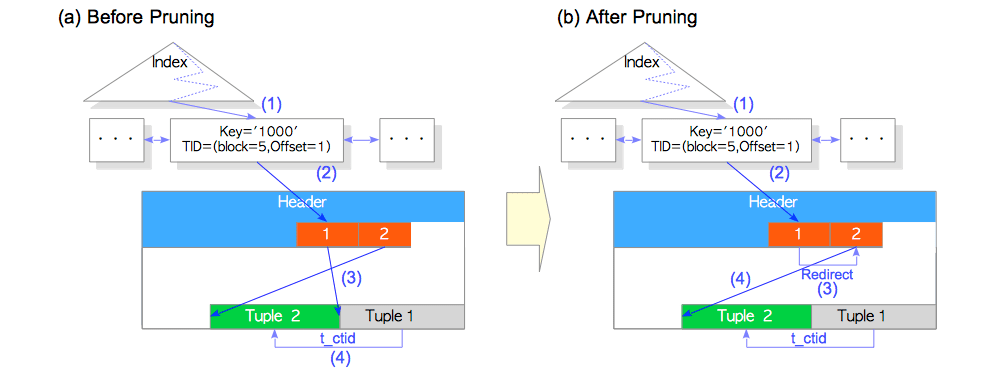
- 找到指向目标数据元组的索引元组
- 按所获索引元组指向的位置访问行指针数组,找到行指针
1 - 读取
Tuple_1 - 经由
Tuple_1的t_ctid字段,读取Tuple_2。
在这种情况下,PostgreSQL会读取两条元组,Tuple_1和Tuple_2,并通过第5章所述的并发控制机制来判断哪条元组是可见的;但如果数据页中的 死元组(dead tuple) 已经被清理了,那就有问题了。比如在图7.4(a)中,如果Tuple_1由于是死元组而被清理了,就无法通过索引访问Tuple_2了。
为了解决这个问题,PostgreSQL会在合适的时候进行行指针重定向:将指向老元组的行指针重新指向新元组的行指针。在PostgreSQL中,这个过程称为修剪(pruning)。图7.4(b)说明了PostgreSQL在修剪之后如何访问更新的元组。
- 找到索引元组
- 通过索引元组,找到行指针
[1] - 通过重定向的行指针
[1],找到行指针[2]; - 通过行指针
[2],读取Tuple_2
可能的话,剪枝任何时候都有可能会发生,比如 SELECT ,UPDATE, INSERT ,DELETE这类SQL命令执行的时候,确切的执行时机不会在本章中描述,因为它太复杂了。细节可以在README.HOT文件中找到。
在PostgreSQL执行剪枝时,如果可能,会挑选合适的时机来清理死元组。在PostgreSQL中这种操作称为碎片整理(defragmentation),图7.5中描述了HOT中的碎片整理过程。
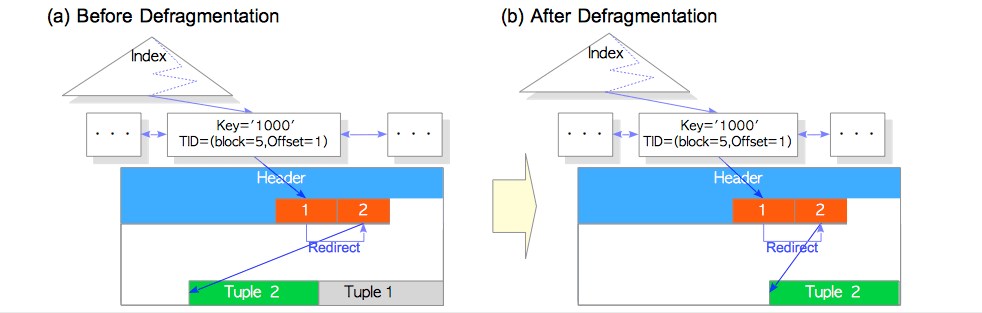
需要注意的是,因为碎片整理的工作并不涉及到索引元组的移除,因此碎片整理比起常规的清理开销要小得多。
因此,HOT特性降低了索引和表的空间消耗,同样减少了清理过程需要处理的元组数量。由于减少了更新操作需要插入的索引元组数量,并减小了清理操作需要处理的元组数量,HOT对于性能提高有良好的促进作用。
HOT不可用的场景
为了清晰地理解HOT的工作,这里介绍一些HOT不可用的场景。
- 当更新的元组在其他的页面时,即和老元组在不在同一个数据页中时,指向该元组的索引元组也会被添加至索引页中,如图7.6(a)所示。
- 当索引的键更新时,会在索引页中插入一条新的索引元组,如图7.6(b)所示。
图7.6 HOT不适用的情况
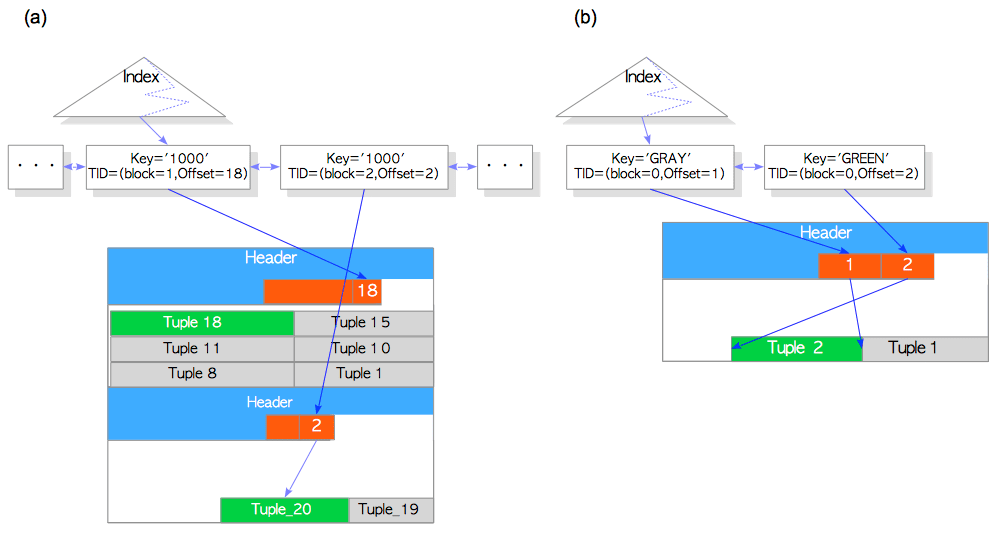
pg_stat_all_tables视图提供了每个表的统计信息视图,也可以参考这个扩展。
7.2 仅索引扫描
当SELECT语句的所有的目标列都在索引键中时,为了减少I/O代价,仅索引扫描(Index-Only Scan)(又叫仅索引访问)会直接使用索引中的键值。所有商业关系型数据库中都提供这个技术,比如DB2和Oracle。PostgreSQL在9.2版本中引入这个特性。
接下来我们会基于一个特殊的例子,介绍PostgreSQL中仅索引扫描的工作过程。
首先是关于这个例子的假设:
-
表定义
我们有一个
tbl表,其定义如下所示: -
索引
表
tbl有一个索引tbl_idx,包含两列:id和name。 -
元组
tbl已经插入了一些元组。id=18, name = 'Queen'的Tuple_18存储在0号数据页中。id=19, name='BOSTON'的Tuple_19存储在1号数据页中。 -
可见性
所有在0号页面中的元组永远可见;1号页面中的元组并不总是可见的。注意每个页的可见性信息都存储在相应的 可见性映射(visibility map) 中,关于可见性映射的描述可以参考第6.2节。
我们来研究一下,当下面的SELECT语句执行时,PostgreSQL是如何读取元组的。
查询需要从表中读取两列:id和name,然而索引tbl_idx包含了这些列。因此在使用索引扫描时,第一眼看上去好像访问表的页面是没有必要的,因为索引中已经包含了必要的数据。然而原则上,PostgreSQL有必要需要检查这些元组的可见性,然而索引元组中并没有任何关于堆元组的事务相关信息,比如t_xmin和t_xmax,详细参考第5章。因此,PostgreSQL需要访问表数据来检查索引元组中数据的可见性,这就有点本末倒置了。
面对这种困境,PostgreSQL使用目标数据表对应的可见性映射表来解决此问题。如果某一页中存储所有的元组都是可见的,PostgreSQL就会使用索引元组,而不去访问索引元组指向的数据页去检查可见性;否则,PostgreSQL读取索引元组指向的数据元组并检查元组可见性,而这个就跟原来设想的一样。
在这个例子中,因为的0号页面被标记为可见,因此0号页面中存储的包括Tuple_18在内的所有元组都是可见的,所以就无需再去访问Tuple_18了。相应的,因为1号页面并没有被标记为可见,此时为了检查并发控制的可见性,需要访问Tuple_19。
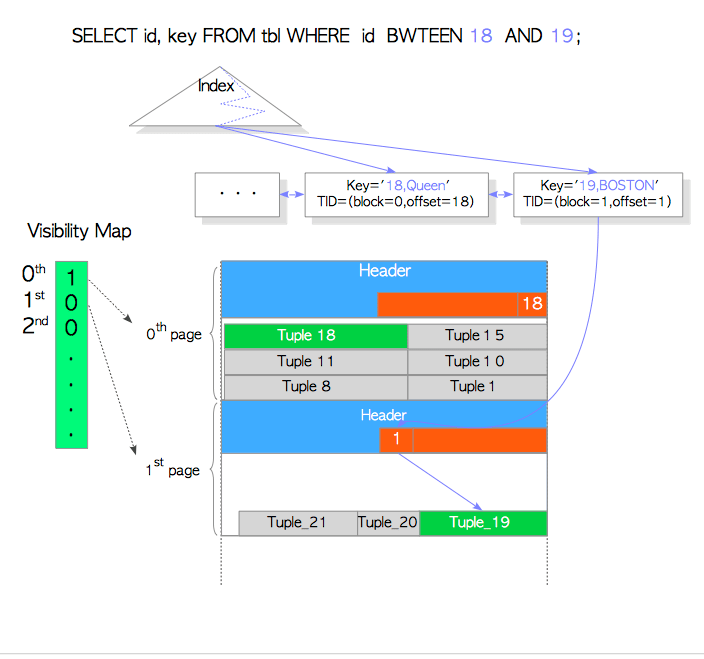
7.3 README.HOT
这是PostgreSQL官方文档中关于HOT的介绍。
堆内元组(HOT)
堆内元组(HOT)功能消除了冗余索引条目,并允许在不进行表级清理的前提下,重用被删除或被更新的元组空间。这是通过单页清理 实现的,也称为碎片整理(defragmentation)。
注意:本文档末尾有一个词汇表,对于新读者可能会有所帮助。
技术挑战
一次一页的清理通常是不切实际的,因为找到并移除链接到待回收元组的索引项开销很大。标准清理会完整扫描索引,并确保所有这些索引项都被移除。但是将索引扫描的开销分摊到许多死元组上是可能的;这种方法向下扩展的并不好,比如只是回收几个元组。原则上,这样的问题只需要重新计算索引键,并进行标准的索引搜索找出这些索引项。但因为函数索引的存在,可能会有各种充满Bug的用户定义函数被用于函数索引,这样做会有风险。声称IMMUTABLE但实际上可变的函数会妨碍我们重新找到索引项(而且我们没法仅仅因为没找到索引项就报错,特别是当死掉的索引项有时候会提前回收)。这些问题可能会导致很严重的索引损坏问题,例如以这样一种形式:索引项指向了一些包含无关内容的元组槽。在任何情况下,我们都更倾向于在不调用任何用户编写的代码的情况下来进行清理。
HOT针对一种受限但很实用的场景解决了这一问题:当一条元组以不改变其索引键的方式被重复更新(这里,“索引列(index column)” 意味着在索引定义中引用的任何列,包括部分索引中用于条件测试但并未实际存储的列)。
HOT的另一个特性是它减小了索引的尺寸,通过避免创建键相等的索引项。这能提高搜索速度。
单个索引项的更新链
在没有HOT的情况下,在更新链条上行的每一个版本都有它们各自的索引项,尽管这些索引项中的索引列值都是相同的。在有HOT的情况下,如果一个元组被放置在与其旧元组相同的页面中,且与旧元组在索引列上值相同,那么新的元组不会产生新的索引项。这意味着在这个堆页面上的一整条更新链,只会有且仅有一条索引项。没有相应索引项的元组会被标记为HEAP_ONLY_TUPLE,而先前的行版本则会被标记为HEAP_HOT_UPDATED,而在一条更新链中,它们的t_ctid字段都会继续指向更新的版本。
举个例子:
在上面这幅图中,索引指向了行指针1,而元组1被标记为HEAP_HOT_UPDATED。元组2是一个HOT元组,带有HEAP_ONLY_TUPLE,意味着没有索引项指向它。尽管元组2没有被索引直接引用,它仍然能够通过索引搜索被找到。当从索引遍历至元组1时,索引搜索会继续跟进其子元组,只要它看到HEAP_HOT_UPDATED就会尽可能远地持续前进。因为我们将HOT链限制在单个页面内,这样的操作不会导致额外的页面访问,因此也不会引入很多性能损失。
最后元组1不再对任何事务可见,在那个时候,它就应该被清理掉了。但是它的行指针无法被清理掉,因为索引项仍然指向该行指针,而元组2仍然需要通过索引被搜索到。HOT通过将行指针1变为一个“重定向行指针”来解决这个问题,该指针没有实际的元组与之关联,而会链接至元组2。这时候看上去应该是这样的:
如果现在这一行又被更新了,到了版本3,页面看上去就会是这样的。
当没有事务能在其快照中看见元组2时,元组2和它的行指针可以被整个剪枝掉:
这是安全的,因为没有指向行指针2的索引项。在该页面中,后续的插入可以回收利用行指针2和原来元组2占用的空间。
如果更新修改了被索引的列,或者同一页中没有空间能放下这个新元组,那么这条更新链就会结束:最后一个成员会有一个通常的t_ctid,指向下一个版本的位置,而且不会被标记为HEAP_HOT_UPDATED。(原则上讲我们是能够跨越页面继续这条HOT链的,但是这会打破我们所期望的性质:能够使用页面本地的操作回收空间。无论如何,我们都不想追着越过好几个堆页面,只是为了拿到一个索引项对应的元组,在那种情况下为新的元组创建一个新的索引项看上去会是一个更好的选择)如果后续的更新继续出现,下一个版本会成为一条新更新链的根。
只要当前页面中更新链还有任何活着的元组,行指针1就始终需要保留。当没有的时候,就可以将其标记为“死掉”,这就允许我们立即回收最后一个子节点的行指针与元组空间。下一次常规的VACUUM扫描会回收该索引项,以及索引项指向的这些行指针本身。因为比起元组而言行指针很小,这并不会出现过度的空间浪费。
注意:我们我们可以用“死掉”的行指针指向任何被删除的元组,无论它是不是HOT链中的元组。这允许我们像HOT更新一样在VACUUM之前,对普通的DELETE也可以进行空间回收。
进行HOT更新的必要条件是被索引的列上没有发生变化,这是在运行时检查旧值与新值的二进制表示来实现的。我们坚持位级别的相等,而不是特定于数据类型的等值比较方法。这样做的原因是后者可能会产生等价的多种表现形式。而我们并不知道索引用的是哪一种。我们假设位级别的相等保证对于所有目的的相等性都是适用的。
中止的情形
索引扫描与顺序扫描
剪枝
碎片整理
什么时候使用剪枝或碎片整理
清理
统计
创建索引
并行创建索引
并行移除索引
局限性
词汇表
8 缓冲区管理器
缓冲区管理器(Buffer Manager) 管理着共享内存和持久存储之间的数据传输,对于DBMS的性能有着重要的影响。PostgreSQL的缓冲区管理器十分高效。
本章介绍了PostgreSQL的缓冲区管理器。第一节概览了缓冲区管理器,后续的章节分别介绍以下内容:
-
缓冲区管理器的结构
-
缓冲区管理器的锁
-
缓冲区管理器是如何工作的
-
环形缓冲区
-
PostgreSQL异步I/O
-
脏页刷写
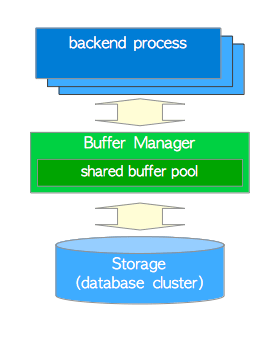
8.1 概览
本节介绍了一些关键概念,有助于理解后续章节。
8.1.1 缓冲区管理器的结构
PostgreSQL缓冲区管理器由缓冲表,缓冲区描述符和缓冲池组成,这几个组件将在接下来的小节中介绍。
**缓冲池(buffer pool)**层存储着数据文件页面,诸如表页与索引页,及其相应的自由空间映射和可见性映射页面。
缓冲池是一个数组,每个槽中存储数据文件的一页。缓冲池数组的序号索引称为 buffer_id。8.2 和 8.3 节描述了缓冲区管理器的内部细节。
8.1.2 缓冲区标签(buffer_tag)
PostgreSQL中的每个数据文件页面都可以分配到唯一的标签,即 缓冲区标签(buffer tag)。 当缓冲区管理器收到请求时,PostgreSQL 会用到目标页面的缓冲区标签。
缓冲区标签(buffer_tag) 由三个值组成:关系文件节点(relfilenode),关系分支编号(fork number),页面块号(block number)。例如,缓冲区标签{(16821, 16384, 37721), 0, 7}表示,在oid=16821的表空间中的oid=16384的数据库中的oid=37721的表的0号分支(关系本体)的第七号页面。再比如缓冲区标签{(16821, 16384, 37721), 1, 3}表示该表空闲空间映射文件的三号页面。(关系本体main分支编号为0,空闲空间映射fsm分支编号为1)
8.1.3 后端进程如何读取数据页
本小节描述了后端进程如何从缓冲区管理器中读取页面,如图8.2所示。
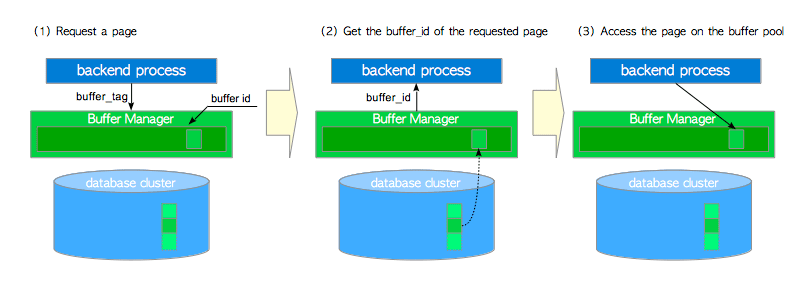
- 当读取表或索引页时,后端进程向缓冲区管理器发送请求,请求中带有目标页面的
buffer_tag。 - 缓冲区管理器会根据
buffer_tag返回一个buffer_id,即目标页面存储在数组中的槽位的序号。如果请求的页面没有存储在缓冲池中,那么缓冲区管理器会将页面从持久存储中加载到其中一个缓冲池槽位中,然后再返回该槽位的buffer_id。 - 后端进程访问
buffer_id对应的槽位(以读取所需的页面)。
当后端进程修改缓冲池中的页面时(例如向页面插入元组),这种尚未刷新到持久存储,但已被修改的页面被称为脏页(dirty page)。
第8.4节描述了缓冲区管理器的工作原理。
8.1.4 页面置换算法
当所有缓冲池槽位都被占用,且其中未包含所请求的页面时,缓冲区管理器必须在缓冲池中选择一个页面逐出,用于放置被请求的页面。 在计算机科学领域中,选择页面的算法通常被称为页面置换算法(page replacement algorithms),而所选择的页面被称为受害者页面(victim page)。
针对页面置换算法的研究从计算机科学出现以来就一直在进行,因此先前已经提出过很多置换算法了。 从8.1版本开始,PostgreSQL使用 时钟扫描(clock-sweep) 算法,因为比起以前版本中使用的LRU算法,它更为简单高效。
第8.4.4节描述了时钟扫描的细节。
8.1.5 刷写脏页
脏页最终应该被刷入存储,但缓冲区管理器执行这个任务需要额外帮助。 在PostgreSQL中,两个后台进程:检查点进程(checkpointer) 和 后台写入器(background writer) 负责此任务。
8.6 节描述了检查点进程和后台写入器。
直接I/O(Direct I/O)
PostgreSQL并不支持直接I/O,但有时会讨论它。 如果你想了解更多详细信息,可以参考这篇文章,以及pgsql-ML中的这个讨论。
8.2 缓冲区管理器的结构
PostgreSQL缓冲区管理器由三层组成,即缓冲表层,缓冲区描述符层和缓冲池层(图8.3):
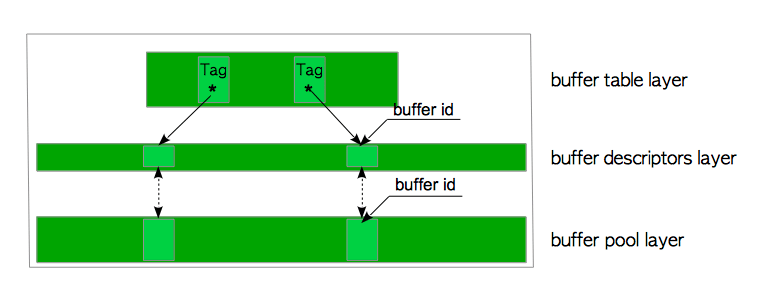
- 缓冲池(buffer pool) 层是一个数组。 每个槽都存储一个数据文件页,数组槽的索引称为
buffer_id。 - 缓冲区描述符(buffer descriptors) 层是一个由缓冲区描述符组成的数组。 每个描述符与缓冲池槽一一对应,并保存着相应槽的元数据。请注意,术语“缓冲区描述符层”只是在本章中为方便起见使用的术语。
- 缓冲表(buffer table) 层是一个哈希表,它存储着页面的
buffer_tag与描述符的buffer_id之间的映射关系。
这些层将在以下的节中详细描述。
8.2.1 缓冲表
缓冲表可以在逻辑上分为三个部分:散列函数,散列桶槽,以及数据项(图8.4)。
内置散列函数将buffer_tag映射到哈希桶槽。 即使散列桶槽的数量比缓冲池槽的数量要多,冲突仍然可能会发生。因此缓冲表采用了 使用链表的分离链接方法(separate chaining with linked lists) 来解决冲突。
当数据项被映射到至同一个桶槽时,该方法会将这些数据项保存在一个链表中,如图8.4所示。
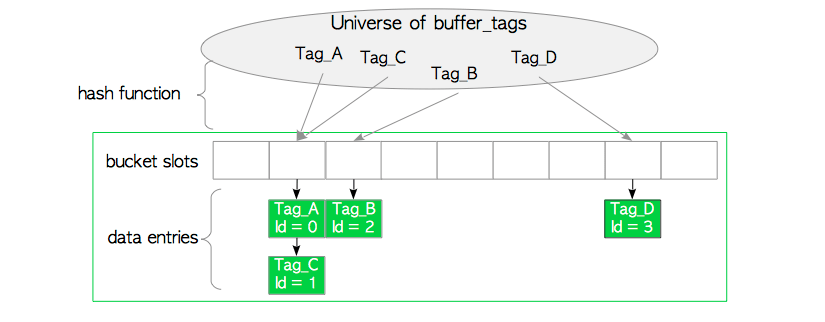
数据项包括两个值:页面的buffer_tag,以及包含页面元数据的描述符的buffer_id。例如数据项Tag_A,id=1 表示,buffer_id=1对应的缓冲区描述符中,存储着页面Tag_A的元数据。
散列函数
这里使用的散列函数是由
calc_bucket()与hash()组合而成。 下面是用伪函数表示的形式。
这里还没有对诸如查找、插入、删除数据项的基本操作进行解释。这些常见的操作将在后续小节详细描述。
8.2.2 缓冲区描述符
本节将描述缓冲区描述符的结构,下一小节将描述缓冲区描述符层。
缓冲区描述符保存着页面的元数据,这些与缓冲区描述符相对应的页面保存在缓冲池槽中。缓冲区描述符的结构由BufferDesc结构定义。这个结构有很多字段,主要字段如下所示:
-
tag保存着目标页面的buffer_tag,该页面存储在相应的缓冲池槽中(缓冲区标签的定义在8.1.2节给出)。 -
buffer_id标识了缓冲区描述符(亦相当于对应缓冲池槽的buffer_id)。 -
refcount保存当前访问相应页面的PostgreSQL进程数,也被称为钉数(pin count)。当PostgreSQL进程访问相应页面时,其引用计数必须自增1(refcount ++)。访问结束后其引用计数必须减1(refcount--)。 当refcount为零,即页面当前并未被访问时,页面将取钉(unpinned) ,否则它会被钉住(pinned)。 -
usage_count保存着相应页面加载至相应缓冲池槽后的访问次数。usage_count会在页面置换算法中被用到(第8.4.4节)。 -
context_lock和io_in_progress_lock是轻量级锁,用于控制对相关页面的访问。第8.3.2节将介绍这些字段。 -
flags用于保存相应页面的状态,主要状态如下:- 脏位(
dirty bit) 指明相应页面是否为脏页。 - 有效位(
valid bit) 指明相应页面是否可以被读写(有效)。例如,如果该位被设置为"valid",那就意味着对应的缓冲池槽中存储着一个页面,而该描述符中保存着该页面的元数据,因而可以对该页面进行读写。反之如果有效位被设置为"invalid",那就意味着该描述符中并没有保存任何元数据;即,对应的页面无法读写,缓冲区管理器可能正在将该页面换出。 - IO进行标记位(
io_in_progress) 指明缓冲区管理器是否正在从存储中读/写相应页面。换句话说,该位指示是否有一个进程正持有此描述符上的io_in_pregress_lock。
- 脏位(
-
freeNext是一个指针,指向下一个描述符,并以此构成一个空闲列表(freelist),细节在下一小节中介绍。
结构
BufferDesc定义于src/include/storage/buf_internals.h中。
为了简化后续章节的描述,这里定义三种描述符状态:
- 空(
Empty):当相应的缓冲池槽不存储页面(即refcount与usage_count都是0),该描述符的状态为空。 - 钉住(
Pinned):当相应缓冲池槽中存储着页面,且有PostgreSQL进程正在访问的相应页面(即refcount和usage_count都大于等于1),该缓冲区描述符的状态为钉住。 - 未钉住(
Unpinned):当相应的缓冲池槽存储页面,但没有PostgreSQL进程正在访问相应页面时(即usage_count大于或等于1,但refcount为0),则此缓冲区描述符的状态为未钉住。
每个描述符都处于上述状态之一。描述符的状态会根据特定条件而改变,这将在下一小节中描述。
在下图中,缓冲区描述符的状态用彩色方框表示。
- (白色)空
- (蓝色)钉住
- (青色)未钉住
此外,脏页面会带有“X”的标记。例如一个未固定的脏描述符用 表示。
8.2.3 缓冲区描述符层
缓冲区描述符的集合构成了一个数组。本书称该数组为缓冲区描述符层(buffer descriptors layer)。
当PostgreSQL服务器启动时,所有缓冲区描述符的状态都为空。在PostgreSQL中,这些描述符构成了一个名为 freelist 的链表,如图8.5所示。
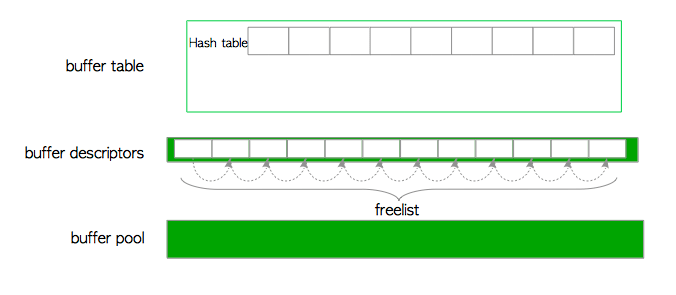
请注意PostgreSQL中的
freelist完全不同于Oracle中freelists的概念。PostgreSQL的freelist只是空缓冲区描述符的链表。PostgreSQL中与Oracle中的freelist相对应的对象是空闲空间映射(FSM)(第5.3.4节)。
图8.6展示了第一个页面是如何加载的。
- 从
freelist的头部取一个空描述符,并将其钉住(即,将其refcount和usage_count增加1)。 - 在缓冲表中插入新项,该缓冲表项保存了页面
buffer_tag与所获描述符buffer_id之间的关系。 - 将新页面从存储器加载至相应的缓冲池槽中。
- 将新页面的元数据保存至所获取的描述符中。
第二页,以及后续页面都以类似方式加载,其他细节将在第8.4.2节中介绍。
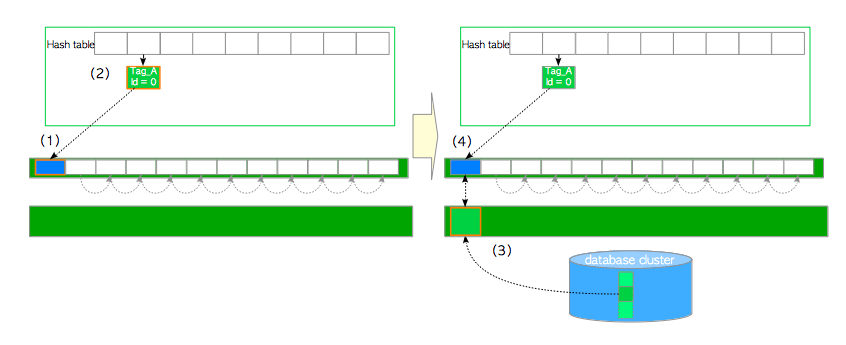
从freelist中摘出的描述符始终保存着页面的元数据。换而言之,仍然在使用的非空描述符不会返还到freelist中。但当下列任一情况出现时,描述符状态将变为“空”,并被重新插入至freelist中:
- 相关表或索引已被删除。
- 相关数据库已被删除。
- 相关表或索引已经被
VACUUM FULL命令清理了。
为什么使用
freelist来维护空描述符?保留
freelist的原因是为了能立即获取到一个描述符。这是内存动态分配的常规做法,详情参阅这里的说明。
缓冲区描述符层包含着一个32位无符号整型变量 nextVictimBuffer 。此变量用于8.4.4节将介绍的页面置换算法。
8.2.4 缓冲池
缓冲池只是一个用于存储关系数据文件(例如表或索引)页面的简单数组。缓冲池数组的序号索引也就是buffer_id。
缓冲池槽的大小为8KB,等于页面大小,因而每个槽都能存储整个页面。
8.3 缓冲区管理器锁
缓冲区管理器会出于不同的目的使用各式各样的锁,本节将介绍理解后续部分所必须的一些锁。
注意本节中描述的锁,指的是缓冲区管理器同步机制的一部分。它们与SQL语句和SQL操作中的锁没有任何关系。
8.3.1 缓冲表锁
BufMappingLock 保护整个缓冲表的数据完整性。它是一种轻量级的锁,有共享模式与独占模式。在缓冲表中查询条目时,后端进程会持有共享的 BufMappingLock。插入或删除条目时,后端进程会持有独占的BufMappingLock。
BufMappingLock 会被分为多个分区,以减少缓冲表中的争用(默认为128个分区)。每个BufMappingLock分区都保护着一部分相应的散列桶槽。
图8.7给出了一个BufMappingLock分区的典型示例。两个后端进程可以同时持有各自分区的BufMappingLock独占锁以插入新的数据项。如果BufMappingLock是系统级的锁,那么其中一个进程就需要等待另一个进程完成处理。
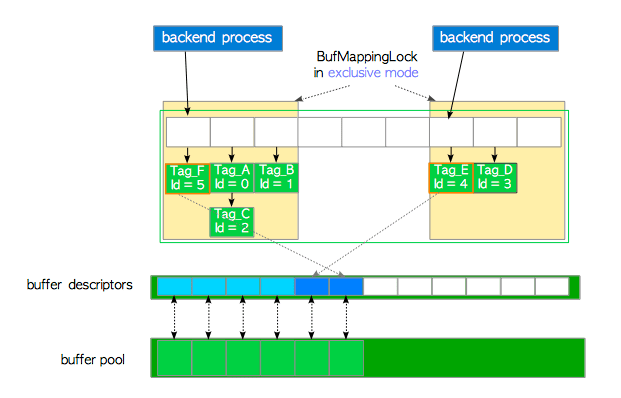
缓冲表也需要许多其他锁。例如,在缓冲表内部会使用 自旋锁(spin lock) 来删除数据项。不过本章不需要其他这些锁的相关知识,因此这里省略了对其他锁的介绍。
在9.4版本之前,
BufMappingLock在默认情况下被分为16个独立的锁。
8.3.2 缓冲区描述符相关的锁
每个缓冲区描述符都会用到两个轻量级锁 —— content_lock 与 io_in_progress_lock,来控制对相应缓冲池槽页面的访问。当检查或更改描述符本身字段的值时,则会用到自旋锁。
8.3.2.1 内容锁(content_lock)
content_lock是一个典型的强制限制访问的锁。它有两种模式:共享(shared) 与独占(exclusive)。
当读取页面时,后端进程以共享模式获取页面相应缓冲区描述符中的content_lock。
但执行下列操作之一时,则会获取独占模式的content_lock:
- 将行(即元组)插入页面,或更改页面中元组的
t_xmin/t_xmax字段时(t_xmin和t_xmax在第5.2节中介绍,简单地说,这些字段会在相关元组被删除或更新行时发生更改)。 - 物理移除元组,或压紧页面上的空闲空间(由清理过程和HOT执行,分别在第6章和第7章中介绍)。
- 冻结页面中的元组(冻结过程在第5.10.1节与第6.3节中介绍)。
官方README文件包含更多的细节。
8.3.2.2 IO进行锁(io_in_progress_lock)
io_in_progress_lock用于等待缓冲区上的I/O完成。当PostgreSQL进程加载/写入页面数据时,该进程在访问页面期间,持有对应描述符上独占的io_in_progres_lock。
8.3.2.3 自旋锁(spinlock)
当检查或更改标记字段与其他字段时(例如refcount和usage_count),会用到自旋锁。下面是两个使用自旋锁的具体例子:
- 下面是钉住缓冲区描述符的例子:
- 获取缓冲区描述符上的自旋锁。
- 将其
refcount和usage_count的值增加1。 - 释放自旋锁。
-
下面是将脏位设置为
"1"的例子:- 获取缓冲区描述符上的自旋锁。
- 使用位操作将脏位置位为
"1"。 - 释放自旋锁。
-
其他标记位也是通过同样的方式来设置的。
用原子操作替换缓冲区管理器的自旋锁
在9.6版本中,缓冲区管理器的自旋锁被替换为原子操作,可以参考这个提交日志的内容。如果想进一步了解详情,可以参阅这里的讨论。
附,9.6版本中缓冲区描述符的数据结构定义。
8.4 缓冲区管理器的工作原理
本节介绍缓冲区管理器的工作原理。当后端进程想要访问所需页面时,它会调用ReadBufferExtended函数。
函数ReadBufferExtended的行为依场景而异,在逻辑上具体可以分为三种情况。每种情况都将用一小节介绍。最后一小节将介绍PostgreSQL中基于 时钟扫描(clock-sweep) 的页面置换算法。
8.4.1 访问存储在缓冲池中的页面
首先来介绍最简单的情况,即,所需页面已经存储在缓冲池中。在这种情况下,缓冲区管理器会执行以下步骤:
- 创建所需页面的
buffer_tag(在本例中buffer_tag是'Tag_C'),并使用散列函数计算与描述符相对应的散列桶槽。 - 获取相应散列桶槽分区上的
BufMappingLock共享锁(该锁将在步骤(5)中被释放)。 - 查找标签为
"Tag_C"的条目,并从条目中获取buffer_id。本例中buffer_id为2。 - 将
buffer_id=2的缓冲区描述符钉住,即将描述符的refcount和usage_count增加1(8.3.2节描述了钉住)。 - 释放
BufMappingLock。 - 访问
buffer_id=2的缓冲池槽。
然后,当从缓冲池槽中的页面里读取行时,PostgreSQL进程获取相应缓冲区描述符的共享content_lock。因而缓冲池槽可以同时被多个进程读取。
当向页面插入(及更新、删除)行时,该postgres后端进程获取相应缓冲区描述符的独占content_lock(注意这里必须将相应页面的脏位置位为"1")。
访问完页面后,相应缓冲区描述符的引用计数值减1。
8.4.2 将页面从存储加载至空槽
在第二种情况下,假设所需页面不在缓冲池中,且freelist中有空闲元素(空描述符)。在这种情况下,缓冲区管理器将执行以下步骤:
-
查找缓冲区表(本节假设页面不存在,找不到对应页面)。
-
创建所需页面的
buffer_tag(本例中buffer_tag为'Tag_E')并计算其散列桶槽。 -
以共享模式获取相应分区上的
BufMappingLock。 -
查找缓冲区表(根据假设,这里没找到)。
-
释放
BufMappingLock。
-
-
从
freelist中获取空缓冲区描述符,并将其钉住。在本例中所获的描述符buffer_id=4。 -
以独占模式获取相应分区的
BufMappingLock(此锁将在步骤(6)中被释放)。 -
创建一条新的缓冲表数据项:
buffer_tag='Tag_E’, buffer_id=4,并将其插入缓冲区表中。 -
将页面数据从存储加载至
buffer_id=4的缓冲池槽中,如下所示:-
以排他模式获取相应描述符的
io_in_progress_lock。 -
将相应描述符的
IO_IN_PROGRESS标记位设置为1,以防其他进程访问。 -
将所需的页面数据从存储加载到缓冲池插槽中。
-
更改相应描述符的状态;将
IO_IN_PROGRESS标记位置位为"0",且VALID标记位被置位为"1"。 -
释放
io_in_progress_lock。
-
-
释放相应分区的
BufMappingLock。 -
访问
buffer_id=4的缓冲池槽。
8.4.3 将页面从存储加载至受害者缓冲池槽中
在这种情况下,假设所有缓冲池槽位都被页面占用,且未存储所需的页面。缓冲区管理器将执行以下步骤:
-
创建所需页面的
buffer_tag并查找缓冲表。在本例中假设buffer_tag是'Tag_M'(且相应的页面在缓冲区中找不到)。 -
使用时钟扫描算法选择一个受害者缓冲池槽位,从缓冲表中获取包含着受害者槽位
buffer_id的旧表项,并在缓冲区描述符层将受害者槽位的缓冲区描述符钉住。本例中受害者槽的buffer_id=5,旧表项为Tag_F, id = 5。时钟扫描将在下一节中介绍。 -
如果受害者页面是脏页,将其刷盘(
write & fsync),否则进入步骤(4)。在使用新数据覆盖脏页之前,必须将脏页写入存储中。脏页的刷盘步骤如下:
-
获取
buffer_id=5描述符上的共享content_lock和独占io_in_progress_lock(在步骤6中释放)。 -
更改相应描述符的状态:相应
IO_IN_PROCESS位被设置为"1",JUST_DIRTIED位设置为"0"。 -
根据具体情况,调用
XLogFlush()函数将WAL缓冲区上的WAL数据写入当前WAL段文件(详细信息略,WAL和XLogFlush函数在第9章中介绍)。 -
将受害者页面的数据刷盘至存储中。
-
更改相应描述符的状态;将
IO_IN_PROCESS位设置为"0",将VALID位设置为"1"。 -
释放
io_in_progress_lock和content_lock。
-
-
以排他模式获取缓冲区表中旧表项所在分区上的
BufMappingLock。 -
获取新表项所在分区上的
BufMappingLock,并将新表项插入缓冲表:- 创建由新表项:由
buffer_tag='Tag_M'与受害者的buffer_id组成的新表项。 - 以独占模式获取新表项所在分区上的
BufMappingLock。 - 将新表项插入缓冲区表中。
- 创建由新表项:由
-
从缓冲表中删除旧表项,并释放旧表项所在分区的
BufMappingLock。 -
将目标页面数据从存储加载至受害者槽位。然后用
buffer_id=5更新描述符的标识字段;将脏位设置为0,并按流程初始化其他标记位。 -
释放新表项所在分区上的
BufMappingLock。 -
访问
buffer_id=5对应的缓冲区槽位。
8.4.4 页面替换算法:时钟扫描
本节的其余部分介绍了 时钟扫描(clock-sweep) 算法。该算法是 NFU(Not Frequently Used) 算法的变体,开销较小,能高效地选出较少使用的页面。
我们将缓冲区描述符想象为一个循环列表(如图8.12所示)。而nextVictimBuffer是一个32位的无符号整型变量,它总是指向某个缓冲区描述符并按顺时针顺序旋转。该算法的伪代码与算法描述如下:
伪代码:时钟扫描
- 获取
nextVictimBuffer指向的候选缓冲区描述符(candidate buffer descriptor)。- 如果候选描述符未被钉住(unpinned),则进入步骤(3), 否则进入步骤(4)。
- 如果候选描述符的
usage_count为0,则选择该描述符对应的槽作为受害者,并进入步骤(5);否则将此描述符的usage_count减1,并继续执行步骤(4)。- 将
nextVictimBuffer迭代至下一个描述符(如果到末尾则回绕至头部)并返回步骤(1)。重复至找到受害者。- 返回受害者的
buffer_id。
具体的例子如图8.12所示。缓冲区描述符为蓝色或青色的方框,框中的数字显示每个描述符的usage_count。
nextVictimBuffer指向第一个描述符(buffer_id = 1);但因为该描述符被钉住了,所以跳过。extVictimBuffer指向第二个描述符(buffer_id = 2)。该描述符未被钉住,但其usage_count为2;因此该描述符的usage_count将减1,而nextVictimBuffer迭代至第三个候选描述符。nextVictimBuffer指向第三个描述符(buffer_id = 3)。该描述符未被钉住,但其usage_count = 0,因而成为本轮的受害者。
当nextVictimBuffer扫过未固定的描述符时,其usage_count会减1。因此只要缓冲池中存在未固定的描述符,该算法总能在旋转若干次nextVictimBuffer后,找到一个usage_count为0的受害者。
8.4.5 环形缓冲区
在读写大表时,PostgreSQL会使用 环形缓冲区(ring buffer) 而不是缓冲池。环形缓冲器是一个很小的临时缓冲区域。当满足下列任一条件时,PostgreSQL将在共享内存中分配一个环形缓冲区:
-
批量读取
当扫描关系读取数据的大小超过缓冲池的四分之一(
shared_buffers/4)时,在这种情况下,环形缓冲区的大小为256 KB。 -
批量写入
当执行下列SQL命令时,这种情况下,环形缓冲区大小为16 MB。
COPY FROM命令。
-
清理过程
当自动清理守护进程执行清理过程时,这种情况环形缓冲区大小为256 KB。
分配的环形缓冲区将在使用后被立即释放。
环形缓冲区的好处显而易见,如果后端进程在不使用环形缓冲区的情况下读取大表,则所有存储在缓冲池中的页面都会被移除(踢出),因而会导致缓存命中率降低。环形缓冲区可以避免此问题。
为什么批量读取和清理过程的默认环形缓冲区大小为256 KB?
为什么是256 KB?源代码中缓冲区管理器目录下的README中解释了这个问题。
顺序扫描使用256KB的环缓冲。它足够小,因而能放入L2缓存中,从而使得操作系统缓存到共享缓冲区的页面传输变得高效。通常更小一点也可以,但环形缓冲区必需足够大到能同时容纳扫描中被钉住的所有页面。
8.4.6 临时表与本地缓冲区
后端创建临时表时,缓冲区管理器会分配一块该后端私有的内存区域并创建本地缓冲区(local buffer)。共享缓冲池槽使用正数标识,而本地缓冲池槽使用负数,例如-1、-2;因此同一后端可以用统一接口访问普通表和临时表。
只有所有者后端能够访问本地缓冲区,所以管理它们不需要进程间锁;临时表数据也不需要写WAL或参与检查点。
8.5 PostgreSQL中的异步I/O
PostgreSQL 18(2025年)引入了**异步I/O(Asynchronous I/O,AIO)**来提高读取性能。缓冲区管理器也因此进行了重构,尤其是执行器进行顺序扫描、位图堆扫描,以及VACUUM顺序读取目标页面的场景。当前PostgreSQL的AIO尚不支持异步写入。
本节介绍AIO的基本概念、PostgreSQL中的实现方式,以及以顺序扫描为重点的具体运行过程。对于不熟悉io_uring的读者,附录A.2给出了两个精简程序。
如何看待AIO基准测试: PostgreSQL的AIO主要优化顺序扫描等操作中的连续块读取,不用于索引扫描;它在缓冲池较冷时收益最大。随着缓冲池升温、缓存命中率提高,收益会逐渐下降。因此,只在冷缓存条件下得到的测试结果可能会明显高估AIO在真实工作负载中的影响。
8.5.1 异步I/O
图8.15比较了传统同步读取与异步读取的执行流程。为了简化说明,图中省略了操作系统页面缓存。
- 同步读取: 应用发出一次
read()系统调用,等待它完成后再发出下一次请求,因此多次读取按顺序串行执行。 - 异步读取: 应用无需等待单个请求完成即可提交多个读取请求;操作系统在后台处理这些请求,应用稍后再收集结果。
8.5.1.1 AIO的优势
异步I/O能同时为应用与存储设备带来性能收益:
- 应用层: 应用可以在等待读取完成期间执行其他任务。
- 存储层: SSD,特别是NVMe SSD,具有多队列与较深的队列深度,可以并行处理多个I/O请求;一次发出多个读取请求能更充分地利用这种并行性。
PostgreSQL因此可以同时发出许多页面读取请求,让操作系统与现代SSD发挥内部并行能力,从而提高缓冲池装载和大表扫描的吞吐量。
8.5.2 PostgreSQL中的AIO实现
PostgreSQL提供两种异步I/O实现:Linux上的io_uring,以及由后台工作进程执行I/O的io_worker。可以使用io_method参数进行选择;macOS、BSD等不支持io_uring的系统需要使用io_worker。
8.5.2.1 io_uring
io_uring是Linux 5.1(2019年)引入的异步I/O接口。PostgreSQL使用一对由用户空间与内核共享的环形缓冲区:提交队列(Submission Queue,SQ)和完成队列(Completion Queue,CQ)。
使用io_uring读取时,处理过程如下:
- 准备并提交请求: PostgreSQL准备一个或多个读取请求,将它们放入SQ并提交给内核。
- 执行请求: 内核从SQ取出请求,利用存储设备的并行能力执行读取。数据通过DMA直接复制到指定的缓冲池槽;操作完成后,内核把完成事件(CQE)放入CQ。
- 等待完成: PostgreSQL等待CQ中出现完成事件,然后即可读取已经装入目标缓冲池槽的页面。
从PostgreSQL的视角看,一个读取请求由数据库页面标识BufferTag与缓冲池槽标识buffer_id组成。使用io_uring时,PostgreSQL会把它们转换为操作系统参数:目标文件描述符、物理字节偏移、8 KB读取长度,以及目标缓冲池槽的内存地址。
向量I/O(分散—聚集I/O)
Linux与Unix通过readv()、writev()支持向量I/O,可以在一次系统调用中读写多个连续块。io_uring同样支持向量I/O,因此PostgreSQL可以用单个请求读取多个连续的关系块。
如图8.17所示,PostgreSQL读取连续块时会准备一次io_uring_prep_readv()调用,而不是为每个块分别执行一次系统调用:
- 后端为关系块0至3准备一个向量读取请求,并指定目标缓冲池槽3、1、4、7。
- 内核把各块读入指定的缓冲池槽。
- PostgreSQL只需等待一个完成事件,即可处理所有已装载页面。
顺序扫描通常读取连续关系块,向量I/O把它们合并成一个请求,既减少系统调用开销,也只产生一个完成事件。
8.5.2.2 io_worker
对于不支持io_uring的操作系统,PostgreSQL提供io_worker实现。一个或多个io_worker后台工作进程负责执行I/O请求。PostgreSQL在共享内存中维护自己的SQ与CQ;后端把读取请求放入SQ,io_worker取出并执行读取,再把完成事件写入CQ。
与io_uring相比:
io_worker使用传统同步读取系统调用执行单个请求。多个worker可以并发处理请求,但并行度和扩展能力通常弱于io_uring。- 后端与
io_worker需要通过共享内存队列和进程唤醒机制协调,因此会产生额外的通信与调度开销。
PostgreSQL 18中I/O worker数量由io_workers固定指定;PostgreSQL 19开发版改为通过io_min_workers、io_max_workers、io_worker_idle_timeout与io_worker_launch_interval动态调整。
8.5.3 异步顺序扫描的基本原理
AIO顺序扫描本身只依赖少量基础函数,但为了优化性能而组合的组件较多。下面先使用一个高度简化的冷启动模型说明基本行为:假设缓冲池中没有任何目标页面,所有数据都需要从存储读取。下一小节再补入真实实现中的缓存命中、自适应预读与快速路径。
在以下伪代码中:
BufferAlloc()抽象了除物理读取外的缓冲区描述符管理。- 省略PIN等低层细节。
do_exec(tuple)代表过滤条件求值、聚合增量计算等元组处理。
8.5.3.1 ReadStream与stream_buffers抽象
AIO顺序扫描的基本策略很直接:从头开始顺序处理目标表页面,同时提前异步预读一定数量的块。缓冲区管理器使用ReadStream结构跟踪和管理这些预读块。
ReadStream包含buffers[]数组及若干元数据。该数组是一个循环FIFO队列,有效窗口大小由combine_distance决定;oldest_buffer_index指向最早尚未消费的缓冲区:
为了隐藏循环队列的底层指针运算,下文把整个FIFO队列简化表示为stream_buffers。
入队
假设要把关系的第2号块装入缓冲池第5号槽。缓冲区管理器会把整数5写入buffers[]中next_buffer_index所指位置;在简化的stream_buffers表示中,则直接显示对应的缓冲区描述符(图中以块号2表示)。
出队
队首缓冲区标识出队后,oldest_buffer_index向右推进一个槽,pinned_buffers也相应减一;在stream_buffers抽象中,这等价于删除列表最左侧元素。
队列大小
read_stream_begin_impl()会根据effective_io_concurrency、io_combine_limit等配置计算queue_size。计算从以下上限开始:
其中BLCKSZ默认为8 KB;实际queue_size还可能因其他参数和运行条件而减小。
8.5.3.2 AIO核心操作
下面定义几个封装基本AIO操作的伪代码函数。
分配缓冲区并入队
read_ahead()为目标关系块分配缓冲区描述符,并将其加入stream_buffers:
准备并提交异步读取
prepare_and_submit()为read_ahead()刚入队的描述符准备并提交异步读取。由于顺序扫描读取连续块,它会使用向量I/O合并多个块:
等待异步读取完成
WaitReadBuffers()等待特定I/O完成,并把相关缓冲区标记为有效:
8.5.3.3 使用AIO的顺序扫描
利用上述函数,AIO顺序扫描的基本行为可写成:
- 首轮预读
combine_distance(这里为4)个页面,将它们入队并提交异步请求。 - 按顺序处理目标表页面。
- 从
stream_buffers取出下一个缓冲区描述符。 - 如果该块仍在从存储读取,则调用
WaitReadBuffers()等待完成。 - 队列为空时预读下一批块并提交请求。此时操作系统可以在后端处理当前页元组的同时异步读取下一批页面,这正是AIO收益的来源。
- 处理当前页面中的全部元组。
在图8.21中,上一轮结束时队列清空,read_ahead()把块至入队并提交请求;后端随即处理上一轮最后一块,与操作系统读取下一批块并行。当开始处理块时,如果I/O尚未结束,WaitReadBuffers()等待一次完成事件,并把这一批四个块全部标记为有效;随后至可以直接处理。队列再次清空后,下一批至以同样方式提交。
与传统同步顺序扫描的比较
在传统模型中,后端对每个块串行重复三个阶段:分配缓冲区;调用同步read()并完全阻塞;I/O完成后解除缓冲区锁定并处理元组。AIO则把多个块的读取与当前页面的处理重叠起来。
8.5.4 异步顺序扫描的实际实现
真实缓冲区管理器在上述流水线基础上还会:处理预读期间的缓存命中;根据实时行为动态调整预读窗口;连续命中缓存时进入快速路径,绕过stream_buffers管理开销。
8.5.4.1 预读时的缓存命中
当read_ahead()遇到缓存命中时,它会停止继续扫描,只使用此前累积的连续未命中块来准备读取请求。
假设块已经在缓冲池中:
read_ahead()从块开始入队,在遇到命中时停止。prepare_and_submit()只为连续的与准备并提交一个向量读取请求。WaitReadBuffers()等待请求完成。- 扫描依次处理、和已在缓存中的。
在第一次命中处停止预读,可以保证stream_buffers中累积的未命中块在关系文件中物理连续,从而合并为单个向量I/O请求。
处理完后,如果后续块未命中,read_ahead()会从开始重新填充队列并提交多块请求;如果后续仍连续命中,则已缓存描述符会逐个入队,扫描反复执行单块处理。
8.5.4.2 自适应预读
stream_buffers的combine_distance会动态变化。顺序扫描开始时其值为1:
-
增长: 每轮翻倍,例如1、2、4、8,直到达到以下上限:
-
衰减: 连续缓存命中超过
queue_size - 1个块后,combine_distance每次减1,最低降至1;一旦再次发生缓存未命中,立即切回增长模式。
这种策略让预读并行度快速达到上限,却只在缓存持续命中时缓慢下降。
8.5.4.3 快速路径:绕过stream_buffers
当combine_distance已经降为1且缓存继续命中时,缓冲区管理器会进入快速路径(Fast Path),不再使用stream_buffers,而是直接读取缓冲池槽,以省去整套队列管理开销。快速路径中一旦出现缓存未命中,就立即回到正常预读模式。
如果目标关系的所有块都已缓存在缓冲池中,缓冲区管理器只在处理第0号块时使用一次stream_buffers,之后的块都走快速路径。
8.6 脏页刷盘
除了置换受害者页面之外,检查点进程(Checkpointer) 和后台写入器进程也会将脏页刷写至存储中。尽管两个进程都具有相同的功能(刷写脏页),但它们有着不同的角色和行为。
检查点进程将 检查点记录(checkpoint record) 写入WAL段文件,并在检查点开始时进行脏页刷写。9.7节介绍了检查点,以及检查点开始的时机。
后台写入器的目的是通过少量多次的脏页刷盘,减少检查点带来的密集写入的影响。后台写入器会一点点地将脏页落盘,尽可能减小对数据库活动造成的影响。默认情况下,后台写入器每200毫秒被唤醒一次(由参数bgwriter_delay定义),且最多刷写bgwriter_lru_maxpages个页面(默认为100个页面)。
为什么检查点进程与后台写入器相分离?
在9.1版及更早版本中,后台写入器会规律性地执行检查点过程。在9.2版本中,检查点进程从后台写入器进程中被单独剥离出来。原因在一篇题为“将检查点进程与后台写入器相分离”的提案中有介绍。下面是一些摘录:
当前(在2011年)后台写入器进程既执行后台写入,又负责检查点,还处理一些其他的职责。这意味着我们没法在不停止后台写入的情况下执行检查点最终的
fsync。因此,在同一个进程中做两件事会有负面的性能影响。此外,在9.2版本中,我们的一个目标是通过将轮询循环替换为锁存器,从而降低功耗。
bgwriter中的循环复杂度太高了,以至于无法找到一种简洁的使用锁存器的方法。
9 预写式日志
事务日志(transaction log)是数据库的关键组件,因为当出现系统故障时,任何数据库管理系统都不允许丢失数据。事务日志是数据库系统中所有 变更(change) 与 行为(action) 的历史记录,当诸如电源故障,或其他服务器错误导致服务器崩溃时,它被用于确保数据不会丢失。由于日志包含每个已执行事务的相关充分信息,因此当服务器崩溃时,数据库服务器应能通过重放事务日志中的变更与行为来恢复数据库集群。
在计算机科学领域,WAL是Write Ahead Logging的缩写,它指的是将变更与行为写入事务日志的协议或规则;而在PostgreSQL中,WAL是Write Ahead Log的缩写。在这里它被当成事务日志的同义词,而且也用来指代一种将行为写入事务日志(WAL)的实现机制。虽然有些令人困惑, 但本文将使用PostgreSQL中的定义。
WAL机制在7.1版本中首次被实现,用以减轻服务器崩溃的影响。它还是 时间点恢复(Point-in-Time Recovery, PITR) 与 流复制(Streaming Replication, SR) 实现的基础,这两者将分别在 第10章 和 第11章 中介绍。
尽管理解WAL机制对于管理、集成PostgreSQL非常重要,但由于它的复杂性,不可能做到简要介绍。因此本章将会对WAL做一个完整的解释。第一节描绘了WAL的全貌,介绍了一些重要的概念与关键词。接下来的小节中会依次讲述其他主题:
- 事务日志(WAL)的逻辑结构与物理结构
- WAL数据的内部布局
- WAL数据的写入
- WAL写入者进程
- 检查点过程
- 数据库恢复流程
- 管理WAL段文件
- 持续归档
9.1 概述
让我们先来概述一下WAL机制。为了阐明WAL要解决的问题,第一部分展示了如果PostgreSQL在没有实现WAL时崩溃会发生什么。第二部分介绍了一些关键概念,并概览了本章中的一些关键主题。最后一部分总结了WAL概述部分,并引出了一个更为重要的概念。
9.1.1 没有WAL的插入操作
正如在第八章中讨论的那样,为了能高效访问关系表的页面,几乎所有的DBMS都实现了共享缓冲池。
假设有这样一个没有实现WAL机制的PostgreSQL,现在向表A中插入一些数据元组,如图9.1所示。
- 发起第一条
INSERT语句时,PostgreSQL从数据库集簇文件中加载表A的页面到内存中的共享缓冲池。然后向页面中插入一条元组。页面并没有立刻写回到数据库集簇文件中。正如第8章中提到的,被修改过的页面通常称为脏页(dirty page) - 发起第二条
INSERT语句时,PostgreSQL直接向缓冲池里的页面内添加了一条新元组。这一页仍然没有被写回到持久存储中。 - 如果操作系统或PostgreSQL服务器因为各种原因失效(例如电源故障),所有插入的数据都会丢失。
因此没有WAL的数据库在系统崩溃时是很脆弱的。
9.1.2 插入操作与数据库恢复
为了解决上述系统失效问题,同时又不招致性能损失,PostgreSQL支持了WAL。这一部分介绍了一些关键词和概念,以及WAL数据的写入和数据库系统的恢复。
为了应对系统失效,PostgreSQL将所有修改作为历史数据写入持久化存储中。这份历史数据称为 XLOG记录(xlog record) 或 WAL数据(wal data)。
当插入、删除、提交等变更动作发生时,PostgreSQL会将XLOG记录写入内存中的WAL缓冲区(WAL Buffer)。 当事务提交或中止时,它们会被立即写入持久存储上的 WAL段文件(WAL segment file) 中(更精确来讲,其他场景也可能会有XLOG记录写入,细节将在9.5节中描述)。XLOG记录的 日志序列号(Log Sequence Number, LSN) 标识了该记录在事务日志中的位置,记录的LSN被用作XLOG记录的唯一标识符。
顺便一提,当我们考虑数据库系统如何恢复时,可能会想到一个问题:PostgreSQL是从哪一点开始恢复的?答案是重做点(REDO Point),即最新一个检查点(Checkpoint)开始时XLOG记录写入的位置。(PostgreSQL中的检查点将在9.7节中描述)。实际上,数据库恢复过程与检查点过程紧密相连,两者是不可分割的。
WAL与检查点过程在7.1版本中同时实现
介绍完了主要的关键词与概念,现在来说一下带有WAL时的元组插入操作。如图9.2所示:
表A的LSN展示的是表A页面中页首部里
pd_lsn类型的PageXLogRecPtr字段,与页面的LSN是一回事。
- 检查点进程是一个后台进程,周期性地执行检查点过程。当检查点进程开始执行检查点时,它会向当前WAL段文件写入一条XLOG记录,称为检查点记录(Checkpoint Record)。这条记录包含了最新的重做点位置。
- 发起第一条
INSERT语句时,PostgreSQL从数据库集簇文件中加载表A的页面至内存中的共享缓冲池,向页面中插入一条元组,然后在LSN_1位置创建并写入一条相应的XLOG记录,然后将表A的LSN从LSN_0更新为LSN_1。在本例中,XLOG记录是由首部数据与完整元组组成的一对值。 - 当该事务提交时,PostgreSQL向WAL缓冲区创建并写入一条关于该提交行为的XLOG记录,然后将WAL缓冲区中的所有XLOG记录刷写入WAL段文件中。
- 发起第二条
INSERT语句时,PostgreSQL向页面中插入一条新元组,然后在LSN_2位置创建并写入一条相应的XLOG记录,然后将表A的LSN从LSN_1更新为LSN_2。 - 当这条语句的事务提交时,PostgreSQL执行同步骤3类似的操作。
- 设想当操作系统失效发生时,尽管共享缓冲区中的所有数据都丢失了,但所有页面修改已经作为历史记录被写入WAL段文件中。
接下来的步骤展示了如何将数据库集簇恢复到崩溃时刻前的状态。不需要任何特殊的操作,重启PostgreSQL时会自动进入恢复模式,如图9.3所示。PostgreSQL会从重做点开始,依序读取正确的WAL段文件并重放XLOG记录。
- PostgreSQL从相关的WAL段文件中读取第一条
INSERT语句的XLOG记录,并从硬盘上的数据库集簇目录加载表A的页面到内存中的共享缓冲区中。 - 在重放XLOG记录前,PostgreSQL会比较XLOG记录的LSN与相应页面的LSN。这么做的原因在第9.8节中描述。重放XLOG记录的规则如下所示:
- 如果XLOG记录的LSN要比页面LSN大,XLOG记录中的数据部分就会被插入到页面中,并将页面的LSN更新为XLOG记录的LSN。
- 如果XLOG记录的LSN要比页面的LSN小,那么不用做任何事情,直接读取后续的WAL数据即可。
- PostgreSQL按照同样的方式重放其余的XLOG记录。
PostgreSQL可以通过按时间顺序重放写在WAL段文件中的XLOG记录来自我恢复,因此,PostgreSQL的XLOG记录显然是一种重做日志(REDO log)。
PostgreSQL不支持撤销日志(UNDO log)
尽管写XLOG记录肯定有一定的代价,这些代价和全页写入相比微不足道。所付出的代价换来了巨大的收益,比如,系统崩溃时的恢复能力。
9.1.3 整页写入
假设后台写入进程在写入脏页的过程中出现了操作系统故障,导致磁盘上表A的页面数据损坏。XLOG是无法在损坏的页面上重放的,我们需要其他功能来确保这一点。
译注:PostgreSQL默认使用8KB的页面,操作系统通常使用4KB的页面,可能出现只写入一个4KB页面的情况。
PostgreSQL支持诸如整页写入(full-page write)的功能来处理这种失效。如果启用,PostgreSQL会在每次检查点之后,在每个页面第一次发生变更时,会将整个页面及相应首部作为一条XLOG记录写入。这个功能默认是开启的。在PostgreSQL中,这种包含完整页面的XLOG记录称为备份区块(backup block),或者整页镜像(full-page image)。
- 检查点进程开始进行检查点过程。
- 在第一条
INSERT语句进行插入操作时,PostgreSQL执行的操作几乎同上所述。区别在于这里的XLOG记录是当前页的备份区块(即,包含了完整的页面),因为这是自最近一次检查点以来,该页面的第一次写入。 - 当事务提交时,PostgreSQL的操作同上节所述。
- 第二条
INSERT语句进行插入操作时,PostgreSQL的操作同上所述,这里的XLOG记录就不是备份块了。 - 当这条语句的事务提交时,PostgreSQL的操作同上节所述。
- 为了说明整页写入的效果,我们假设后台写入进程在向磁盘写入脏页的过程中出现了操作系统故障,导致磁盘上表A的页面数据损坏。
重启PostgreSQL即可修复损坏的集簇,如图9.5所示
-
PostgreSQL读取第一条
INSERT语句的XLOG记录,并从数据库集簇目录加载表A的页面至共享缓冲池中。在本例中,按照整页写入的规则,这条XLOG记录是一个备份区块。 -
当一条XLOG记录是备份区块时,会使用另一条重放规则:XLOG记录的数据部分会直接覆盖当前页面,无视页面或XLOG记录中的LSN,然后将页面的LSN更新为XLOG记录的LSN。
在本例中,PostgreSQL使用记录的数据部分覆写了损坏的页面,并将表A的LSN更新为
LSN_1,通过这种方式,损坏的页面通过它自己的备份区块恢复回来了。 -
因为第二条XLOG记录不是备份区块, 因此PostgreSQL的操作同上所述。
即使发生一些数据写入错误,PostgreSQL也能从中恢复。(当然如果发生文件系统或物理介质失效,就不行了)
9.2 事务日志与WAL段文件
PostgreSQL在逻辑上将XLOG记录写入事务日志,即,一个长度用8字节表示的虚拟文件(16 EB)。
虽说事务日志的容量实际上应该是无限的,但8字节长度的地址空间已经足够宽广了。目前是不可能处理这个量级的单个文件的。因此PostgreSQL中的事务日志实际上默认被划分为16M大小的一系列文件,这些文件被称作WAL段(WAL Segment)。如图9.6所示。
WAL段文件尺寸
从版本11开始,在使用
initdb创建数据库时,可以通过--wal-segsize选项来配置WAL段文件的大小。
WAL段文件名由24个十六进制数字组成,其命名规则如下:
时间线标识
PostgreSQL的WAL有时间线标识(TimelineID,四字节无符号整数)的概念,用于第十章中所述的时间点恢复(PITR)。不过在本章中时间线标识将固定为
0x00000001,因为接下来的几节里还不需要这个概念。
第一个WAL段文件名是 ,如果第一个段被XLOG记录写满了,就会创建第二个段,后续的文件名将使用升序。在被填满之后,就会使用下一个文件。通过这种方式,每当最后两位数字要进位时,中间8位数字就会加一。与之类似,在被填满后,就会开始使用,依此类推。
WAL文件名
使用内建的函数
pg_xlogfile_name(9.6及以前的版本),或pg_walfile_name(10及以后的版本),我们可以找出包含特定LSN的WAL段文件。例如:
9.3 WAL段文件的内部布局
一个WAL段文件大小默认为16MB,并在内部划分为大小为8192字节(8KB)的页面。第一个页包含了由XLogLongPageHeaderData定义的首部数据,其他的页包含了由XLogPageHeaderData定义的首部数据。每页在首部数据之后,紧接着就是以降序写入的XLOG记录,如图9.7所示。
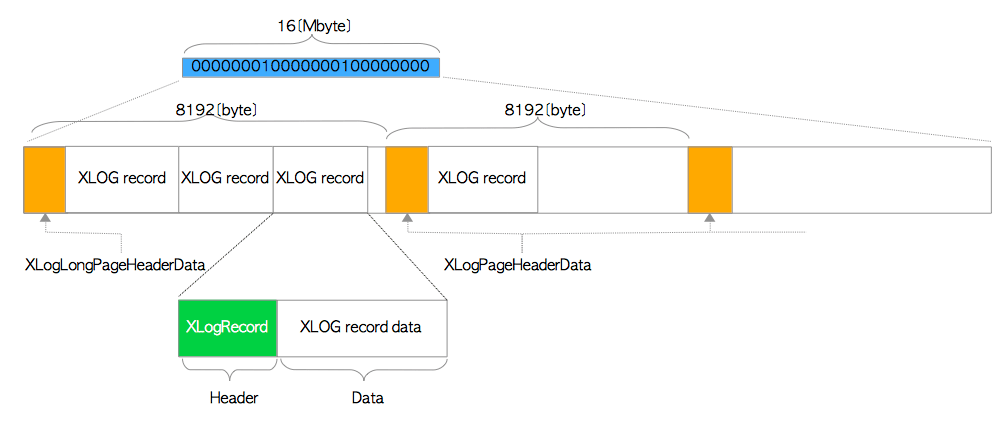
XLogLongPageHeaderData与XLogPageHeaderData结构定义在 src/include/access/xlog_internal.h中。这两个结构的具体说明就不在此展开了,因为对于后续小节并非必需。
9.4 WAL记录的内部布局
一条XLOG记录由通用的首部部分与特定的数据部分构成。本章第一节描述了首部的结构,剩下两个节分别解释了9.5版本前后数据部分的结构。(9.5版本改变了数据格式)
9.4.1 WAL记录首部部分
所有的XLOG记录都有一个通用的首部,由结构XLogRecord定义。9.5更改了首部的定义,9.4及更早版本的结构定义如下所示:
除了两个变量,大多数变量的意思非常明显,无需多言。xl_rmid 与 xl_info都是与 资源管理器(resource manager) 相关的变量,它是一些与WAL功能(写入,重放XLOG记录)相关的操作集合。资源管理器的数目随着PostgreSQL不断增加,第10版包括这些:
| 资源管理器 | |
|---|---|
| 堆元组操作 | RM_HEAP, RM_HEAP2 |
| 索引操作 | RM_BTREE, RM_HASH, RM_GIN, RM_GIST, RM_SPGIST, RM_BRIN |
| 序列号操作 | RM_SEQ |
| 事务操作 | RM_XACT, RM_MULTIXACT, RM_CLOG, RM_XLOG, RM_COMMIT_TS |
| 表空间操作 | RM_SMGR, RM_DBASE, RM_TBLSPC, RM_RELMAP |
| 复制与热备操作 | RM_STANDBY, RM_REPLORIGIN, RM_GENERIC_ID, RM_LOGICALMSG_ID |
下面是一些有代表性的例子,展示了资源管理器工作方式。
- 如果发起的是
INSERT语句,则其相应XLOG记录首部中的变量xl_rmid与xl_info会相应地被设置为RM_HEAP与XLOG_HEAP_INSERT。当恢复数据库集簇时,就会按照xl_info选用资源管理器RM_HEAP的函数heap_xlog_insert()来重放当前XLOG记录。 UPDATE语句与之类似,首部变量中的xl_info会被设置为XLOG_HEAP_UPDATE,而在数据库恢复时就会选用资源管理器RM_HEAP的函数heap_xlog_update()进行重放。- 当事务提交时,相应XLOG记录首部的变量
xl_rmid与xl_info会被相应地设置为RM_XACT与XLOG_XACT_COMMIT。当数据库恢复时,RM_XACT的xact_redo_commit()就会执行本记录的重放。
在9.5及之后的版本,首部结构XLogRecord移除了一个字段xl_len,精简了XLOG记录的格式,省了几个字节。
9.4版本中的
XLogRecord结构定义在src/include/access/xlog.h中,9.5及以后的定义在src/include/access/xlogrecord.h。heap_xlog_insert与heap_xlog_update定义在src/backend/access/heap/heapam.c;而函数xact_redo_commit定义在src/backend/access/transam/xact.c中
9.4.2 XLOG记录数据部分(9.4及以前)
XLOG记录的数据部分可以分为两类:备份区块(完整的页面),或非备份区块(不同的操作相应的数据不同)。
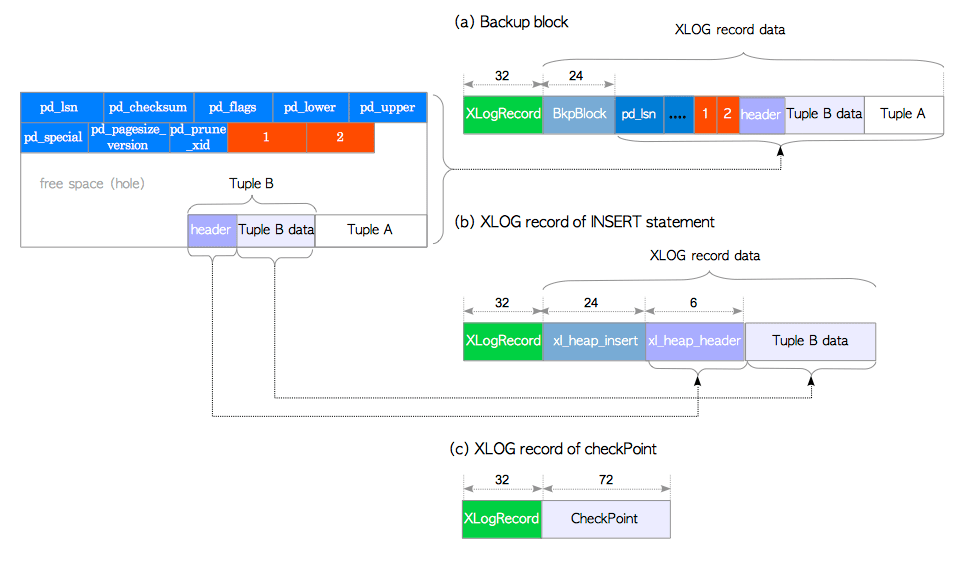
让我们通过几个具体示例来了解XLOG记录的内部布局。
9.4.2.1 备份区块
备份区块如图9.8(a)所示,它由两个数据结构和一个数据对象组成,如下所述:
- 首部部分,
XLogRecord结构体 BkpBlock结构体- 除去空闲空间的完整页面。
BkpBlock包括了用于在数据库集簇目录中定位该页面的变量(比如,包含该页面的关系表的RelFileNode与ForkNumber,以及文件内的区块号BlockNumber),以及当前页面空闲空间的开始位置与长度。
9.4.2.2 非备份区块
在非备份区块中,数据部分的布局依不同操作而异。这里举一个具有代表性的例子:一条INSERT语句的XLOG记录。如图9.8(b)所示,INSERT语句的XLOG记录是由两个数据结构与一个数据对象组成的:
- 首部部分,
XLogRecord结构体 xl_heap_insert结构体- 被插入的元组 —— 更精确地说,是移除了一些字节的元组。
结构体xl_heap_insert包含的变量用于在数据库集簇中定位被插入的元组。(即,包含该元组的表的RelFileNode,以及该元组的tid),以及该元组的可见性标记位。
在结构体
xl_heap_header的代码注释中解释了移除插入元组中若干字节的原因:我们并没有在WAL中存储被插入或被更新元组的固定部分(即
HeapTupleHeaderData,堆元组首部),我们可以在需要时从WAL中的其它部分重建这几个字段,以此节省一些字节。或者根本就无需重建。
这里还有一个例子值得一提,如图9.8(c)所示,检查点的XLOG记录相当简单,它由如下所示的两个数据结构组成:
XLogRecord结构(首部部分)- 包含检查点信息的
CheckPoint结构体(参见9.7节)
xl_heap_header结构定义在src/include/access/htup.h中,而CheckPoint结构体定义在src/include/catalog/pg_control.h中。
9.4.3 XLOG记录数据部分(9.5及后续版本)
在9.4及之前的版本,XLOG记录并没有通用的格式,因此每一种资源管理器都需要定义各自的格式。在这种情况下,维护源代码,以及实现与WAL相关的新功能变得越来越困难。为了解决这个问题,9.5版引入了一种通用的结构化格式,不依赖于特定的资源管理器。
XLOG记录的数据部分可以被划分为两个部分:首部与数据,如图9.9所示:
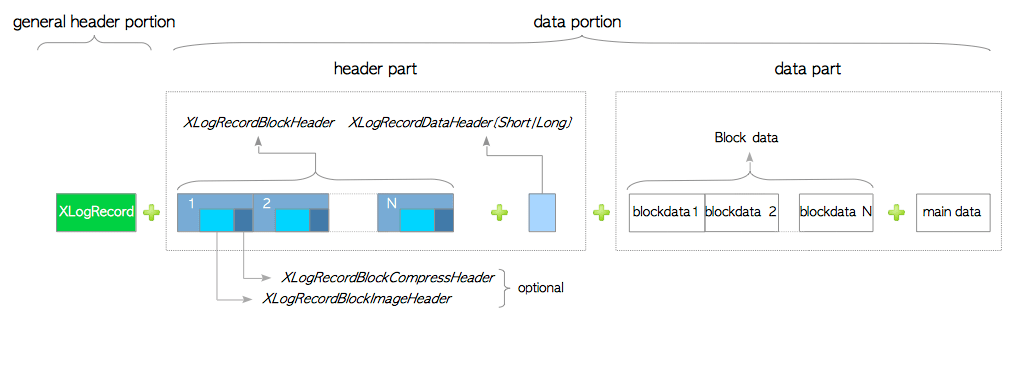
首部部分包含零个或多个XLogRecordBlockHeaders,以及零个或一个XLogRecordDataHeaderShort(或XLogRecordDataHeaderLong);它必须至少包含其中一个。当记录存储着整页镜像时(即备份区块),XLogRecordBlockHeader会包含XLogRecordBlockImageHeader,如果启用压缩还会包含XLogRecordBlockCompressHeader。
数据部分则由零或多个区块数据与零或一个主数据组成,区块数据与XLogRecordBlockHeader(s)对应,而 主数据(main data) 则与XLogRecordDataHeader对应。
WAL压缩
在9.5及其后的版本,可以通过设置
wal_compression = enable启用WAL压缩:使用LZ压缩方法对带有整页镜像的XLOG记录进行压缩。在这种情况下,会添加XLogRecordBlockCompressHeader结构。该功能有两个优点与一个缺点,优点是降低写入记录的I/O开销,并减小WAL段文件的消耗量;缺点是会消耗更多的CPU资源来执行压缩。
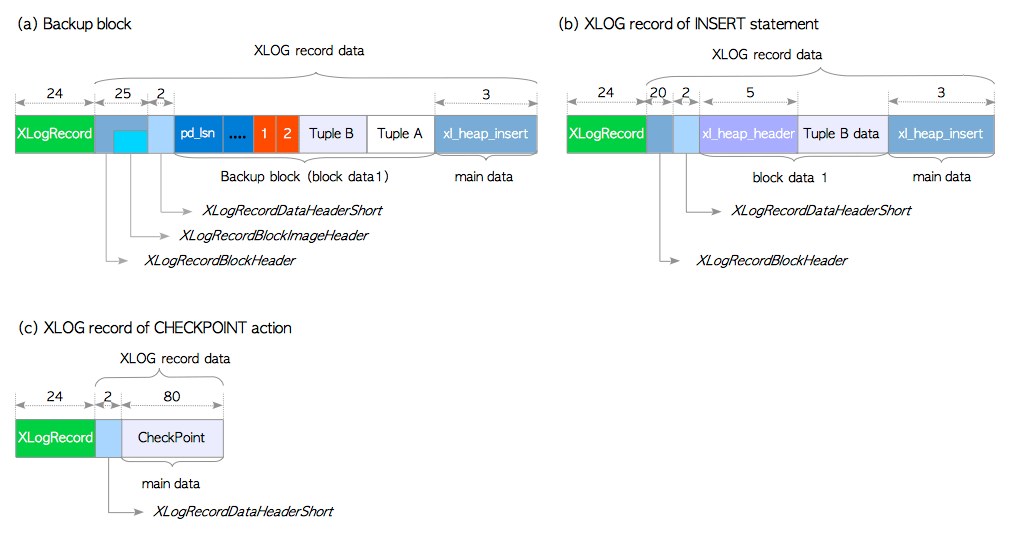
和前一小节一样,这里通过一些特例来描述。
9.4.3.1 备份区块
由INSERT语句创建的备份区块如图9.10(a)所示,它由如下所示的四个数据结构与一个数据对象组成:
XLogRecord结构 (首部部分)XLogRecordBlockHeader结构,且包含一个XLogRecordBlockImageHeaderXLogRecordDataHeaderShort结构- 一个备份区块(区块数据)
xl_heap_insert结构 (主数据)
XLogRecordBlockHeader包含了用于在数据库集簇中定位区块的变量 (关系节点,分支编号,以及区块号); XLogRecordImageHeader 包含了当前区块的长度与偏移量(这两个首部结构合起来效果与9.4及先前版本中的BkpBlock结构相同)。
XLogRecordDataHeaderShort存储了xl_heap_insert结构的长度,该结构是当前记录的主数据部分(见下)。
除了某些特例外(例如逻辑解码与推测插入(speculative insertion)),包含整页镜像的XLOG记录的主数据不会被使用。它们会在记录重放时被忽略,属于冗余数据,未来可能会对其改进。
此外,备份区块记录的主数据与创建它们的语句相关。例如
UPDATE语句就会追加写入xl_heap_lock或xl_heap_updated。
9.4.3.2 非备份区块
接下来描述由INSERT语句创建的非备份区块,如图9.10(b)所示,它由四个数据结构与一个数据对象组成:
XLogRecord结构 (首部部分)XLogRecordBlockHeader结构XLogRecordDataHeaderShort结构- 一条被插入的元组(更精确地说,一个
xl_heap_header结构与完整的插入数据) xl_heap_insert结构 (主数据)
XLogRecordBlockHeader包含三个值 (关系节点,分支编号,以及区块号),用以指明该元组被插入到哪个区块中,以及要插入数据部分的长度。XLogRecordDataHeaderShort存储了xl_heap_insert结构的长度,该结构是当前记录的主数据部分。
新版本的xl_heap_insert仅包含两个值:当前元组在区块内的偏移量,以及一个可见性标记。该结构变得十分简单,因为XLogRecordBlockHeader存储了旧版本中该结构体的绝大多数数据。
最后一个例子,检查点的记录如图9.10(c)所示,它由三个数据结构组成:
XLogRecord结构体(首部部分)XLogRecordDataHeaderShort结构,包含了主数据的长度。- 结构体
CheckPoint(主数据)
xl_heap_header定义于src/include/access/htup.h中,而CheckPoint结构定义于src/include/catalog/pg_control.h中。
尽管对我们来说新格式稍显复杂,但它对于资源管理器的解析而言,设计更为合理,而且许多类型的XLOG记录的大小都比先前要小。主要的结构如图9.8和图9.10所示,你可以计算并相互比较这些记录的大小。(新版CheckPoint记录的尺寸要比旧版本大一些,但它也包含了更多的变量)。
9.5 WAL记录的写入
完成了热身练习后,现在我们已经做好理解XLOG记录写入过程的准备了。因此在本节中,我将尽可能仔细地描述。首先,以下列语句的执行为例,让我们来看一看PostgreSQL的内幕。
通过发出上述语句,内部函数exec_simple_query()会被调用,其伪代码如下所示:
在接下来的段落中将会解释每一行伪代码,从而理解XLOG记录写入的过程。如图9.11和图9.12所示。
- 函数
ExtendCLOG()将当前事务的状态IN_PROGRESS写入内存中的CLOG。 - 函数
heap_insert()向共享缓冲池的目标页面中插入堆元组,创建当前页面的XLOG记录,并执行函数XLogInsert()。 - 函数
XLogInsert()会将heap_insert()创建的XLOG记录写入WAL缓冲区LSN_1处,并将被修改页面的pd_lsn从LSN_0更新为LSN_1。 - 函数
finish_xact_command()会在该事务被提交时被调用,用于创建该提交动作的XLOG记录,而这里的XLogInsert()函数会将该记录写入WAL缓冲区LSN_2处。
上图的XLOG格式是9.4版本的
- 函数
XLogWrite()会冲刷WAL缓冲区,并将所有内容写入WAL段文件中。如果wal_sync_method参数被配置为open_sync或open_datasync,记录会被同步写入(译者注:而不是提交才会刷新WAL缓冲区),因为函数会使用带有O_SYNC或O_DSYNC标记的open()系统调用。如果该参数被配置为fsync,fsync_writethrough,fdatasync,相应的系统调用就是fsync(),带有F_FULLSYNC选项的fcntl(),以及fdatasync()。无论哪一种情况,所有的XLOG记录都会被确保写入存储之中。 - 函数
TransactionIdCommitTree()将提交日志clog中当前事务的状态从IN_PROGRESS更改为COMMITTED。
在上面这个例子中,COMMIT操作致使XLOG记录写入WAL段文件。但发生在下列任一情况时,都会执行这种写入操作:
- 一个运行中的事务提交或中止。
- WAL缓冲区被写入的元组填满(WAL缓冲区的大小由参数
wal_buffers控制) - WAL写入者进程周期性执行写入(参见下一节)
如果出现上述情况之一,无论其事务是否已提交,WAL缓冲区上的所有WAL记录都将写入WAL段文件中。
DML操作写XLOG记录是理所当然的,但非DML操作也会产生XLOG。如上所述,COMMIT操作会写入包含着提交的事务ID的XLOG记录。另一个例子是Checkpoint操作会写入关于该检查点概述信息的XLOG记录。此外,尽管不是很常见,SELECT语句在一些特殊情况下也会创建XLOG记录。例如在SELECT语句处理的过程中,如果因为HOT(Heap Only Tuple)需要删除不必要元组并拼接必要的元组时,修改对应页面的XLOG记录就会写入WAL缓冲区。
9.6 WAL相关进程
9.6.1 WAL写入进程
WAL写入者是一个后台进程,用于定期检查WAL缓冲区,并将所有未写入的XLOG记录写入WAL段文件。 这个进程的目的是避免XLOG记录的突发写入。 如果没有启用该进程,则在一次提交大量数据时,XLOG记录的写入可能会成为瓶颈。
WAL写入者默认是启用的,无法禁用。但检查间隔可以通过参数wal_writer_delay进行配置,默认值为200毫秒。
9.6.2 WAL汇总器进程
PostgreSQL 17(2024年)为了支持第10.5节中的增量备份,引入了WAL汇总器进程(WAL summarizer process)。该进程跟踪所有数据库块的变化,包括关系文件和可见性映射,并把结果写入$PGDATA/pg_wal/summaries/目录下的WAL汇总文件。
配置参数summarize_wal用于启用该进程,默认关闭。需要注意的是,WAL汇总器不会跟踪空闲空间映射(FSM)分支,因为FSM的变更没有被完整地写入WAL。
9.6.2.1 WAL汇总器的工作流程
WAL汇总器按以下步骤工作:
- 在每次检查点期间,读取从上一个重做点到当前重做点之间的WAL段文件。
- 利用这些WAL记录跟踪所有关系的全部变更块,包括可见性映射。
- 把结果写入
pg_wal/summaries/目录下的WAL汇总文件。
这里把“上一个重做点”和“当前重做点”分别称为start_lsn与end_lsn。汇总文件采用以下命名格式:
实际文件示例如下:
函数pg_available_wal_summaries()可以列出可用的WAL汇总:
汇总文件创建后,超过wal_summary_keep_time所指定的保留期(默认10天)便会被PostgreSQL自动删除。
9.6.2.2 汇总文件的内容
下面创建t1、t2、t3和t4四张表,每张表最初都由四个块组成,用它们说明汇总文件记录的内容:
执行检查点后,再进行以下操作:更新t1的两行;向t2插入150行;从t3删除500行;截断t4;创建新表t5并插入800行。
函数pg_wal_summary_contents(timeline, start_lsn, end_lsn)显示给定start_lsn与end_lsn之间的所有变更块,包括文件节点OID、块号、分支号和is_limit_block标记。
1. 修改已有块
更新t1中的两行后,汇总数据如下:
输出表明t1的第0号和第3号块发生了变化。
2. 增加新块
向t2增加150行后,第3号块被修改,并新增第4号块:
3. 移除块
当从某个块号开始删除后续块时,汇总器会记录边界块并把is_limit_block设为true;该**边界块(limit block)**相当于一个虚拟终止块。
从t3删除500行后的结果为:
第2号块被标记为边界块,相应的可见性映射(分支2)也以相同方式更新。由此可知,第2号与第3号数据块以及可见性映射的第2号块被移除,剩余的第0号与第1号块发生了修改。
4. 截断全部块
截断t4时,所有相关分支的边界块号都设为0,is_limit_block设为true:
执行DROP TABLE时也会得到同类结果。
5. 创建新表
创建新表时,汇总器先记录块号0并将is_limit_block设为true;后续插入再创建第0至第3号块,并把这些普通变更项的is_limit_block设为false:
9.7 PostgreSQL中的检查点过程
在PostgreSQL中,检查点进程(后台)会执行检查点;当下列情形之一发生时,它会启动处理:
- 距离上次检查点已经过去了由参数
checkpoint_timeout配置的时间间隔(默认间隔为300秒(5分钟))。 - 在9.4及以前的版本中,自上一次检查点以来消耗的WAL段文件超出了参数
checkpoint_segments的数量(默认值为3)。 - 在9.5及以后的版本,
pg_xlog(10之后是pg_wal)中的WAL段文件总大小超过参数max_wal_size配置的值(默认值为1GB,64个段文件)。 - PostgreSQL服务器以
smart或fast模式关闭。
当超级用户手动执行CHECKPOINT命令时,该进程也会启动。
在9.1或更早的版本中,后台写入进程(见8.6节)同时负责脏页写入与检查点。
在接下来的几个小节中会简要描述检查点过程与pg_control文件,pg_control文件保存了当前检查点的元数据。
9.7.1 检查点过程概述
检查点进程负责两个方面:为数据库恢复做准备工作,以及共享缓冲池上脏页的刷盘工作。在本小节介绍其内部过程时,将重点关注前一个方面。参见图9.13和以下描述。
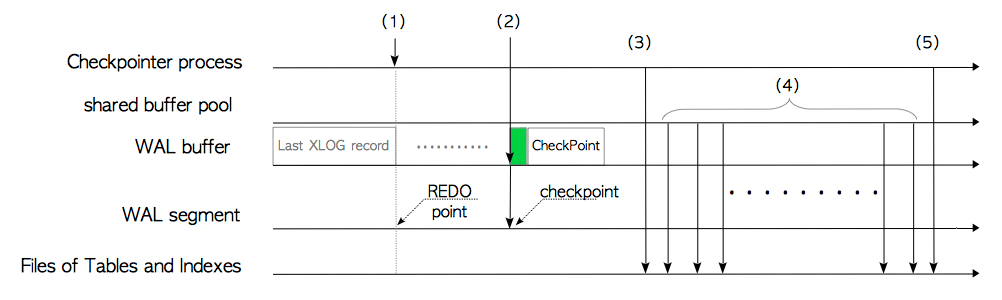
- 当检查点进程启动时,会将 重做点(REDO Point) 存储在内存中;重做点是上次检查点开始时刻时XLOG记录的写入位置,也是数据库恢复的开始位置。
- 该检查点相应的XLOG记录(即检查点记录)会被写入WAL缓冲区。记录的数据部分由
CheckPoint结构体定义,包含第一步中的重做点位置等变量。另外,写入检查点记录的位置称为检查点位置(checkpoint location)。 - 共享内存中的所有数据(例如,CLOG的内容)都会被刷入持久存储中。
- 共享缓冲池中的所有脏页都会被逐渐刷写到存储中。
- 更新
pg_control文件。该文件包含一些基础信息,例如上一次检查点的位置;后面会介绍该文件的细节。
让我们从数据库恢复的角度来总结上面的内容,检查点过程会创建包含重做点的检查点,并将检查点位置与其他信息存储到pg_control文件中。因此,PostgreSQL能够通过从重做点回放WAL数据来进行恢复(重做点是从检查点中获取的)。
9.7.2 pg_control文件
由于pg_control文件包含了检查点的基本信息,因此它对于数据库恢复肯定是必不可少的。如果它被破坏或不可读,因为系统不知道从哪里开始恢复,则恢复过程就无法启动。
尽管pg_control文件存储了40多条数据项,如下三个是接下来和我们讨论内容相关的:
- 状态(State) —— 最近检查点过程开始时数据库的状态,总共有七种状态:
start up表示系统正在启动,shut down表示系统被关机命令正常关闭,in production表示数据库正在运行,诸如此类。 - 最新检查点位置(Latest Checkpoint Location) —— 最新检查点的LSN位置
- 上次检查点位置(Prior Checkpoint Location)—— 前一个检查点的LSN位置,在版本11中已经弃用,细节如引文所示。
pg_control文件存储在数据目录中global子目录内;可以使用pg_controldata程序显示其内容。
PostgreSQL 11中移除了前一个检查点
PostgreSQL 11及后续版本只会存储包含最新检查点或更新版本的WAL段文件;将不会存储包含先前检查点的旧段文件,以减少用于在
pg_xlog(pg_wal)子目录下保存WAL段文件的磁盘空间。详细信息请参见相关提交说明。
9.8 PostgreSQL中的数据库恢复
PostgreSQL的恢复功能基于 重做日志(REDO log) 实现。如果数据库服务器崩溃,PostgreSQL通过从REDO点依序重放WAL段文件中的XLOG记录来恢复数据库集群。
在本节之前,我们已经多次讨论过数据库恢复,所以这里将会介绍两个与恢复有关,但尚未解释过的事情。
第一件事是PostgreSQL如何启动恢复过程。当PostgreSQL启动时,它首先读取pg_control文件。以下是从那时起恢复处理的细节。参见图9.14和以下描述。
- PostgreSQL在启动时读取
pg_control文件的所有项。如果state项是in production,PostgreSQL将进入恢复模式,因为这意味着数据库没有正常停止;如果是shut down,它就会进入正常的启动模式。 - PostgreSQL从合适的WAL段文件中读取最近的检查点,该记录的位置写在
pg_control文件中,并从该检查点中获得重做点。如果最新的检查点是无效的,PostgreSQL会读取前一个检查点。如果两个记录都不可读,它就会放弃自我恢复(注意在PostgreSQL 11中不会存储前一个检查点)。 - 使用合适的资源管理器按顺序读取并重放XLOG记录,从重做点开始,直到最新WAL段文件的最后位置。当遇到一条属于备份区块的XLOG记录时,无论其LSN如何,它都会覆写相应表的页面。其他情况下,只有当此记录的LSN大于相应页面的
pd_lsn时,才会重放该(非备份区块的)XLOG记录。
第二件事是关于LSN的比较:为什么应该比较非备份区块的LSN和相应页面的pd_lsn。与前面的示例不同,这里使用需要在两个LSN之间进行比较的具体例子来解释,如图9.15和图9.16。 (注意这里省略了WAL缓冲区,以简化描述)。
-
PostgreSQL将一条元组插入表A,并将一条XLOG记录写入
LSN_1。 -
后台写入者进程将表A的页面写入存储。此时,此页面的
pd_lsn为LSN_1。 -
PostgreSQL在表A中插入一条新元组,并在
LSN_2处写入一条XLOG记录。修改后的页面尚未写入存储。
与本章概述中的例子不同,在本场景中,表A的页面已经被一次性写入存储中。
使用immediate模式关闭数据库,然后启动数据库。
- PostgreSQL加载第一条XLOG记录和表A的页面,但不重放它,因为该记录的LSN不大于表A的LSN(两个值都是
LSN_1)。实际上一目了然,没有重放该记录的必要性。 - 接下来,PostgreSQL会重放第二条XLOG记录,因为该记录的LSN(
LSN_2)大于当前表A的LSN(LSN_1)。
从这个例子中可以看出,如果非备份区块的重放顺序不正确,或者多次重放非备份区块,数据库集群将不再一致。简而言之,非备份区块的重做(重放)操作不是 幂等(idempotent) 的。因此,为了确保正确的重放顺序,非备份区块中的记录当且仅当其LSN大于相应页面的pd_lsn时,才执行重放。
另一方面,由于备份区块的重放操作是幂等的,不管其LSN为何值,备份块可以重放任意次。
9.9 WAL段文件管理
PostgreSQL将XLOG记录写入pg_xlog子目录中的WAL段文件中(版本10之后是pg_wal子目录),当旧的段文件写满时就会切换至新的段文件。WAL文件的数量会根据几个配置参数的变化而变化,一些服务器的行为也会相应变化。此外,在9.5版中,段文件的管理机制也有了一些改善。
9.9.1 WAL段切换
当出现下列任一情况时,WAL段会发生切换:
- WAL段已经被填满。
- 函数
pg_switch_xlog()(10以后为pg_switch_wal())被调用。 - 启用了
archive_mode,且已经超过archive_timeout配置的时间。
被切换的文件通常会被回收(重命名或重用),以供未来之用。但如果不是需要的话,也可能会被移除。
9.9.2 WAL段管理(9.5版及以后)
每当检查点过程启动时,PostgreSQL都会估计并准备下一个检查点周期所需的WAL段文件数。这种估计基于前一个检查点周期中消耗的文件数量,即从包含上一个重做点的段文件开始计数,而这个值应当在min_wal_size(默认80MB,5个文件)与max_wal_size之间(默认1GB,64个文件)。如果检查点过程启动,必需的段文件会被保留或回收,而不必要的段文件会被移除。
一个具体的例子如图9.17所示,假设在检查点开始前有六个文件,WAL_3包含了上一个重做点(版本10及以前,版本11后就是当前重做点),PostgreSQL估计会需要五个文件,在这种情况下,WAL_1被重命名为WAL_7回收利用,而WAL_2会被移除。
任何比包含上一个重做点的段文件更老的段文件都可以被移除,因为按照9.8节中描述的恢复机制,这些文件永远不会再被使用。
如果出现了WAL活动尖峰,导致需要更多的文件,新的文件会被创建,而WAL文件的总大小是小于max_wal_size的。例如在图9.18中,如果WAL_7被填满,WAL_8就会被新创建出来。
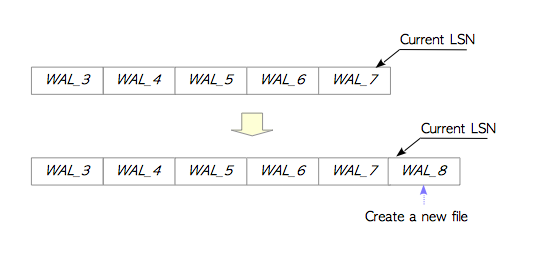
WAL文件的数量会根据服务器活动而自动适配。 如果WAL数据写入量持续增加,则WAL段文件的估计数量以及WAL文件的总大小也会逐渐增加。 在相反的情况下(即WAL数据写入量减少),这些值也会减少。
如果WAL文件的总大小超过max_wal_size,则将启动检查点。 图9.19说明了这种情况。 检查点将会创建一个新的重做点,最近的重做点将会变为上一个重做点,不是必需的文件将被回收。通过这种方式,PostgreSQL将始终只保留数据库恢复所必需的WAL段文件。
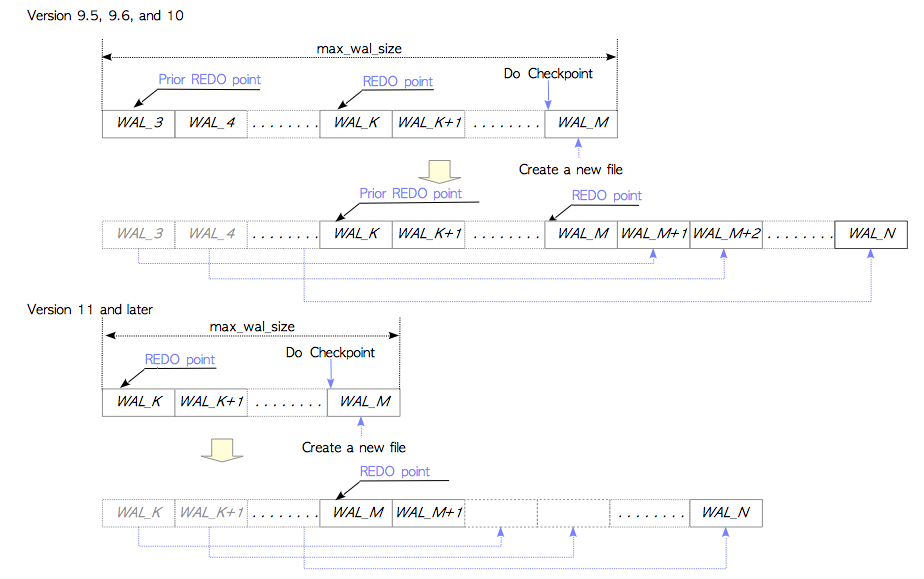
配置参数 wal_keep_segments 以及 复制槽(Replication Slot) 功能都会影响WAL段文件的数量。
9.9.3 WAL段管理(9.4版及以前)
WAL段文件的数量主要由下列三个参数控制:
checkpoint_segmentscheckpoint_completion_targetwal_keep_segments。
WAL段文件的数量通常会:
比 要大
比要大
且不超过个文件
WAL段文件具体数目的取决于不同的服务器活动,复制槽的存在也会影响WAL文件的数量。
如第9.7节中所提到的,当消耗了超过checkpoint_segments个数量的文件时,就会启动检查点过程。因此可以保证WAL段文件中总是包含至少两个重做点,因为文件的数量始终大于,对于由超时导致的检查点同样适用。PostgreSQL总是会保留足够用于恢复的WAL段文件(有时候会超出必需的量)。
在版本9.4或更早版本中,调整参数
checkpoint_segments是一个痛苦的问题。 如果设置为较小的值,则检查点会频繁发生,这会导致性能下降;而如果设置为较大的数值,则WAL文件总是需要巨大的磁盘空间,但其中一些空间不是必须的。在9.5版本中,WAL文件的管理策略得到了改善,而
checkpoint_segments参数被弃用,因此上述的权衡问题已经得到解决。
9.10 归档日志与持续归档
持续归档(continuous archiving)是当WAL段文件发生切换时会自动将其拷贝至归档区域的一项功能。持续归档是由归档后台进程执行的,拷贝的文件称为归档日志(archive log)。该功能通常用于物理备份与时间点恢复(参见第十章)。
归档区域的配置取决于参数archive_command。例如使用下列配置时,每当发生段文件切换,WAL段文件都会被拷贝到/home/postgres/archives目录下:
这里%p是被拷贝WAL段文件的路径占位符,而%f是归档日志文件名的占位符。
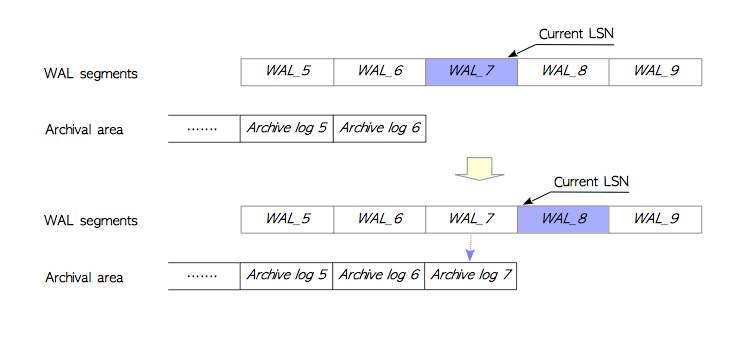
当WAL段文件WAL_7发生切换时,该文件被拷贝至归档区域,作为归档日志7。
archive_command参数可以配置为任意的Unix命令或程序,因此你也能用scp将归档日志发送到其他主机上,或使用任意的文件备份工具来替代普通的拷贝命令。
PostgreSQL并不会清理归档日志,所以在使用该功能时需要管理好这些日志。如果什么都不做,归档日志的数量会不断增长。
pg_archivecleanup工具是一个管理归档日志的实用工具。
10 基础备份与时间点恢复
在线数据库备份大致可分为两类:逻辑备份和物理备份。它们有着各自的优点和缺点。尽管各有优劣,但逻辑备份有一个缺点:执行需要花费太多时间。特别是对于大型数据库而言,需要花费很长时间进行备份,而从备份数据中恢复数据库可能需要更长的时间。相反的是,物理备份可以在相对较短的时间内备份和恢复大型数据库,因此在实际系统中,它是一个非常重要而实用的功能。
在PostgreSQL中,自8.0版本开始提供在线的全量物理备份,整个数据库集簇(即物理备份数据)的运行时快照称为基础备份(base backup)。
PostgreSQL还在8.0版中引入了时间点恢复(Point-In-Time Recovery, PITR)。这一功能可以将数据库恢复至任意时间点,这是通过使用一个基础备份和由持续归档生成的归档日志来实现的。例如,即使你犯了一个严重的错误(例如TRUNCATE所有的表),此功能使您可以将数据库恢复至错误发生之前的时刻。
本章描述了以下主题:
- 什么是基础备份
- PITR的工作原理
- 时间线标识(TimelineID)是什么
- 时间线历史文件是什么
- 增量备份的原理、创建方式与内部格式
在7.4或更早版本中,PostgreSQL仅支持逻辑备份(全量逻辑备份、部分逻辑备份,数据导出)。
10.1 基础备份
版本说明: PostgreSQL 15起使用
pg_backup_start()与pg_backup_stop();PostgreSQL 14及以前的名称分别为pg_start_backup()与pg_stop_backup()。下面的历史译文保留旧名称,新增部分使用当前内部函数名称。
首先,使用底层命令进行基本备份的标准过程如下所示:
-
发出
pg_start_backup命令 -
使用你想用的归档命令获取数据库集簇的快照
-
发出
pg_stop_backup命令
这个简单的过程对于DBA来说很容易操作,因为它不需要特殊工具,只需要常用工具(如复制命令或类似的归档工具)来创建基本备份。此外,在此过程中,不需要获取表上的锁,所有用户都可以在不受备份操作影响的情况下发起查询。相对于其他开源关系型数据库,这是一个巨大的优势。
更简单的方式是使用pg_basebackup命令来做基础备份,不过在它内部也是使用这些底层命令来工作的。
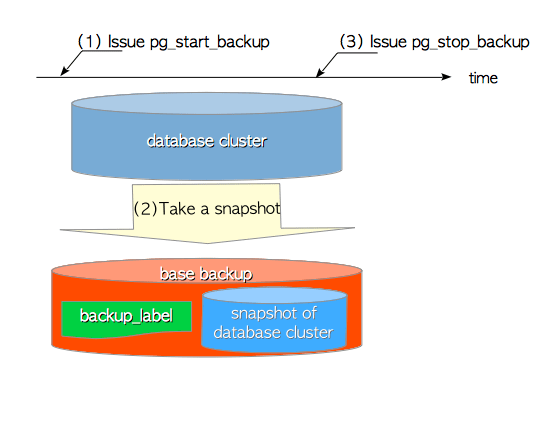
由于这些命令对显然是理解PITR的关键点之一,我们将在以下小节中探讨它们。
pg_start_backup和pg_stop_backup命令定义在:src/backend/access/transam/xlogfuncs.c。
10.1.1 pg_start_backup
pg_start_backup开始为制作基础备份进行准备工作。如第9.8节所述,恢复过程从重做点开始,因此pg_start_backup必须执行检查点,以便在制作基础备份的开始时刻显式创建一个重做点。此外,这次检查点的位置必须保存在不同于pg_control的其他文件中,因为在备份期间可能会进行多次常规检查点。因此pg_start_backup执行下列四个操作:
- 强制进入整页写入模式。
- 切换到当前的WAL段文件(8.4或更高版本)。
- 执行检查点。
- 创建
backup_label文件 —— 该文件创建于基本目录顶层中,包含有关该基本备份本身的关键信息,例如检查点位置。
第三和第四个操作是该命令的核心。第一和第二个操作是为了更可靠地恢复数据库集簇。
备份标签backup_label文件包含以下六个项目(11或更新版本为七个项目):
- 检查点位置(
CHECKPOINT LOCATION) —— 该命令所创建检查点的LSN位置。 - WAL开始位置(
START WAL LOCATION) —— 这不是给PITR用的,而是为第11章描述的流复制准备的。它被命名为START WAL LOCATION,因为复制模式下的备用服务器在初始启动时只读取一次该值。 - 备份方法(
BACKUP METHOD) —— 这是用于进行此基本备份的方法。 (pg_start_backup或pg_basebackup) - 备份来源(
BACKUP FROM) —— 说明此备份是从主库还是备库拉取。 - 开始时间(
START TIME)—— 这是执行pg_start_backup时的时间戳。 - 备份标签(
LABEL) —— 这是pg_start_backup中指定的标签。 - 开始时间线(
START TIMELINE) —— 这是备份开始的时间线。这是为了进行正常性检查,在版本11中被引入。
备份标签
一个9.6版本中备份标签的实际例子如下所示:
可以想象,当使用此基础备份恢复数据库时,PostgreSQL从backup_label文件中取出检查点位置CHECKPOINT LOCATION,然后从归档日志中的合适位置读取检查点记录,然后从检查点记录中获取重做点的位置,最后从重做点开始进行恢复过程(下一节将介绍细节)。
10.1.2 pg_stop_backup
pg_stop_backup执行以下五个操作以完成备份。
- 如果
pg_start_backup打开了整页写入,那么关闭整页写入。 - 写入一条备份结束的XLOG记录。
- 切换WAL段文件。
- 创建一个备份历史记录文件 —— 此文件包含
backup_label文件的内容,以及已执行pg_stop_backup的时间戳。 - 删除
backup_label文件 —— 从基础备份恢复需要backup_label文件,不过一旦被复制,原始的数据库集簇中就不需要它了。
备份历史文件的命名方法如下所示:
10.1.3 pg_basebackup
pg_basebackup是创建在线备份的工具。PostgreSQL 16及以前只支持整个数据库集簇的全量备份;PostgreSQL 17又增加了第10.5节介绍的增量备份。
执行远程备份时,pg_basebackup使用第11章介绍的walsender进程。例如,下面的命令从主机192.168.1.10创建一份全量备份,并保存至本地目录/usr/local/pgsql/backup/full:
图10.1-1展示了pg_basebackup创建全量备份的处理序列。该图对应新版英文原著的图10.2;为避免与中文旧译本已有的图10.2冲突,这里采用补充编号。
- 连接请求:
pg_basebackup请求连接PostgreSQL服务器上的walsender。 - 创建walsender进程: 服务器创建walsender并建立连接。
- 基础备份请求:
pg_basebackup请求备份。 - 执行
do_pg_backup_start(): walsender调用该函数。 - 发送全部文件: walsender发送数据库集簇中的所有文件,但暂不发送
pg_wal中的WAL文件。 - 执行
do_pg_backup_stop(): walsender调用该函数。 - 发送WAL文件: 如果
--wal-method不是none,walsender发送pg_wal中的WAL文件。 - 发送
backup_manifest: walsender创建并发送备份清单。
第5步暂不发送WAL,是为了让pg_basebackup在最后取得完整的WAL段;第6步中的do_pg_backup_stop()会切换当前WAL段,确保备份期间生成的所有WAL都已刷入pg_wal目录。
为什么使用walsender?
pg_basebackup并不直接执行复制,但开发该工具时,可以接受外部程序连接的进程只有postgres与walsender,因此项目扩展了walsender协议来支持基础备份。
10.1.3.1 备份清单文件
备份清单是一个JSON文件,包含备份的元数据与校验信息。主要字段如下:
| 字段 | 含义 |
|---|---|
PostgreSQL-Backup-Manifest-Version |
备份清单格式版本。 |
System-Identifier |
数据库集簇的系统标识。 |
Files |
所有备份文件的路径、大小、修改时间、校验算法及校验值。 |
WAL-Ranges |
备份期间的时间线与LSN范围;Start-LSN是do_pg_backup_start()触发检查点所生成的重做点,End-LSN是do_pg_backup_stop()生成WAL记录的LSN。 |
Manifest-Checksum |
清单文件自身的校验值。 |
备份清单示例如下:
10.2 时间点恢复(PITR)的工作原理
图10.2展示了PITR的基本概念。 PITR模式下的PostgreSQL会在基础备份上重放归档日志中的WAL数据,从pg_start_backup创建的重做点开始,恢复至你想要的位置为止。在PostgreSQL中,要恢复到的位置,被称为恢复目标(recovery target)。
PITR是这样工作的。假设你在GMT时间2018-07-16 12:05:00进行了误操作。你应该删除当前的数据库集簇,并使用之前制作的基础备份恢复一个新的集簇。然后创建recovery.conf文件,将参数recovery_target_time配置为误操作发生的时间点(在本例中,也就是12:05 GMT)。recovery.conf文件如下所示:
当PostgreSQL启动的时候,如果数据库集簇中存在recovery.conf和backup_label文件,它就会进入恢复模式。
PITR过程几乎与第九章中描述的常规恢复过程一模一样,唯一的区别只有以下两点:
- 从哪里读取WAL段/归档日志?
- 正常恢复模式 —— 来自基础目录下的
pg_xlog子目录(10或更新版本,pg_wal子目录)。 - PITR模式 —— 来自配置参数
archive_command中设置的归档目录。
- 正常恢复模式 —— 来自基础目录下的
- 从哪里读取检查点位置?
- 正常恢复模式 —— 来自
pg_control文件。 - PITR模式 —— 来自
backup_label文件。
- 正常恢复模式 —— 来自
PITR流程概述如下:
-
为了找到重做点,PostgreSQL使用内部函数
read_backup_label从backup_label文件中读取CHECKPOINT LOCATION的值。 -
PostgreSQL从
recovery.conf中读取一些参数值;在此示例中为restore_command和recovery_target_time。 -
PostgreSQL开始从重做点重放WAL数据,重做点的位置可以简单地从
CHECKPOINT LOCATION的值中获得。 PostgreSQL执行参数restore_command中配置的命令,将归档日志从归档区域拷贝到临时区域,并从中读取WAL数据(复制到临时区域中的日志文件会在使用后删除)。在本例中,PostgreSQL从重做点读取并重放WAL数据,直到时间戳
2018-7-16 12:05:00为止,因为参数recovery_target_time被设置为该时间戳。如果recovery.conf中没有配置恢复目标,则PostgreSQL将重放至归档日志的末尾。 -
当恢复过程完成时,会在
pg_xlog子目录(10或更高版本为pg_wal子目录)中创建时间线历史文件,例如00000002.history;如果启用了日志归档功能,则还会在归档目录中创建相同的命名文件。以下各节介绍了此文件的内容和作用。
提交和中止操作的记录包含每个操作完成时的时间戳(两个操作的XLOG数据部分分别在xl_xact_commit和xl_xact_abort中定义)。因此,如果将目标时间设置为参数recovery_target_time,只要PostgreSQL重放提交或中止操作的XLOG记录,它可以选择是否继续恢复。当重放每个动作的XLOG记录时,PostgreSQL会比较目标时间和记录中写入的每个时间戳;如果时间戳超过目标时间,PITR过程将完成。
函数
read_backup_label定义于src/backend/access/transam/xlog.c中。 结构xl_xact_commit和xl_xact_abort定义于src/backend/access/transam/xlog.c。
为什么可以用一般归档工具做基础备份?
尽管数据库集簇可能是不一致的,但恢复过程是使数据库集簇达成一致状态的过程。由于PITR是基于恢复过程的,所以即使基础备份是一堆不一致的文件,它也可以恢复数据库集簇。因此我们可以在没有文件系统快照功能,或其他特殊工具的情况下,使用一般归档工具做基础备份。
10.3 时间线与时间线历史文件
PostgreSQL中的时间线用于区分原始数据库集簇和恢复生成的数据库集簇,它是PITR的核心概念。在本节中,描述了与时间线相关的两件事:时间线标识(TimelineID),以及时间线历史文件(Timeline History Files)。
10.3.1 时间线标识(TimelineID)
每个时间线都有一个相应的时间线标识,一个四字节的无符号整型,从1开始计数。
每个数据库集簇都会被指定一个时间线标识。由initdb命令创建的原始数据库集簇,其时间线标识为1。每当数据库集簇恢复时,时间线标识都会增加1。例如在前一节的例子中,从原始集簇中恢复得到的集簇,其时间线标识为2。
图10.3从时间线标识的角度展示了PITR过程。首先,我们删除当前的数据库集簇,并替换为过去的基础备份,以便返回到恢复的起始点,这一步在图中用红色曲线箭头标识。接下来,我们启动PostgreSQL服务器,它通过跟踪初始时间线(时间线标识1),从pg_start_backup创建的重做点开始,重放归档日志中的WAL数据,直到恢复目标达成,这一步在图中用蓝色直线箭头标识。接下来,恢复得到的数据库集簇将被分配一个新的时间线标识2,而PostgreSQL将运行在新的时间线上。
正如第九章中简要提到的,WAL段文件名的前8位数字等于创建这些段文件的数据库集簇的时间线标识。当时间线标识发生变化时,WAL段文件名也会相应改变。
让我们从WAL段文件的角度重新审视恢复过程。假设我们使用两个归档日志文件来恢复数据库:
,以及 。新恢复得到的数据库集簇被分配了时间线标识2,而PostgreSQL就会从 开始创建WAL段。如图10.4所示。
10.3.2 时间线历史文件
当PITR过程完成时,会在归档目录和pg_xlog子目录(10或更高版本为pg_wal子目录)下创建名称为00000002.history的时间线历史文件。该文件记录了当前时间线是从哪条时间线分叉出来的,以及分叉的时间。
该文件的命名规则如下所示:
时间线历史文件至少包含一行,每行由以下三项组成:
- 时间线标识 —— 曾用于恢复的归档日志的时间线。
- LSN —— 发生WAL段切换的LSN位置。
- 原因 —— 可读的时间线发生变化的原因解释。
具体示例如下所示:
含义如下:
数据库集簇(时间线标识为2)基于时间线标识为1的基础备份,并在
2018-7-9 12:05:00.861324+00之前,通过重放检查点日志,恢复至0/A000198的位置。
通过这种方式,每个时间线历史文件都会告诉我们每个恢复所得的数据库集簇的完整历史,而且它也会在PITR过程中使用。下一节将描述具体细节。
时间线历史文件的格式在9.3版本中发生变化。9.3前后的格式如下所示,但相对简略。
9.3及后续版本:
9.2及先前版本
10.4 时间点恢复与时间线历史文件
时间线历史文件在第二次及后续PITR过程中起着重要作用。通过尝试第二次恢复,我们将探索如何使用它。
同样,假设您在12:15:00又犯了一个错误,错误发生在时间线ID为2的数据库集簇上。在这种情况下为了恢复数据库集簇,你需要创建一个如下所示的recovery.conf文件:
参数recovery_target_time被设置为您犯下新错误的时间,而recovery_target_timeline被设置为2,以便沿着这条时间线恢复。
重启PostgreSQL服务器并进入PITR模式,数据库会沿着时间线标识2进行恢复。如图10.5所示。
-
PostgreSQL从
backup_label文件中读取CHECKPOINT LOCATION的值。 -
从
recovery.conf中读取一些参数值;在此示例中为restore_command,recovery_target_time和recovery_target_timeline。 -
PostgreSQL读取时间线历史文件
00000002.history,该文件对应参数recovery_target_timeline的值。 -
PostgreSQL通过以下步骤重放WAL数据:
- 对于从重做点到
LSN 0/A000198(该值写在00000002.history文件中)之间的WAL数据,PostgreSQL会(从合适的归档日志中)读取并重放TimelineID=1的WAL数据。 - 对于从
LSN 0/A000198,到时间戳2018-7-9 12:15:00之间的WAL数据,PostgreSQL会(从合适的归档日志中)读取并重放TimelineID=2的WAL数据。
- 对于从重做点到
-
当恢复过程完成时,当前的时间线标识将增加到3,并在
pg_xlog子目录(10及后续版本为pg_wal子目录)和归档目录中创建名为00000003.history的新时间线历史文件。
当你进行过超过一次的PITR时,应明确设置时间线标识,以便使用合适的时间线历史文件。
因此,时间线历史文件不仅仅是数据库集簇的历史日志,还是PITR过程的参考恢复指令。
10.5 增量备份
定期备份对于系统的正常运行至关重要。然而,保留多份全量备份会占用大量存储空间。
为解决这个问题,PostgreSQL 17(2024年)引入了增量备份。增量备份只保存相较于前一份备份发生过变化的文件部分。
以下小节将介绍增量备份的整体原理、使用pg_basebackup创建增量备份的过程,以及增量备份的内部数据格式。
10.5.1 增量备份概述
10.5.1.1 创建增量备份
增量备份依赖一份全量备份和若干WAL汇总文件。这些汇总文件由第9.6.2节介绍的WAL汇总器进程生成。下面从最初的全量备份开始说明。
-
创建全量备份: 执行
do_pg_backup_start()后创建一份全量备份,其中包含所有关系文件。假设这份全量备份的重做点为。 -
跟踪变更: WAL汇总器进程跟踪所有数据库块的变更,并将这些修改写入WAL汇总文件。
-
创建增量备份: 假设本次增量备份的重做点为。PostgreSQL利用与之间生成的汇总文件,只保存发生过变化的块,而不是保存完整的关系文件。
这个过程有两点需要注意:
- 关系文件和可见性映射(VM)文件会以增量备份文件的形式保存,而空闲空间映射(FSM)文件始终会被完整备份。这是因为WAL汇总器不会跟踪FSM分支。
- 如果某个关系是在前一份备份之后创建的,系统会备份整个关系文件。
增量备份文件采用以下命名规则:
- 关系文件:
INCREMENTAL.{oid} - 可见性映射:
INCREMENTAL.{oid}_vm
例如,表t1的OID为16551,那么它对应的增量备份文件名就是INCREMENTAL.16551。
下面的例子展示了表t1的全量备份文件与增量备份文件:
10.5.1.2 重构备份
PostgreSQL提供了pg_combinebackup工具,用于将增量备份及其所依赖的备份重构为一份基础备份。
假设全量备份位于/usr/local/pgsql/backup/full,增量备份位于/usr/local/pgsql/backup/inc01,可以先用以下命令检查将其重构至/usr/local/pgsql/reconstructed的过程:
译者注:
-n(--dry-run)只会演练重构过程,并不会写出备份。若要真正生成/usr/local/pgsql/reconstructed,应去掉-n选项。
图10.8展示了pg_combinebackup重构基础备份的方式。简而言之,pg_combinebackup会把增量备份文件中记录的块变更应用到原始关系文件上。
例如,全量备份中包含表t1的关系文件16551,增量备份中包含INCREMENTAL.16551,那么pg_combinebackup会使用增量文件中的变更块(例如第0号块和第3号块)覆盖原始的16551文件。
10.5.2 如何创建增量备份
创建增量备份时,需要使用--incremental选项,并在其后指定前一份备份的清单文件路径。
例如,若要以前一份位于/usr/local/pgsql/backup/full的全量备份为基准,从主机192.168.1.10创建一份增量备份,并将其保存至本地目录/usr/local/pgsql/backup/inc01,可以执行:
图10.9展示了pg_basebackup以增量备份模式运行时的处理序列。
- 连接请求
- 创建walsender进程
- 发送备份清单文件:
pg_basebackup发送前一份备份的backup_manifest文件。 - 初始化增量备份参数:
walsender进程调用
FinalizeIncrementalManifest(),从前一份备份的清单文件中取得时间线与起始LSN。 - 请求基础备份
- 执行
do_pg_backup_start() - 识别变更块:
walsender进程调用
PrepareForIncrementalBackup(),生成所有已变更关系块的列表。它会分析从起始LSN(第4步取得)到最新重做点(第6步生成)之间的汇总文件,从中识别这些变更。 - 发送
INCREMENTAL文件: walsender进程发送增量备份文件,而不是完整的关系文件和可见性映射文件。这些增量文件由一个首部块和若干变更块组成,具体内容由第7步生成的列表决定。 - 执行
do_pg_backup_stop() - 发送WAL文件
- 发送
backup_manifest文件
在第8步中,如果某个关系是在前一份备份之后创建的,walsender会发送完整的关系文件。
若要继续创建下一份增量备份,可以再次执行pg_basebackup,并让--incremental指向前一份增量备份的清单文件:
10.5.3 INCREMENTAL文件的格式
一个INCREMENTAL文件通常由一个首部块和若干变更块组成,每个块的大小都是8 KB。
首部块包含四类信息:
- 魔数(Magic Number): 首部以
0xd3ae1f0d开头,用于标识这是一个增量备份文件。 num_incremental_block: 变更块的数量。truncation_block_length: 该值通常表示此文件所对应表或可见性映射的当前块数;如果WAL汇总信息记录了更靠后的边界块,它也可能大于文件的当前块数,详情参见源代码。- 变更块编号列表: 保存发生过变化的块编号。例如,如果第0号块和第3号块发生了变化,这里就会记录
0和3。
首部块通常为8 KB,或者是8 KB的整数倍。PostgreSQL会在块编号列表之后补零,使首部保持8 KB对齐;如果列表超过8 KB,则会增加额外的首部块。
如果一张表被截断、删除或没有发生变化,增量文件可能不需要携带任何变更块。此时num_incremental_block为0,整个INCREMENTAL文件只有12字节,只包含魔数、num_incremental_block和truncation_block_length三个字段;truncation_block_length记录重构后文件的截断边界,在图10.11的表t4示例中其值为1。
图10.11展示了四种INCREMENTAL文件的例子,对应的WAL汇总文件内容详见第9.6.2.2节。
11 流复制
PostgreSQL在9.1版本中实现了流复制。它属于所谓的一主多从类型的复制,而这两个术语 —— 主(master)和从(slave),在PostgreSQL中通常分别被称为主(primary)和备(standby)。
译注:存储数据库副本的每个节点称为副本(replica)。每一次对数据库的写入操作都需要传播到所有副本上,否则副本就会包含不一样的数据。最常见的解决方案被称为基于领导者的复制(leader-based replication),也称主动/被动(active/passive) 或 主/从(master/slave)复制。其中,副本之一被指定为领导者(leader),也称为 主库(master)、首要(primary)。当客户端要向数据库写入时,它必须将请求发送给领导者,领导者会将新数据写入其本地存储。其他副本被称为追随者(followers),亦称为只读副本(read replicas)、从库(slaves)、次要(secondaries)或热备(hot standby)。
这种原生复制功能是基于日志传输实现的,这是一种通用的复制技术:主库不断发送WAL数据,而每个备库接受WAL数据,并立即重放日志。
本章将介绍以下主题,重点介绍流复制的工作原理:
- 流复制是如何启动的
- 数据是如何在主备之间传递的
- 主库如何管理多个备库
- 主库如何检测到备库的失效
- 复制槽如何保留流复制所需的WAL
尽管在9.0版本中最初实现的复制功能只能进行异步复制,它很快就在9.1版中被新的实现(如今采用的)所替代,可以支持同步复制。
11.1 流复制的启动
在流复制中,有三种进程协同工作。首先,主库上的walsender(WAL发送器)进程将WAL数据发送到备库;同时,备库上的walreceiver(WAL接收器)在接收这些数据,而备库上的startup进程可以重放这些数据。 其中walsender和walreceiver 之间使用单条TCP连接进行通信。
在本节中,我们将探讨流复制的启动顺序,以了解这些进程如何启动并且它们之间是如何建立连接的。图11.1显示了流复制的启动顺序图:
- 启动主库服务器和备库服务器。
- 备库服务器启动一个startup进程。
- 备库服务器启动一个walreceiver进程。
- walreceiver向主库服务器发送连接请求。如果主库尚未启动,walreceiver会定期重发该请求。
- 当主库服务器收到连接请求时,将启动walsender进程,并建立walsender和walreceiver之间的TCP连接。
- walreceiver发送备库数据库集簇上最新的LSN。在IT领域中通常将该阶段称作握手(handshaking)。
- 如果备库最新的LSN小于主库最新的LSN(备库的LSN < 主库的LSN),则walsender会将前一个LSN到后一个LSN之间的WAL数据发送到walreceiver。这些WAL数据由存储在主库
pg_xlog子目录(版本号为10+的更名为pg_wal)中的WAL段提供。最终,备库重放接收到的WAL数据。在这一阶段,备库在追赶主库,因此被称为 追赶(catch-up) 阶段。 - 最终,流复制开始工作。
每个walsender进程都维护了连接上的walreceiver或其他应用程序的复制进度状态(请注意,不是连接到walsender的walreceiver或应用程序的本身的状态)。如下是其可能的状态:
- 启动(start-up) —— 从启动walsender到握手结束。如图11.1(5)-(6)。
- 追赶(catch-up) —— 处于追赶期间,如图11.1(7)。
- 流复制(streaming)—— 正在运行流复制。如图11.1(8)。
- 备份(backup)—— 处于向
pg_basebackup等备份工具发送整个数据库集簇文件的过程中。
系统视图pg_stat_replication显示了所有正在运行的walsenders的状态,如下例所示:
如上结果所示,有两个walsender正在运行,其正在向连接的备库发送WAL数据,另一个walsender在向pg_basebackup应用发送所有数据库集簇中的文件。
在备库长时间停机后,如果重启会发生什么?
在9.3版及更早版本中,如果备库所需的WAL段在主库上已经被回收了,备库就无法追上主库了。这一问题并没有可靠的解决方案,只能为参数
wal_keep_segments配置一个较大的值,以减少这种情况发生的可能性,但这只是权宜之计。在9.4及后续版本中,可以使用 复制槽(replication slot) 来预防此问题发生。复制槽是一项提高WAL数据发送灵活性的功能,主要是为 逻辑复制(logical replication) 而提出的,同时也能解决这类问题——复制槽通过暂停回收过程,从而保留
pg_xlog(10及后续版本的pg_wal)中含有未发送数据的WAL段文件,详情请参阅官方文档。
11.2 如何实施流复制
流复制有两个方面:日志传输和数据库同步。因为流复制基于日志,日志传送显然是其中的一个方面 —— 主库会在写入日志记录时,将WAL数据发送到连接的备库。同步复制中需要数据库同步 —— 主库与多个备库通信,从而同步整个数据库集簇。
为准确理解流复制的工作原理,我们应该探究下主库如何管理多个备库。为了尽可能简化问题,本节描述了一个特例(即单主单备系统),而下一节将描述一般情况(单主多备系统)。
11.2.1 主从间的通信
假设备库处于同步复制模式,但配置参数hot_standby已禁用,且wal_level为'archive'。主库的主要参数如下所示:
另外,在9.5节中提到,有三个情况触发写WAL数据,这里我们只关注事务提交。
假设主库上的一个后端进程在自动提交模式下发出一个简单的INSERT语句。后端启动事务,发出INSERT语句,然后立即提交事务。让我们进一步探讨此提交操作如何完成的。如图11.2中的序列图:
- 后端进程通过执行函数
XLogInsert()和XLogFlush(),将WAL数据写入并刷新到WAL段文件中。 - walsender进程将写入WAL段文件的WAL数据发送到walreceiver进程。
- 在发送WAL数据之后,后端进程继续等待来自备库的ACK响应。更确切地说,后端进程通过执行内部函数
SyncRepWaitForLSN()来获取锁存器(latch),并等待它被释放。 - 备库上的walreceiver通过
write()系统调用,将接收到的WAL数据写入备库的WAL段,并向walsender返回ACK响应。 - walreceiver通过系统调用(例如
fsync())将WAL数据刷新到WAL段中,向walsender返回另一个ACK响应,并通知 启动进程(startup process ) 相关WAL数据的更新。 - 启动进程重放已写入WAL段的WAL数据。
- walsender在收到来自walreceiver的ACK响应后释放后端进程的锁存器,然后,后端进程完成
commit或abort动作。 锁存器释放的时间取决于参数synchronous_commit。如果它是'on'(默认),当接收到步骤(5)的ACK时,锁存器被释放。而当它是'remote_write'时,接收到步骤(4)的ACK时,即被释放。
如果配置参数
wal_level是'hot_standby'或'logical',则PostgreSQL会根据COMMIT或ABORT操作的记录,写入热备功能相关的WAL记录。(在这个例子中,PostgreSQL不写那些记录,因为它是'archive'。)
每个ACK响应将备库的内部信息通知给主库。包含以下四个项目:
- 已写入最新WAL数据的LSN位置。
- 已刷新最新WAL数据的LSN位置。
- 启动进程已经重放最新的WAL数据的LSN。
- 发送此响应的时间戳。
walreceiver不仅在写入和刷新WAL数据时返回ACK响应,而且还定期发送备库的心跳响应。因此,主库始终掌握所有连接备库的状态。
执行如下查询,可以显示所连接备库的相关LSN信息。
心跳的间隔设置为参数
wal_receiver_status_interval,默认为10秒。
11.2.2 备库故障检测
流复制使用两种常见的故障检测过程,不需要任何特殊硬件。
- 备库服务器失效: 当检测到walsender与walreceiver之间的连接断开,或者底层网络函数无法读写walreceiver套接字并返回错误时,主库会立即判定备库或walreceiver失效。
- 硬件或网络失效: 如果walreceiver在
wal_sender_timeout所规定的时间内没有返回任何结果,主库就会判定备库失效。默认超时为60秒,因此从故障发生到被确认之间最多可能存在这一长度的延迟。
取决于故障类型,有些故障能够立即发现,有些则存在检测延迟。如果同步备库发生后一类故障,即使还有多个潜在备库正常工作,主库也会在确认故障前暂停事务处理。
PostgreSQL 9.2及更早版本中,
wal_sender_timeout参数名为replication_timeout。
11.2.3 发生故障时的行为
在本小节中,将介绍在同步备库发生故障时,主库的行为方式,以及主库会如何处理该情况。
即使同步备库发生故障,且不再能够返回ACK响应,主库也会继续等待响应。因此,正在运行的事务无法提交,而后续查询也无法启动。换而言之,实际上主库的所有操作都已停止(流复制不支持发生超时时自动降级回滚到异步模式的功能)。
有两种方法可以避免这种情况。其中之一是使用多个备库来提高系统可用性,另一个是通过手动执行以下步骤从同步模式切换到异步模式。
-
将参数
synchronous_standby_names的值设置为空字符串。 -
使用
reload选项执行pg_ctl命令。
上述过程不会影响连接的客户端。主库继续事务处理,以及会保持客户端与相应的后端进程之间的所有会话。
11.2.4 备库查询与WAL重放冲突
备库可以独立执行SELECT,但某些主库操作产生的WAL与备库查询之间会发生冲突。例如,主库删除一张备库正在读取的表。
-
备库正在查询一张表。
-
主库执行
DROP TABLE并发送相关WAL。 -
备库暂缓重放,默认最多等待30秒,由
max_standby_archive_delay或max_standby_streaming_delay配置。 -
指定时间内查询仍未结束,就取消查询并返回:
冲突来自主库DROP TABLE获取AccessExclusiveLock时生成的WAL。恢复冲突主要包括三类:主库上的访问独占锁;删除数据库或表空间;重放VACUUM清理记录时,备库事务仍能看到将被删除的行,或仍在访问相应页面。
11.2.4.1 缓解锁冲突
提高max_standby_archive_delay和max_standby_streaming_delay可以让备库延迟WAL重放,降低查询被取消的概率,但不能彻底消除冲突;等待期间其他备库会话也看不到最新数据,因此需要在查询可用性与复制延迟之间权衡。
11.2.4.2 避免VACUUM冲突
在主库开启hot_standby_feedback,可以根据备库反馈延迟删除备库仍需要的旧行版本。反馈间隔由wal_receiver_status_interval控制,默认10秒。
代价是主库无法及时清理旧元组,可能增加表与索引膨胀及WAL使用。备库可通过pg_stat_database_conflicts查看冲突类型与次数。
11.3 管理多个备库
本节描述了存在多个备库时,流复制是如何工作的。
11.3.1 同步优先级与同步状态
主库为自己管理的每一个备库指定一个同步优先级(sync_priority) 与 同步状态(sync_state)。(上一节并没有提到这一点,即使主库只管理一个备库,也会指定这些值。)
同步优先级(sync_priority) 表示备库在同步模式下的优先级,它是一个固定值。较小的值表示较高的优先级,而0是一个特殊值,表示“异步模式”。备库优先级是一个有序列表,在主库配置参数 synchronous_standby_names中依序给出。例如在以下配置中,standby1和standby2的优先级分别为1和2。
(未列于此参数中的备库处于异步模式,优先级为0)
同步状态(sync_state) 是备库的状态,它因所有在列备库的运行状态及其优先级而异,以下是可能的状态:
- 同步(Sync) 状态的备库,是所有正在工作中的备库中,具有最高优先级的同步备库的状态(异步模式除外)。
- 潜在(Potential) 状态的备库,是所有工作备库(异步备库除外)中,优先级等于或低于2的闲置同步备库。如果同步备库失效,潜在备库中有着最高优先级的那个将替换为同步备库。
- 异步(Async) 状态的备库是固定的。主库以与潜在备库相同的方式处理异步备库,只是它们的
sync_state永远不会是sync或potential。
执行以下查询来显示备库的优先级和状态:
最近有几个开发者尝试实现“多个同步备库”。详情参见此处。
11.3.2 主库如何管理多个备库
主库仅等待来自同步备库的ACK响应。换句话说,主库仅确保同步备库写入并刷新WAL数据。因此在流复制中,只有同步备库的状态是与主库始终一致且同步的。
图11.3展示了潜在备库的ACK响应早于首要备库ACK响应的情况。这时主库并不会完成当前事务的COMMIT操作,而是继续等待首要备库的ACK响应。而当收到首要备库的响应时,后端进程释放锁存器并完成当前事务的处理。
备库1与备库2的同步状态分别为
sync和potential。
- 尽管从潜在备库接收到ACK响应,但主库的后端进程会继续等待来自同步备库的ACK响应。
- 主库的后端进程释放锁存器,完成当前的事务处理。
在相反的情况下(即首要从库的ACK响应返回早于潜在从库的响应),主库会立即完成当前事务的COMMIT操作,而不会去确认潜在从库是否已经写入和刷盘了WAL数据。
11.3.2.1 基于法定人数的同步复制
PostgreSQL 9.6开始支持同时等待多个按优先级选择的同步备库;PostgreSQL 10进一步加入ANY关键字,形成真正不依赖列表顺序的法定人数(quorum)提交。当前语法分为ANY与FIRST两种模式。
ANY模式
列表中任意num_sync个备库返回ACK后即可提交。例如:
这些备库的sync_state均为quorum,sync_priority相同。
FIRST模式
主库等待列表中优先级最高的前num_sync个备库。例如:
即使standby3先返回,主库仍要等待standby1和standby2。
11.3.3 发生故障时的行为
我们再来看看当从库发生故障时主库的表现。
当潜在或异步备库发生故障时,主库会终止连接到故障备库的walsender进程,并继续进行所有处理。换而言之,主库上的事务处理不会受到这两种备库的影响。
当同步备库发生故障时,主库将终止连接到故障备库的walsender进程,并使用具有最高优先级的潜在备库替换首要同步备库,如图11.4。与上述的故障相反,主库将会暂停从失效点到成功替换同步备库之间的查询处理。(因此备库的故障检测对于提高复制系统可用性至关重要,故障检测将在下一节介绍)
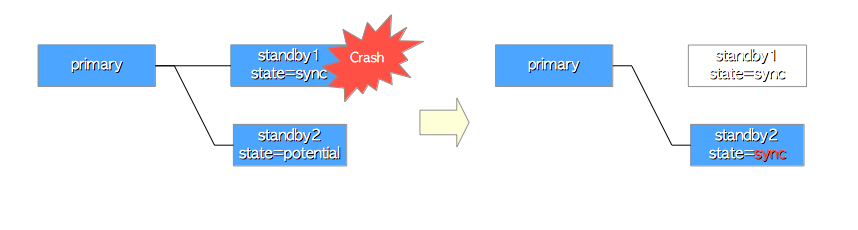
在任何情况下,如果一个或多个备库在同步模式下运行,主库始终只会保留一个同步备库,而同步备库始终与主库保持一致且同步的状态。
11.4 复制槽
如第11.1节所述,PostgreSQL 9.4引入的**复制槽(replication slot)**可以确保复制完成之前,仍然需要的WAL段和旧元组版本不会被清理。本节介绍复制槽在物理流复制中的机制;复制槽也是逻辑复制的基础,但逻辑场景将在第12章讨论。
11.4.1 复制槽在流复制中的优势
流复制并不强制要求复制槽,但与只使用wal_keep_size相比,它有两个优势:
- 保证所需WAL段不丢失: 复制槽跟踪备库仍然需要的WAL并阻止其被删除。只配置
wal_keep_size时,如果备库长时间未读取,PostgreSQL仍可能删除它后来需要的段。 - 只保留最低必要数量: 复制槽让
pg_wal只保留确实需要的段,并删除无用段;wal_keep_size则无论是否需要,都固定保留指定容量。
max_slot_wal_keep_size: 复制槽可能无限期保留WAL,最坏情况下会耗尽存储空间。PostgreSQL 13增加了max_slot_wal_keep_size,限制检查点时复制槽允许在pg_wal中保留的最大WAL容量。它与wal_keep_size的区别在于:前者是“按需保留,但设置上限”,后者是“无论是否需要,固定保留”。
11.4.2 复制槽相关进程与文件
复制槽存放在共享内存中分配的区域。图11.8展示了复制槽及相关进程和文件。
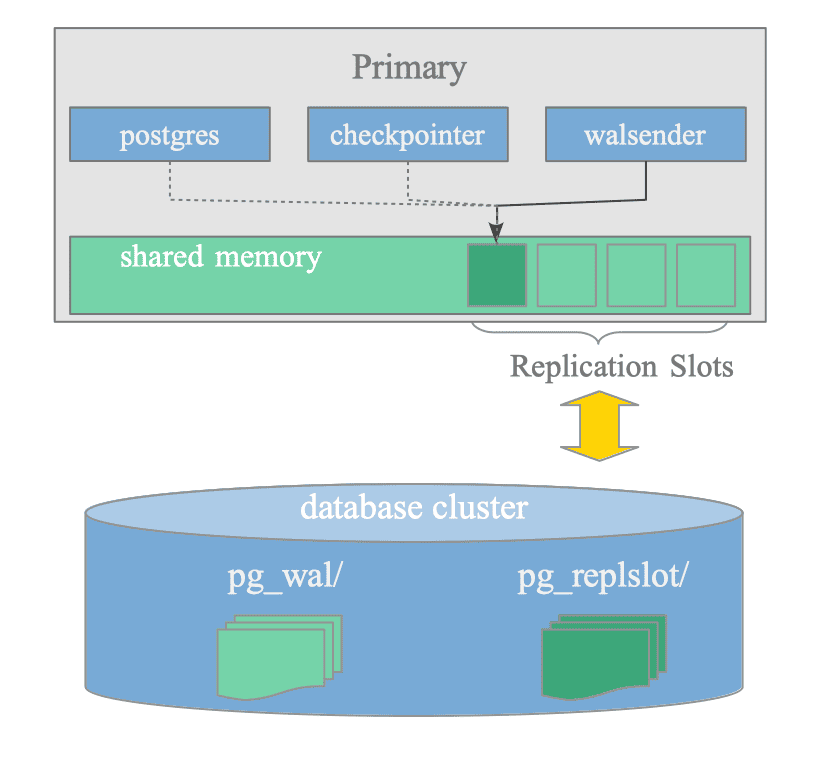
11.4.2.1 相关进程
- walsender: 持续更新对应复制槽,使其反映备库当前接收WAL的进度。
- 检查点后台进程: 在检查点期间读取复制槽,以判断哪些WAL段可以删除。
- postgres后端: 通过系统视图
pg_replication_slots显示槽信息。
11.4.2.2 相关文件
pg_replslot目录下的状态文件: walsender定期把复制槽的持久状态保存到这里。服务器重启时,PostgreSQL重新把这些信息载入内存,恢复复制槽状态。pg_wal目录下的WAL段文件。
11.4.3 数据结构
复制槽由slot.h中的ReplicationSlot结构定义。该结构同时服务物理复制与逻辑复制,和物理流复制最相关的字段可以简化为:
active_pid: 当前管理该槽的walsender PID。data:ReplicationSlotPersistentData定义的持久数据,其中最重要的是槽名name和restart_lsn。restart_lsn是该槽未来仍可能需要的最老LSN;检查点进程会读取所有槽中最小的restart_lsn,据此决定哪些WAL段不能删除。
持久数据会定期写入pg_replslot目录,其主要结构如下:
物理复制槽的database为InvalidOid,逻辑复制槽则保存所属数据库OID。confirmed_flush、plugin、two_phase和failover等字段主要用于逻辑复制。
11.4.4 启用复制槽
图11.9展示了启用物理复制槽的顺序。
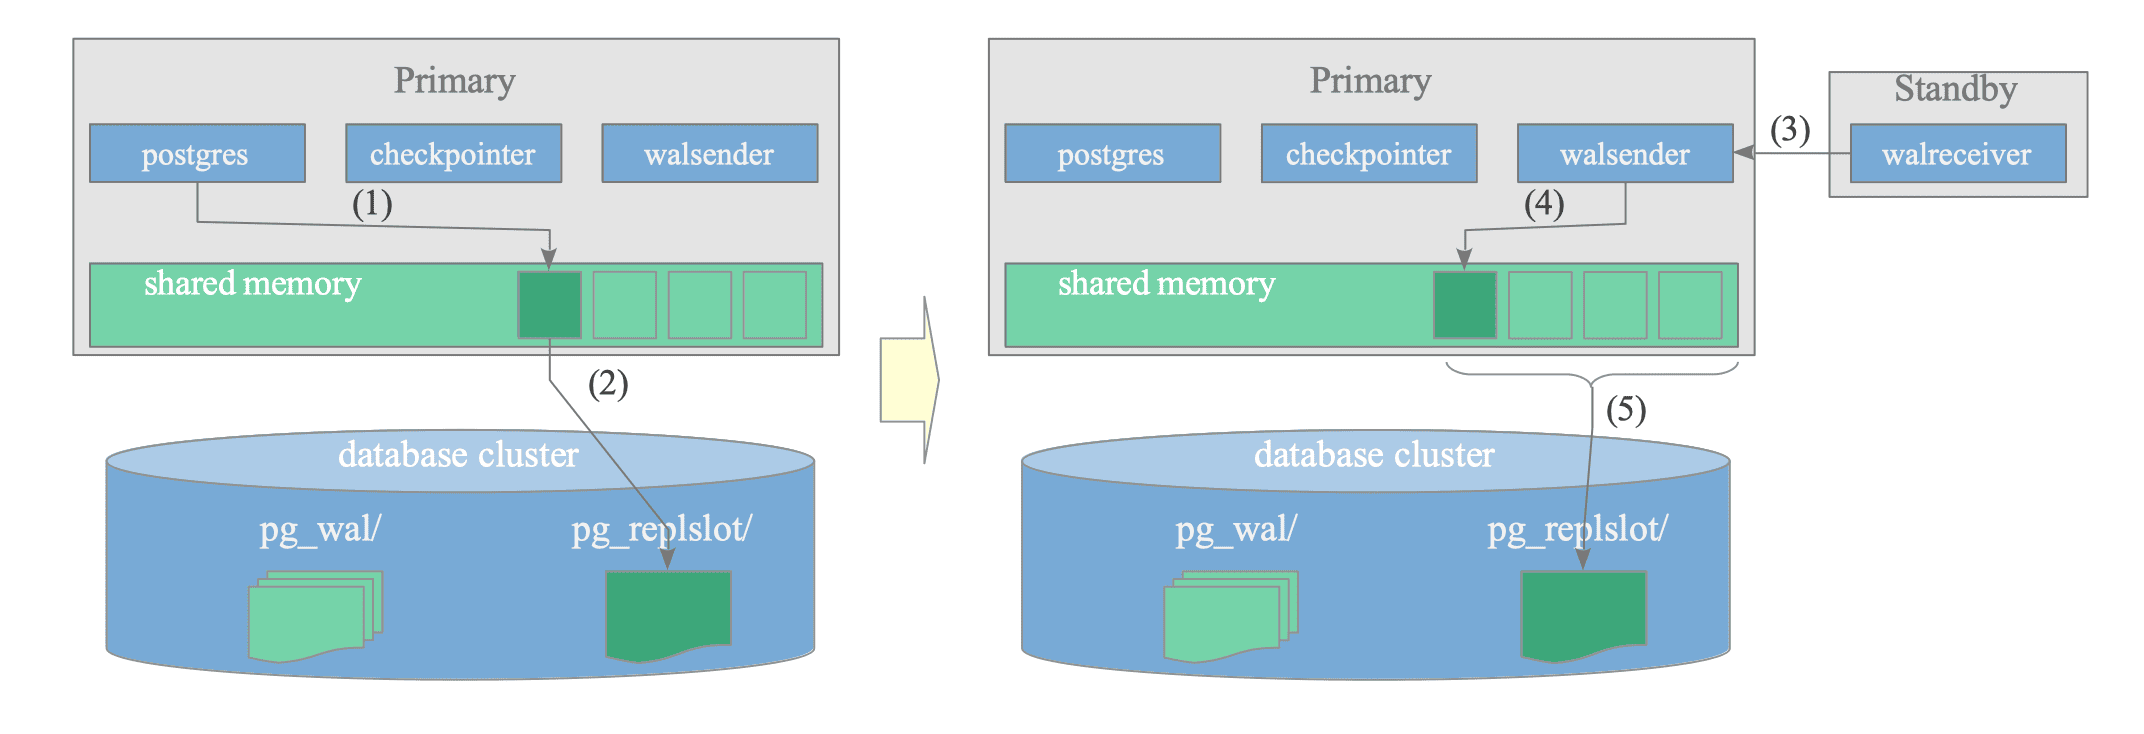
-
使用
pg_create_physical_replication_slot()创建物理复制槽。除槽名外,其他数据先使用默认值: -
PostgreSQL把
ReplicationSlotPersistentData中的持久部分写入pg_replslot。槽名对应一个子目录,状态保存在其中的state文件: -
让备库重新连接主库,并把
primary_slot_name设为该槽名:然后重新加载配置:
-
连接建立后,walsender更新
active_pid、restart_lsn等复制槽字段。 -
更新后的持久状态再次写入
pg_replslot。
11.4.5 管理复制槽
复制槽建立在共享内存中后,walsender会持续更新它,使其反映对应备库的当前状态。可以使用pg_replication_slots查看:
主库会定期把复制槽详情保存到pg_replslot下的state文件。主库重启时,再从这些文件恢复内存中的复制槽状态。
12 逻辑复制
Beta版:仍在编写中。 英文原著明确把第12章标记为Beta/WIP。本译文按当前上游内容同步,章节结构和技术细节仍可能继续变化。
PostgreSQL从10(2017年)开始原生支持逻辑复制。流复制中的节点称为主库(Primary)和备库(Standby);逻辑复制则使用发布者(Publisher)与订阅者(Subscriber)。
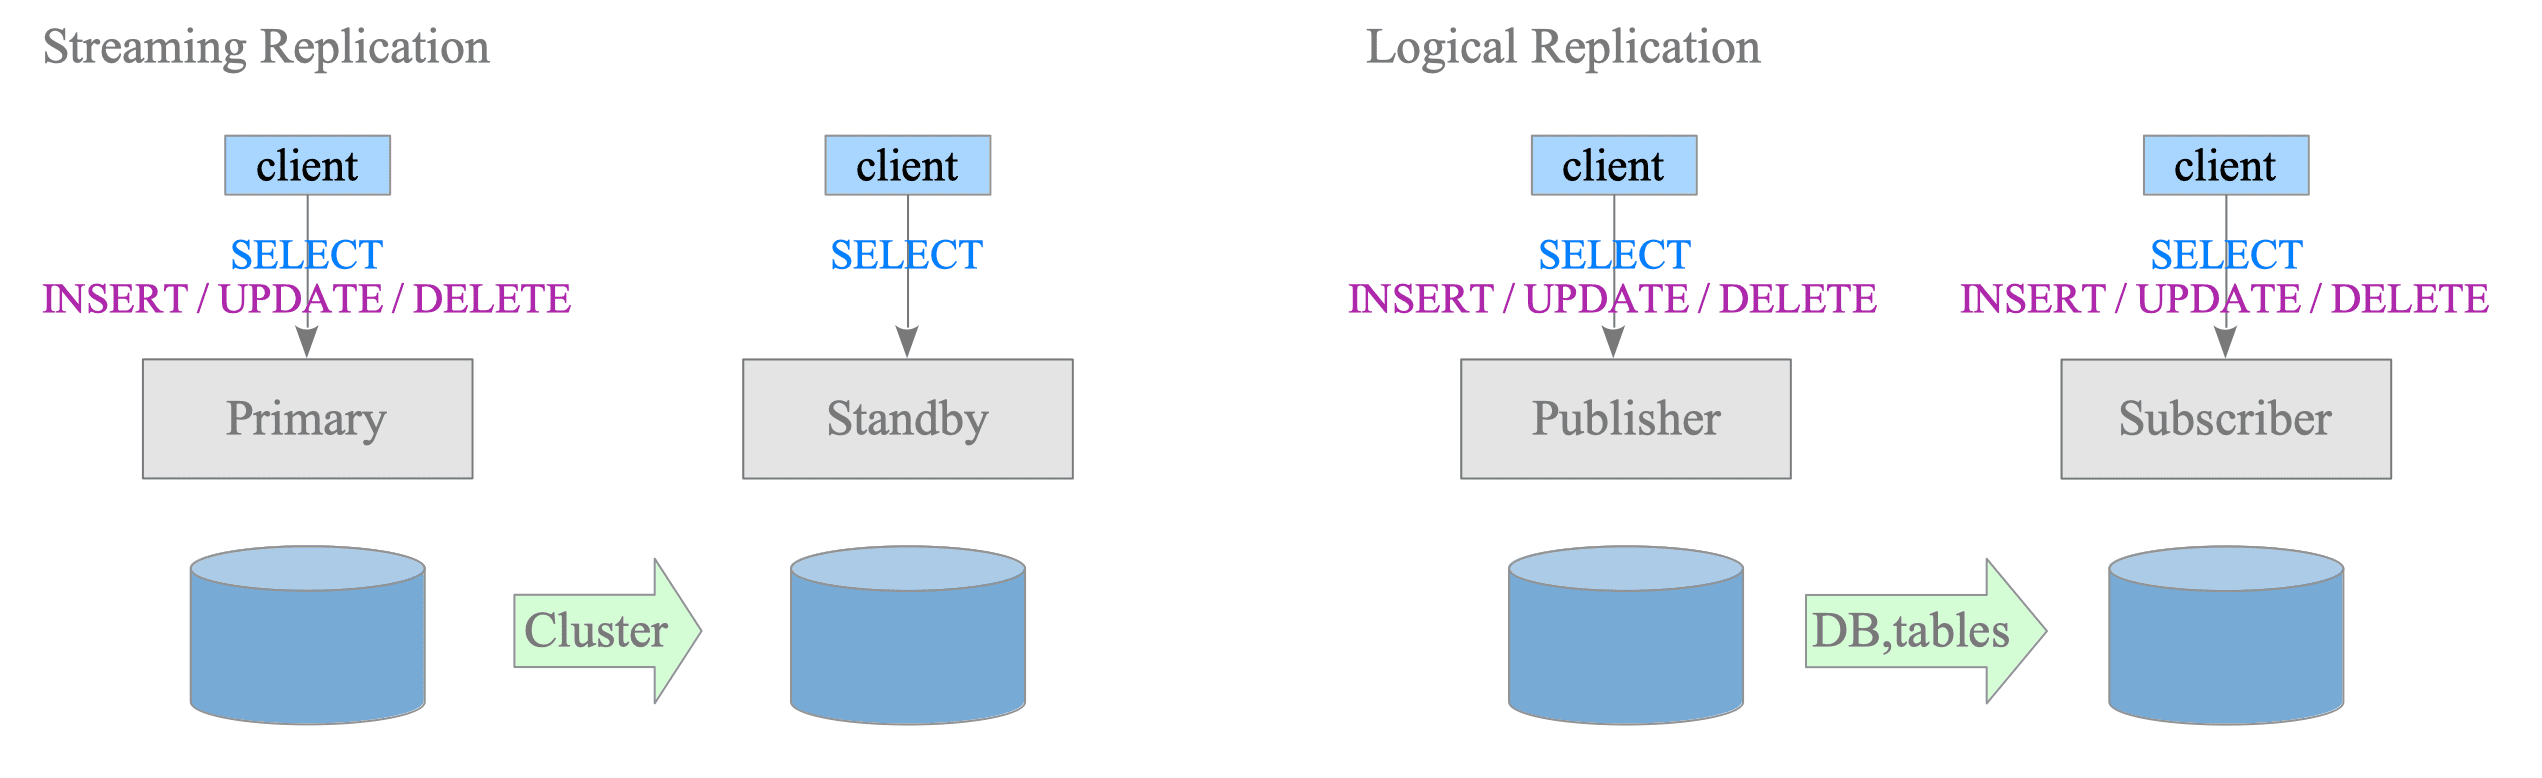
流复制复制整个数据库集簇,而逻辑复制可以只复制一个数据库中的指定表。流复制备库通常只能处理只读查询;逻辑订阅者则可以一边接收发布者的数据,一边独立执行本地写入。
| 特性 | 逻辑复制 | 流复制 |
|---|---|---|
| WAL发送时机 | 通常在事务提交后;大事务可在提交前分段传输 | WAL生成后立即传输 |
| 发送进程 | walsender | walsender |
| 接收进程 | logical replication launcher、apply worker | walreceiver、startup |
| 复制单位 | 表、数据库 | 整个数据库集簇 |
| 不复制的操作 | DDL | 无 |
| 不复制的对象 | 视图、索引、大对象等非表对象;序列自PG 19起支持 | UNLOGGED表 |
| 跨大版本 | 支持 | 不支持 |
| 跨操作系统 | 支持 | 不支持 |
| 订阅端/备库上的DML | INSERT、UPDATE、DELETE、SELECT、TRUNCATE |
SELECT |
| 订阅端/备库触发器 | apply worker默认不触发普通触发器;可启用REPLICA或ALWAYS行级触发器 |
禁用 |
本章依次介绍逻辑复制的关键概念与启动流程、ReorderBuffer结构、WAL过滤与缓冲、pgoutput输出插件、事务消息构造、订阅端应用,以及重启和崩溃恢复。
12.1 概述与关键概念
12.1.1 相关进程
逻辑复制由四类进程协同完成:
- 发布者上的walsender向订阅者发送逻辑变更,并执行各种协调工作。
- 订阅者上的logical replication launcher负责启动apply worker。
- apply worker连接发布者的walsender,接收逻辑变更流、解析消息,并更新目标表。
- table sync worker负责某张表的初始数据同步;追上主复制流后,再把后续更新交给apply worker。
12.1.2 逻辑复制概要
PostgreSQL逻辑复制是基于行(row-based)的:它捕获各行的变化,并以解码后的格式传输。逻辑消息携带操作已经求值的结果,因此不会因为random()、now()等非确定性函数在两端重复求值而产生不一致。
假设两个并发事务(txid=99和100)修改tbl_a与tbl_b:
- 流复制在每条SQL执行时依次写入WAL记录至,walsender不考虑事务是否提交,直接把记录发送给备库。walreceiver按相同顺序写入本地WAL,形成主库的物理镜像。
- 逻辑复制按事务边界与发布范围处理数据。walsender一边读取WAL,一边把记录解码为逻辑变更,并在ReorderBuffer中按事务重组,而不是立即发送。
ReorderBuffer相关处理分为三步:
- 过滤: 按发布范围过滤变更。如果订阅者只订阅
tbl_a,那么来自tbl_b的变更会被丢弃。 - 解码与缓冲: 把每条WAL记录解码为逻辑变更,存入ReorderBuffer。
- 发送: 读到
txid=100的提交记录后,收集属于该事务且在发布范围内的、,连同提交消息一起发送。尚未提交的txid=99变更继续保留在缓冲区中。
标准逻辑复制默认使用pgoutput插件进行逻辑解码。订阅端apply worker根据收到的消息重建事务并执行相应修改。
12.1.2.1 异步与同步
PostgreSQL逻辑复制同时支持异步和同步模式,默认异步。
- 异步模式: 发布者的
COMMIT在本地WAL刷盘后立即完成,不等待订阅者响应。 - 同步模式: 当
synchronous_commit='remote_apply'时,发布者提交会等待订阅者ACK;apply worker只有在订阅端完成应用后才发送确认。
同步模式相较异步模式多出的提交耗时称为端到端延迟(End-to-End Latency)。事务越大,解码、传输和应用越耗时:异步模式下体现为更大的复制延迟和更长的不一致窗口;同步模式下则直接增加发布者的提交延迟。
12.1.2.2 大事务的管理与优化
1. 标准事务处理(streaming=off)
变更量超过logical_decoding_work_mem后,walsender会把ReorderBuffer中的数据写入磁盘溢出文件(spill file)。
处理流程为:变更进入ReorderBuffer;超出内存限制后写入溢出文件;事务在发布者提交;walsender从内存和溢出文件收集全部变更并发送;apply worker按顺序应用。每条连接一次只发送一个事务,因此大事务容易造成明显复制延迟。
2. 大事务提交前流式发送(PostgreSQL 14及以后)
PostgreSQL 14允许在事务提交前分段发送变更,从而隐藏提交后的传输开销。
当ReorderBuffer达到内存阈值时,walsender立即开始发送;apply worker把收到的原始二进制消息缓存在StringInfoData original_msg中,超过订阅端内存限制后写入临时文件。发布者提交后,apply worker从内存或临时文件取出消息并应用。
使用CREATE SUBSCRIPTION ... WITH (streaming = on)启用该模式。apply worker的消息缓存同样受logical_decoding_work_mem控制。
3. 流式变更的并行应用(PostgreSQL 16及以后)
PostgreSQL 16进一步允许在事务提交前就并行应用已流式传输的变更,使传输与应用都能和发布者上的事务执行重叠。
leader apply worker接收消息并分派给parallel apply worker;后者立即修改目标表。发布者提交后,leader把提交消息转交给parallel worker,由其完成本地事务。使用streaming='parallel'启用。若活跃worker达到max_parallel_apply_workers_per_subscription上限,则会退化为提交后串行应用。
12.1.3 副本标识
逻辑复制处理逻辑行,而不是块号、偏移量等物理位置。订阅者执行UPDATE或DELETE时,需要一个“搜索键”准确定位要修改的行,这就是副本标识(Replica Identity)。
如果发布表没有合适的副本标识,PostgreSQL会拒绝发布UPDATE或DELETE:
12.1.3.1 副本标识类型
| 模式 | 含义 | 特点 |
|---|---|---|
DEFAULT |
使用主键列 | 表有主键时自动使用 |
USING INDEX |
使用指定的唯一、非空索引 | 适用于无主键但有合适唯一索引的表 |
FULL |
记录行中所有列的旧值 | 无唯一约束时使用,但会增加消息体积 |
NOTHING |
不记录标识信息 | 无主键表的默认值;可复制INSERT,不能复制UPDATE与DELETE |
12.1.3.2 配置与验证
使用ALTER TABLE ... REPLICA IDENTITY配置:
模式保存在pg_class.relreplident中,取值为d(default)、n(nothing)、f(full)或i(index):
当使用USING INDEX时,具体索引并不存于pg_class.relreplident,而是在pg_index.indisreplident中标记。
12.1.4 复制来源
**复制来源(Replication Origin)**标识一次数据变更来自哪里,主要有两个用途:
- 跟踪复制进度: 订阅者应用外部变更时,把发布者的提交LSN记录到自己的WAL中,使中断后能从正确位置继续。
- 阻止无限复制环: 双向复制中,节点A发送到B的变更可能又被B发回A。给变更盖上来源标记,可以区分本地变更与复制得到的变更。
origin_id是订阅者本地分配的标识,不是集簇级或全局唯一键,其具体数字对其他节点没有意义:0表示事务最初在本节点执行;非零表示本节点正在重放上游变更。
12.1.4.1 使用复制来源阻止无限循环
订阅端表仍可写,因此两个节点可以同时作为发布者与订阅者,形成双活复制。
PostgreSQL 16以前会无条件转发所有解码变更,双向配置中同一变更会在节点之间不断往返。PostgreSQL 16增加了订阅参数origin:
origin='any'(默认):无论WAL来自本地事务还是外部消息应用,都继续发送。origin='none':过滤由外部节点消息应用所生成的WAL。
apply worker提交时,会在COMMIT或ABORT WAL记录上附加非零origin_id;walsender在ReorderBuffer中解码事务时读取来源。如果配置为none且发现来源标识,就跳过整个事务。
在Node 1 → Node 2 → Node 3的级联场景中,any允许Node 2继续转发带来源标记的变更;none则让Node 2应用变更但不再发往Node 3。所有参与节点都配置origin='none'即可避免双向拓扑中的无限循环。
12.1.5 逻辑复制槽
逻辑复制槽比物理槽多出若干属性,后续最重要的是:
plugin: 逻辑解码输出插件名,例如pgoutput。database: 复制槽所属数据库。物理槽作用于整个实例,逻辑槽严格限定在单个数据库。confirmed_flush_lsn: 订阅端apply worker已经确认收到数据的位置。发布者不再需要保留该LSN之前已提交事务的解码数据。
逻辑槽还包含catalog_xmin、two_phase等字段,详见pg_replication_slots官方文档。
12.1.6 冲突
逻辑复制不复制DDL,也不会像物理流复制那样受到发布者VACUUM的影响,因此不会出现流复制的那些冲突。逻辑复制冲突主要来自订阅端应用程序的并发写入。例如,一行先在订阅端被本地删除,随后发布者又尝试更新同一行,就会产生update_missing冲突。
PostgreSQL能够检测的完整冲突列表参见逻辑复制冲突官方文档。
12.2 启动逻辑复制
下面假设发布者已经存在需要复制的表,订阅者也已创建结构相同但尚无数据的表:
建立逻辑复制需要两条命令:在发布者执行CREATE PUBLICATION,在订阅者执行CREATE SUBSCRIPTION。
12.2.1 创建发布
CREATE PUBLICATION把发布信息写入pg_publication、pg_publication_rel和pg_publication_namespace,并在需要时更新pg_class:
系统视图pg_publication_tables展示发布与所属表之间的映射。
12.2.2 创建订阅
订阅者使用CREATE SUBSCRIPTION创建订阅:
整个过程分为三个阶段:创建订阅并默认请求发布者上的逻辑复制槽;连接apply worker与发布者walsender;同步发布中的表。
12.2.2.1 阶段一:创建元数据和复制槽
订阅端首先完成两项工作:把订阅元数据写入pg_subscription与pg_subscription_rel;默认请求发布者创建逻辑复制槽。
- 执行
CREATE SUBSCRIPTION的postgres进程连接发布者walsender。 - 它检查指定发布是否存在,取得目标表的模式和OID并验证结构兼容性;如果没有指定复用现有槽,则请求创建新槽。
- 把订阅信息写入
pg_subscription和pg_subscription_rel。 - 发布者终止这条初始化连接所用的walsender。
发布者上会出现使用pgoutput的逻辑槽:
12.2.2.2 阶段二:启动后台进程
- Logical Replication Launcher启动apply worker。
- apply worker连接发布者walsender,并初始化复制来源;若
pg_replication_origin中还没有对应项,则创建一个。
此后,发布者walsender与订阅者apply worker会持续运行,负责发送和应用增量变更。
12.2.2.3 阶段三:同步表
Logical Replication Launcher启动专门的table sync worker,从发布者取得目标表的现有行。为了提高效率,launcher会在配置上限内尽可能并发启动多个同步worker。
- launcher启动table sync worker。
- table sync worker连接发布者上的walsender。
- walsender发送表数据,table sync worker把数据插入订阅端目标表。
- 表追上主复制流后,table sync worker及其walsender终止,后续变更交给主apply worker。
walsender与table sync worker使用COPY ... TO STDOUT和COPY ... FROM STDIN协议高效传输并插入表数据,内部实现见tablesync.c。
PostgreSQL 17还提供
pg_createsubscriber,可以把物理备库转换为逻辑订阅者。
12.3 ReorderBuffer结构
每个walsender都会分配一块ReorderBuffer区域,其内存使用受logical_decoding_work_mem限制,默认64 MB。
ReorderBuffer由三个核心组件组成:ReorderBuffer、ReorderBufferTXN与ReorderBufferChange。
ReorderBuffer最重要的成员是以事务ID为键的by_txn散列表。每个表项都是一个ReorderBufferTXN,保存某个事务的元数据和实际WAL变更。每次INSERT、UPDATE、DELETE等修改则表示为ReorderBufferChange,按LSN顺序追加到对应事务的changes双向链表。
12.3.1 ReorderBuffer
该结构保存逻辑解码的主上下文:
| 字段 | 类型 | 含义 |
|---|---|---|
by_txn |
HTAB * |
从txid映射到ReorderBufferTXN的散列表,用于快速查找活动事务。 |
12.3.2 ReorderBufferTXN
该结构管理单个事务及其变更:
| 字段 | 类型 | 含义 |
|---|---|---|
first_lsn |
XLogRecPtr |
此事务第一条变更记录的LSN。 |
final_lsn |
XLogRecPtr |
此事务提交或中止记录的LSN。 |
origin_id |
RepOriginId |
事务最初产生处的复制来源ID。 |
origin_lsn |
XLogRecPtr |
事务在来源发布者上的提交LSN。 |
base_snapshot |
Snapshot |
解码事务时使用的历史快照,确保扫描系统目录时可见性正确。 |
changes |
dlist_head |
按LSN顺序保存ReorderBufferChange的双向链表。 |
base_snapshot对于刚创建复制槽或事务修改系统目录时尤其重要;后文主要关注稳定运行阶段的数据流,因此不再展开。
12.3.3 ReorderBufferChange
该结构表示一次独立数据修改,主要字段如下:
| 字段 | 类型 | 含义 |
|---|---|---|
lsn |
XLogRecPtr |
产生该变更的WAL记录LSN。 |
action |
ReorderBufferChangeType |
INSERT、UPDATE、DELETE、TRUNCATE等操作类型。 |
data |
union |
与操作类型对应的数据。 |
data.tp.rlocator |
RelFileLocator |
被修改关系的表空间OID、数据库OID和relfilenode编号。 |
data.tp.oldtuple |
HeapTuple |
UPDATE或DELETE需要时保存的旧元组,取决于副本标识。 |
data.tp.newtuple |
HeapTuple |
INSERT或UPDATE后的新元组。 |
核心结构可以简化为:
12.4 WAL数据过滤与缓冲
本节介绍walsender如何通过多级过滤决定哪些WAL记录可以进入ReorderBuffer,并用一个并发事务示例展示ReorderBuffer如何累积变更;随后说明副本标识如何决定UPDATE、DELETE记录中的元组数据,以及超过内存上限后的磁盘溢出机制。
12.4.1 过滤
walsender通过多道过滤门决定是否解码一条WAL记录并把它加入ReorderBuffer的changes链表:
- 数据库OID: 立即丢弃不属于目标数据库的WAL记录。
- 来源ID/回调: PostgreSQL 16起,在数据进入ReorderBuffer之前检查来源。配置
origin='none'时,丢弃来自其他节点(origin_id > 0)的变更,阻止无限复制环。 - 发布缓存: PostgreSQL 15起,在缓冲前按表过滤;不属于发布的表,以及被行过滤器排除的行,都不会进入缓冲区。
- 关系类型/物理结构: 过滤索引更新。逻辑复制只关心行级变化;订阅端修改元组后,本地索引机制会自动更新索引。
只有通过全部过滤门的变更才会存入ReorderBuffer。
PostgreSQL 14及以前: 旧版本先检查数据库OID,再解码并缓冲所有变更,直到
COMMIT时才按发布定义过滤。这种惰性过滤会让ReorderBuffer暂时保存最终必然丢弃的数据,浪费内存。
12.4.2 WAL数据缓冲
下面用两个并发事务说明walsender如何从原始WAL重建逻辑变更。
12.4.2.1 目标关系
tbl_a与tbl_b都使用主键作为默认副本标识:
12.4.2.2 交错事务场景
两个事务txid=840与841按以下时间线交错执行:
事务隔离级别不会影响逻辑解码。隔离级别在事务运行时控制元组可见性;逻辑解码处理的则是已经完成可见性检查、写入WAL的历史结果,它只负责按事务重组这些结果。
12.4.2.3 ReorderBuffer状态变化
T1:txid=840向tbl_a插入
系统为txid=840创建ReorderBufferTXN,把first_lsn设为该INSERT记录的LSN,并把变更加入changes链表。
ReorderBufferChange保存LSN、INSERT等动作类型、目标表空间/数据库/关系OID和实际元组数据。
当
wal_level=logical时,整页写入的main data部分包含实际被修改的元组。walsender可以直接从main data取得元组,而无需解析整个页面块,从而降低逻辑解码开销。
T2:txid=841向tbl_a插入
系统为txid=841创建另一份ReorderBufferTXN。两个事务的变更存入相互独立的子链表。
T3:txid=840向tbl_b插入
新的INSERT变更追加到txid=840自己的changes链表。
T4与T5:txid=841两次更新tbl_a
第一次与第二次UPDATE依次追加到txid=841的变更链表。
在REPLICA IDENTITY DEFAULT下,只有主键列被修改时才需要oldtuple。本例的主键id未变,订阅者可使用newtuple中的id=1找到目标元组,因此省略oldtuple。
T6:txid=840删除tbl_b中的行
DELETE记录追加到txid=840的链表,只保存作为副本标识的主键数据。
订阅者删除目标元组只需要键值;省略name、data等非键列既减少ReorderBuffer内存,也降低网络流量。
T7与T8:事务提交
txid=840提交时,ReorderBuffer从链表头开始遍历其变更。输出插件把每条变更编码为复制消息并发送;完成后移除该ReorderBufferTXN。
txid=841在T8提交时也按同样方式重组并发送。
12.4.3 副本标识与解码元组
UPDATE和DELETE写入WAL的元组内容由目标表的副本标识决定。
12.4.3.1 UPDATE
当副本标识为主键或指定索引时:
| 更新类型 | oldtuple |
newtuple |
|---|---|---|
| 只更新非键列 | 无 | 完整新元组 |
| 更新键列 | 旧键值 | 完整新元组 |
如果更新副本标识中的键列,订阅者需要用oldtuple中的旧键定位原行:
若只修改非键列,oldtuple为空,订阅者可使用newtuple中仍未改变的键:
apply worker并不会拼接或执行文本SQL;它复用执行器基础设施,但绕过解析与计划阶段,直接使用索引扫描或顺序扫描查找并修改目标元组。
REPLICA IDENTITY FULL则让oldtuple保存更新前的完整元组,newtuple保存更新后的完整元组:
没有正式唯一键时,订阅者需要比较所有列来定位目标行:
12.4.3.2 DELETE
DELETE没有后续状态,因此只记录oldtuple:
| 副本标识 | oldtuple |
newtuple |
|---|---|---|
| 主键/索引 | 键列 | 无 |
FULL |
完整旧元组 | 无 |
12.4.4 ReorderBuffer内存管理与磁盘溢出
为了避免大事务耗尽内存,当全部缓冲事务的累计内存超过logical_decoding_work_mem时,ReorderBuffer会把部分变更溢出到磁盘(spill-to-disk)。
12.4.4.1 溢出算法
- 每加入一条
ReorderBufferChange,累计内存增加相应大小。 - 将当前用量与
logical_decoding_work_mem比较。 - 超出阈值时,找到当前积累变更最多的“最重”事务。
- 把该事务的全部已缓冲变更序列化到
$PGDATA/pg_replslot/<slot_name>中的.spill文件。 - 释放这些变更占用的内存,但保留
ReorderBufferTXN元数据。 - 把事务标为
serialized=true,提交解码时再从磁盘读回。
PostgreSQL只溢出最重事务,而不是同时刷新所有事务,以较少的磁盘I/O把内存维持在上限内。
12.4.4.2 溢出文件
溢出文件位于复制槽目录:
命名格式为xid-[XID]-lsn-[LSN_HIGH]-[LSN_LOW].spill:XID使用十进制;LSN高32位和低32位使用十六进制。
12.5 逻辑解码输出插件:pgoutput
输出插件把ReorderBuffer已经组织、排序好的变更数据序列化为订阅者能够理解的格式,主要完成两项工作:
- 最终过滤与转换: 再次根据发布配置检查目标表、操作类型、行过滤器和列列表,丢弃无关数据,并按协议要求编码为文本或二进制。
- 生成消息: 构造
BEGIN、DML、TRUNCATE、COMMIT等消息序列,交给walsender发送。
这一机制是可插拔的;自定义插件可以输出不同格式或实现特殊逻辑。标准PostgreSQL逻辑复制使用官方插件pgoutput。下文列出核心消息结构;完整的协议版本差异参见逻辑复制消息格式。
12.5.1 TupleData公共子消息
TupleData在DML消息中表示元组内容:
| 字段 | 类型 | 含义 |
|---|---|---|
num_cols |
Int16 |
元组列数。 |
kind |
Byte1 |
n=NULL;u=未改变的TOAST值;t=文本格式;b=二进制格式。 |
length |
Int32 |
t或b值的字节长度。 |
value |
Byte*n* |
实际列值。 |
12.5.2 事务控制
12.5.2.1 Begin(B)
标识事务开始,并携带最终LSN、提交时间与事务ID:
final_lsn通常是提交LSN;两阶段提交时则是prepare LSN。commit_timestamp是从PostgreSQL纪元(2000-01-01)开始计算的微秒时间戳。
12.5.2.2 Commit(C)
标识事务结束。订阅者收到后,把此前累积的变更作为一个原子单元在本地提交:
flags当前保留且为0;commit_lsn是提交记录LSN,end_lsn是事务末尾LSN。
12.5.3 DML消息
12.5.3.1 Origin(O)
多节点复制中用于说明事务最初产生的位置:
一个事务中可以出现多个Origin消息;origin_lsn是来源服务器上的提交LSN。
12.5.3.2 Relation(R)
提供表的元数据,通常在会话中第一次发送某表的DML消息前发送,把关系OID映射到模式、表名和列定义:
replica_identity对应pg_class.relreplident的d、n、f、i;列flags=1表示该列属于副本标识键。
12.5.3.3 Insert(I)
N表示随后是新元组,rel_id对应此前Relation消息中的关系OID。
12.5.3.4 Update(U)
消息形态取决于副本标识以及键列是否改变:
K表示随后是旧键,O表示完整旧元组,两者互斥;N始终标记新元组。
12.5.3.5 Delete(D)
订阅者使用给出的旧键或完整旧元组定位并删除记录。
12.5.3.6 Truncate(T)
表示批量清空一张或多张表:
options的位0表示CASCADE,位1表示RESTART IDENTITY;后续重复num_relations个关系OID。
12.5.4 流控制消息
发布者为支持大事务流式传输而分段发送数据时,使用以下消息。
12.5.4.1 Stream Start(S)
标识一个流片段开始;first_segment=1表示这是该XID的首段。
12.5.4.2 Stream Stop(E)
标识当前流片段结束。
12.5.4.3 Stream Commit(c)
标识流式事务提交,字段与普通Commit消息类似,但额外显式携带txid。
12.5.4.4 Stream Abort(A)
标识流式事务或子事务中止。subxid在顶层事务中等于txid;abort_lsn与abort_timestamp只在支持并行流式应用的协议v4及以后出现。
12.6 事务重组与消息发送
本节说明ReorderBuffer如何重组累积的变更,并通过输出插件发送给订阅者apply worker。
12.6.1 事务重组概要
walsender在WAL中发现COMMIT记录后,ReorderBuffer开始重组事务:
- 找到已提交事务的
ReorderBufferTXN。 - 如果存在子事务,把子事务变更链表合并到顶层事务。
- 按LSN排序最终变更列表,保证时间顺序。
- 检查提交或中止记录中的复制来源;存在时把来源信息加入复制消息。
- 依次遍历变更并交给
pgoutput等输出插件。 - 释放
ReorderBufferTXN与所有ReorderBufferChange对象。
不含子事务时,单个事务链表天然按LSN排序,只需正向遍历。若事务中止,ReorderBuffer会立即丢弃该事务及全部变更,不交给输出插件。
12.6.1.1 示例
txid=840经pgoutput生成的消息序列为:
txid=841的消息序列为:
Relation(R)消息只在当前walsender会话尚未发送过该表元数据,或表定义发生变化时发送,以避免重复传输。
12.6.2 发送消息
输出插件完成序列化后,消息会封装进逻辑复制协议并经网络发送。
普通事务只有在发布者提交后,apply worker才会收到从Begin到Commit的完整连续序列。
pgoutput消息是二进制格式,不能直接作为文本查看。调试时可以把pg_recvlogical输出交给od:
若希望查看可读输出,可以使用test_decoding插件:
12.6.3 大事务流式传输
当streaming为on或parallel且ReorderBuffer达到内存上限时,PostgreSQL不再把变更写入发布端本地spill文件,而是立即发送给订阅端apply worker或leader apply worker。
假设溢出时txid=842占用内存最多,发布者先重排它的变更,再用Stream Start(S)与Stream Stop(E)包住形成一个片段。首段的S取代普通事务的Begin消息。
12.6.3.1 第一段
后续再次达到阈值时继续发送新片段,first_segment改为0。
12.6.3.2 第二段
12.6.3.3 流式提交
发布者最终提交txid=842时发送Stream Commit:
若事务中止,则发送Stream Abort(A),通知订阅端丢弃此前收到的全部片段。
12.7 Apply Worker与事务重放
apply worker负责把发布者发送的逻辑变更重放到订阅者本地表。本节先介绍普通模式,再说明大事务流式处理与并行apply worker。
12.7.1 普通模式(streaming=off)
订阅端apply worker执行以下主要工作:
- 来源过滤: 检查消息来源,决定应用还是跳过,防止复制环。
- LSN跳过检查(幂等性): 把事务LSN与
pg_replication_origin_status中持久化的remote_lsn比较;已经应用过的事务直接跳过。 - 分派: 按消息类型交给
INSERT、UPDATE、DELETE等处理器。 - 冲突检测: 检测更新目标行不存在、唯一约束冲突等问题。会产生错误的冲突将停止复制;
update_missing、delete_missing等缺行冲突则记录后跳过相应操作。
12.7.1.1 来源过滤与LSN跟踪
是否应用事务取决于订阅参数origin及消息中的origin_id。当前实现中,如果配置origin='none'且origin_id>0,apply worker跳过重放;否则继续。
12.7.1.2 消息分派与重放
假设发布者向tbl_a插入一行,消息流为:
处理流程如下:
- Begin: 开启本地事务,记录发布者提交LSN和时间戳,并把
session_replication_role设为replica,使本地触发器和约束按其复制角色运行。 - Relation: 接收表定义,更新
RelationSyncCache,依据模式名与表名把发布端OID映射到本地表OID。 - Insert: 把二进制元组转为本地表格式,调用内部插入逻辑直接写表并更新索引;该操作也会在订阅者生成自己的WAL。
- Commit: 提交本地事务,把对应发布者的
origin_id附加到提交WAL;更新复制来源的已应用LSN,并向walsender返回已刷盘ACK。
订阅端提交WAL会附带发布者元数据:origin_id、作为origin_lsn的final_lsn,以及作为origin_timestamp的提交时间。UPDATE与DELETE还需要使用索引或顺序扫描直接查找目标元组。
12.7.1.3 REPLICA IDENTITY FULL优化
PostgreSQL 15及以前,REPLICA IDENTITY FULL表在应用UPDATE或DELETE时必须顺序扫描定位目标元组,大表开销很高。PostgreSQL 16起,apply worker可以使用现有的合适索引;FindLogicalRepLocalIndex()会寻找能够定位行的非部分B-tree索引,显著减少顺序扫描。
12.7.2 流式模式(streaming=on)
此模式下,apply worker在最终提交前就会分段收到尚在进行中的事务。假设txid=842是分两段发送的大事务,而txid=843是普通小事务:
- 收到
txid=842首段后,用StringInfoData original_msg在内存中累积消息。 - 普通
txid=843到达后,立即解码并应用。 txid=842第二段追加到原有缓冲区。- 收到Stream Commit后,解码
txid=842的全部累积变更并顺序重放。
因此,普通消息立即处理,流式片段则先缓冲到提交消息到达。
12.7.2.1 内存压力与临时文件
流式变更缓存同样受logical_decoding_work_mem限制。超过上限后,apply worker把数据写入$PGDATA/base/pgsql_tmp/下的临时文件:
例如订阅OID为16403、事务ID为767、apply worker PID为2212:
事务提交或中止后,PostgreSQL自动删除这些临时文件。
12.7.3 并行Apply Worker(streaming=parallel)
PostgreSQL 16引入并行应用,允许订阅端并发重放多个事务。与streaming=on先缓冲到提交不同,被分配到parallel apply worker的变更会在到达时立即应用。
- leader apply worker: 维持walsender连接,并为收到的变更分派parallel worker。
- parallel apply worker: 由leader启动并并发应用事务。
- worker上限: 由
max_parallel_apply_workers_per_subscription控制。 - 退化机制: 活跃流式事务超过上限时,leader对额外事务退回
streaming=on,把片段缓存在内存或磁盘直到提交。
12.7.3.1 并行重放序列
假设txid=845是分两段发送的大事务,txid=846是单元组事务:
- leader收到
txid=845首段,启动或分配一个parallel worker。 - 把首段交给该worker,立即开始应用。
- 收到
txid=846后,为它启动或分配另一个worker并立即应用。 txid=845第二段到达后,转给原先分配的worker继续应用。- leader收到
txid=845的Stream Commit,通知该worker提交本地事务并回到就绪状态。
如果事务已经分配worker,后续片段始终转给同一worker;没有分配且仍低于上限时启动新worker;达到上限时则由leader缓冲并在提交后串行应用。
12.8 重启与崩溃恢复的内部机制
本节先说明逻辑复制如何管理WAL位置,再介绍订阅者正常重启与崩溃恢复的序列。
12.8.1 WAL数据管理
复制进度以WAL的LSN为基准。物理流复制的主备共享同一套WAL空间;逻辑复制的发布者与订阅者各自使用独立LSN,因此必须维护两套WAL空间之间的映射。
PostgreSQL由订阅者负责这项映射:发布者始终使用自己的LSN,订阅者记录本地LSN与从发布者收到的远端LSN之间的对应关系。
12.8.1.1 发布者与订阅者的LSN状态
发布者在逻辑复制槽中维护confirmed_flush_lsn:它表示复制槽消费者已经确认接收的位置;在此位置之前提交的事务不再需要提供给复制。复制槽状态保存在内存中,通常在检查点时持久化。
订阅者提交或中止由复制产生的本地事务时,会在自己的WAL中记录发布者元数据:origin_id、发布者提交LSN与提交时间。同时在内存中维护:
local_lsn: 订阅者本地提交记录的LSN。remote_lsn: 与该提交对应的发布者final_lsn。
这些值可通过pg_replication_origin_status查看,并在每次检查点写入$PGDATA/pg_logical/replorigin_checkpoint。订阅者意外崩溃时,该文件中的最新映射可能落后;恢复过程会扫描WAL自动重建。
12.8.1.2 正常事务中的LSN流
- 复制槽当前
confirmed_flush_lsn为。发布者执行txid=100的INSERT,提交WAL从开始,到结束;pgoutput在Begin中发送final_lsn=LSN^P_1,在Commit中发送commit_lsn=LSN^P_1、end_lsn=LSN^P_2。 - 订阅者内存最初保存
local_lsn=LSN^S_0、remote_lsn=LSN^P_0。apply worker应用变更,并在订阅者WAL的写入提交记录,其中包含origin_id和发布者;内存映射随即更新为,但replorigin_checkpoint要到下次检查点才更新。 - 事务完成后,订阅者返回包含
write_lsn、flush_lsn与apply_lsn的ACK;这些值使用发布者WAL空间,本例均为。发布者据此把复制槽的confirmed_flush_lsn推进到。
12.8.2 重启序列
任一端正常重启导致复制停止后,逻辑复制会自动恢复。
- 订阅者读取
replorigin_checkpoint,初始化local_lsn和remote_lsn。 - logical replication launcher启动apply worker。
- apply worker向发布者请求连接。
- 发布者postmaster启动walsender。
- apply worker与walsender建立连接。
- 双方使用
remote_lsn协商起点;订阅者发送远端位置,walsender从发布者WAL中的该位置开始解码。 - 复制从指定LSN继续。
12.8.3 崩溃恢复序列
订阅者崩溃时,replorigin_checkpoint中的映射只反映上一次检查点,可能已经过期。因此连接发布者前必须扫描本地WAL,重建最新映射。
- 扫描WAL段: 在常规崩溃恢复过程中,从源自发布者的提交记录中提取
origin_id与origin_lsn。 - 恢复来源状态: 恢复完成后,把最新
origin_lsn及其对应的订阅者提交LSN恢复到内存,分别作为新的remote_lsn与local_lsn,并重建replorigin_checkpoint。 - 随后进入普通重启序列,与发布者重新建立连接。
技术附录
本附录收录英文原著新增的方差公式推导与io_uring示例。
A.1 方差计算公式推导
A.1.1 Youngs与Cramer方法的推导
Youngs与Cramer方法是Welford在线方差算法的一种改进。先从Welford方法开始。
Welford方法
Welford计算方差的递推关系为:
其中为前个值的平均数,。由于
可得:
$$ \begin{aligned} V_n &= \sum_{i=1}^{n-1}(x_i-A_n)^2 + (x_n-A_n)^2 \ &= \sum_{i=1}^{n-1}\left((x_i-A_{n-1})-\frac{x_n-A_{n-1}}{n}\right)^2
- \left(\frac{n-1}{n}(x_n-A_{n-1})\right)^2 \ &= V_{n-1} + \frac{n-1}{n}(x_n-A_{n-1})^2. \end{aligned} $$
中间的交叉项为零,因为。
Youngs与Cramer方法
Youngs与Cramer方法用和代替平均数,改善计算效率与数值稳定性:
A.1.2 单遍/并行方差公式的推导
并行查询计算方差时,leader需要合并多个worker算出的局部结果。把数据分成大小为与的两部分,总和分别为、,平方离差和分别为、,则总体方差分子为:
记两部分平均数为、,总体平均数为
将总体平方离差和分成两部分:
$$ \begin{aligned} V_n &= \sum_{i=1}^{n_1}(x_i-A)^2
- \sum_{i=n_1+1}^{n_1+n_2}(x_i-A)^2 \ &= V_{n_1}+n_1(A_1-A)^2
- V_{n_2}+n_2(A_2-A)^2. \end{aligned} $$
代入总体平均数并整理:
于是得到上面的并行合并公式。
A.2 io_uring示例
下面两个小程序构造了一个玩具缓冲区管理器:把32字节文件rel.data按四次8字节逻辑读取,异步装入BufferPool。
四个逻辑块分别放入缓冲池槽3、7、1、0:
A.2.1 多读取请求
第一个程序为每个逻辑块准备一条独立的io_uring读取请求:
处理流程如下:
io_uring_get_sqe()为每个读取请求取得一个提交队列项(SQE);io_uring_prep_read()写入目标缓冲区、读取长度和文件偏移,user_data保存块号。io_uring_submit()一次提交四个请求。- 内核读取各块,每完成一次就向完成队列加入一个CQE。
- 程序反复调用
io_uring_wait_cqe()等待事件;收到CQE后相应缓冲区即可安全读取,最后用io_uring_cqe_seen()标记事件已消费。
A.2.2 向量读取
io_uring支持向量I/O(分散—聚集I/O),可以用一条请求把多个连续页面读入分散的缓冲池地址:
程序先用iov数组绑定四个分散的BufferPool槽,再用io_uring_prep_readv()准备一条向量请求。内核从文件连续读取四个块,并按iov指定的地址分散写入;因为逻辑上只有一条请求,整个操作只产生一个完成事件。
许可与授权
本页集中说明本书的版权归属与使用条款。在线阅读的每一章页脚都带有对应上游章节的归属信息,并链接回本页。
原著版权
英文原著《The Internals of PostgreSQL》由 Hironobu Suzuki(鈴木 啓修)创作并持续更新,版权归原作者所有(All Rights Reserved)。原著在线版本见 interdb.jp/pg,对原著内容的任何授权以作者本人的声明为准。
中文版与译本权利
本书中文版由冯若航、刘阳明、张文升翻译,经正规出版流程引进出版,作者亦专门为中文版撰写了序言。译者保留对本中文译本的所有权利(All Rights Reserved)。
本站在线收录的主体是 2018 年完成的中文译稿,并包含对英文原著后续新增内容的补译,供学习、研究与技术传播使用。
使用条款
- 在线阅读与分享:欢迎自由阅读,并以链接形式分享本站页面。
- 引用:适度引用时,请同时注明英文原著(作者与出处)与中文译本(译者与本站)信息。
- 转载与商用:未经许可,请勿整章转载、再分发,或将本译本用于商业用途;如有需要,请先联系译者取得授权。
版本边界
中文译本主体反映 PostgreSQL 9.x 至 11 前后的实现,保留了翻译当时的历史语境;本站也收录了英文原著后来新增、涉及 PostgreSQL 10 至 19 的补译内容,其中第 12 章在原著中仍标为 Beta/WIP,PostgreSQL 19相关内容属于发布前描述。判断当前版本行为时,请以持续更新的英文原著与 PostgreSQL 官方文档为准。