8 缓冲区管理器
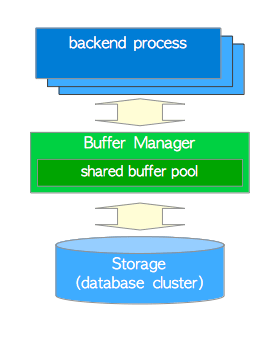
缓冲区管理器(Buffer Manager) 管理着共享内存和持久存储之间的数据传输,对于DBMS的性能有着重要的影响。PostgreSQL的缓冲区管理器十分高效。
本章介绍了PostgreSQL的缓冲区管理器。第一节概览了缓冲区管理器,后续的章节分别介绍以下内容:
-
缓冲区管理器的结构
-
缓冲区管理器的锁
-
缓冲区管理器是如何工作的
-
环形缓冲区
-
PostgreSQL异步I/O
-
脏页刷写
8.1 概览
本节介绍了一些关键概念,有助于理解后续章节。
8.1.1 缓冲区管理器的结构
PostgreSQL缓冲区管理器由缓冲表,缓冲区描述符和缓冲池组成,这几个组件将在接下来的小节中介绍。
**缓冲池(buffer pool)**层存储着数据文件页面,诸如表页与索引页,及其相应的自由空间映射和可见性映射页面。
缓冲池是一个数组,每个槽中存储数据文件的一页。缓冲池数组的序号索引称为 buffer_id。8.2 和 8.3 节描述了缓冲区管理器的内部细节。
8.1.2 缓冲区标签(buffer_tag)
PostgreSQL中的每个数据文件页面都可以分配到唯一的标签,即 缓冲区标签(buffer tag)。 当缓冲区管理器收到请求时,PostgreSQL 会用到目标页面的缓冲区标签。
缓冲区标签(buffer_tag) 由三个值组成:关系文件节点(relfilenode),关系分支编号(fork number),页面块号(block number)。例如,缓冲区标签{(16821, 16384, 37721), 0, 7}表示,在oid=16821的表空间中的oid=16384的数据库中的oid=37721的表的0号分支(关系本体)的第七号页面。再比如缓冲区标签{(16821, 16384, 37721), 1, 3}表示该表空闲空间映射文件的三号页面。(关系本体main分支编号为0,空闲空间映射fsm分支编号为1)
8.1.3 后端进程如何读取数据页
本小节描述了后端进程如何从缓冲区管理器中读取页面,如图8.2所示。
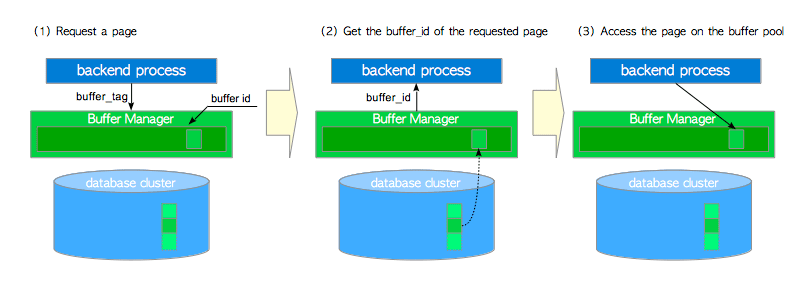
- 当读取表或索引页时,后端进程向缓冲区管理器发送请求,请求中带有目标页面的
buffer_tag。 - 缓冲区管理器会根据
buffer_tag返回一个buffer_id,即目标页面存储在数组中的槽位的序号。如果请求的页面没有存储在缓冲池中,那么缓冲区管理器会将页面从持久存储中加载到其中一个缓冲池槽位中,然后再返回该槽位的buffer_id。 - 后端进程访问
buffer_id对应的槽位(以读取所需的页面)。
当后端进程修改缓冲池中的页面时(例如向页面插入元组),这种尚未刷新到持久存储,但已被修改的页面被称为脏页(dirty page)。
第8.4节描述了缓冲区管理器的工作原理。
8.1.4 页面置换算法
当所有缓冲池槽位都被占用,且其中未包含所请求的页面时,缓冲区管理器必须在缓冲池中选择一个页面逐出,用于放置被请求的页面。 在计算机科学领域中,选择页面的算法通常被称为页面置换算法(page replacement algorithms),而所选择的页面被称为受害者页面(victim page)。
针对页面置换算法的研究从计算机科学出现以来就一直在进行,因此先前已经提出过很多置换算法了。 从8.1版本开始,PostgreSQL使用 时钟扫描(clock-sweep) 算法,因为比起以前版本中使用的LRU算法,它更为简单高效。
第8.4.4节描述了时钟扫描的细节。
8.1.5 刷写脏页
脏页最终应该被刷入存储,但缓冲区管理器执行这个任务需要额外帮助。 在PostgreSQL中,两个后台进程:检查点进程(checkpointer) 和 后台写入器(background writer) 负责此任务。
8.6 节描述了检查点进程和后台写入器。
直接I/O(Direct I/O)
PostgreSQL并不支持直接I/O,但有时会讨论它。 如果你想了解更多详细信息,可以参考这篇文章,以及pgsql-ML中的这个讨论。
8.2 缓冲区管理器的结构
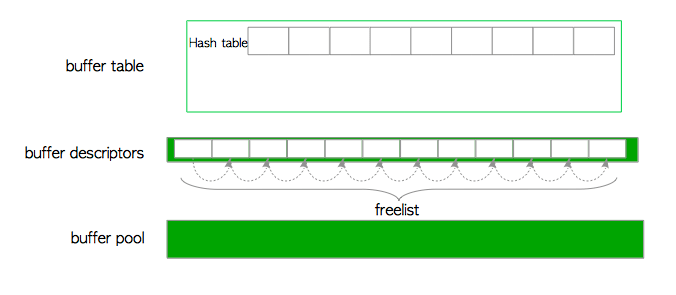
PostgreSQL缓冲区管理器由三层组成,即缓冲表层,缓冲区描述符层和缓冲池层(图8.3):
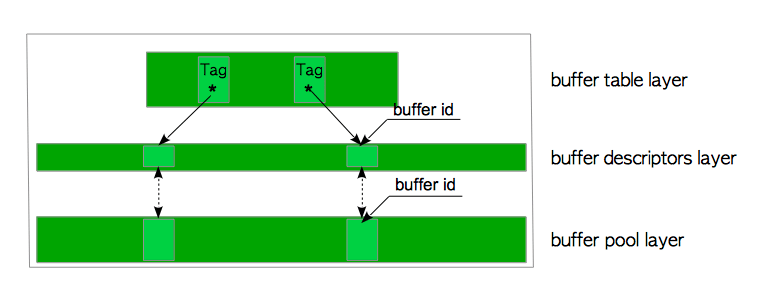
- 缓冲池(buffer pool) 层是一个数组。 每个槽都存储一个数据文件页,数组槽的索引称为
buffer_id。 - 缓冲区描述符(buffer descriptors) 层是一个由缓冲区描述符组成的数组。 每个描述符与缓冲池槽一一对应,并保存着相应槽的元数据。请注意,术语“缓冲区描述符层”只是在本章中为方便起见使用的术语。
- 缓冲表(buffer table) 层是一个哈希表,它存储着页面的
buffer_tag与描述符的buffer_id之间的映射关系。
这些层将在以下的节中详细描述。
8.2.1 缓冲表
缓冲表可以在逻辑上分为三个部分:散列函数,散列桶槽,以及数据项(图8.4)。
内置散列函数将buffer_tag映射到哈希桶槽。 即使散列桶槽的数量比缓冲池槽的数量要多,冲突仍然可能会发生。因此缓冲表采用了 使用链表的分离链接方法(separate chaining with linked lists) 来解决冲突。
当数据项被映射到至同一个桶槽时,该方法会将这些数据项保存在一个链表中,如图8.4所示。
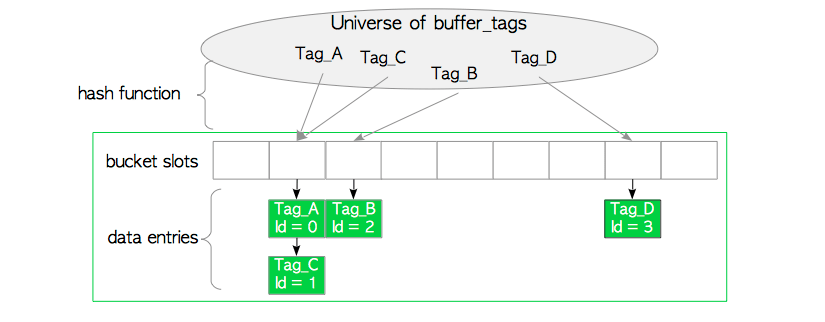
数据项包括两个值:页面的buffer_tag,以及包含页面元数据的描述符的buffer_id。例如数据项Tag_A,id=1 表示,buffer_id=1对应的缓冲区描述符中,存储着页面Tag_A的元数据。
散列函数
这里使用的散列函数是由
calc_bucket()与hash()组合而成。 下面是用伪函数表示的形式。
这里还没有对诸如查找、插入、删除数据项的基本操作进行解释。这些常见的操作将在后续小节详细描述。
8.2.2 缓冲区描述符
本节将描述缓冲区描述符的结构,下一小节将描述缓冲区描述符层。
缓冲区描述符保存着页面的元数据,这些与缓冲区描述符相对应的页面保存在缓冲池槽中。缓冲区描述符的结构由BufferDesc结构定义。这个结构有很多字段,主要字段如下所示:
-
tag保存着目标页面的buffer_tag,该页面存储在相应的缓冲池槽中(缓冲区标签的定义在8.1.2节给出)。 -
buffer_id标识了缓冲区描述符(亦相当于对应缓冲池槽的buffer_id)。 -
refcount保存当前访问相应页面的PostgreSQL进程数,也被称为钉数(pin count)。当PostgreSQL进程访问相应页面时,其引用计数必须自增1(refcount ++)。访问结束后其引用计数必须减1(refcount--)。 当refcount为零,即页面当前并未被访问时,页面将取钉(unpinned) ,否则它会被钉住(pinned)。 -
usage_count保存着相应页面加载至相应缓冲池槽后的访问次数。usage_count会在页面置换算法中被用到(第8.4.4节)。 -
context_lock和io_in_progress_lock是轻量级锁,用于控制对相关页面的访问。第8.3.2节将介绍这些字段。 -
flags用于保存相应页面的状态,主要状态如下:- 脏位(
dirty bit) 指明相应页面是否为脏页。 - 有效位(
valid bit) 指明相应页面是否可以被读写(有效)。例如,如果该位被设置为"valid",那就意味着对应的缓冲池槽中存储着一个页面,而该描述符中保存着该页面的元数据,因而可以对该页面进行读写。反之如果有效位被设置为"invalid",那就意味着该描述符中并没有保存任何元数据;即,对应的页面无法读写,缓冲区管理器可能正在将该页面换出。 - IO进行标记位(
io_in_progress) 指明缓冲区管理器是否正在从存储中读/写相应页面。换句话说,该位指示是否有一个进程正持有此描述符上的io_in_pregress_lock。
- 脏位(
-
freeNext是一个指针,指向下一个描述符,并以此构成一个空闲列表(freelist),细节在下一小节中介绍。
结构
BufferDesc定义于src/include/storage/buf_internals.h中。
为了简化后续章节的描述,这里定义三种描述符状态:
- 空(
Empty):当相应的缓冲池槽不存储页面(即refcount与usage_count都是0),该描述符的状态为空。 - 钉住(
Pinned):当相应缓冲池槽中存储着页面,且有PostgreSQL进程正在访问的相应页面(即refcount和usage_count都大于等于1),该缓冲区描述符的状态为钉住。 - 未钉住(
Unpinned):当相应的缓冲池槽存储页面,但没有PostgreSQL进程正在访问相应页面时(即usage_count大于或等于1,但refcount为0),则此缓冲区描述符的状态为未钉住。
每个描述符都处于上述状态之一。描述符的状态会根据特定条件而改变,这将在下一小节中描述。
在下图中,缓冲区描述符的状态用彩色方框表示。
- (白色)空
- (蓝色)钉住
- (青色)未钉住
此外,脏页面会带有“X”的标记。例如一个未固定的脏描述符用 表示。
8.2.3 缓冲区描述符层
缓冲区描述符的集合构成了一个数组。本书称该数组为缓冲区描述符层(buffer descriptors layer)。
当PostgreSQL服务器启动时,所有缓冲区描述符的状态都为空。在PostgreSQL中,这些描述符构成了一个名为 freelist 的链表,如图8.5所示。
请注意PostgreSQL中的
freelist完全不同于Oracle中freelists的概念。PostgreSQL的freelist只是空缓冲区描述符的链表。PostgreSQL中与Oracle中的freelist相对应的对象是空闲空间映射(FSM)(第5.3.4节)。
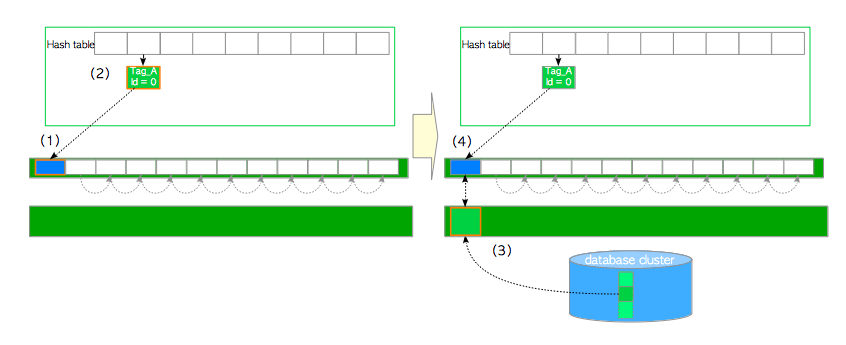
图8.6展示了第一个页面是如何加载的。
- 从
freelist的头部取一个空描述符,并将其钉住(即,将其refcount和usage_count增加1)。 - 在缓冲表中插入新项,该缓冲表项保存了页面
buffer_tag与所获描述符buffer_id之间的关系。 - 将新页面从存储器加载至相应的缓冲池槽中。
- 将新页面的元数据保存至所获取的描述符中。
第二页,以及后续页面都以类似方式加载,其他细节将在第8.4.2节中介绍。
从freelist中摘出的描述符始终保存着页面的元数据。换而言之,仍然在使用的非空描述符不会返还到freelist中。但当下列任一情况出现时,描述符状态将变为“空”,并被重新插入至freelist中:
- 相关表或索引已被删除。
- 相关数据库已被删除。
- 相关表或索引已经被
VACUUM FULL命令清理了。
为什么使用
freelist来维护空描述符?保留
freelist的原因是为了能立即获取到一个描述符。这是内存动态分配的常规做法,详情参阅这里的说明。
缓冲区描述符层包含着一个32位无符号整型变量 nextVictimBuffer 。此变量用于8.4.4节将介绍的页面置换算法。
8.2.4 缓冲池
缓冲池只是一个用于存储关系数据文件(例如表或索引)页面的简单数组。缓冲池数组的序号索引也就是buffer_id。
缓冲池槽的大小为8KB,等于页面大小,因而每个槽都能存储整个页面。
8.3 缓冲区管理器锁
缓冲区管理器会出于不同的目的使用各式各样的锁,本节将介绍理解后续部分所必须的一些锁。
注意本节中描述的锁,指的是缓冲区管理器同步机制的一部分。它们与SQL语句和SQL操作中的锁没有任何关系。
8.3.1 缓冲表锁
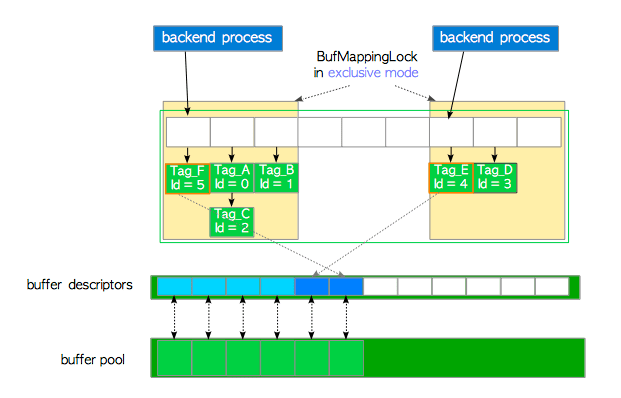
BufMappingLock 保护整个缓冲表的数据完整性。它是一种轻量级的锁,有共享模式与独占模式。在缓冲表中查询条目时,后端进程会持有共享的 BufMappingLock。插入或删除条目时,后端进程会持有独占的BufMappingLock。
BufMappingLock 会被分为多个分区,以减少缓冲表中的争用(默认为128个分区)。每个BufMappingLock分区都保护着一部分相应的散列桶槽。
图8.7给出了一个BufMappingLock分区的典型示例。两个后端进程可以同时持有各自分区的BufMappingLock独占锁以插入新的数据项。如果BufMappingLock是系统级的锁,那么其中一个进程就需要等待另一个进程完成处理。
缓冲表也需要许多其他锁。例如,在缓冲表内部会使用 自旋锁(spin lock) 来删除数据项。不过本章不需要其他这些锁的相关知识,因此这里省略了对其他锁的介绍。
在9.4版本之前,
BufMappingLock在默认情况下被分为16个独立的锁。
8.3.2 缓冲区描述符相关的锁
每个缓冲区描述符都会用到两个轻量级锁 —— content_lock 与 io_in_progress_lock,来控制对相应缓冲池槽页面的访问。当检查或更改描述符本身字段的值时,则会用到自旋锁。
8.3.2.1 内容锁(content_lock)
content_lock是一个典型的强制限制访问的锁。它有两种模式:共享(shared) 与独占(exclusive)。
当读取页面时,后端进程以共享模式获取页面相应缓冲区描述符中的content_lock。
但执行下列操作之一时,则会获取独占模式的content_lock:
- 将行(即元组)插入页面,或更改页面中元组的
t_xmin/t_xmax字段时(t_xmin和t_xmax在第5.2节中介绍,简单地说,这些字段会在相关元组被删除或更新行时发生更改)。 - 物理移除元组,或压紧页面上的空闲空间(由清理过程和HOT执行,分别在第6章和第7章中介绍)。
- 冻结页面中的元组(冻结过程在第5.10.1节与第6.3节中介绍)。
官方README文件包含更多的细节。
8.3.2.2 IO进行锁(io_in_progress_lock)
io_in_progress_lock用于等待缓冲区上的I/O完成。当PostgreSQL进程加载/写入页面数据时,该进程在访问页面期间,持有对应描述符上独占的io_in_progres_lock。
8.3.2.3 自旋锁(spinlock)
当检查或更改标记字段与其他字段时(例如refcount和usage_count),会用到自旋锁。下面是两个使用自旋锁的具体例子:
- 下面是钉住缓冲区描述符的例子:
- 获取缓冲区描述符上的自旋锁。
- 将其
refcount和usage_count的值增加1。 - 释放自旋锁。
-
下面是将脏位设置为
"1"的例子:- 获取缓冲区描述符上的自旋锁。
- 使用位操作将脏位置位为
"1"。 - 释放自旋锁。
-
其他标记位也是通过同样的方式来设置的。
用原子操作替换缓冲区管理器的自旋锁
在9.6版本中,缓冲区管理器的自旋锁被替换为原子操作,可以参考这个提交日志的内容。如果想进一步了解详情,可以参阅这里的讨论。
附,9.6版本中缓冲区描述符的数据结构定义。
8.4 缓冲区管理器的工作原理
本节介绍缓冲区管理器的工作原理。当后端进程想要访问所需页面时,它会调用ReadBufferExtended函数。
函数ReadBufferExtended的行为依场景而异,在逻辑上具体可以分为三种情况。每种情况都将用一小节介绍。最后一小节将介绍PostgreSQL中基于 时钟扫描(clock-sweep) 的页面置换算法。
8.4.1 访问存储在缓冲池中的页面
首先来介绍最简单的情况,即,所需页面已经存储在缓冲池中。在这种情况下,缓冲区管理器会执行以下步骤:
- 创建所需页面的
buffer_tag(在本例中buffer_tag是'Tag_C'),并使用散列函数计算与描述符相对应的散列桶槽。 - 获取相应散列桶槽分区上的
BufMappingLock共享锁(该锁将在步骤(5)中被释放)。 - 查找标签为
"Tag_C"的条目,并从条目中获取buffer_id。本例中buffer_id为2。 - 将
buffer_id=2的缓冲区描述符钉住,即将描述符的refcount和usage_count增加1(8.3.2节描述了钉住)。 - 释放
BufMappingLock。 - 访问
buffer_id=2的缓冲池槽。
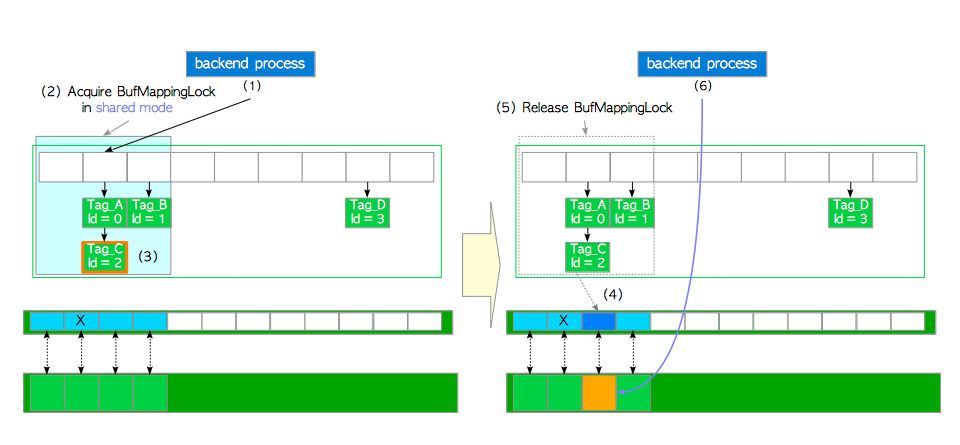
然后,当从缓冲池槽中的页面里读取行时,PostgreSQL进程获取相应缓冲区描述符的共享content_lock。因而缓冲池槽可以同时被多个进程读取。
当向页面插入(及更新、删除)行时,该postgres后端进程获取相应缓冲区描述符的独占content_lock(注意这里必须将相应页面的脏位置位为"1")。
访问完页面后,相应缓冲区描述符的引用计数值减1。
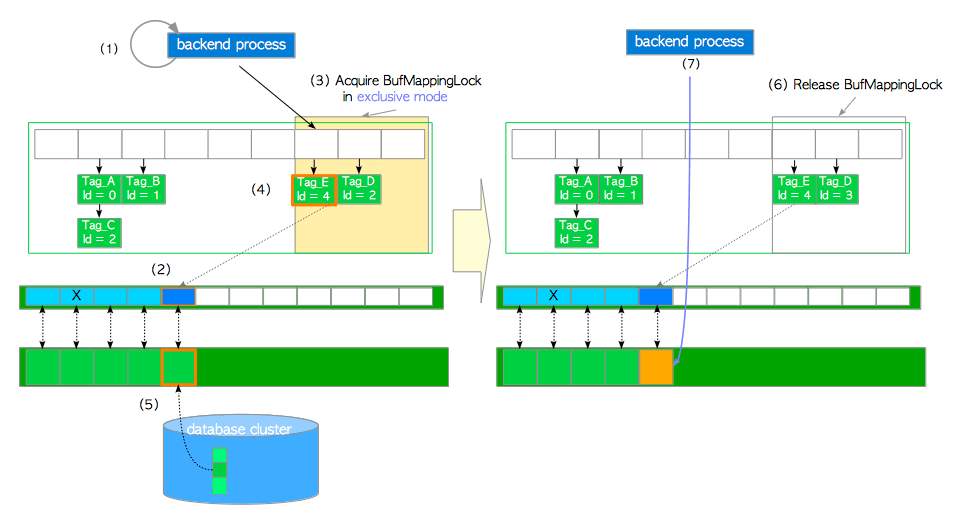
8.4.2 将页面从存储加载至空槽
在第二种情况下,假设所需页面不在缓冲池中,且freelist中有空闲元素(空描述符)。在这种情况下,缓冲区管理器将执行以下步骤:
-
查找缓冲区表(本节假设页面不存在,找不到对应页面)。
-
创建所需页面的
buffer_tag(本例中buffer_tag为'Tag_E')并计算其散列桶槽。 -
以共享模式获取相应分区上的
BufMappingLock。 -
查找缓冲区表(根据假设,这里没找到)。
-
释放
BufMappingLock。
-
-
从
freelist中获取空缓冲区描述符,并将其钉住。在本例中所获的描述符buffer_id=4。 -
以独占模式获取相应分区的
BufMappingLock(此锁将在步骤(6)中被释放)。 -
创建一条新的缓冲表数据项:
buffer_tag='Tag_E’, buffer_id=4,并将其插入缓冲区表中。 -
将页面数据从存储加载至
buffer_id=4的缓冲池槽中,如下所示:-
以排他模式获取相应描述符的
io_in_progress_lock。 -
将相应描述符的
IO_IN_PROGRESS标记位设置为1,以防其他进程访问。 -
将所需的页面数据从存储加载到缓冲池插槽中。
-
更改相应描述符的状态;将
IO_IN_PROGRESS标记位置位为"0",且VALID标记位被置位为"1"。 -
释放
io_in_progress_lock。
-
-
释放相应分区的
BufMappingLock。 -
访问
buffer_id=4的缓冲池槽。
8.4.3 将页面从存储加载至受害者缓冲池槽中
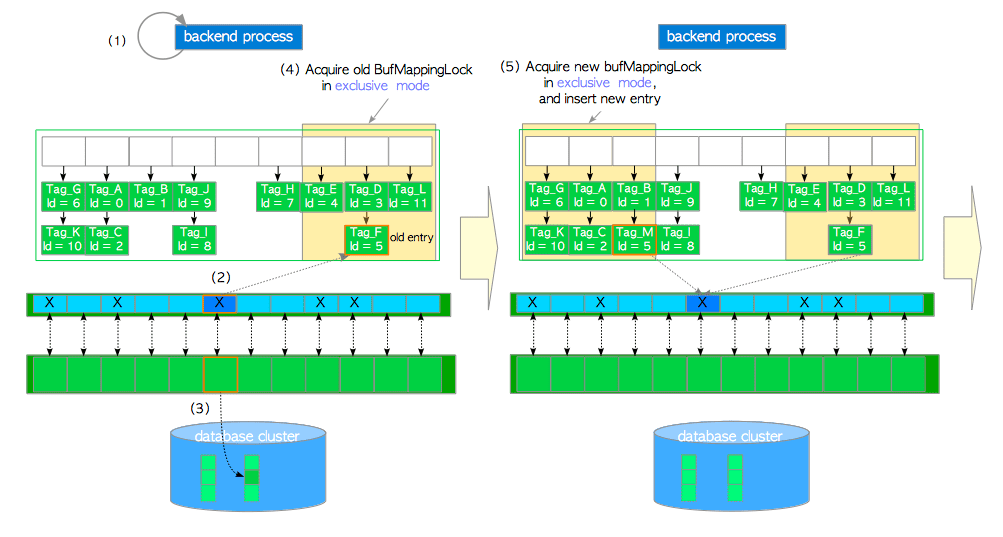
在这种情况下,假设所有缓冲池槽位都被页面占用,且未存储所需的页面。缓冲区管理器将执行以下步骤:
-
创建所需页面的
buffer_tag并查找缓冲表。在本例中假设buffer_tag是'Tag_M'(且相应的页面在缓冲区中找不到)。 -
使用时钟扫描算法选择一个受害者缓冲池槽位,从缓冲表中获取包含着受害者槽位
buffer_id的旧表项,并在缓冲区描述符层将受害者槽位的缓冲区描述符钉住。本例中受害者槽的buffer_id=5,旧表项为Tag_F, id = 5。时钟扫描将在下一节中介绍。 -
如果受害者页面是脏页,将其刷盘(
write & fsync),否则进入步骤(4)。在使用新数据覆盖脏页之前,必须将脏页写入存储中。脏页的刷盘步骤如下:
-
获取
buffer_id=5描述符上的共享content_lock和独占io_in_progress_lock(在步骤6中释放)。 -
更改相应描述符的状态:相应
IO_IN_PROCESS位被设置为"1",JUST_DIRTIED位设置为"0"。 -
根据具体情况,调用
XLogFlush()函数将WAL缓冲区上的WAL数据写入当前WAL段文件(详细信息略,WAL和XLogFlush函数在第9章中介绍)。 -
将受害者页面的数据刷盘至存储中。
-
更改相应描述符的状态;将
IO_IN_PROCESS位设置为"0",将VALID位设置为"1"。 -
释放
io_in_progress_lock和content_lock。
-
-
以排他模式获取缓冲区表中旧表项所在分区上的
BufMappingLock。 -
获取新表项所在分区上的
BufMappingLock,并将新表项插入缓冲表:- 创建由新表项:由
buffer_tag='Tag_M'与受害者的buffer_id组成的新表项。 - 以独占模式获取新表项所在分区上的
BufMappingLock。 - 将新表项插入缓冲区表中。
- 创建由新表项:由
-
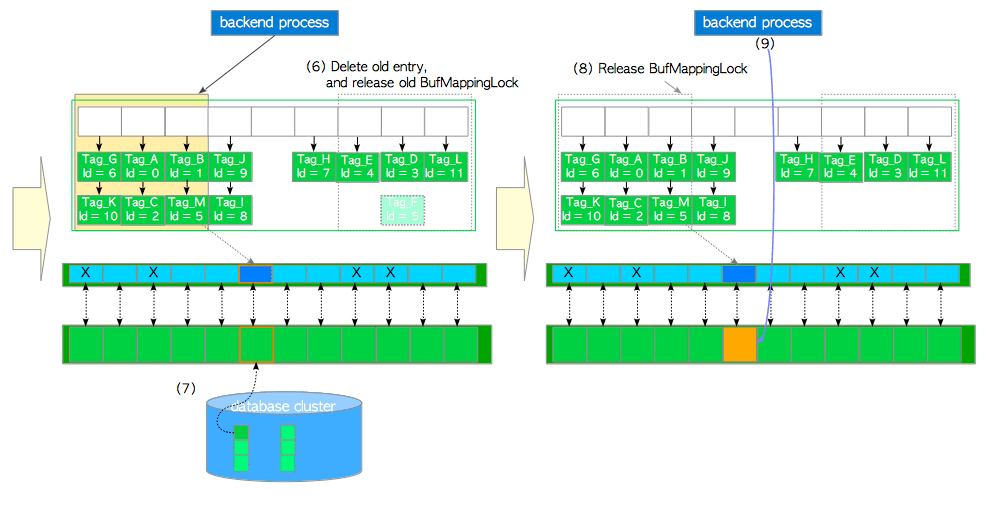
从缓冲表中删除旧表项,并释放旧表项所在分区的
BufMappingLock。 -
将目标页面数据从存储加载至受害者槽位。然后用
buffer_id=5更新描述符的标识字段;将脏位设置为0,并按流程初始化其他标记位。 -
释放新表项所在分区上的
BufMappingLock。 -
访问
buffer_id=5对应的缓冲区槽位。
8.4.4 页面替换算法:时钟扫描
本节的其余部分介绍了 时钟扫描(clock-sweep) 算法。该算法是 NFU(Not Frequently Used) 算法的变体,开销较小,能高效地选出较少使用的页面。
我们将缓冲区描述符想象为一个循环列表(如图8.12所示)。而nextVictimBuffer是一个32位的无符号整型变量,它总是指向某个缓冲区描述符并按顺时针顺序旋转。该算法的伪代码与算法描述如下:
伪代码:时钟扫描
- 获取
nextVictimBuffer指向的候选缓冲区描述符(candidate buffer descriptor)。- 如果候选描述符未被钉住(unpinned),则进入步骤(3), 否则进入步骤(4)。
- 如果候选描述符的
usage_count为0,则选择该描述符对应的槽作为受害者,并进入步骤(5);否则将此描述符的usage_count减1,并继续执行步骤(4)。- 将
nextVictimBuffer迭代至下一个描述符(如果到末尾则回绕至头部)并返回步骤(1)。重复至找到受害者。- 返回受害者的
buffer_id。
具体的例子如图8.12所示。缓冲区描述符为蓝色或青色的方框,框中的数字显示每个描述符的usage_count。
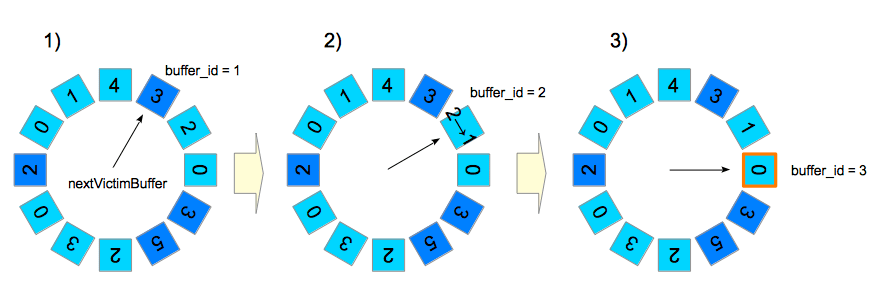
nextVictimBuffer指向第一个描述符(buffer_id = 1);但因为该描述符被钉住了,所以跳过。extVictimBuffer指向第二个描述符(buffer_id = 2)。该描述符未被钉住,但其usage_count为2;因此该描述符的usage_count将减1,而nextVictimBuffer迭代至第三个候选描述符。nextVictimBuffer指向第三个描述符(buffer_id = 3)。该描述符未被钉住,但其usage_count = 0,因而成为本轮的受害者。
当nextVictimBuffer扫过未固定的描述符时,其usage_count会减1。因此只要缓冲池中存在未固定的描述符,该算法总能在旋转若干次nextVictimBuffer后,找到一个usage_count为0的受害者。
8.4.5 环形缓冲区
在读写大表时,PostgreSQL会使用 环形缓冲区(ring buffer) 而不是缓冲池。环形缓冲器是一个很小的临时缓冲区域。当满足下列任一条件时,PostgreSQL将在共享内存中分配一个环形缓冲区:
-
批量读取
当扫描关系读取数据的大小超过缓冲池的四分之一(
shared_buffers/4)时,在这种情况下,环形缓冲区的大小为256 KB。 -
批量写入
当执行下列SQL命令时,这种情况下,环形缓冲区大小为16 MB。
COPY FROM命令。
-
清理过程
当自动清理守护进程执行清理过程时,这种情况环形缓冲区大小为256 KB。
分配的环形缓冲区将在使用后被立即释放。
环形缓冲区的好处显而易见,如果后端进程在不使用环形缓冲区的情况下读取大表,则所有存储在缓冲池中的页面都会被移除(踢出),因而会导致缓存命中率降低。环形缓冲区可以避免此问题。
为什么批量读取和清理过程的默认环形缓冲区大小为256 KB?
为什么是256 KB?源代码中缓冲区管理器目录下的README中解释了这个问题。
顺序扫描使用256KB的环缓冲。它足够小,因而能放入L2缓存中,从而使得操作系统缓存到共享缓冲区的页面传输变得高效。通常更小一点也可以,但环形缓冲区必需足够大到能同时容纳扫描中被钉住的所有页面。
8.4.6 临时表与本地缓冲区
后端创建临时表时,缓冲区管理器会分配一块该后端私有的内存区域并创建本地缓冲区(local buffer)。共享缓冲池槽使用正数标识,而本地缓冲池槽使用负数,例如-1、-2;因此同一后端可以用统一接口访问普通表和临时表。
只有所有者后端能够访问本地缓冲区,所以管理它们不需要进程间锁;临时表数据也不需要写WAL或参与检查点。
8.5 PostgreSQL中的异步I/O
PostgreSQL 18(2025年)引入了**异步I/O(Asynchronous I/O,AIO)**来提高读取性能。缓冲区管理器也因此进行了重构,尤其是执行器进行顺序扫描、位图堆扫描,以及VACUUM顺序读取目标页面的场景。当前PostgreSQL的AIO尚不支持异步写入。
本节介绍AIO的基本概念、PostgreSQL中的实现方式,以及以顺序扫描为重点的具体运行过程。对于不熟悉io_uring的读者,附录A.2给出了两个精简程序。
如何看待AIO基准测试: PostgreSQL的AIO主要优化顺序扫描等操作中的连续块读取,不用于索引扫描;它在缓冲池较冷时收益最大。随着缓冲池升温、缓存命中率提高,收益会逐渐下降。因此,只在冷缓存条件下得到的测试结果可能会明显高估AIO在真实工作负载中的影响。
8.5.1 异步I/O
图8.15比较了传统同步读取与异步读取的执行流程。为了简化说明,图中省略了操作系统页面缓存。
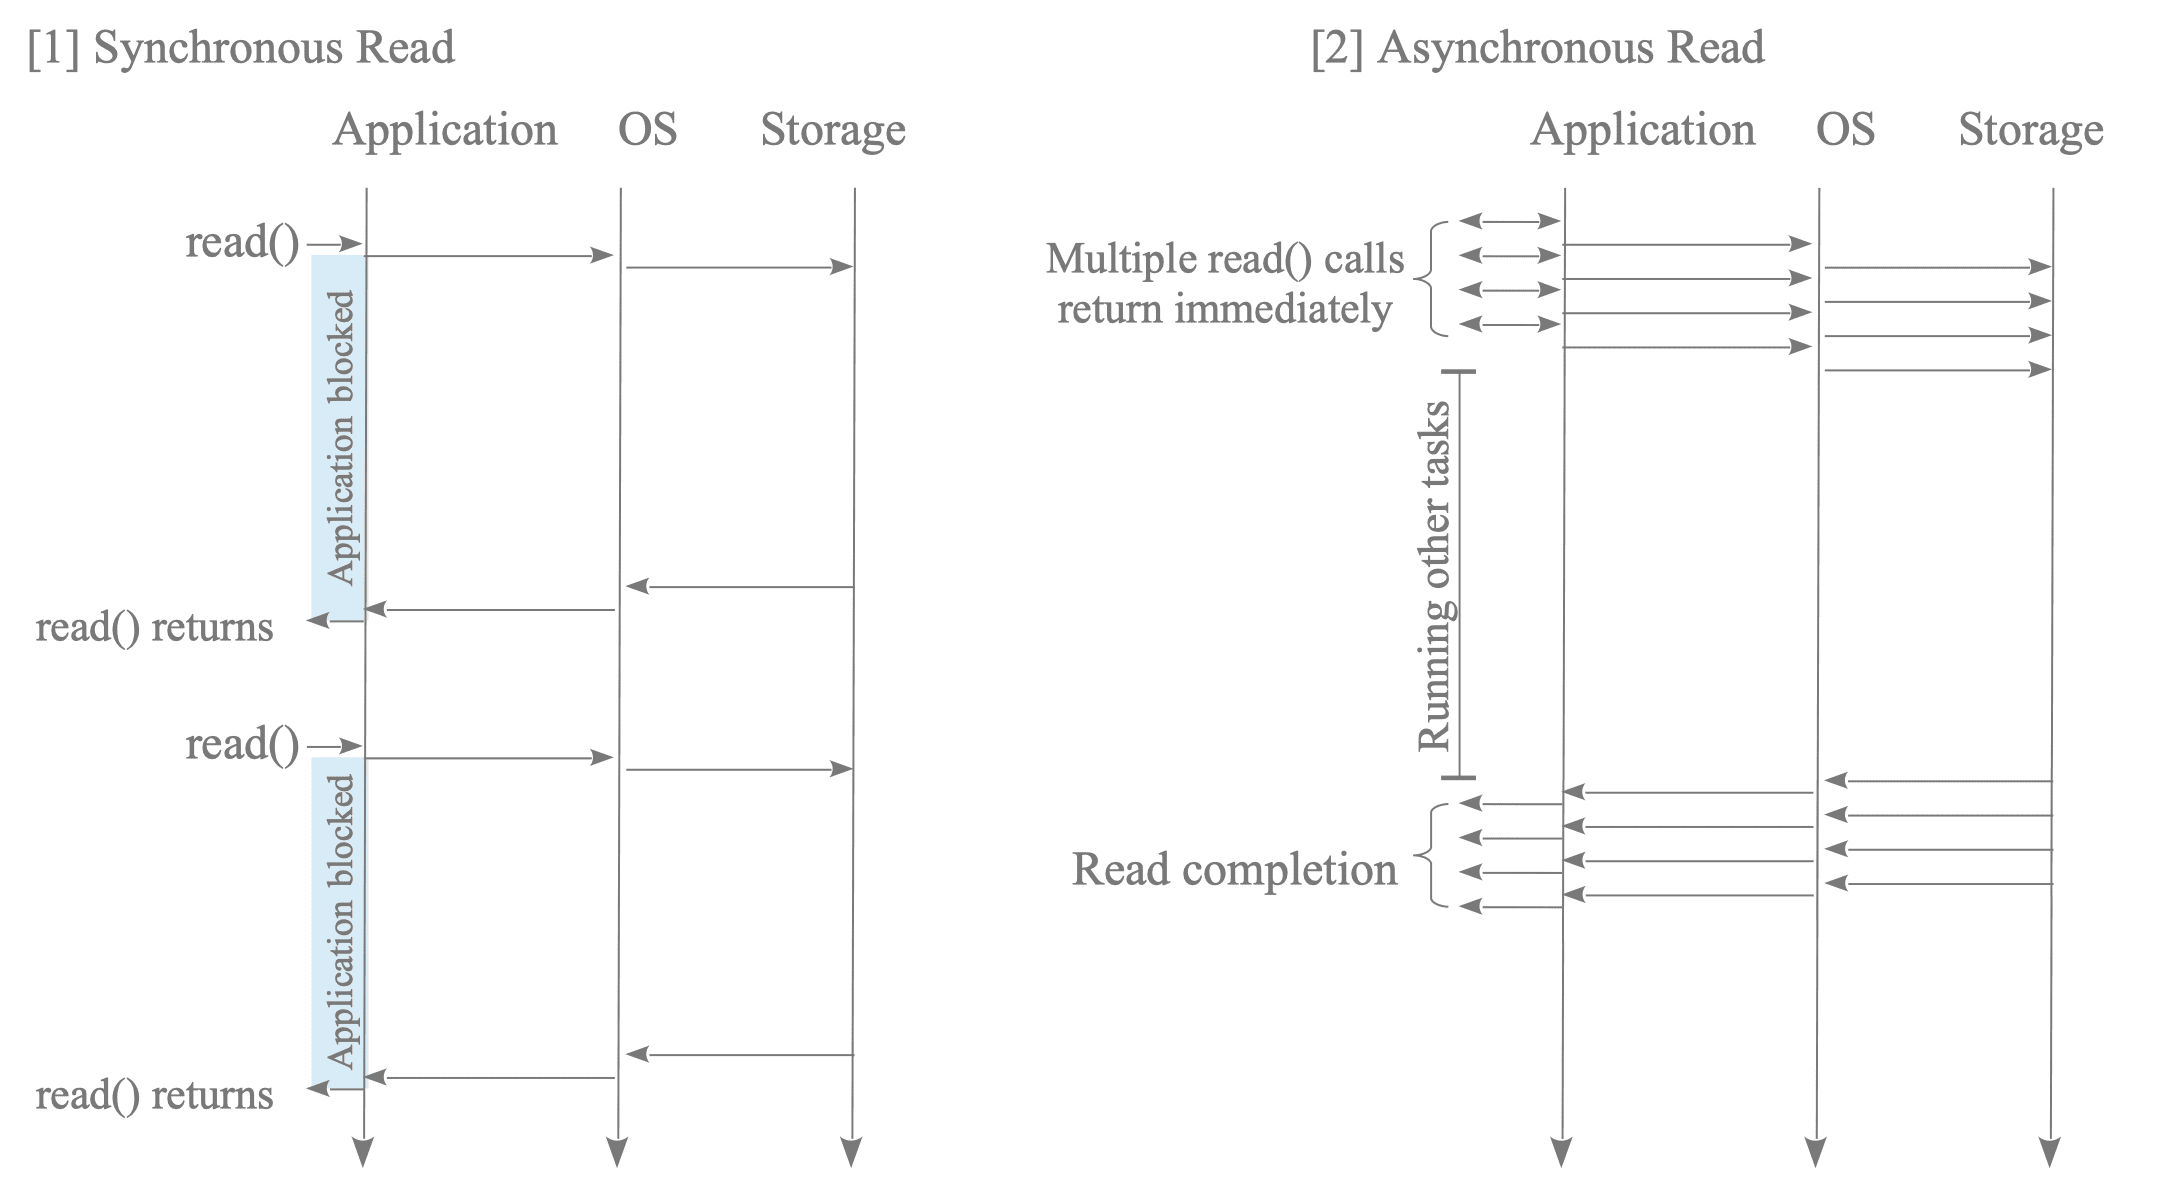
- 同步读取: 应用发出一次
read()系统调用,等待它完成后再发出下一次请求,因此多次读取按顺序串行执行。 - 异步读取: 应用无需等待单个请求完成即可提交多个读取请求;操作系统在后台处理这些请求,应用稍后再收集结果。
8.5.1.1 AIO的优势
异步I/O能同时为应用与存储设备带来性能收益:
- 应用层: 应用可以在等待读取完成期间执行其他任务。
- 存储层: SSD,特别是NVMe SSD,具有多队列与较深的队列深度,可以并行处理多个I/O请求;一次发出多个读取请求能更充分地利用这种并行性。
PostgreSQL因此可以同时发出许多页面读取请求,让操作系统与现代SSD发挥内部并行能力,从而提高缓冲池装载和大表扫描的吞吐量。
8.5.2 PostgreSQL中的AIO实现
PostgreSQL提供两种异步I/O实现:Linux上的io_uring,以及由后台工作进程执行I/O的io_worker。可以使用io_method参数进行选择;macOS、BSD等不支持io_uring的系统需要使用io_worker。
8.5.2.1 io_uring
io_uring是Linux 5.1(2019年)引入的异步I/O接口。PostgreSQL使用一对由用户空间与内核共享的环形缓冲区:提交队列(Submission Queue,SQ)和完成队列(Completion Queue,CQ)。
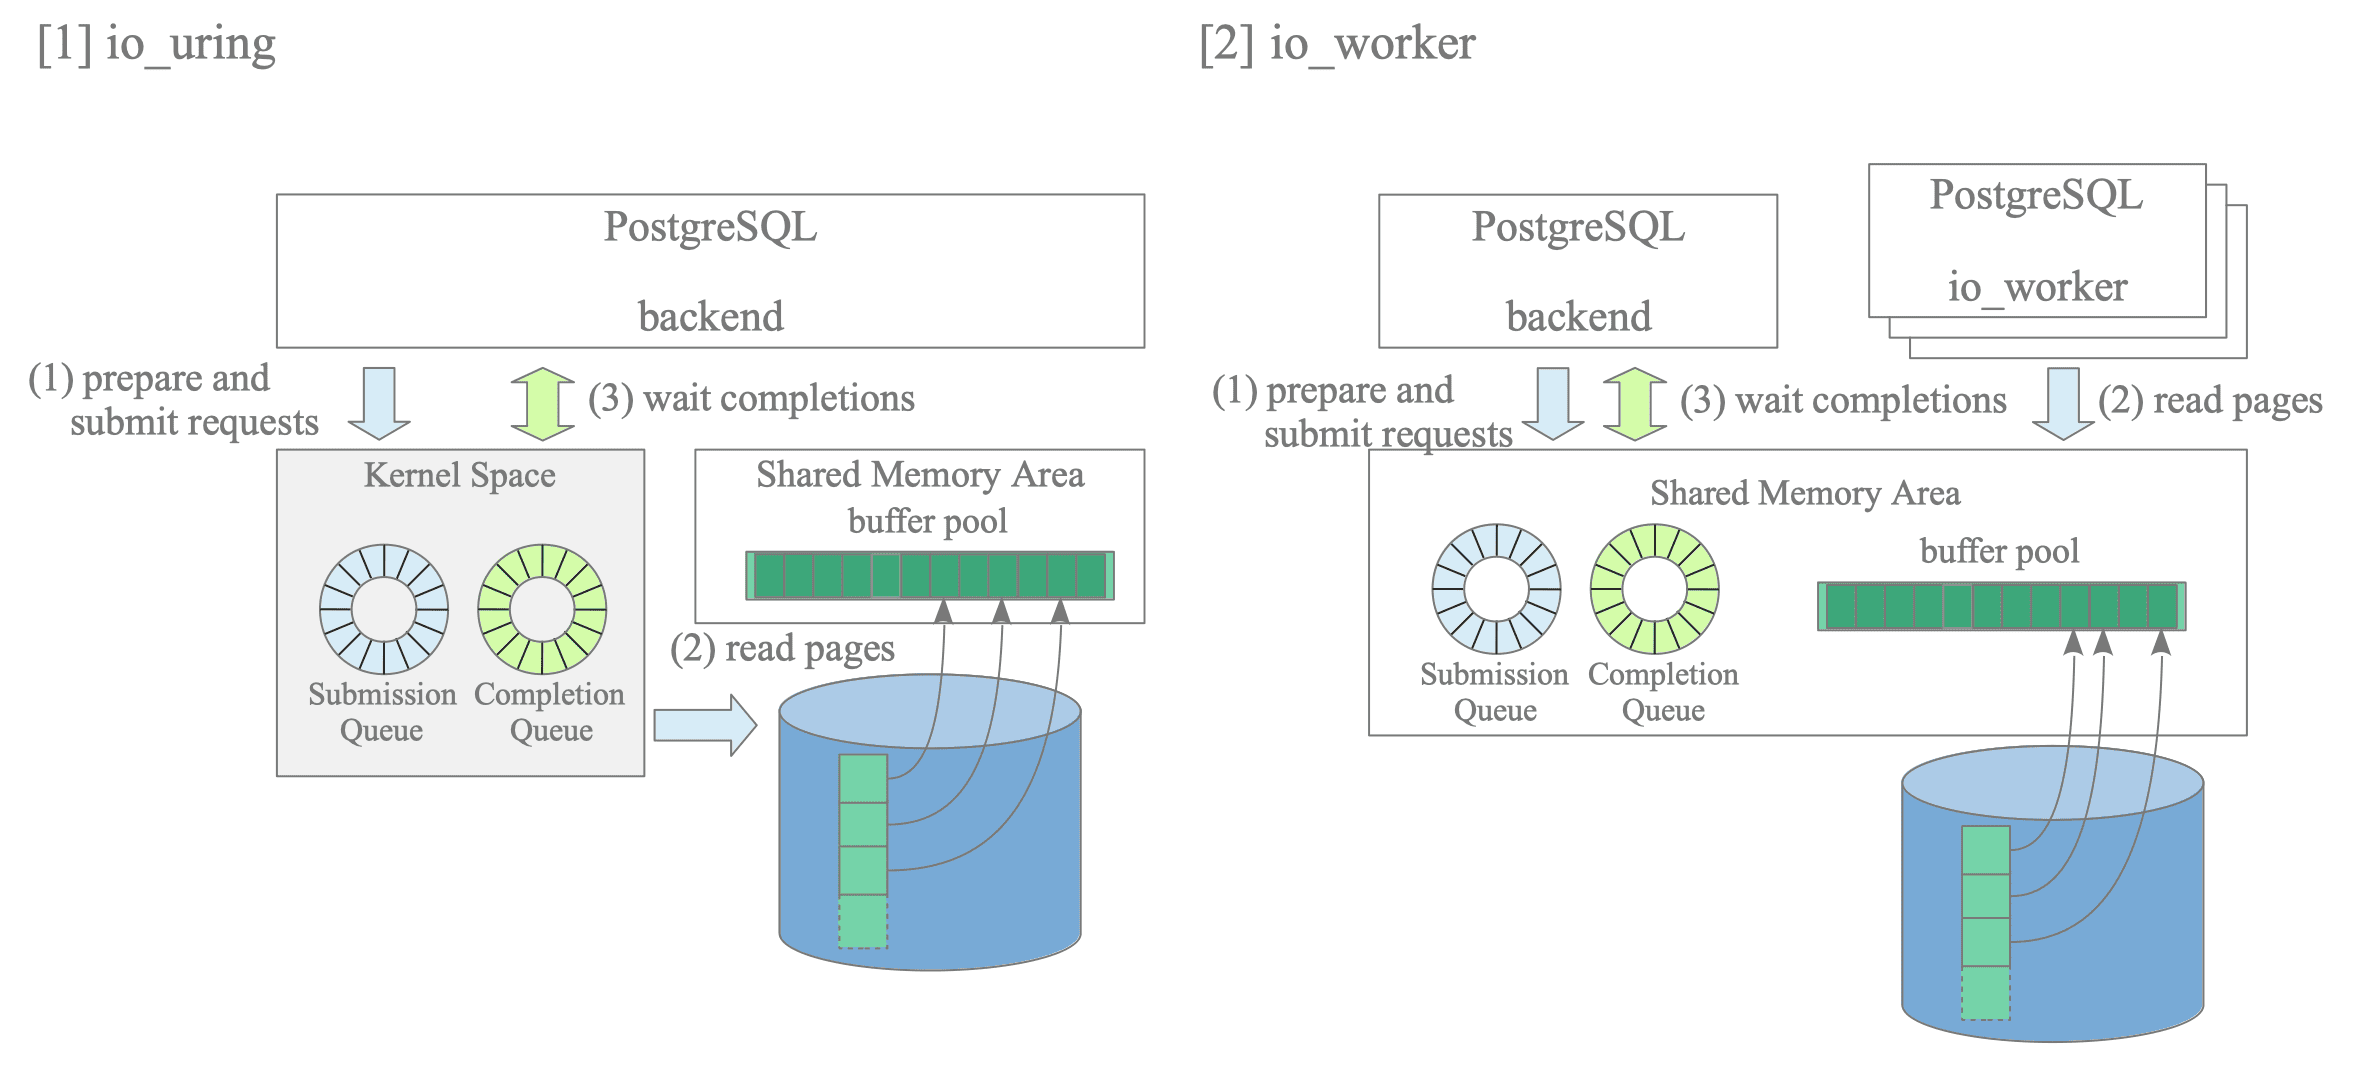
使用io_uring读取时,处理过程如下:
- 准备并提交请求: PostgreSQL准备一个或多个读取请求,将它们放入SQ并提交给内核。
- 执行请求: 内核从SQ取出请求,利用存储设备的并行能力执行读取。数据通过DMA直接复制到指定的缓冲池槽;操作完成后,内核把完成事件(CQE)放入CQ。
- 等待完成: PostgreSQL等待CQ中出现完成事件,然后即可读取已经装入目标缓冲池槽的页面。
从PostgreSQL的视角看,一个读取请求由数据库页面标识BufferTag与缓冲池槽标识buffer_id组成。使用io_uring时,PostgreSQL会把它们转换为操作系统参数:目标文件描述符、物理字节偏移、8 KB读取长度,以及目标缓冲池槽的内存地址。
向量I/O(分散—聚集I/O)
Linux与Unix通过readv()、writev()支持向量I/O,可以在一次系统调用中读写多个连续块。io_uring同样支持向量I/O,因此PostgreSQL可以用单个请求读取多个连续的关系块。
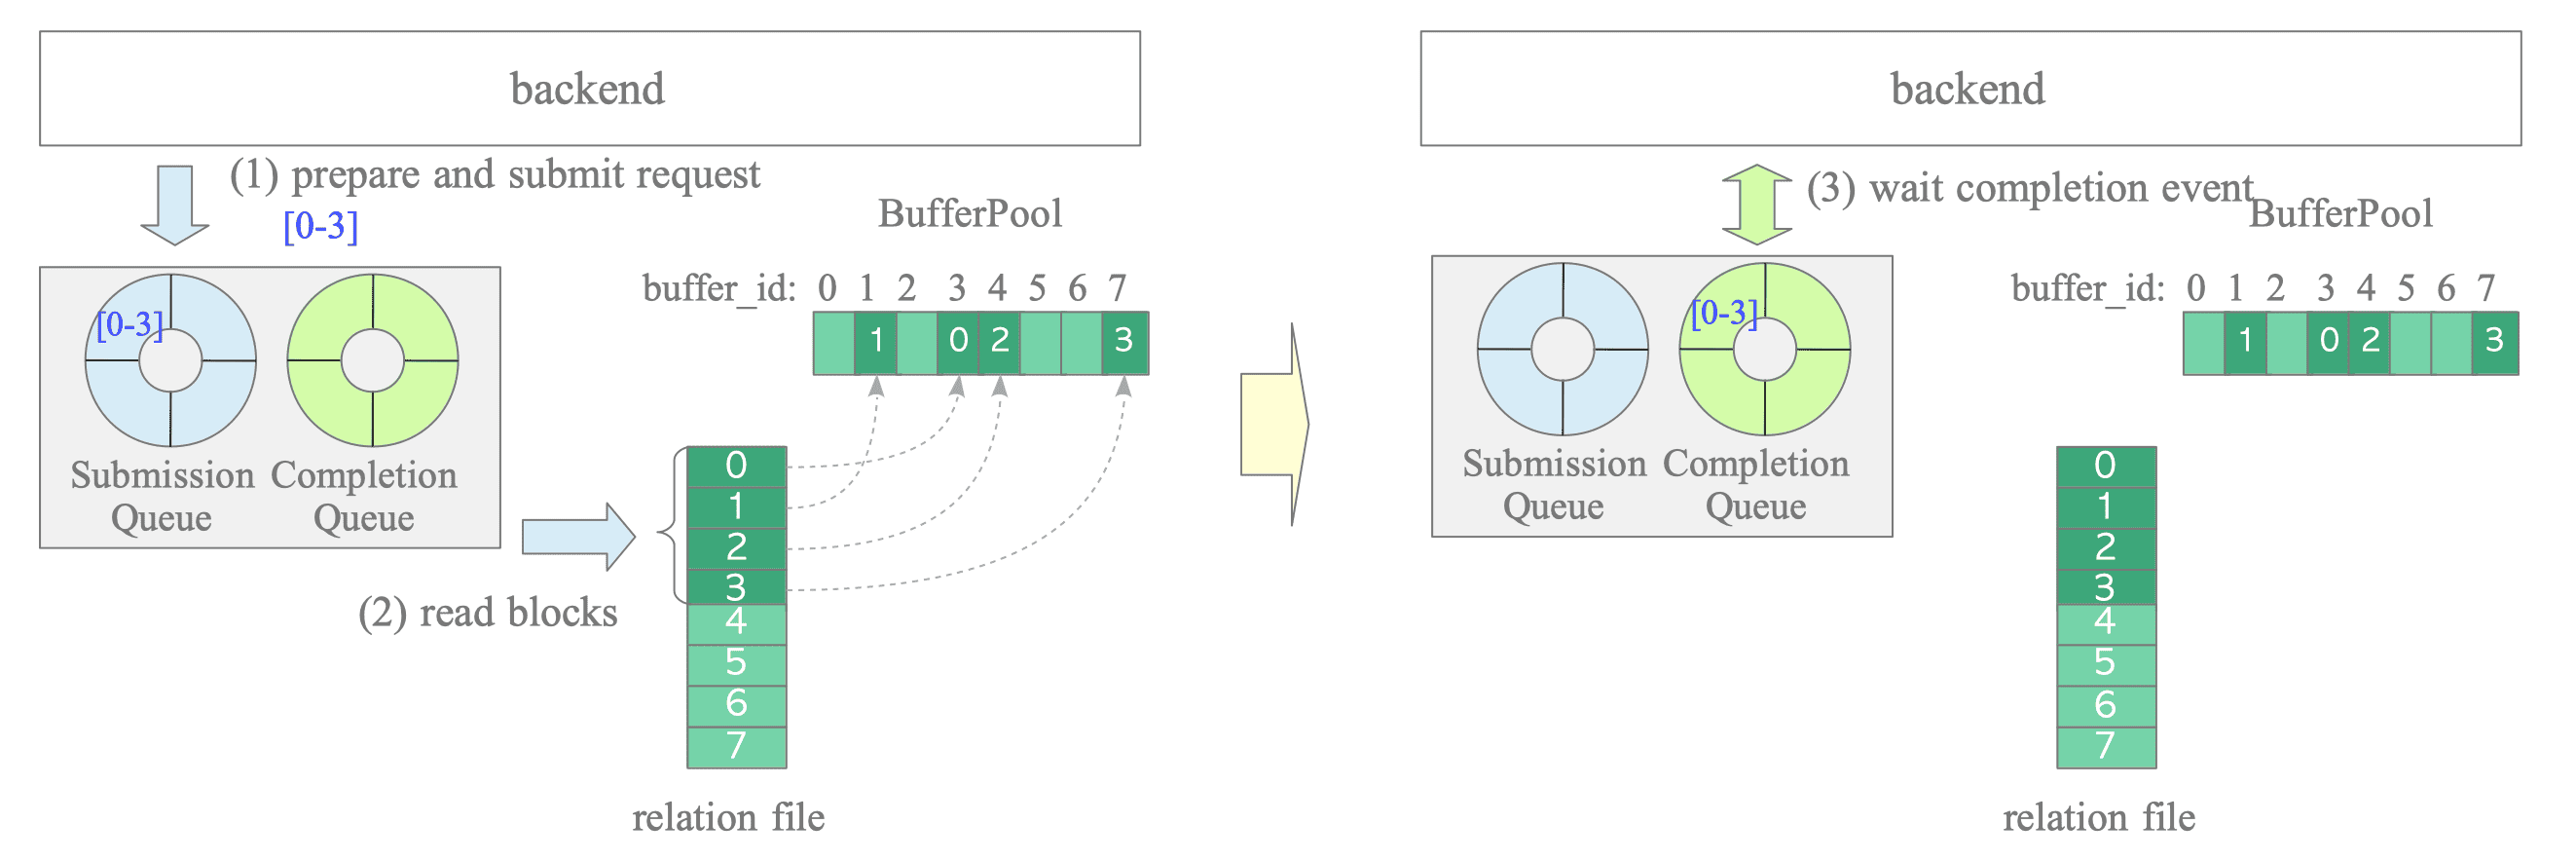
如图8.17所示,PostgreSQL读取连续块时会准备一次io_uring_prep_readv()调用,而不是为每个块分别执行一次系统调用:
- 后端为关系块0至3准备一个向量读取请求,并指定目标缓冲池槽3、1、4、7。
- 内核把各块读入指定的缓冲池槽。
- PostgreSQL只需等待一个完成事件,即可处理所有已装载页面。
顺序扫描通常读取连续关系块,向量I/O把它们合并成一个请求,既减少系统调用开销,也只产生一个完成事件。
8.5.2.2 io_worker
对于不支持io_uring的操作系统,PostgreSQL提供io_worker实现。一个或多个io_worker后台工作进程负责执行I/O请求。PostgreSQL在共享内存中维护自己的SQ与CQ;后端把读取请求放入SQ,io_worker取出并执行读取,再把完成事件写入CQ。
与io_uring相比:
io_worker使用传统同步读取系统调用执行单个请求。多个worker可以并发处理请求,但并行度和扩展能力通常弱于io_uring。- 后端与
io_worker需要通过共享内存队列和进程唤醒机制协调,因此会产生额外的通信与调度开销。
PostgreSQL 18中I/O worker数量由io_workers固定指定;PostgreSQL 19开发版改为通过io_min_workers、io_max_workers、io_worker_idle_timeout与io_worker_launch_interval动态调整。
8.5.3 异步顺序扫描的基本原理
AIO顺序扫描本身只依赖少量基础函数,但为了优化性能而组合的组件较多。下面先使用一个高度简化的冷启动模型说明基本行为:假设缓冲池中没有任何目标页面,所有数据都需要从存储读取。下一小节再补入真实实现中的缓存命中、自适应预读与快速路径。
在以下伪代码中:
BufferAlloc()抽象了除物理读取外的缓冲区描述符管理。- 省略PIN等低层细节。
do_exec(tuple)代表过滤条件求值、聚合增量计算等元组处理。
8.5.3.1 ReadStream与stream_buffers抽象
AIO顺序扫描的基本策略很直接:从头开始顺序处理目标表页面,同时提前异步预读一定数量的块。缓冲区管理器使用ReadStream结构跟踪和管理这些预读块。
ReadStream包含buffers[]数组及若干元数据。该数组是一个循环FIFO队列,有效窗口大小由combine_distance决定;oldest_buffer_index指向最早尚未消费的缓冲区:
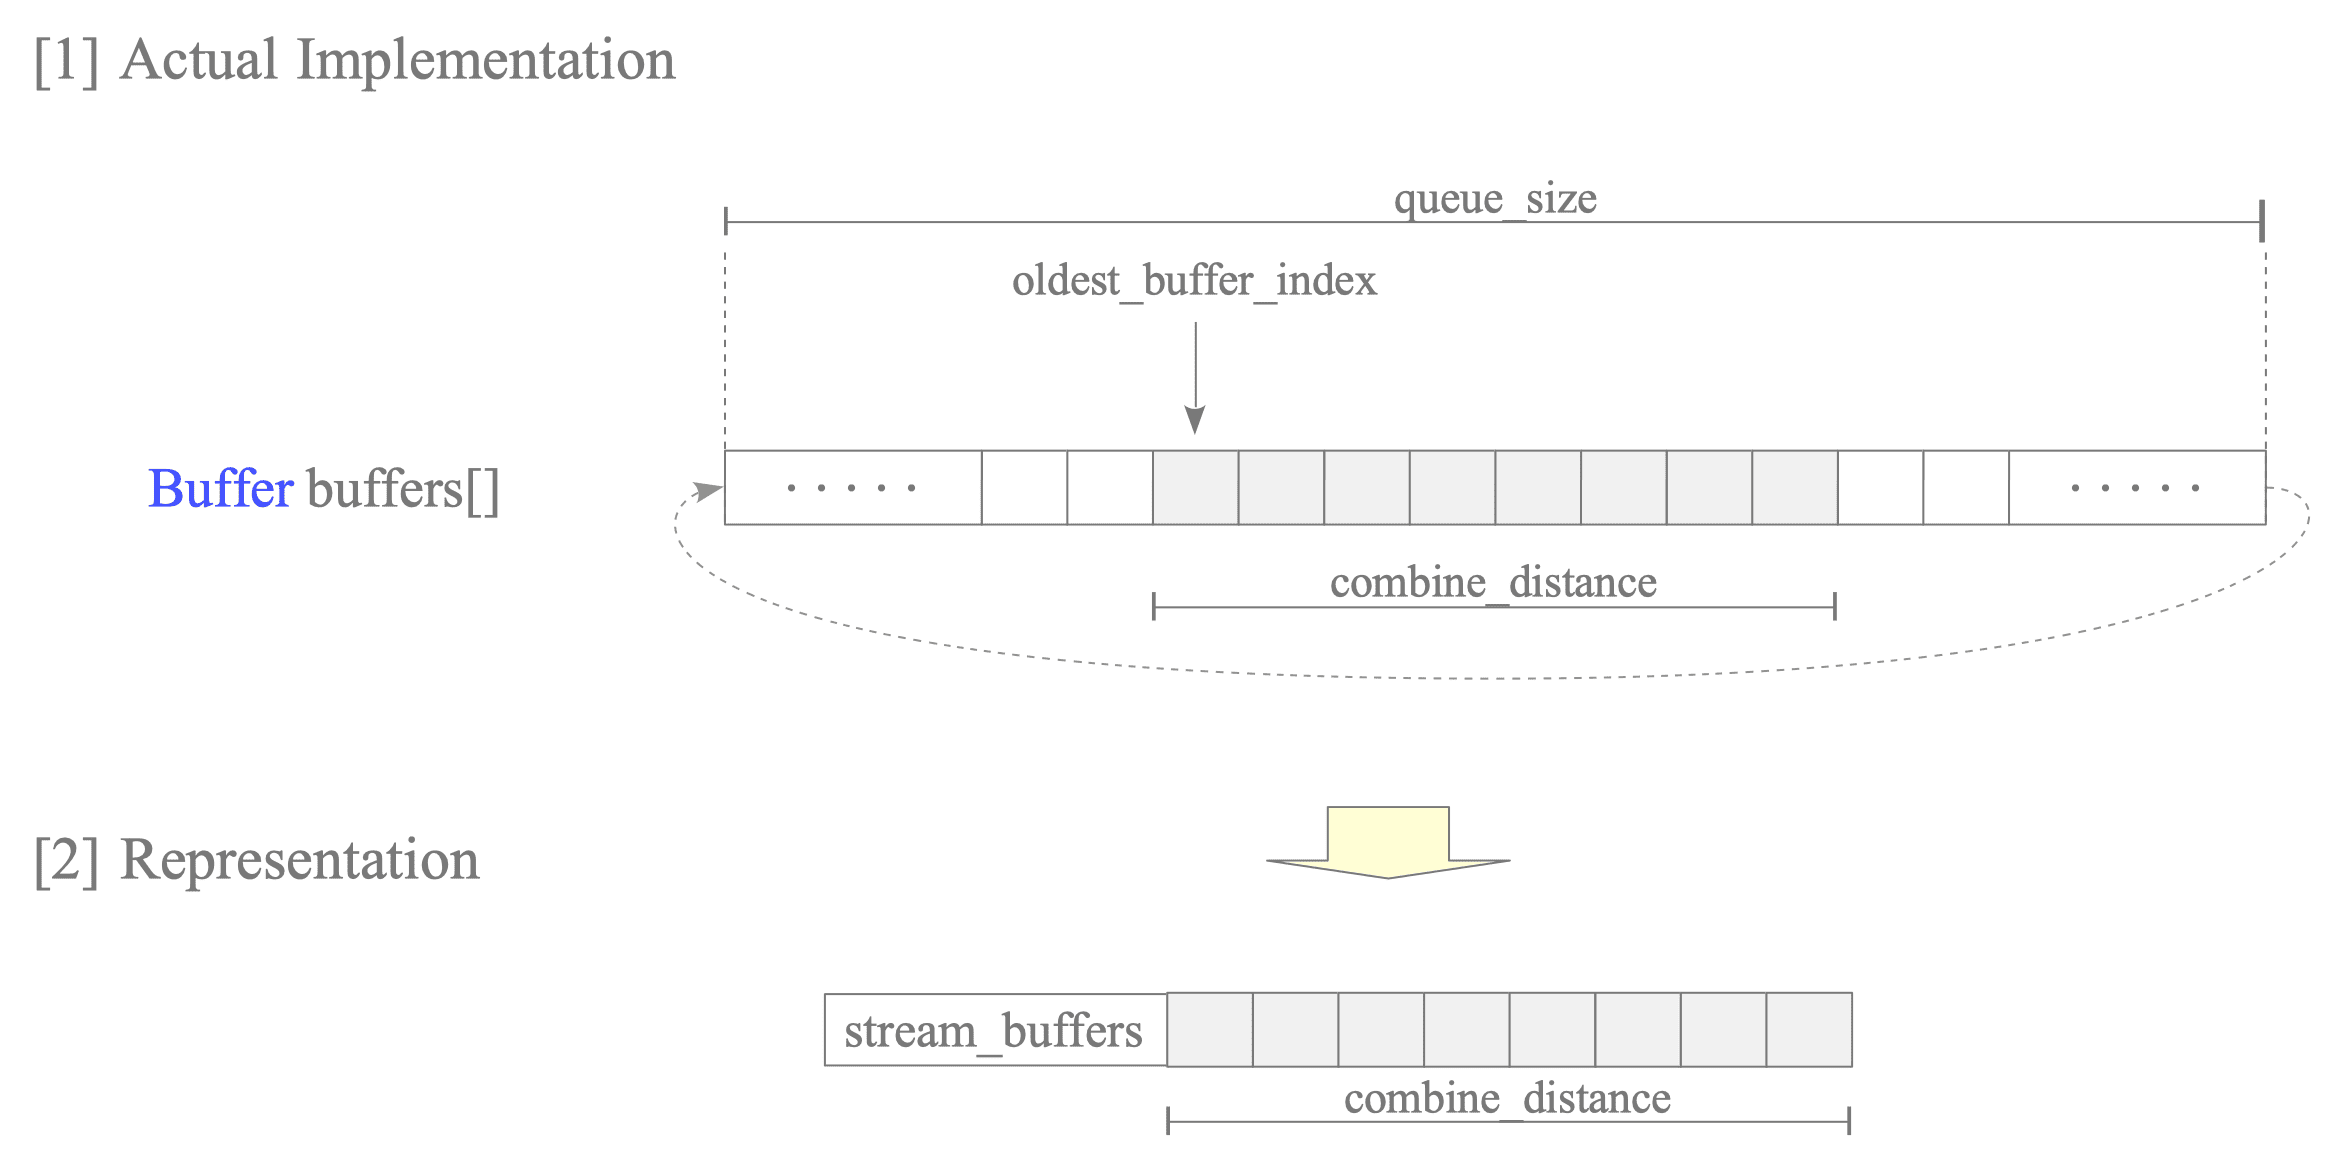
为了隐藏循环队列的底层指针运算,下文把整个FIFO队列简化表示为stream_buffers。
入队
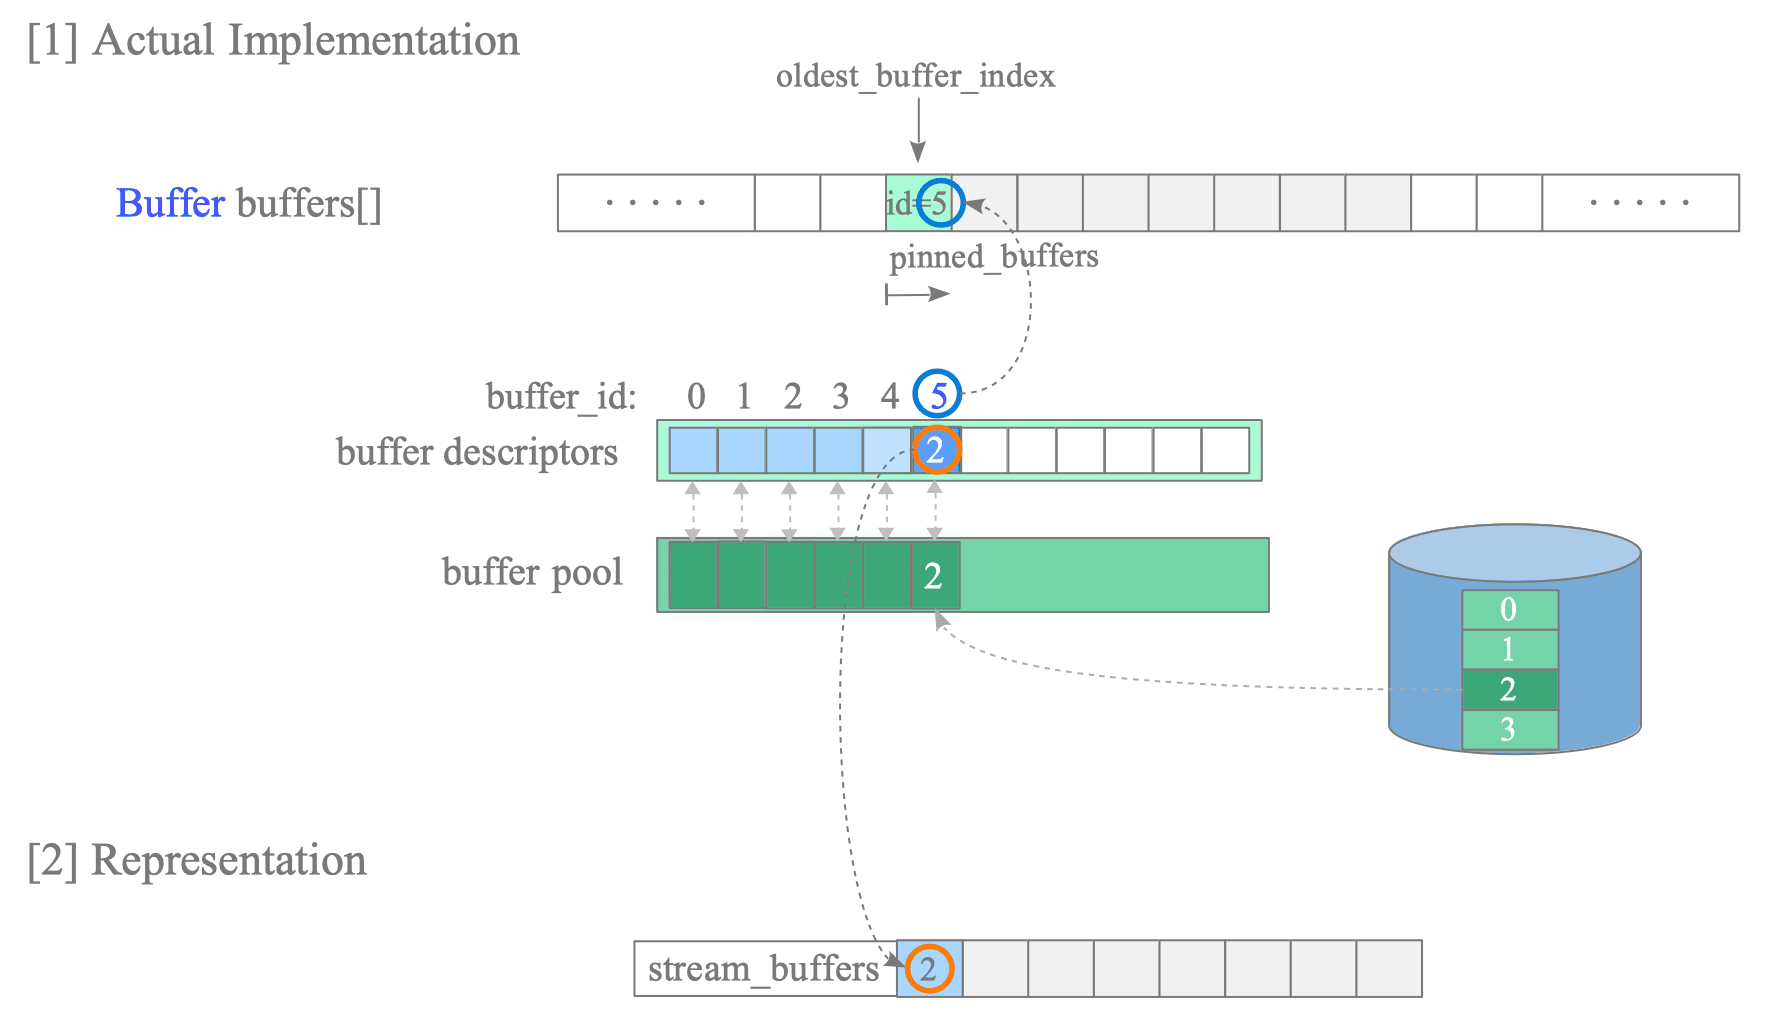
假设要把关系的第2号块装入缓冲池第5号槽。缓冲区管理器会把整数5写入buffers[]中next_buffer_index所指位置;在简化的stream_buffers表示中,则直接显示对应的缓冲区描述符(图中以块号2表示)。
出队
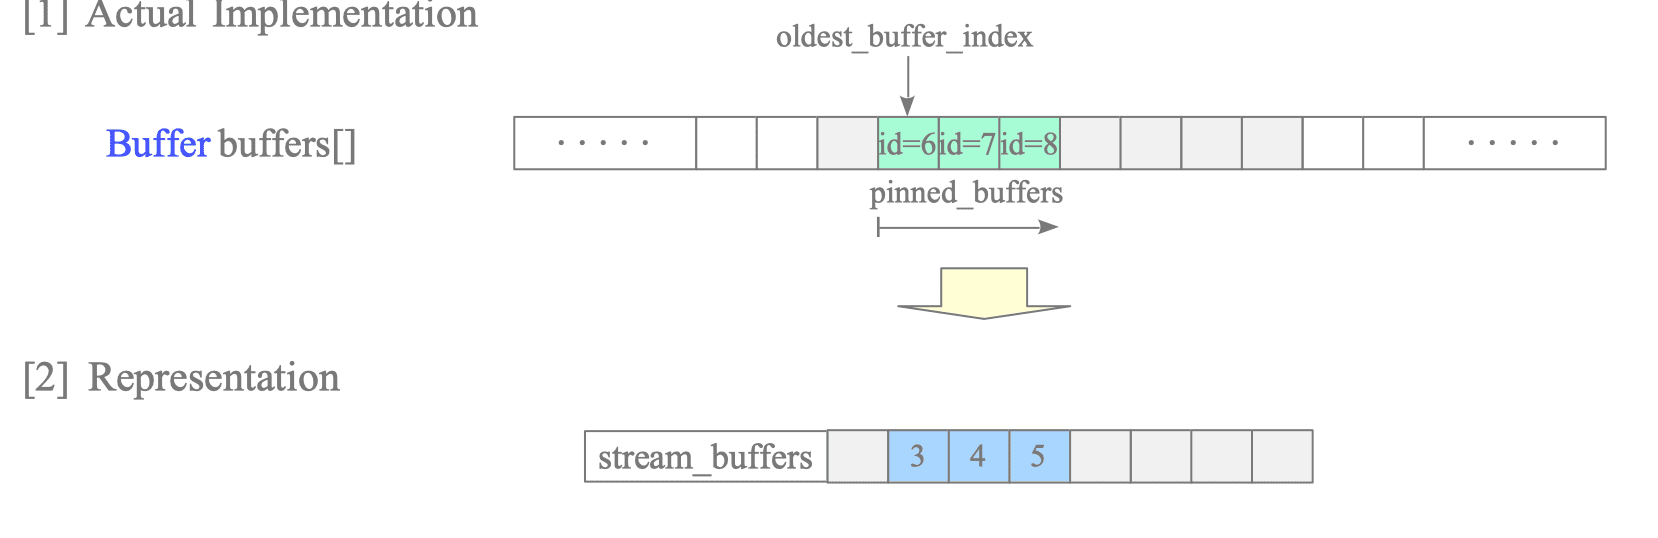
队首缓冲区标识出队后,oldest_buffer_index向右推进一个槽,pinned_buffers也相应减一;在stream_buffers抽象中,这等价于删除列表最左侧元素。
队列大小
read_stream_begin_impl()会根据effective_io_concurrency、io_combine_limit等配置计算queue_size。计算从以下上限开始:
其中BLCKSZ默认为8 KB;实际queue_size还可能因其他参数和运行条件而减小。
8.5.3.2 AIO核心操作
下面定义几个封装基本AIO操作的伪代码函数。
分配缓冲区并入队
read_ahead()为目标关系块分配缓冲区描述符,并将其加入stream_buffers:
准备并提交异步读取
prepare_and_submit()为read_ahead()刚入队的描述符准备并提交异步读取。由于顺序扫描读取连续块,它会使用向量I/O合并多个块:
等待异步读取完成
WaitReadBuffers()等待特定I/O完成,并把相关缓冲区标记为有效:
8.5.3.3 使用AIO的顺序扫描
利用上述函数,AIO顺序扫描的基本行为可写成:
- 首轮预读
combine_distance(这里为4)个页面,将它们入队并提交异步请求。 - 按顺序处理目标表页面。
- 从
stream_buffers取出下一个缓冲区描述符。 - 如果该块仍在从存储读取,则调用
WaitReadBuffers()等待完成。 - 队列为空时预读下一批块并提交请求。此时操作系统可以在后端处理当前页元组的同时异步读取下一批页面,这正是AIO收益的来源。
- 处理当前页面中的全部元组。
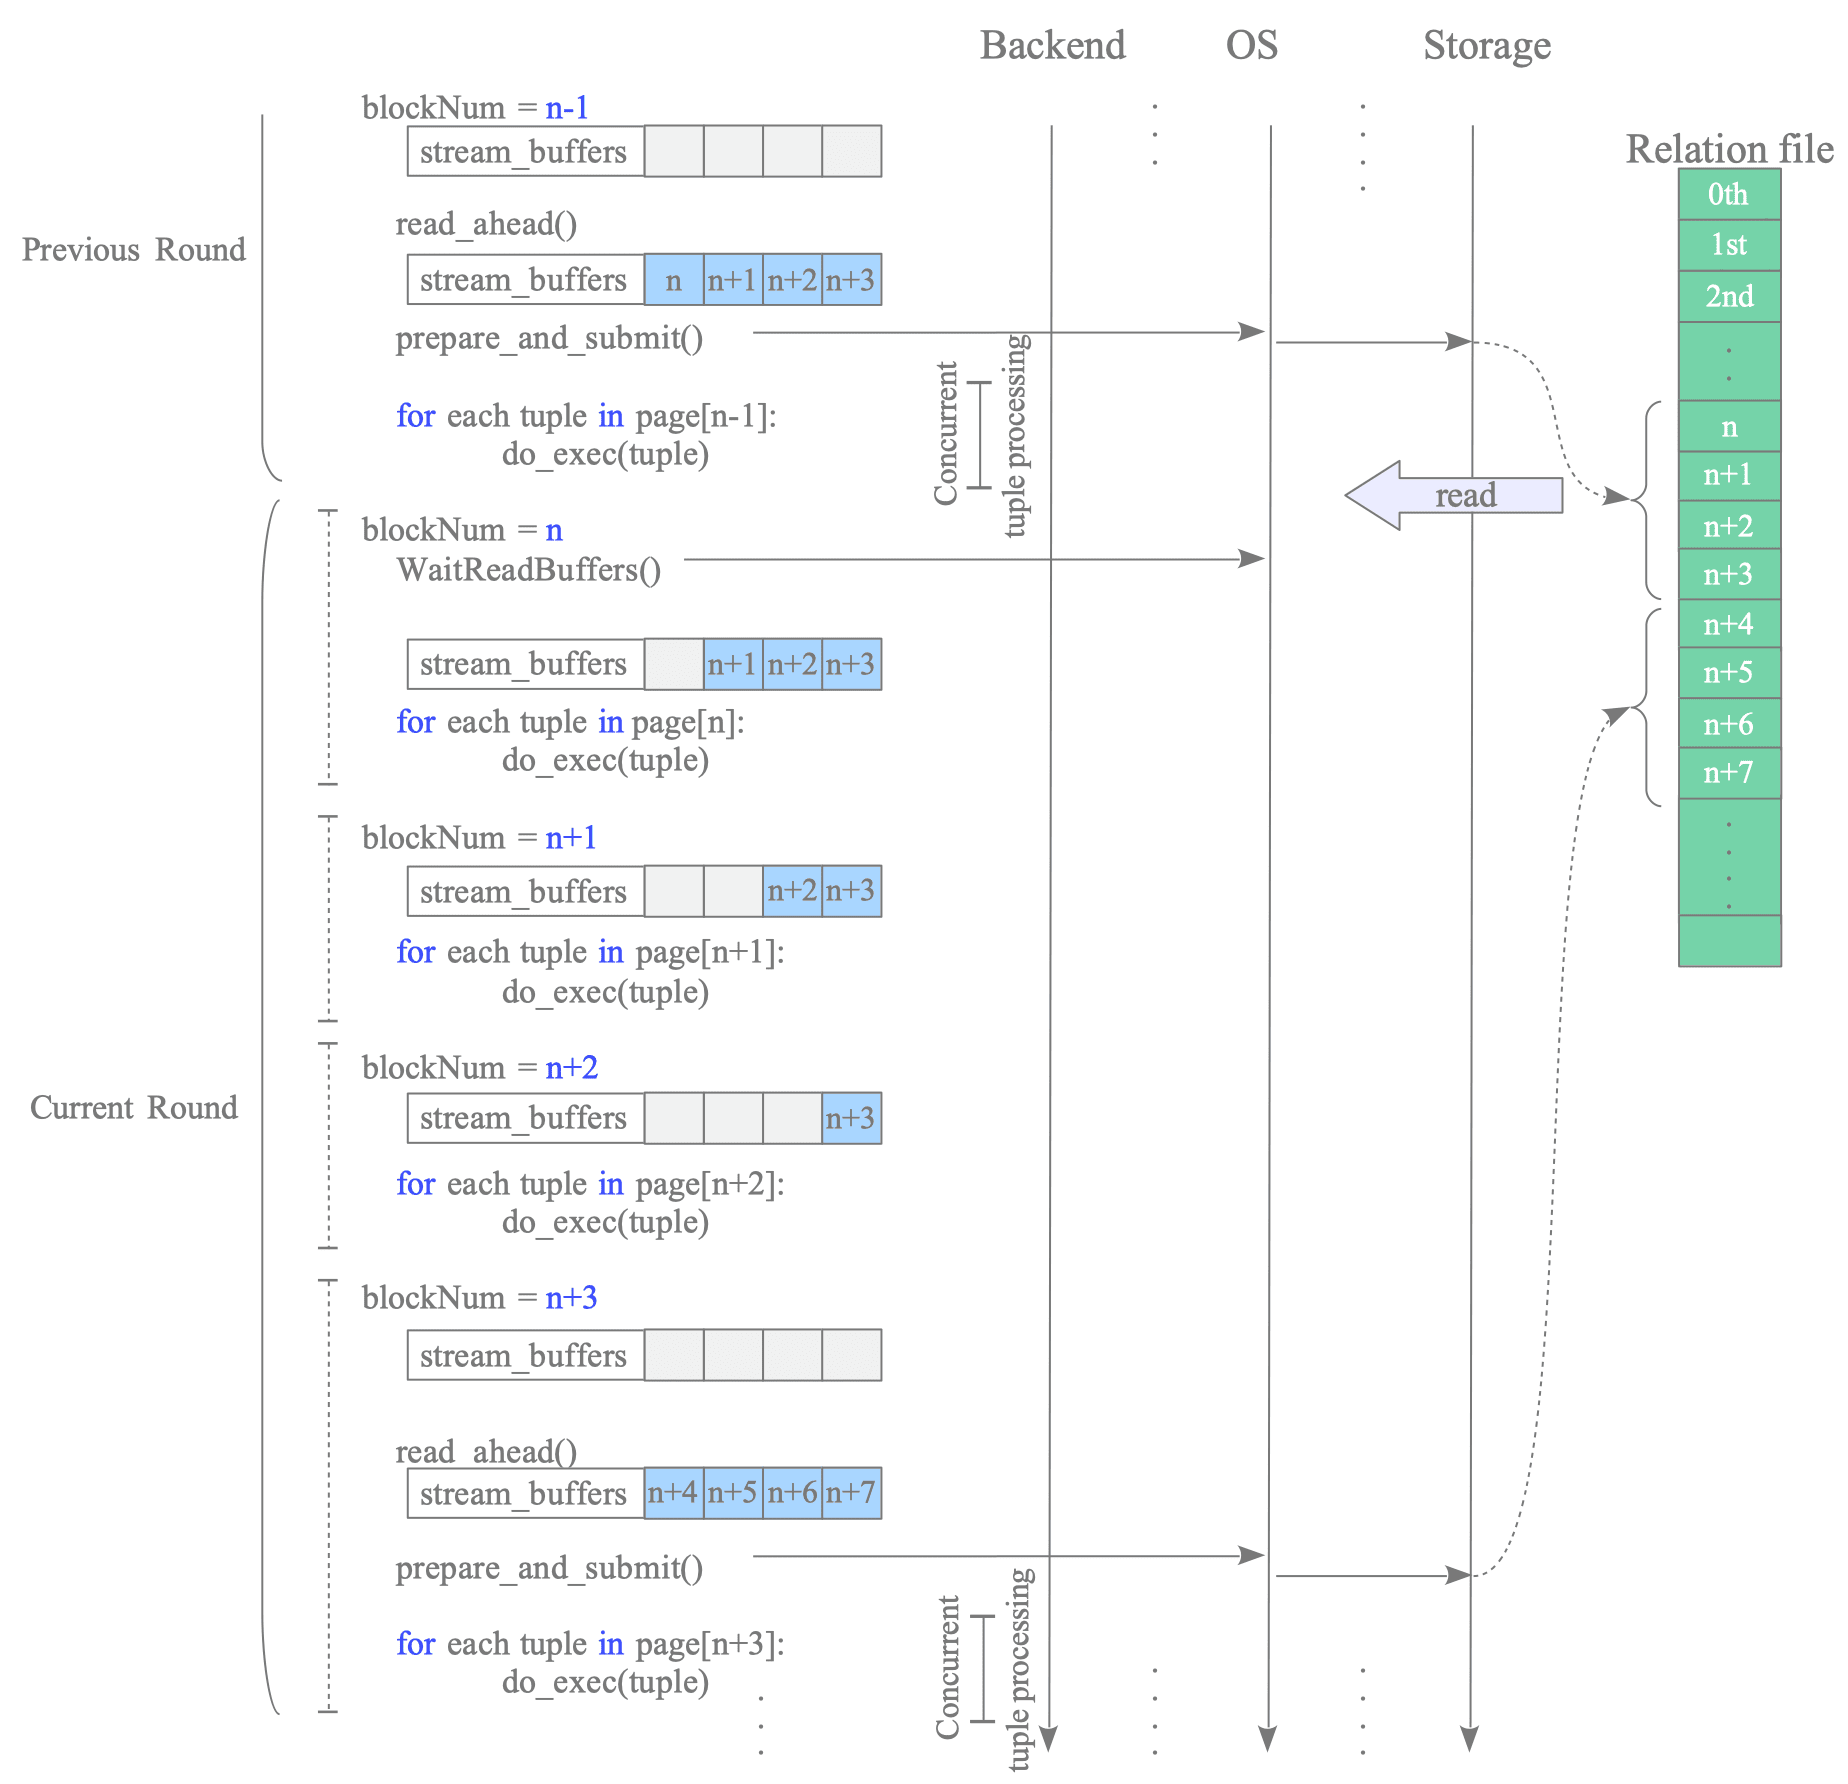
在图8.21中,上一轮结束时队列清空,read_ahead()把块至入队并提交请求;后端随即处理上一轮最后一块,与操作系统读取下一批块并行。当开始处理块时,如果I/O尚未结束,WaitReadBuffers()等待一次完成事件,并把这一批四个块全部标记为有效;随后至可以直接处理。队列再次清空后,下一批至以同样方式提交。
与传统同步顺序扫描的比较
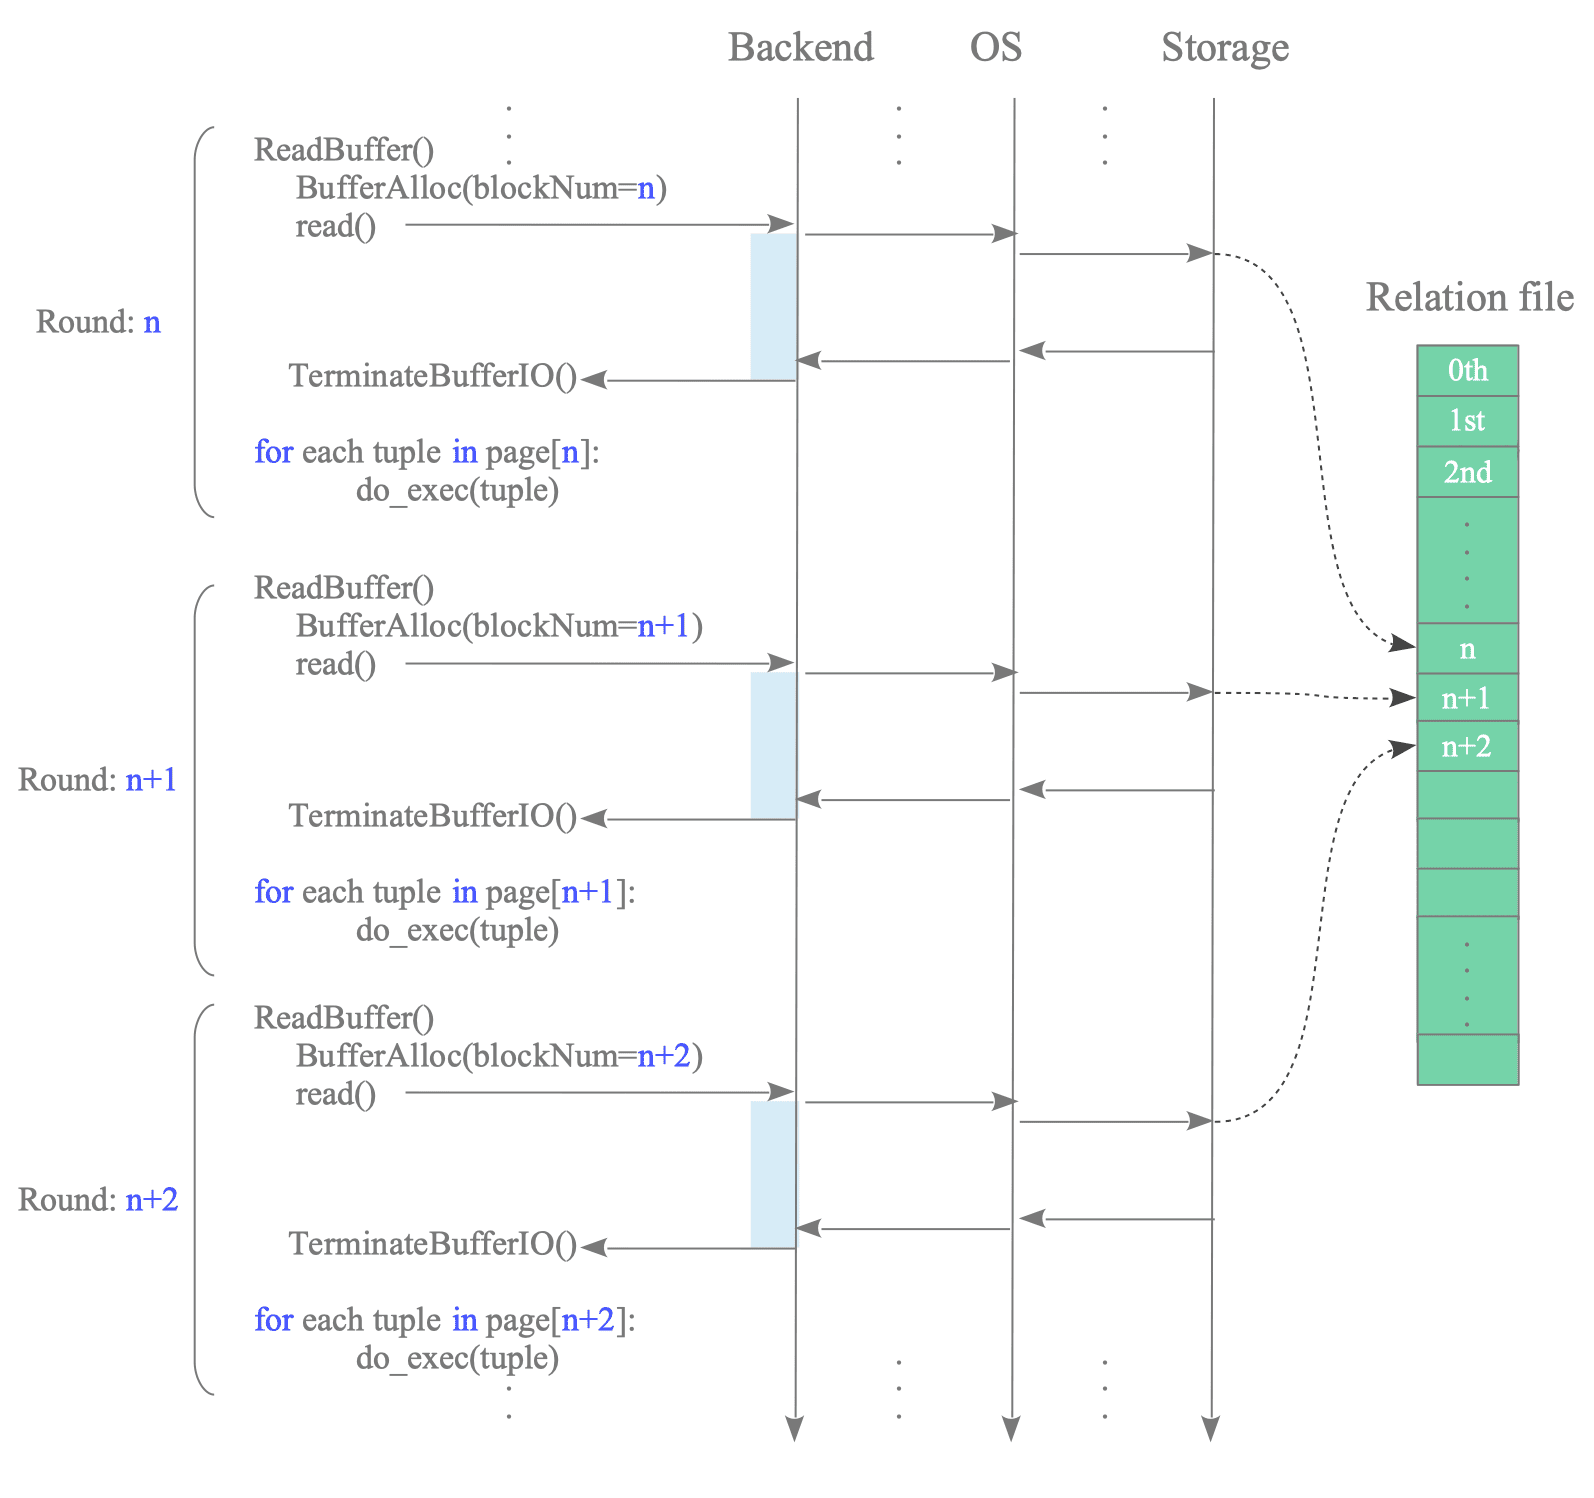
在传统模型中,后端对每个块串行重复三个阶段:分配缓冲区;调用同步read()并完全阻塞;I/O完成后解除缓冲区锁定并处理元组。AIO则把多个块的读取与当前页面的处理重叠起来。
8.5.4 异步顺序扫描的实际实现
真实缓冲区管理器在上述流水线基础上还会:处理预读期间的缓存命中;根据实时行为动态调整预读窗口;连续命中缓存时进入快速路径,绕过stream_buffers管理开销。
8.5.4.1 预读时的缓存命中
当read_ahead()遇到缓存命中时,它会停止继续扫描,只使用此前累积的连续未命中块来准备读取请求。
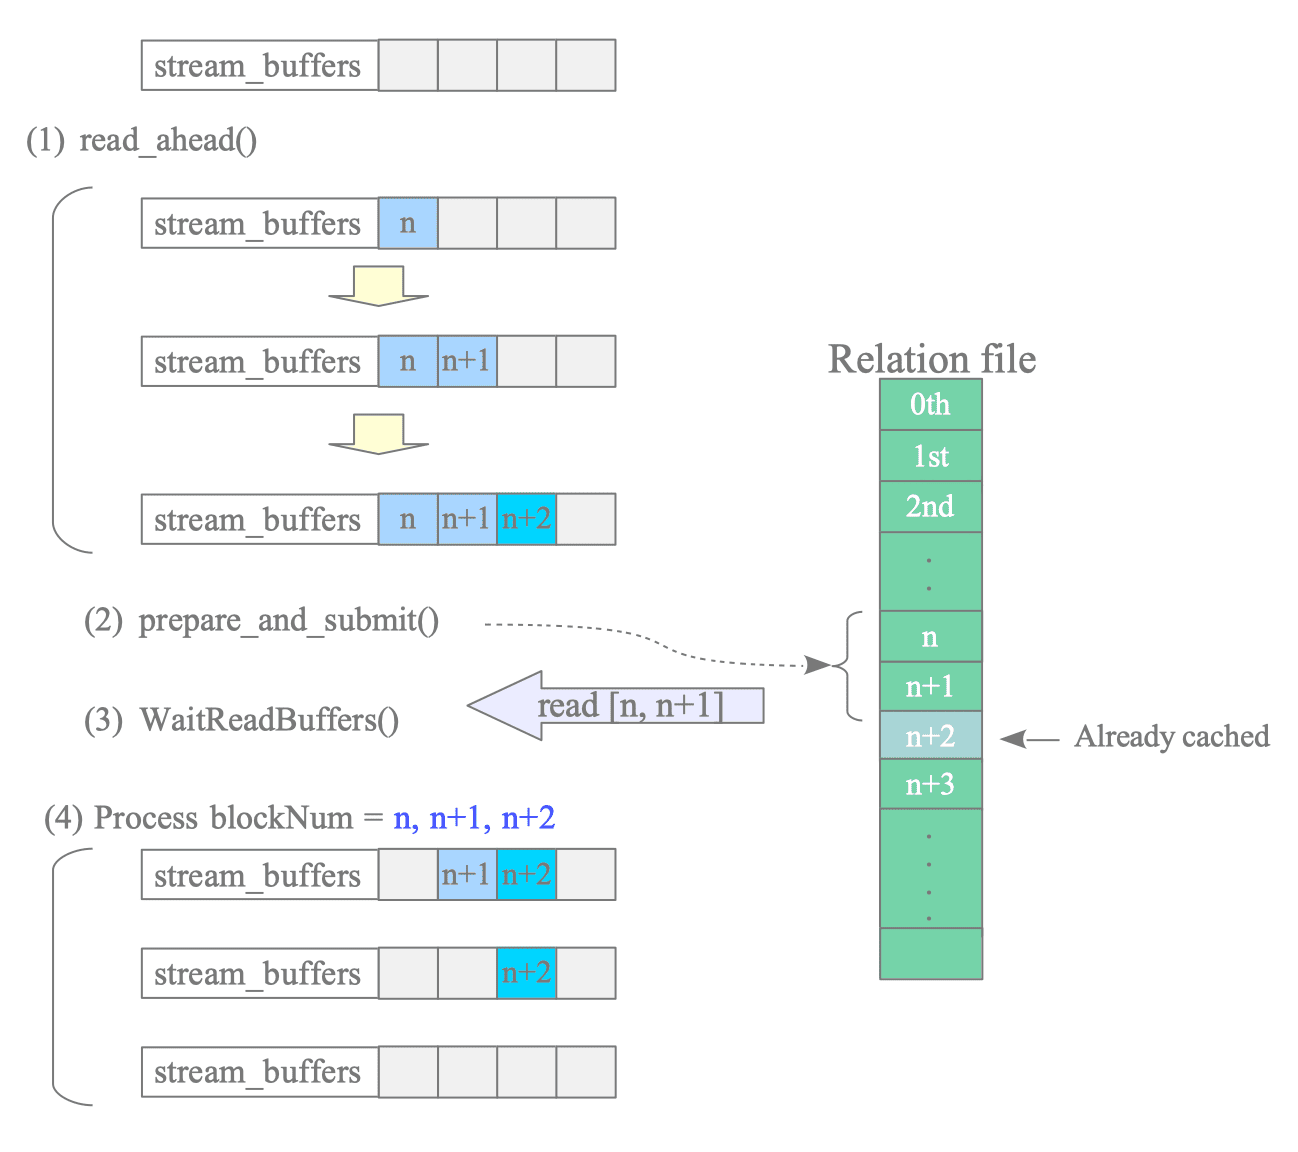
假设块已经在缓冲池中:
read_ahead()从块开始入队,在遇到命中时停止。prepare_and_submit()只为连续的与准备并提交一个向量读取请求。WaitReadBuffers()等待请求完成。- 扫描依次处理、和已在缓存中的。
在第一次命中处停止预读,可以保证stream_buffers中累积的未命中块在关系文件中物理连续,从而合并为单个向量I/O请求。
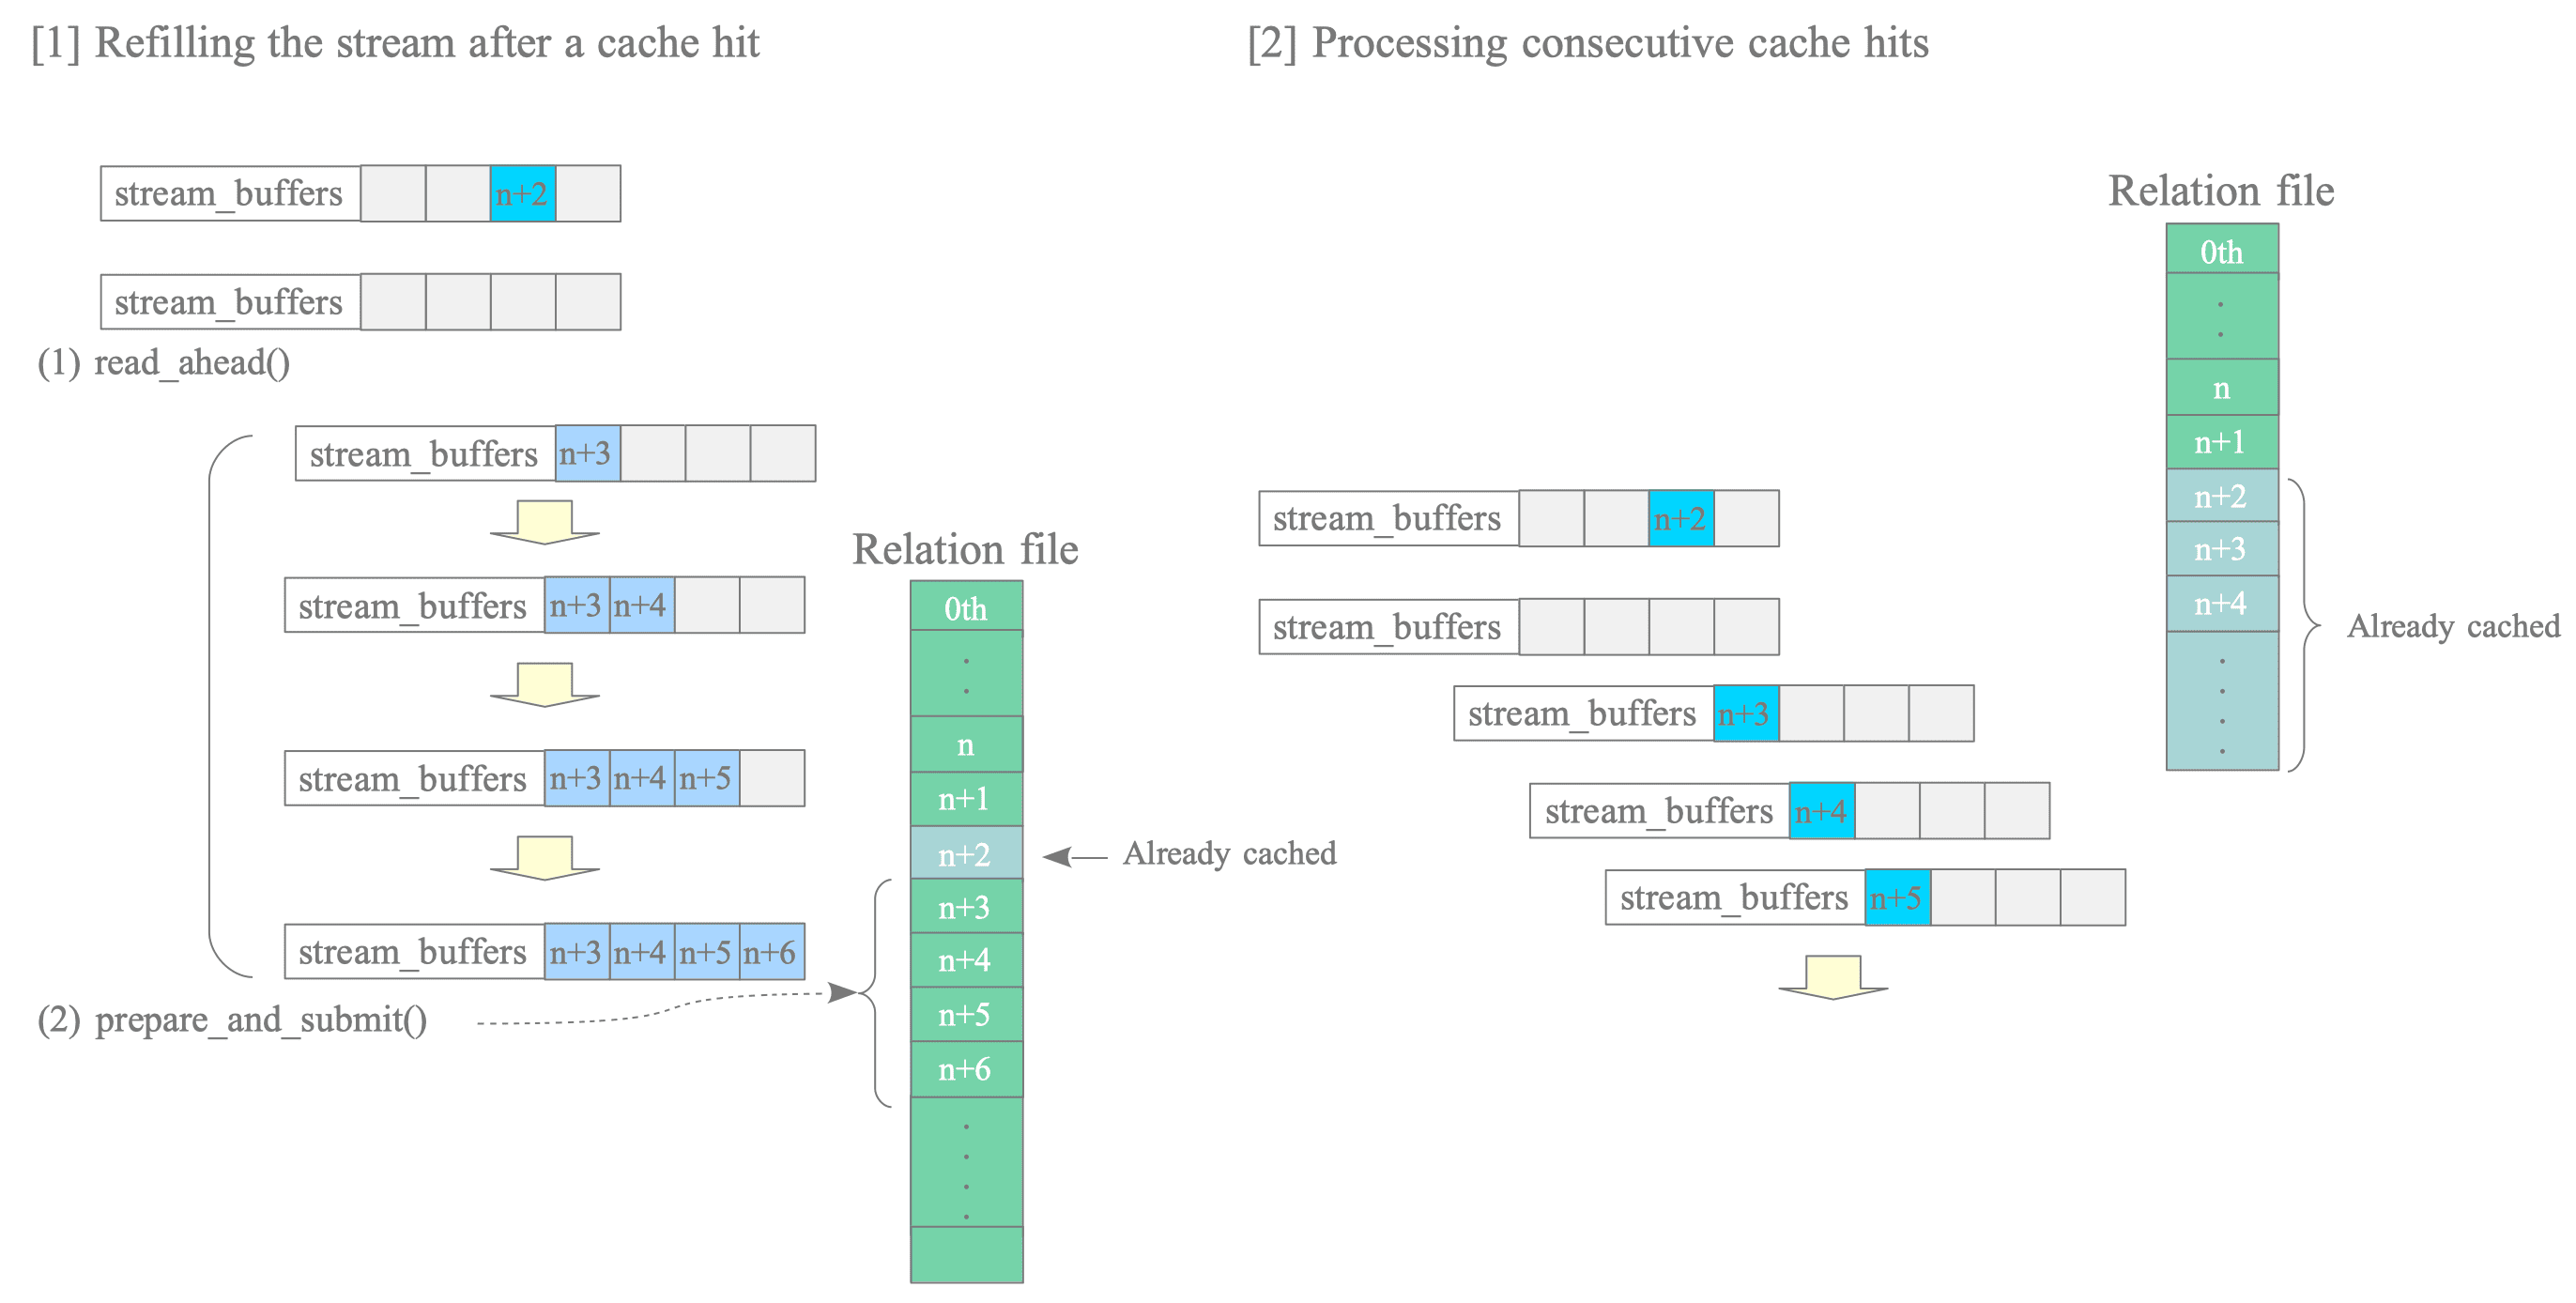
处理完后,如果后续块未命中,read_ahead()会从开始重新填充队列并提交多块请求;如果后续仍连续命中,则已缓存描述符会逐个入队,扫描反复执行单块处理。
8.5.4.2 自适应预读
stream_buffers的combine_distance会动态变化。顺序扫描开始时其值为1:
-
增长: 每轮翻倍,例如1、2、4、8,直到达到以下上限:
-
衰减: 连续缓存命中超过
queue_size - 1个块后,combine_distance每次减1,最低降至1;一旦再次发生缓存未命中,立即切回增长模式。
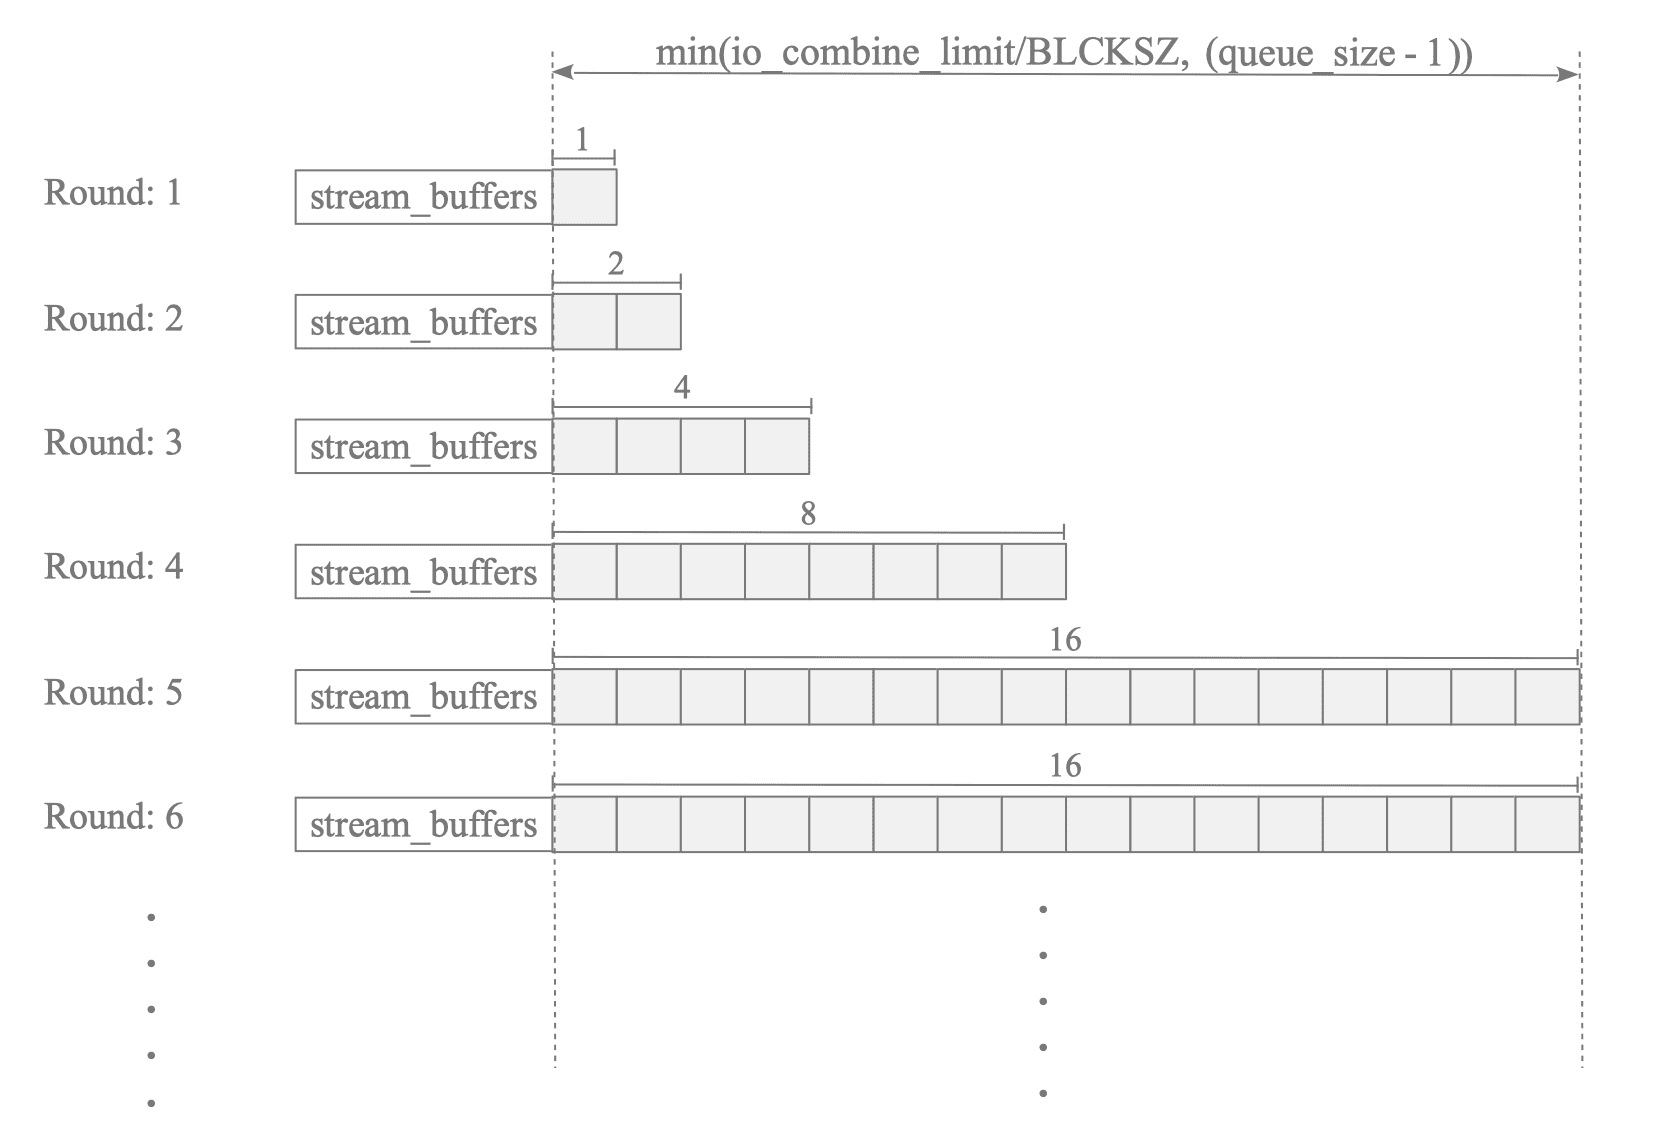
这种策略让预读并行度快速达到上限,却只在缓存持续命中时缓慢下降。
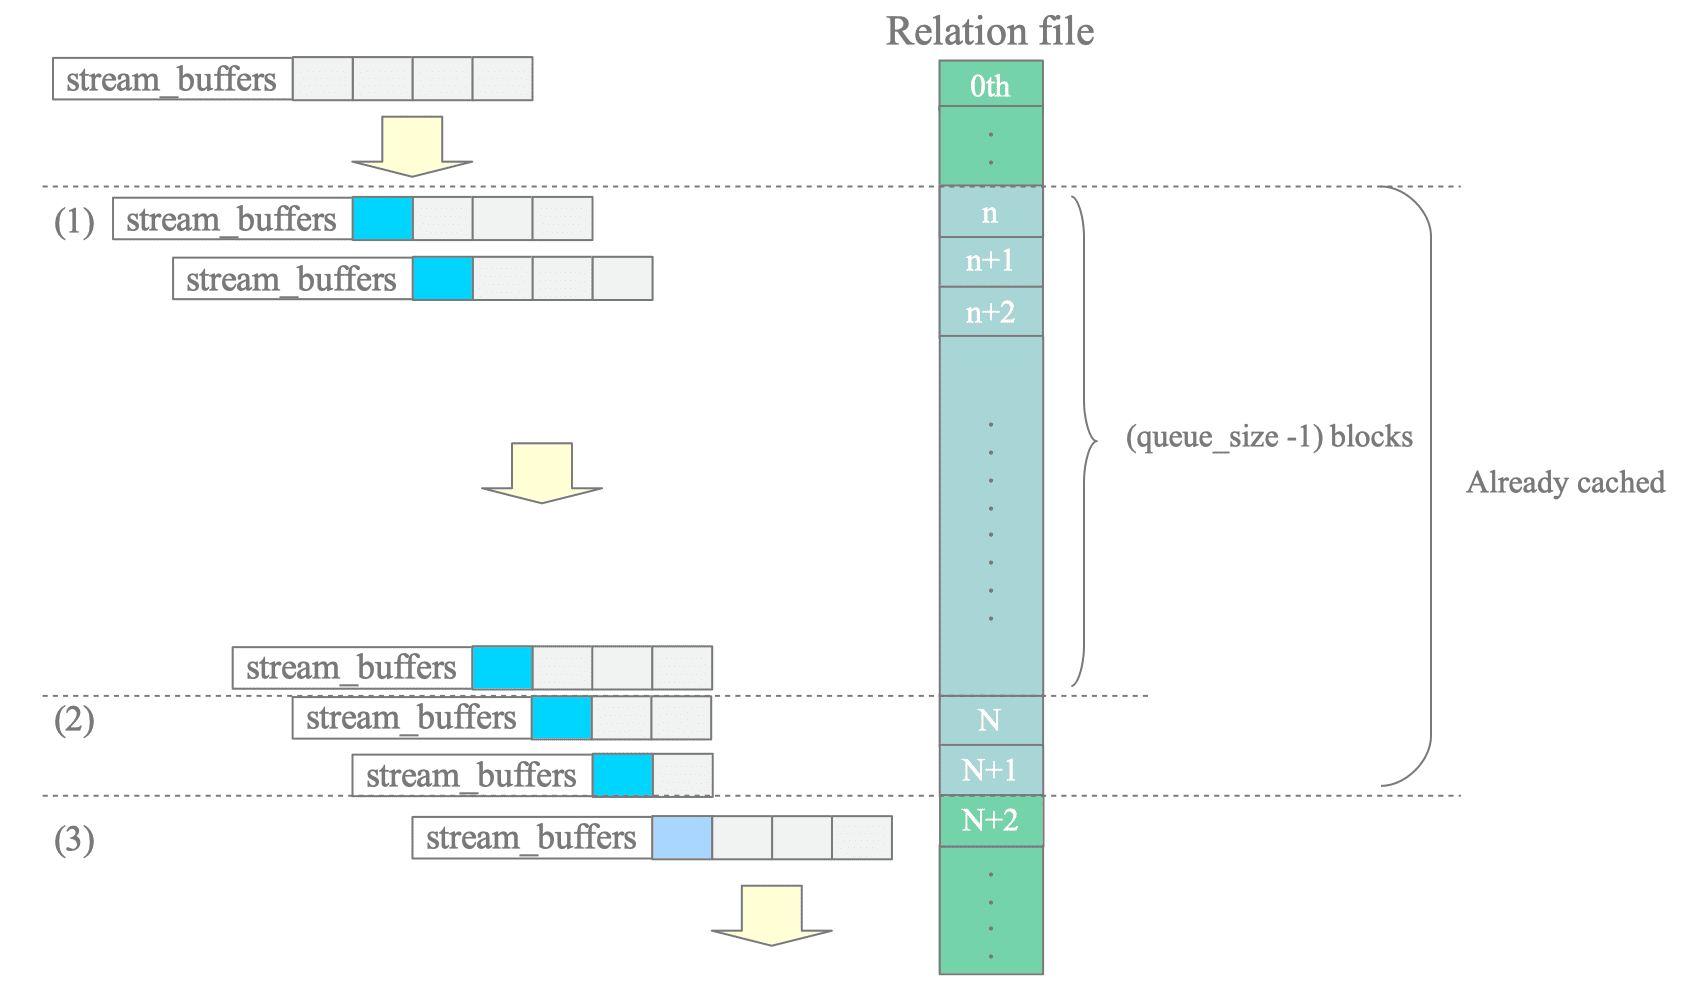
8.5.4.3 快速路径:绕过stream_buffers
当combine_distance已经降为1且缓存继续命中时,缓冲区管理器会进入快速路径(Fast Path),不再使用stream_buffers,而是直接读取缓冲池槽,以省去整套队列管理开销。快速路径中一旦出现缓存未命中,就立即回到正常预读模式。
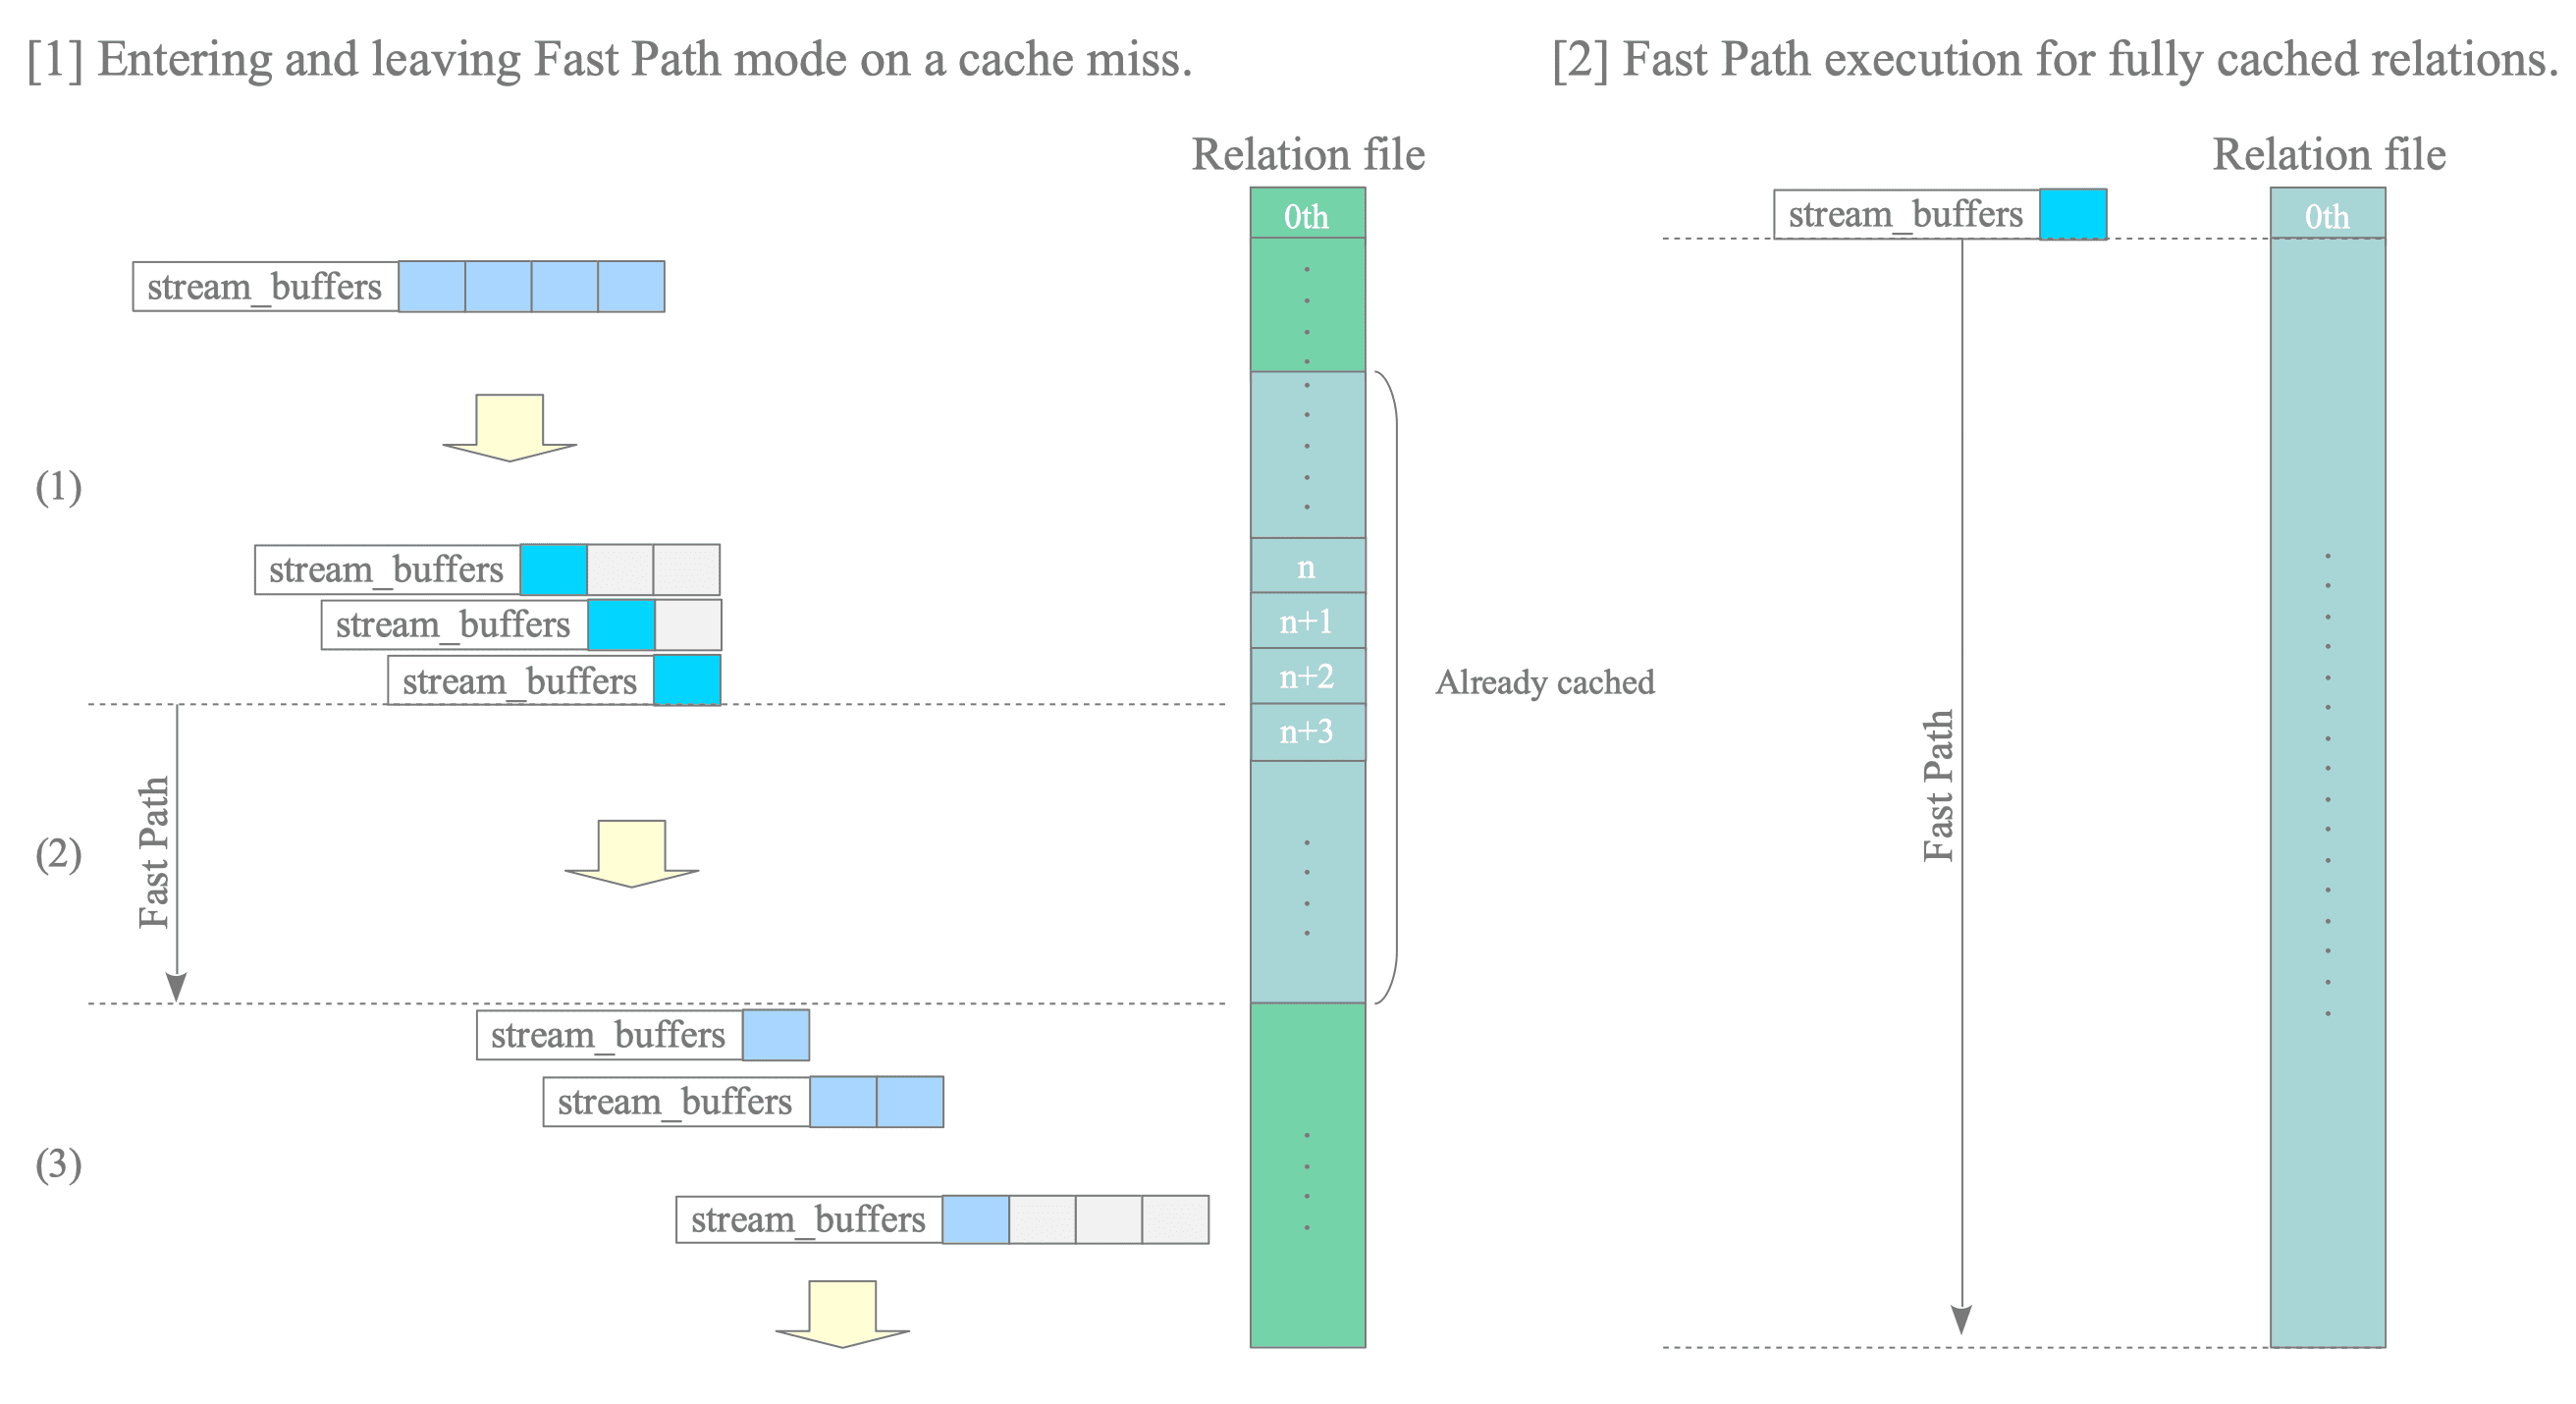
如果目标关系的所有块都已缓存在缓冲池中,缓冲区管理器只在处理第0号块时使用一次stream_buffers,之后的块都走快速路径。
8.6 脏页刷盘
除了置换受害者页面之外,检查点进程(Checkpointer) 和后台写入器进程也会将脏页刷写至存储中。尽管两个进程都具有相同的功能(刷写脏页),但它们有着不同的角色和行为。
检查点进程将 检查点记录(checkpoint record) 写入WAL段文件,并在检查点开始时进行脏页刷写。9.7节介绍了检查点,以及检查点开始的时机。
后台写入器的目的是通过少量多次的脏页刷盘,减少检查点带来的密集写入的影响。后台写入器会一点点地将脏页落盘,尽可能减小对数据库活动造成的影响。默认情况下,后台写入器每200毫秒被唤醒一次(由参数bgwriter_delay定义),且最多刷写bgwriter_lru_maxpages个页面(默认为100个页面)。
为什么检查点进程与后台写入器相分离?
在9.1版及更早版本中,后台写入器会规律性地执行检查点过程。在9.2版本中,检查点进程从后台写入器进程中被单独剥离出来。原因在一篇题为“将检查点进程与后台写入器相分离”的提案中有介绍。下面是一些摘录:
当前(在2011年)后台写入器进程既执行后台写入,又负责检查点,还处理一些其他的职责。这意味着我们没法在不停止后台写入的情况下执行检查点最终的
fsync。因此,在同一个进程中做两件事会有负面的性能影响。此外,在9.2版本中,我们的一个目标是通过将轮询循环替换为锁存器,从而降低功耗。
bgwriter中的循环复杂度太高了,以至于无法找到一种简洁的使用锁存器的方法。