技术附录
方差计算公式推导,以及帮助理解 PostgreSQL 异步 I/O 的 io_uring 示例程序。
本附录收录英文原著新增的方差公式推导与io_uring示例。
A.1 方差计算公式推导
A.1.1 Youngs与Cramer方法的推导
Youngs与Cramer方法是Welford在线方差算法的一种改进。先从Welford方法开始。
Welford方法
Welford计算方差的递推关系为:
Vn=Vn−1+nn−1(xn−An−1)2其中An为前n个值的平均数,Vn=∑i=1n(xi−An)2。由于
An=n(n−1)An−1+xn,可得:
$$
\begin{aligned}
V_n
&= \sum_{i=1}^{n-1}(x_i-A_n)^2 + (x_n-A_n)^2 \
&= \sum_{i=1}^{n-1}\left((x_i-A_{n-1})-\frac{x_n-A_{n-1}}{n}\right)^2
- \left(\frac{n-1}{n}(x_n-A_{n-1})\right)^2 \
&= V_{n-1} + \frac{n-1}{n}(x_n-A_{n-1})^2.
\end{aligned}
$$
中间的交叉项为零,因为∑i=1n−1(xi−An−1)=0。
Youngs与Cramer方法
Youngs与Cramer方法用和Sn−1代替平均数An−1,改善计算效率与数值稳定性:
Vn=Vn−1+nn−1(xn−n−1Sn−1)2=Vn−1+n(n−1)1((n−1)xn−Sn−1)2=Vn−1+n(n−1)1(nxn−Sn)2.A.1.2 单遍/并行方差公式的推导
并行查询计算方差时,leader需要合并多个worker算出的局部结果。把数据分成大小为n1与n2的两部分,总和分别为Sn1、Sn2,平方离差和分别为Vn1、Vn2,则总体方差分子为:
Vn=Vn1+Vn2+n1+n2n1n2(n1Sn1−n2Sn2)2.记两部分平均数为A1=Sn1/n1、A2=Sn2/n2,总体平均数为
A=n1+n2Sn1+Sn2.将总体平方离差和分成两部分:
$$
\begin{aligned}
V_n
&= \sum_{i=1}^{n_1}(x_i-A)^2
- \sum_{i=n_1+1}^{n_1+n_2}(x_i-A)^2 \
&= V_{n_1}+n_1(A_1-A)^2
- V_{n_2}+n_2(A_2-A)^2.
\end{aligned}
$$
代入总体平均数并整理:
n1(A1−A)2+n2(A2−A)2=n1+n2n1n2(A1−A2)2=n1+n2n1n2(n1Sn1−n2Sn2)2,于是得到上面的并行合并公式。
A.2 io_uring示例
下面两个小程序构造了一个玩具缓冲区管理器:把32字节文件rel.data按四次8字节逻辑读取,异步装入BufferPool。
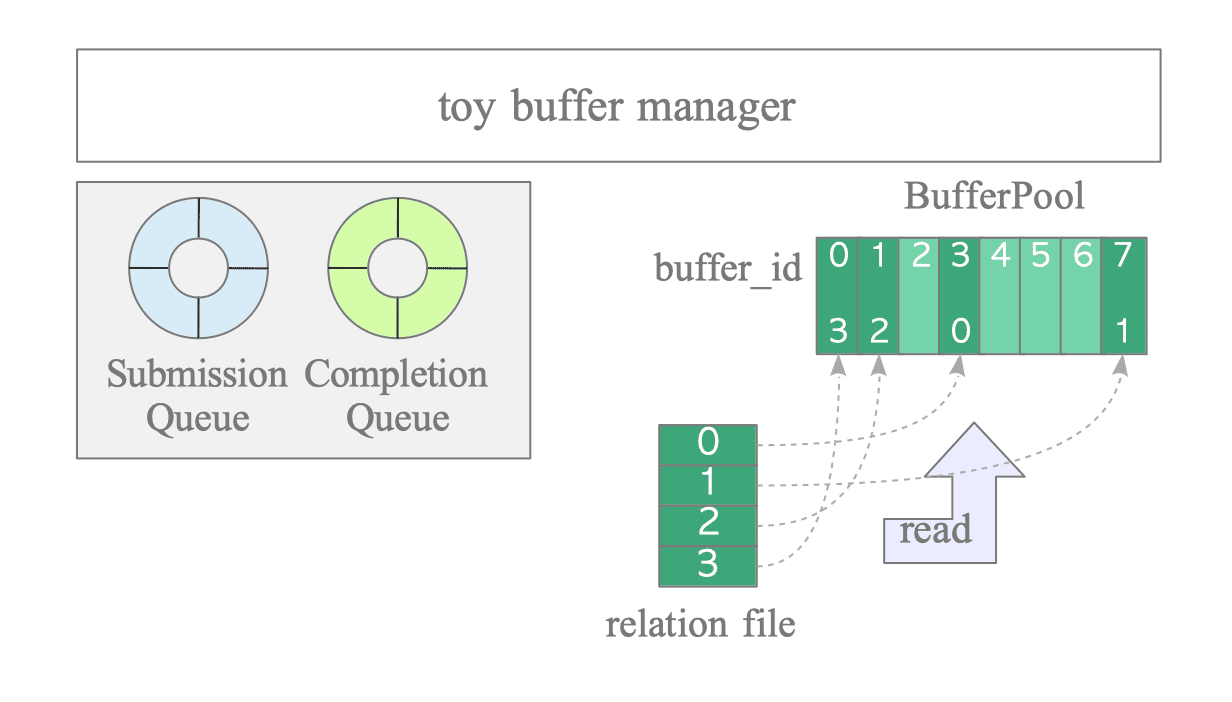 图 A.2-1 玩具缓冲区管理器模型
$ cat rel.data
A0000000B0000001C0000010D0000011
四个逻辑块分别放入缓冲池槽3、7、1、0:
#define BUFFER_SIZE 8
#define PAGE_SIZE 8
#define QUEUE_SIZE 4

char BufferPool[BUFFER_SIZE][PAGE_SIZE + 1];
int dest[QUEUE_SIZE] = { 3, 7, 1, 0 };
A.2.1 多读取请求
第一个程序为每个逻辑块准备一条独立的io_uring读取请求:
#include <fcntl.h>
#include <liburing.h>
#include <stdio.h>
#include <string.h>
#include <unistd.h>

#define BUFFER_SIZE 8
#define PAGE_SIZE 8
#define QUEUE_SIZE 4
#define REL_FILE "rel.data"

int
main(void)
{
    int fd;
    struct io_uring ring;
    char BufferPool[BUFFER_SIZE][PAGE_SIZE + 1];
    int dest[QUEUE_SIZE] = { 3, 7, 1, 0 };

    io_uring_queue_init(QUEUE_SIZE, &ring, 0);
    if ((fd = open(REL_FILE, O_RDONLY)) < 0)
        return 1;
    memset(BufferPool, 0, sizeof(BufferPool));

    for (int i = 0; i < QUEUE_SIZE; i++)
    {
        struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
        int buff_id = dest[i];
        io_uring_prep_read(sqe, fd, BufferPool[buff_id],
                           PAGE_SIZE, i * PAGE_SIZE);
        sqe->user_data = i;
    }
    io_uring_submit(&ring);

    for (int i = 0; i < QUEUE_SIZE; i++)
    {
        struct io_uring_cqe *cqe;
        io_uring_wait_cqe(&ring, &cqe);

        int blockNum = (int)cqe->user_data;
        int buff_id = dest[blockNum];
        printf("CQ[%d]: BlockNum_%d -> BufferPool[%d] "
               "offset=%3d bytes=%2d: [%s]\n",
               i + 1, blockNum, buff_id, blockNum * PAGE_SIZE,
               PAGE_SIZE, BufferPool[buff_id]);

        io_uring_cqe_seen(&ring, cqe);
    }

    close(fd);
    io_uring_queue_exit(&ring);
    return 0;
}
$ gcc -o aio_read aio_read.c -luring
$ ./aio_read
CQ[1]: BlockNum_0 -> BufferPool[3] offset=  0 bytes= 8: [A0000000]
CQ[2]: BlockNum_1 -> BufferPool[7] offset=  8 bytes= 8: [B0000001]
CQ[3]: BlockNum_2 -> BufferPool[1] offset= 16 bytes= 8: [C0000010]
CQ[4]: BlockNum_3 -> BufferPool[0] offset= 24 bytes= 8: [D0000011]
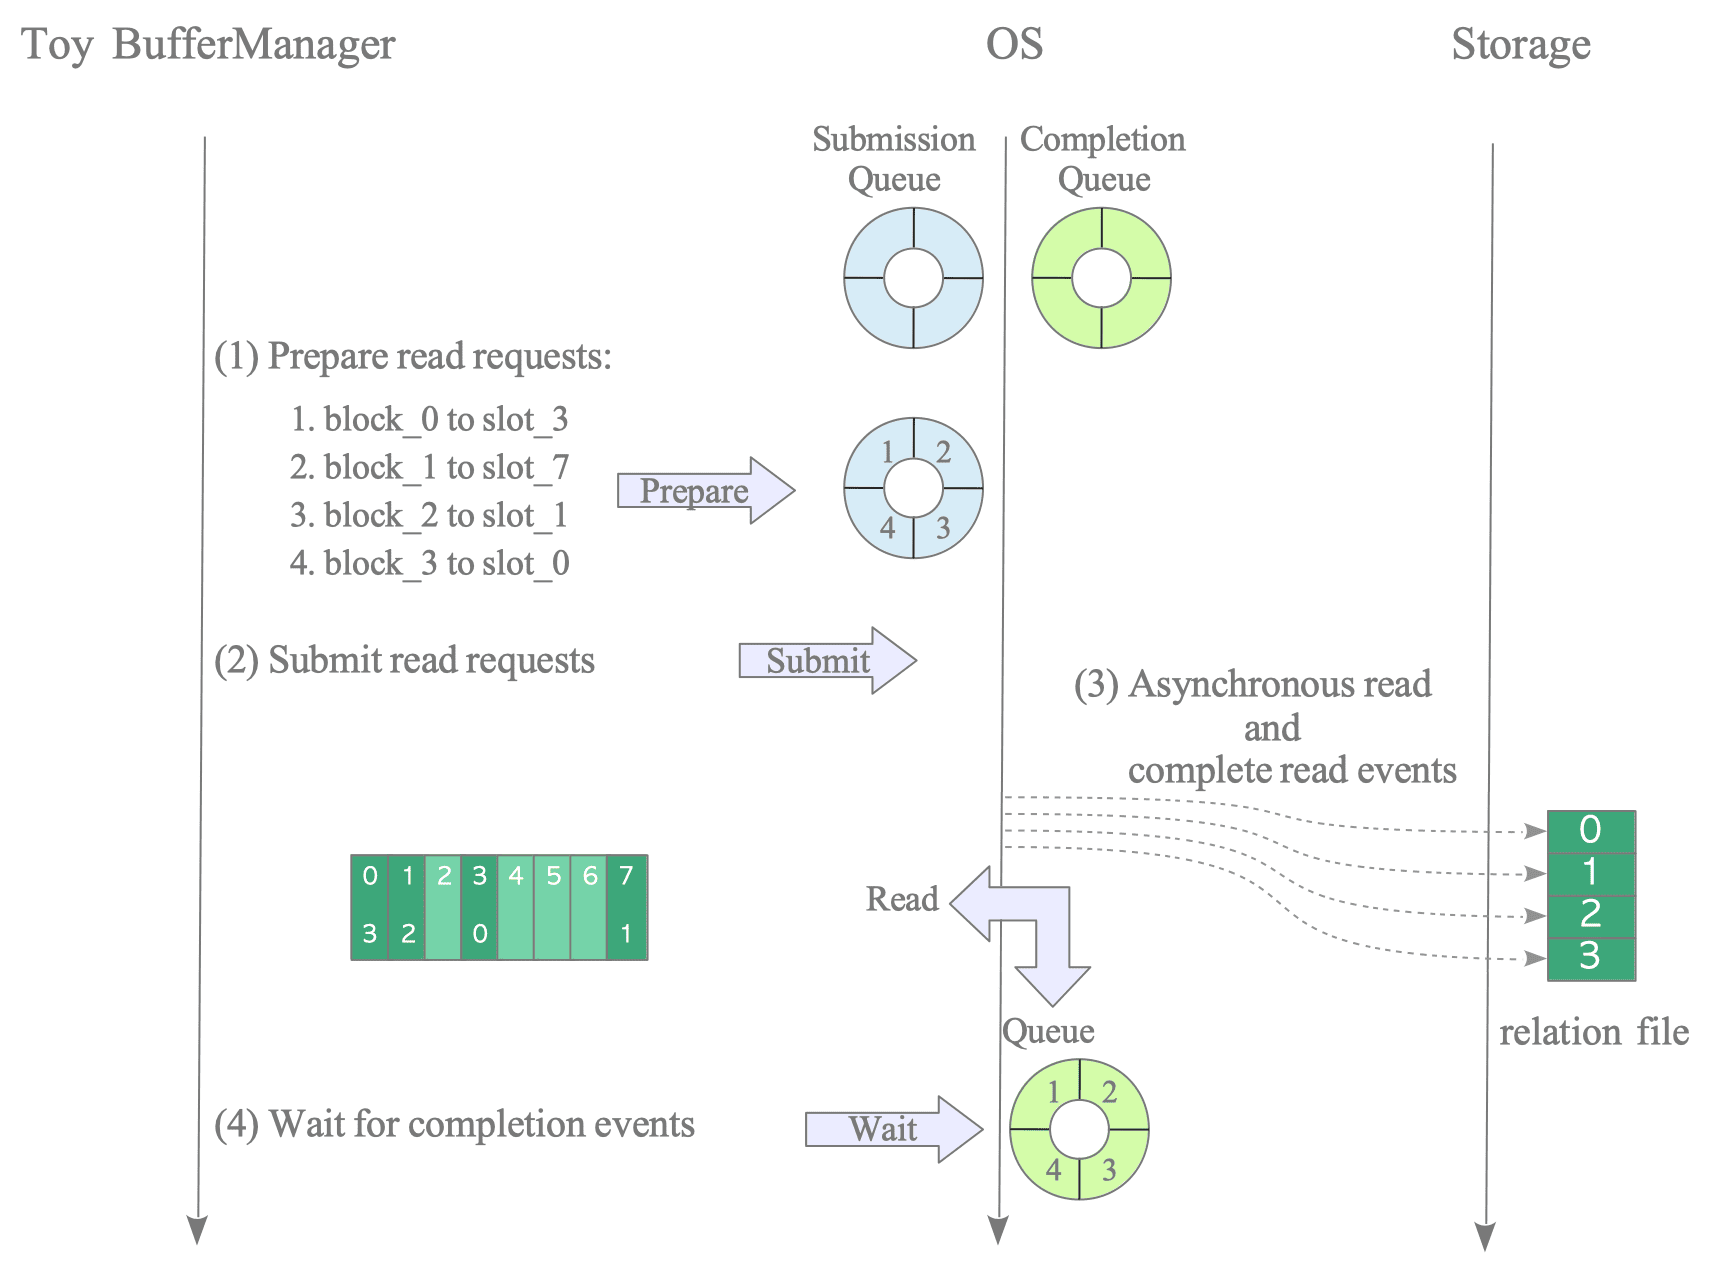 图 A.2-2 处理多条读取请求
处理流程如下:
io_uring_get_sqe()为每个读取请求取得一个提交队列项(SQE);io_uring_prep_read()写入目标缓冲区、读取长度和文件偏移,user_data保存块号。io_uring_submit()一次提交四个请求。- 内核读取各块,每完成一次就向完成队列加入一个CQE。
- 程序反复调用
io_uring_wait_cqe()等待事件;收到CQE后相应缓冲区即可安全读取,最后用io_uring_cqe_seen()标记事件已消费。
A.2.2 向量读取
io_uring支持向量I/O(分散—聚集I/O),可以用一条请求把多个连续页面读入分散的缓冲池地址:
#include <fcntl.h>
#include <liburing.h>
#include <stdio.h>
#include <string.h>
#include <unistd.h>

#define BUFFER_SIZE 8
#define PAGE_SIZE 8
#define QUEUE_SIZE 4
#define REL_FILE "rel.data"

int
main(void)
{
    int fd;
    struct io_uring ring;
    char BufferPool[BUFFER_SIZE][PAGE_SIZE + 1];
    struct iovec iov[QUEUE_SIZE];
    int dest[QUEUE_SIZE] = { 3, 7, 1, 0 };

    io_uring_queue_init(QUEUE_SIZE, &ring, 0);
    if ((fd = open(REL_FILE, O_RDONLY)) < 0)
        return 1;
    memset(BufferPool, 0, sizeof(BufferPool));

    for (int blockNum = 0; blockNum < QUEUE_SIZE; blockNum++)
    {
        int buff_id = dest[blockNum];
        iov[blockNum].iov_base = BufferPool[buff_id];
        iov[blockNum].iov_len = PAGE_SIZE;
    }

    struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
    io_uring_prep_readv(sqe, fd, iov, QUEUE_SIZE, 0);
    io_uring_submit(&ring);

    struct io_uring_cqe *cqe;
    io_uring_wait_cqe(&ring, &cqe);
    printf("CQ: readv completed: %d bytes read\n", cqe->res);

    for (int blockNum = 0; blockNum < QUEUE_SIZE; blockNum++)
    {
        int buff_id = dest[blockNum];
        printf("\tBlockNum_%d -> BufferPool[%d] "
               "offset=%3d bytes=%2d: [%s]\n",
               blockNum, buff_id, blockNum * PAGE_SIZE,
               PAGE_SIZE, BufferPool[buff_id]);
    }

    io_uring_cqe_seen(&ring, cqe);
    close(fd);
    io_uring_queue_exit(&ring);
    return 0;
}
$ gcc -o aio_readv aio_readv.c -luring
$ ./aio_readv
CQ: readv completed: 32 bytes read
    BlockNum_0 -> BufferPool[3] offset=  0 bytes= 8: [A0000000]
    BlockNum_1 -> BufferPool[7] offset=  8 bytes= 8: [B0000001]
    BlockNum_2 -> BufferPool[1] offset= 16 bytes= 8: [C0000010]
    BlockNum_3 -> BufferPool[0] offset= 24 bytes= 8: [D0000011]
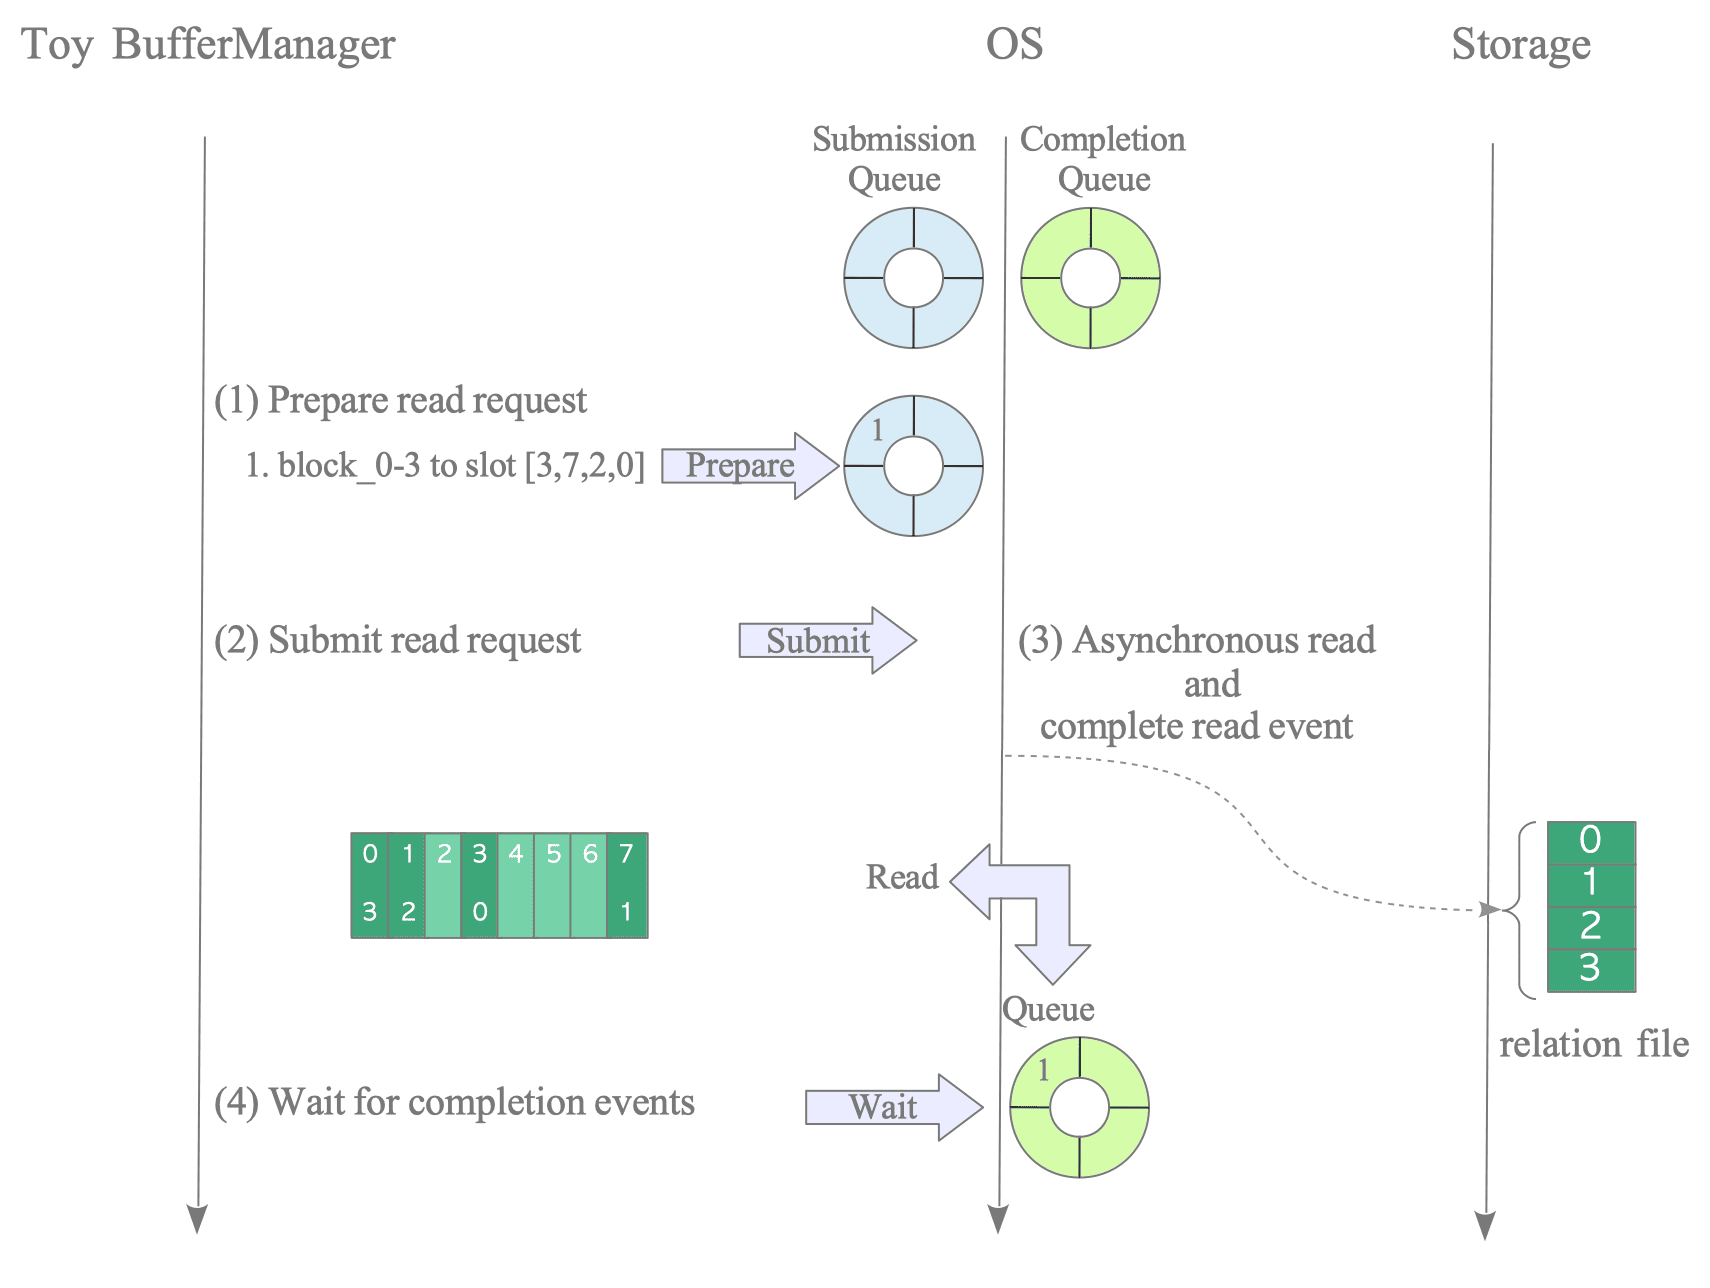 图 A.2-3 处理一条向量读取请求
程序先用iov数组绑定四个分散的BufferPool槽,再用io_uring_prep_readv()准备一条向量请求。内核从文件连续读取四个块,并按iov指定的地址分散写入;因为逻辑上只有一条请求,整个操作只产生一个完成事件。