12 逻辑复制
Beta版:仍在编写中。 英文原著明确把第12章标记为Beta/WIP。本译文按当前上游内容同步,章节结构和技术细节仍可能继续变化。
PostgreSQL从10(2017年)开始原生支持逻辑复制。流复制中的节点称为主库(Primary)和备库(Standby);逻辑复制则使用发布者(Publisher)与订阅者(Subscriber)。
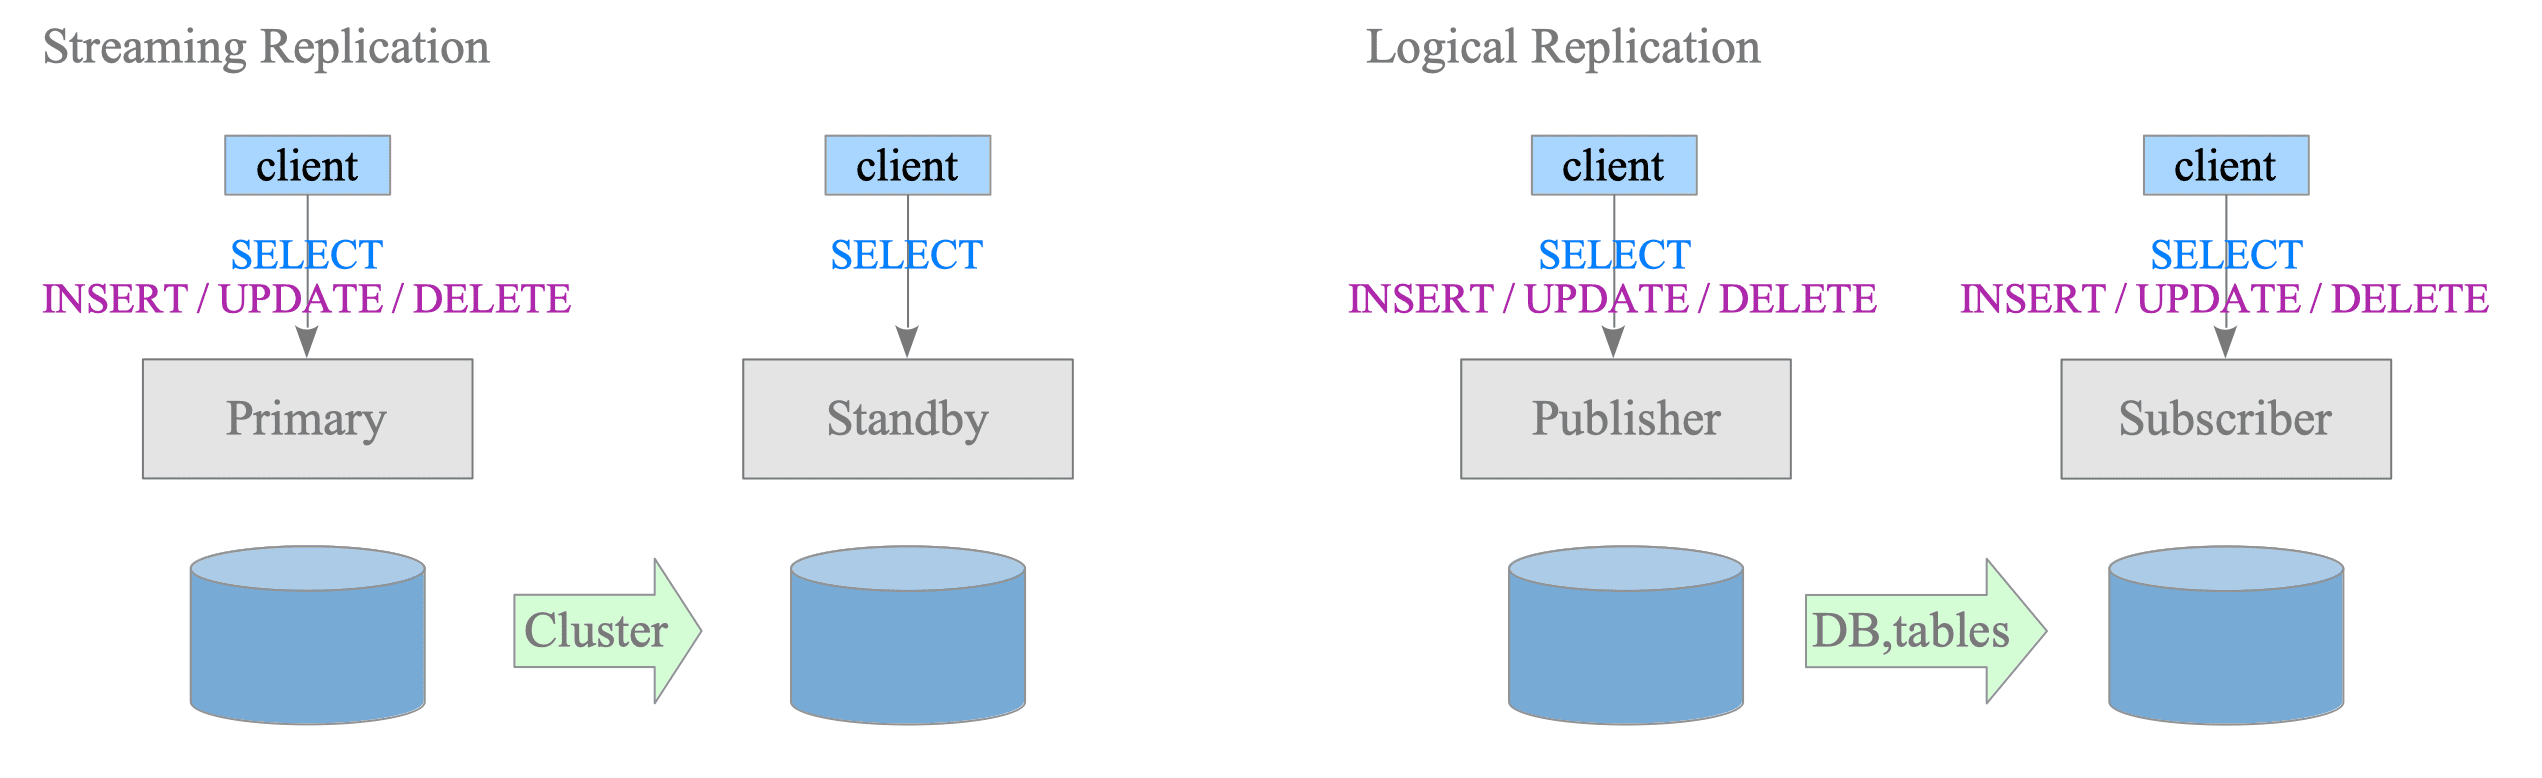
流复制复制整个数据库集簇,而逻辑复制可以只复制一个数据库中的指定表。流复制备库通常只能处理只读查询;逻辑订阅者则可以一边接收发布者的数据,一边独立执行本地写入。
| 特性 | 逻辑复制 | 流复制 |
|---|---|---|
| WAL发送时机 | 通常在事务提交后;大事务可在提交前分段传输 | WAL生成后立即传输 |
| 发送进程 | walsender | walsender |
| 接收进程 | logical replication launcher、apply worker | walreceiver、startup |
| 复制单位 | 表、数据库 | 整个数据库集簇 |
| 不复制的操作 | DDL | 无 |
| 不复制的对象 | 视图、索引、大对象等非表对象;序列自PG 19起支持 | UNLOGGED表 |
| 跨大版本 | 支持 | 不支持 |
| 跨操作系统 | 支持 | 不支持 |
| 订阅端/备库上的DML | INSERT、UPDATE、DELETE、SELECT、TRUNCATE |
SELECT |
| 订阅端/备库触发器 | apply worker默认不触发普通触发器;可启用REPLICA或ALWAYS行级触发器 |
禁用 |
本章依次介绍逻辑复制的关键概念与启动流程、ReorderBuffer结构、WAL过滤与缓冲、pgoutput输出插件、事务消息构造、订阅端应用,以及重启和崩溃恢复。
12.1 概述与关键概念
12.1.1 相关进程
逻辑复制由四类进程协同完成:
- 发布者上的walsender向订阅者发送逻辑变更,并执行各种协调工作。
- 订阅者上的logical replication launcher负责启动apply worker。
- apply worker连接发布者的walsender,接收逻辑变更流、解析消息,并更新目标表。
- table sync worker负责某张表的初始数据同步;追上主复制流后,再把后续更新交给apply worker。
12.1.2 逻辑复制概要
PostgreSQL逻辑复制是基于行(row-based)的:它捕获各行的变化,并以解码后的格式传输。逻辑消息携带操作已经求值的结果,因此不会因为random()、now()等非确定性函数在两端重复求值而产生不一致。
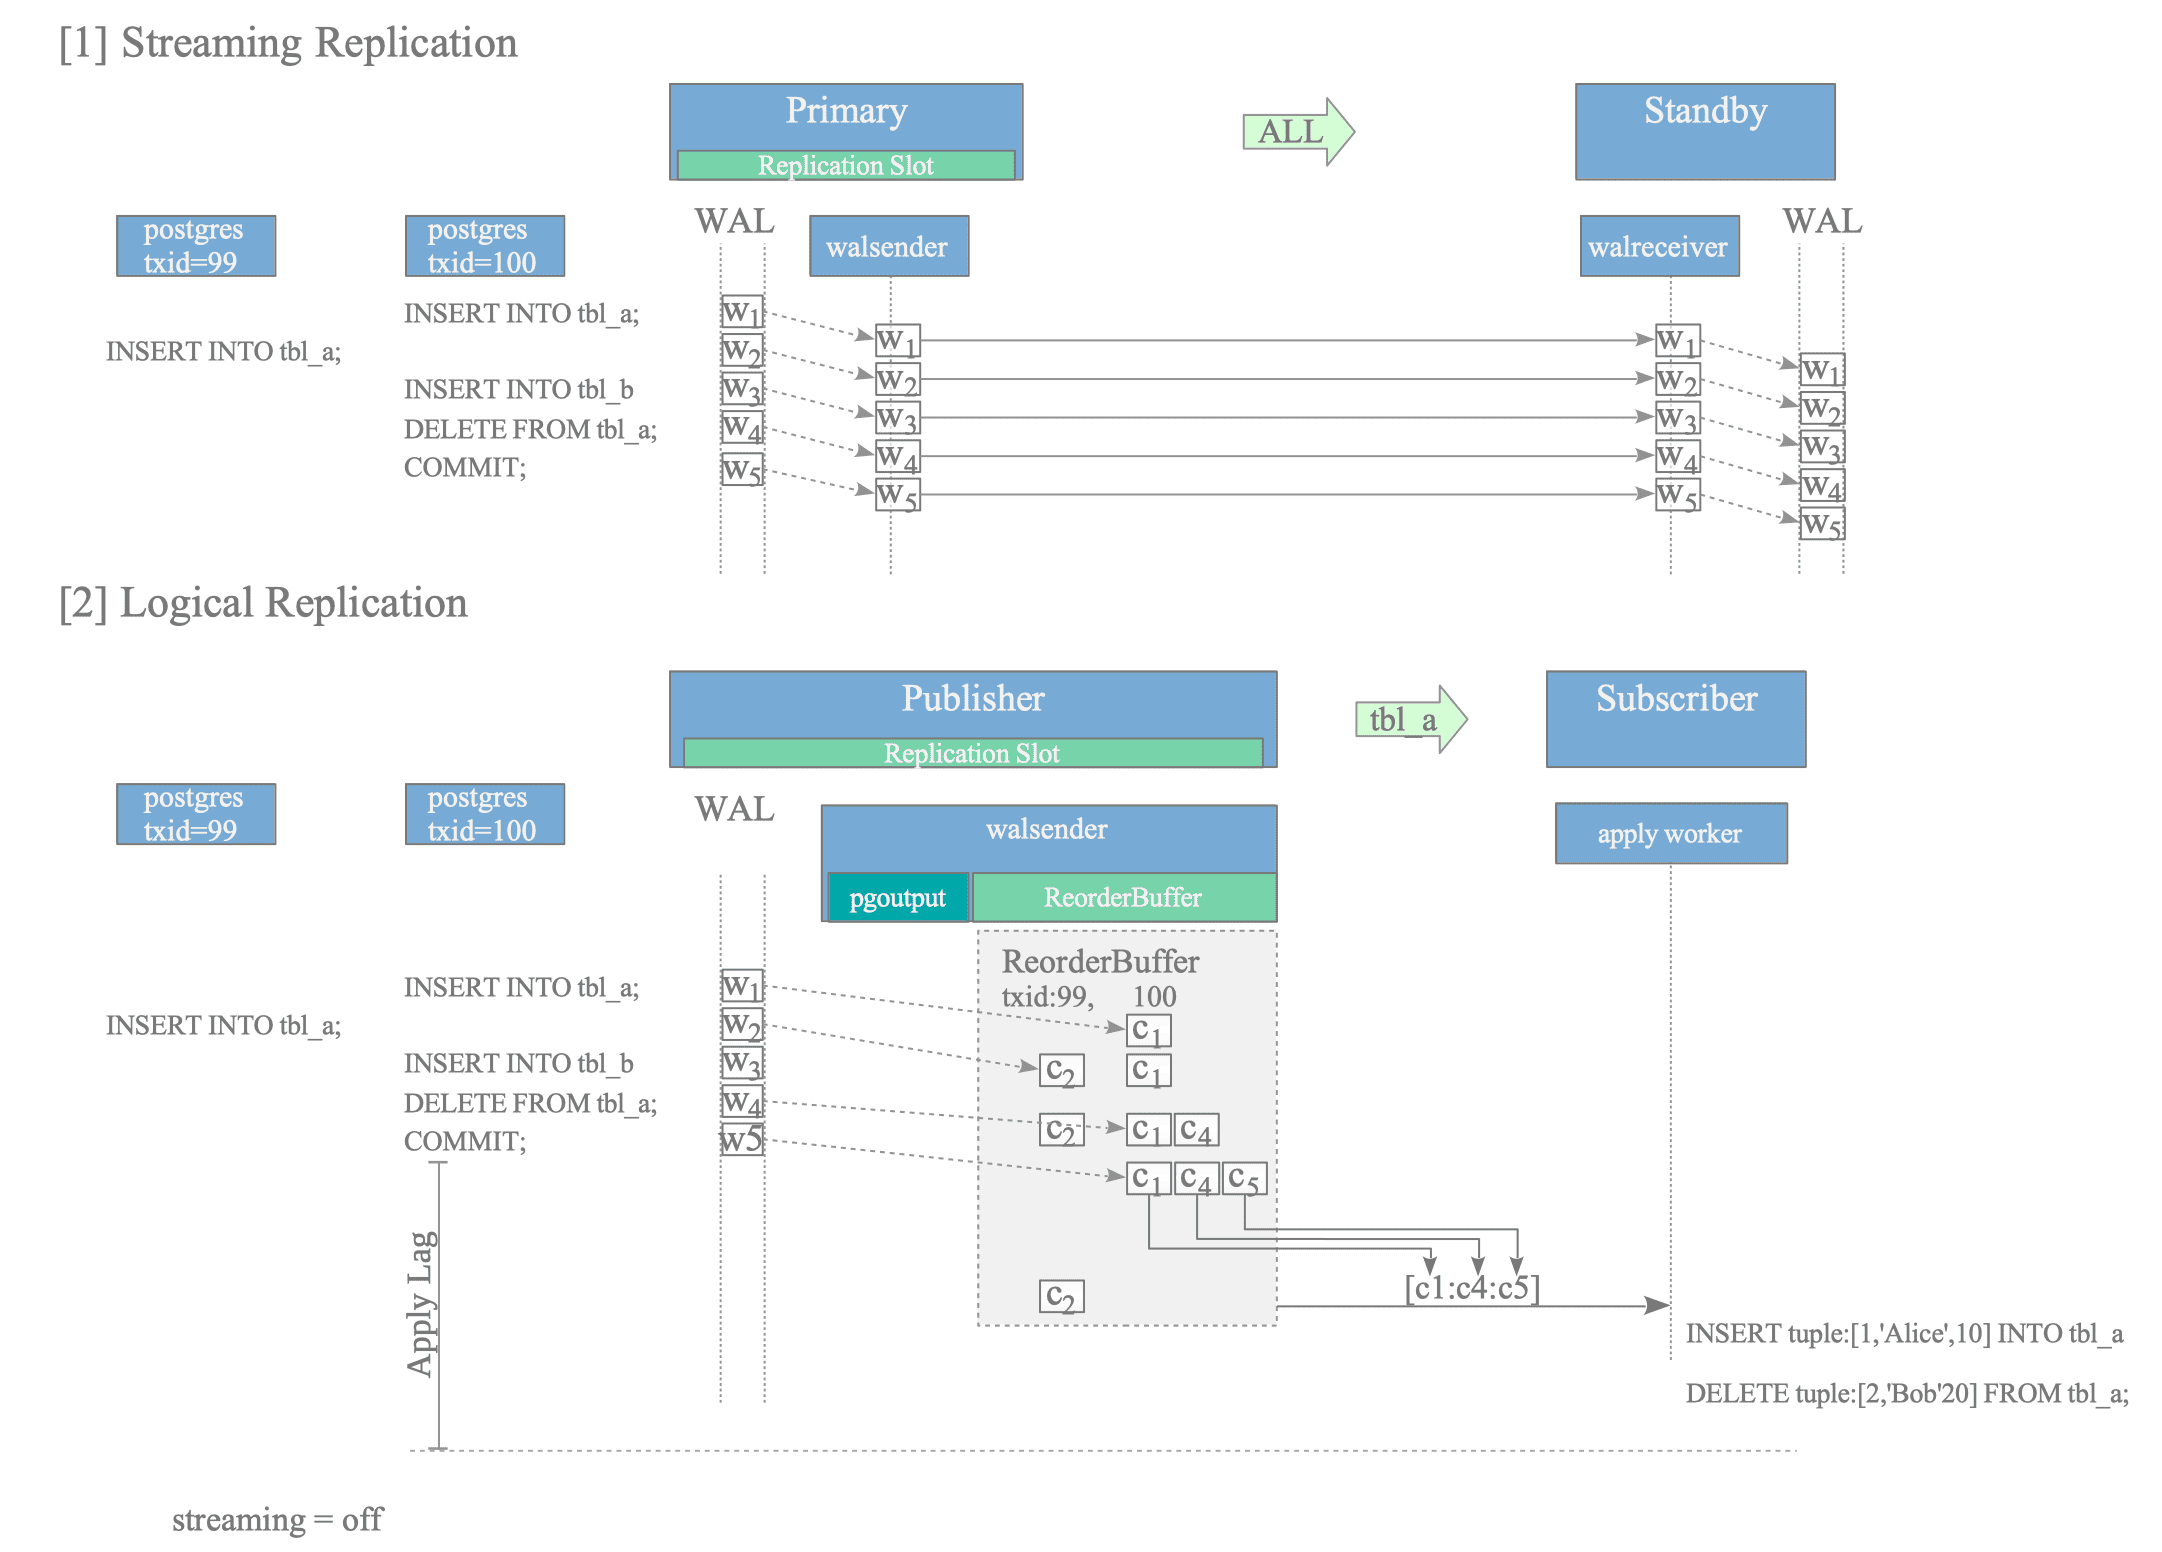
假设两个并发事务(txid=99和100)修改tbl_a与tbl_b:
- 流复制在每条SQL执行时依次写入WAL记录至,walsender不考虑事务是否提交,直接把记录发送给备库。walreceiver按相同顺序写入本地WAL,形成主库的物理镜像。
- 逻辑复制按事务边界与发布范围处理数据。walsender一边读取WAL,一边把记录解码为逻辑变更,并在ReorderBuffer中按事务重组,而不是立即发送。
ReorderBuffer相关处理分为三步:
- 过滤: 按发布范围过滤变更。如果订阅者只订阅
tbl_a,那么来自tbl_b的变更会被丢弃。 - 解码与缓冲: 把每条WAL记录解码为逻辑变更,存入ReorderBuffer。
- 发送: 读到
txid=100的提交记录后,收集属于该事务且在发布范围内的、,连同提交消息一起发送。尚未提交的txid=99变更继续保留在缓冲区中。
标准逻辑复制默认使用pgoutput插件进行逻辑解码。订阅端apply worker根据收到的消息重建事务并执行相应修改。
12.1.2.1 异步与同步
PostgreSQL逻辑复制同时支持异步和同步模式,默认异步。
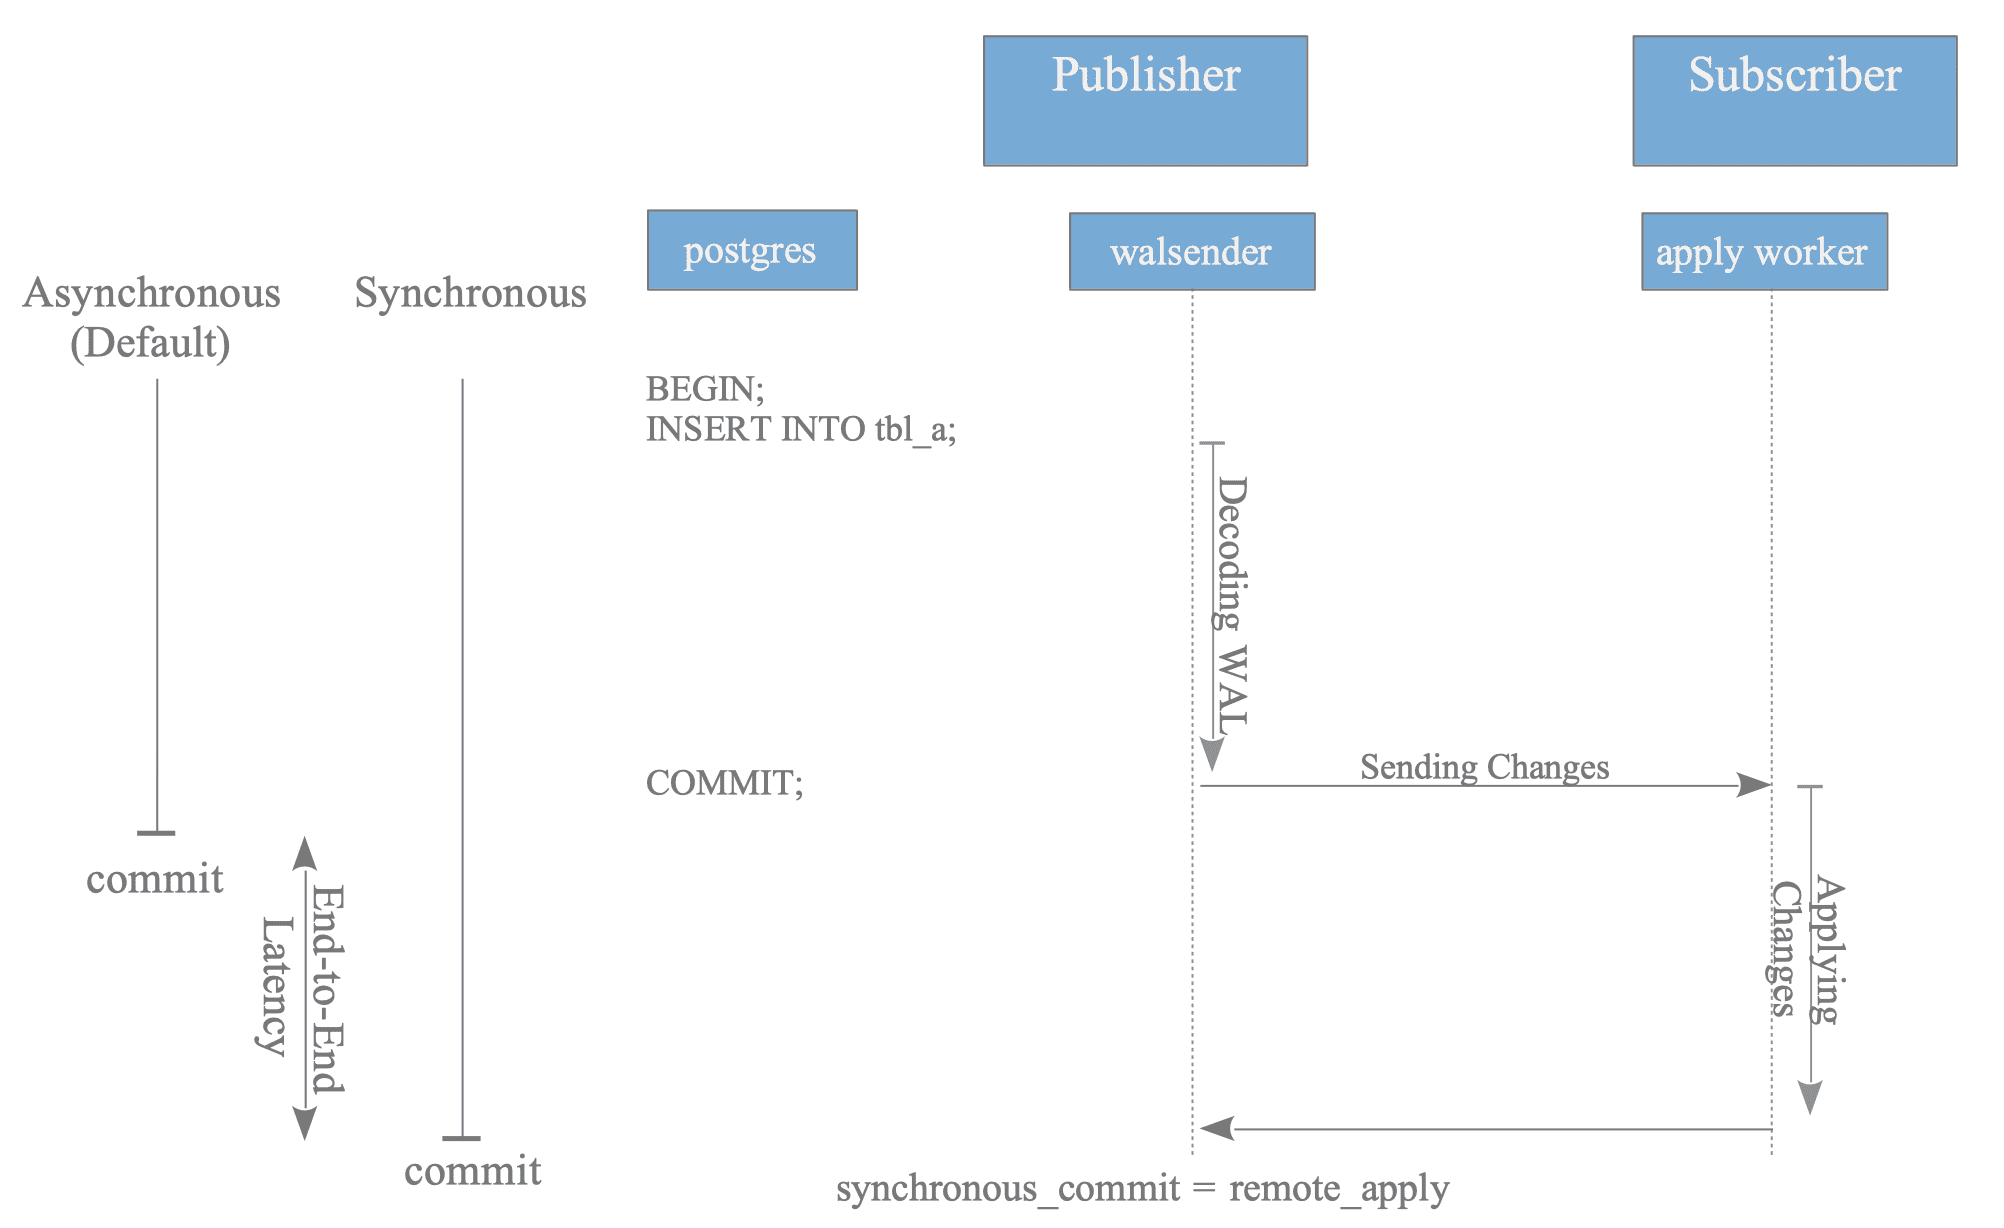
- 异步模式: 发布者的
COMMIT在本地WAL刷盘后立即完成,不等待订阅者响应。 - 同步模式: 当
synchronous_commit='remote_apply'时,发布者提交会等待订阅者ACK;apply worker只有在订阅端完成应用后才发送确认。
同步模式相较异步模式多出的提交耗时称为端到端延迟(End-to-End Latency)。事务越大,解码、传输和应用越耗时:异步模式下体现为更大的复制延迟和更长的不一致窗口;同步模式下则直接增加发布者的提交延迟。
12.1.2.2 大事务的管理与优化
1. 标准事务处理(streaming=off)
变更量超过logical_decoding_work_mem后,walsender会把ReorderBuffer中的数据写入磁盘溢出文件(spill file)。
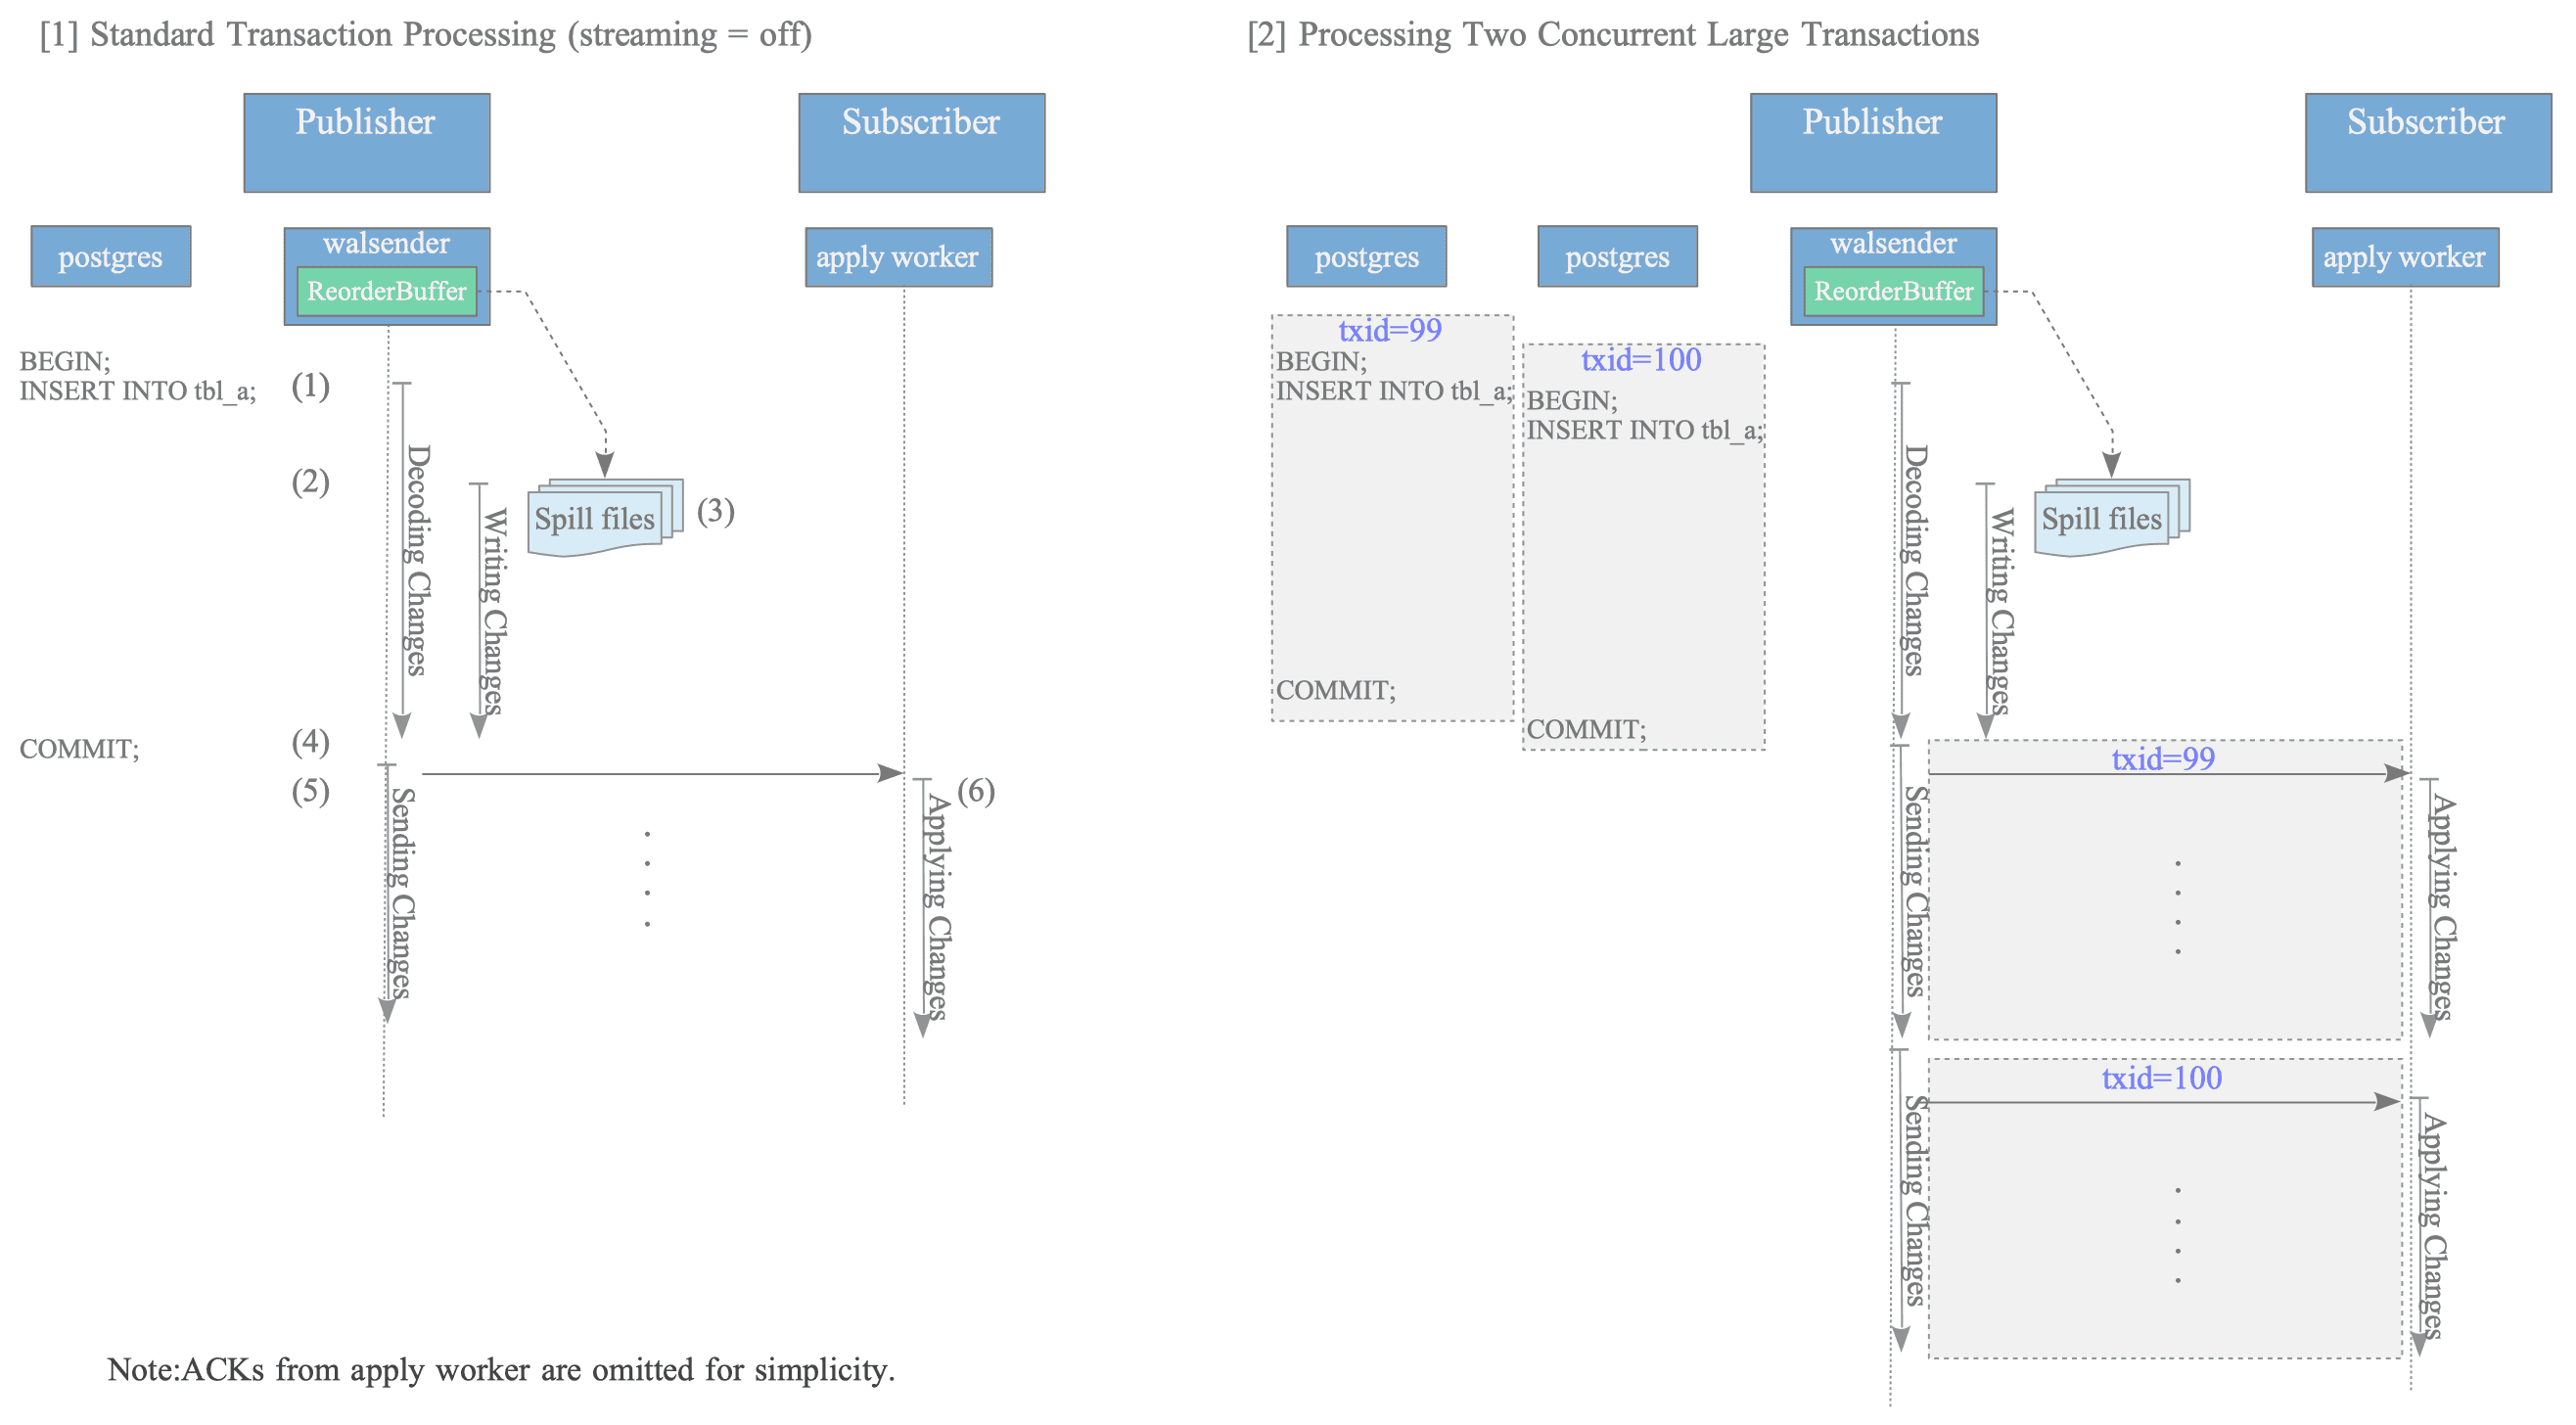
处理流程为:变更进入ReorderBuffer;超出内存限制后写入溢出文件;事务在发布者提交;walsender从内存和溢出文件收集全部变更并发送;apply worker按顺序应用。每条连接一次只发送一个事务,因此大事务容易造成明显复制延迟。
2. 大事务提交前流式发送(PostgreSQL 14及以后)
PostgreSQL 14允许在事务提交前分段发送变更,从而隐藏提交后的传输开销。
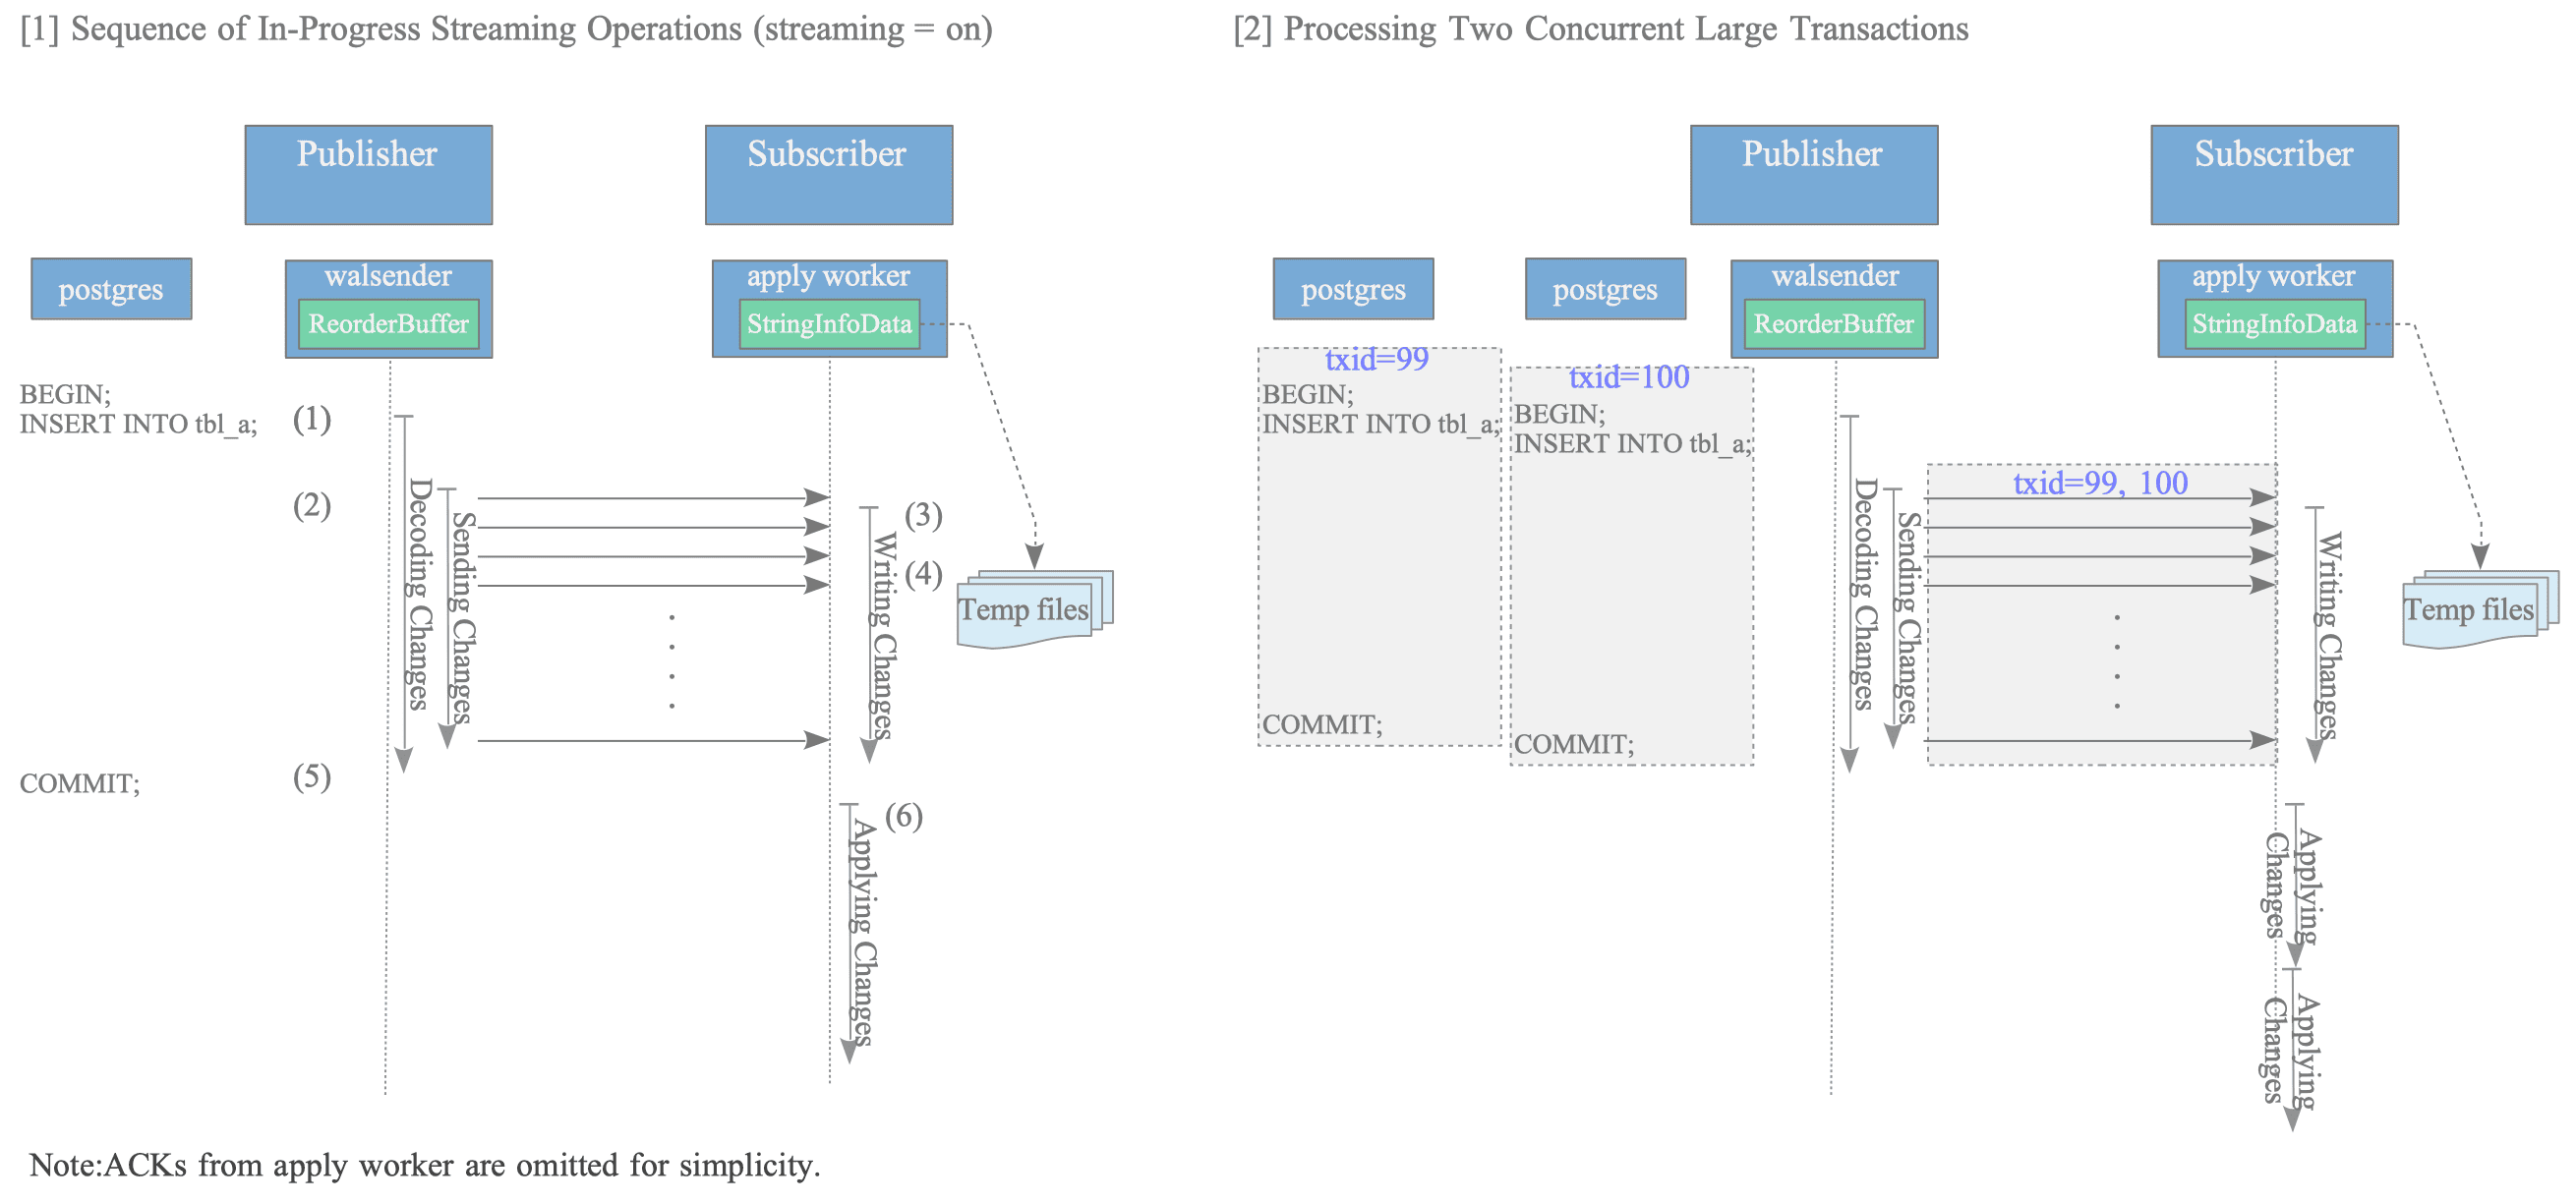
当ReorderBuffer达到内存阈值时,walsender立即开始发送;apply worker把收到的原始二进制消息缓存在StringInfoData original_msg中,超过订阅端内存限制后写入临时文件。发布者提交后,apply worker从内存或临时文件取出消息并应用。
使用CREATE SUBSCRIPTION ... WITH (streaming = on)启用该模式。apply worker的消息缓存同样受logical_decoding_work_mem控制。
3. 流式变更的并行应用(PostgreSQL 16及以后)
PostgreSQL 16进一步允许在事务提交前就并行应用已流式传输的变更,使传输与应用都能和发布者上的事务执行重叠。
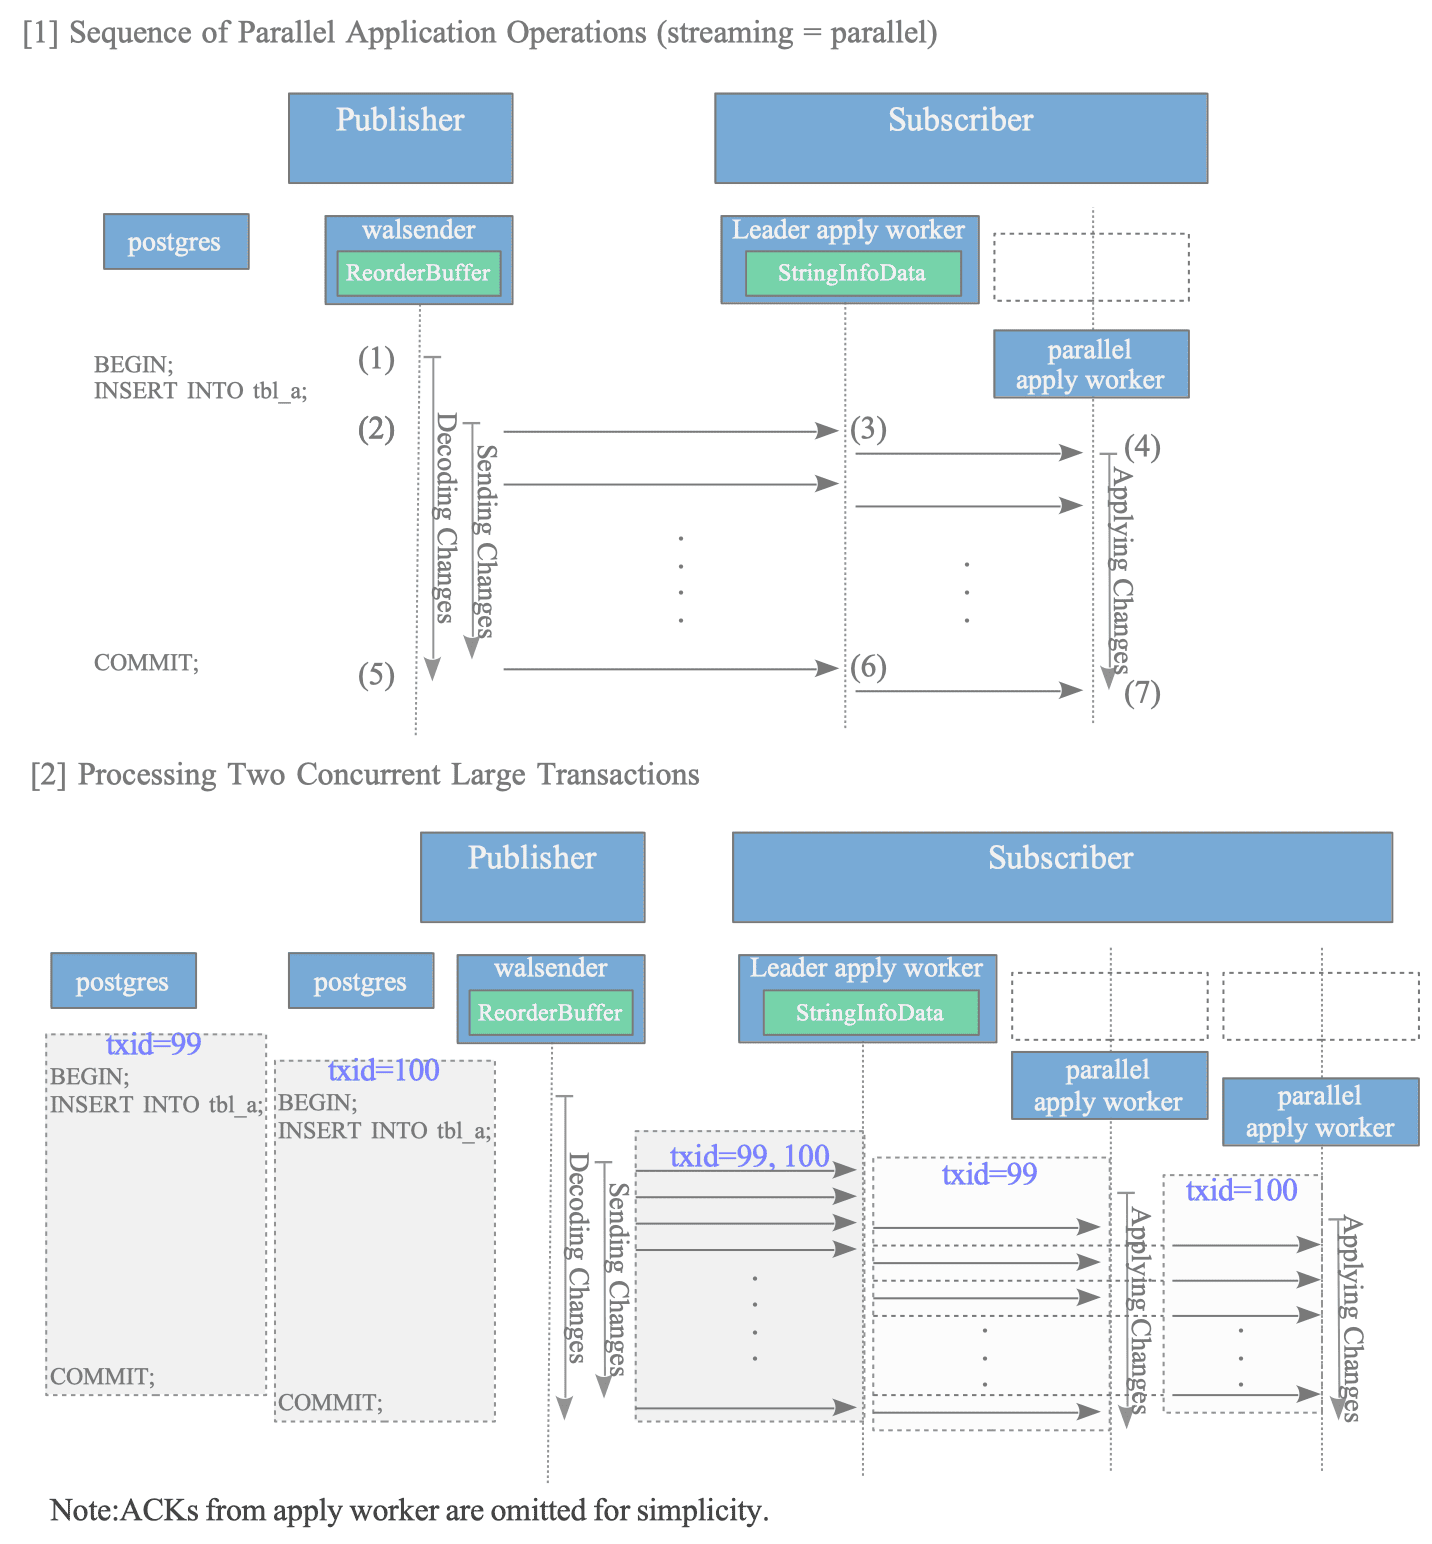
leader apply worker接收消息并分派给parallel apply worker;后者立即修改目标表。发布者提交后,leader把提交消息转交给parallel worker,由其完成本地事务。使用streaming='parallel'启用。若活跃worker达到max_parallel_apply_workers_per_subscription上限,则会退化为提交后串行应用。
12.1.3 副本标识
逻辑复制处理逻辑行,而不是块号、偏移量等物理位置。订阅者执行UPDATE或DELETE时,需要一个“搜索键”准确定位要修改的行,这就是副本标识(Replica Identity)。
如果发布表没有合适的副本标识,PostgreSQL会拒绝发布UPDATE或DELETE:
12.1.3.1 副本标识类型
| 模式 | 含义 | 特点 |
|---|---|---|
DEFAULT |
使用主键列 | 表有主键时自动使用 |
USING INDEX |
使用指定的唯一、非空索引 | 适用于无主键但有合适唯一索引的表 |
FULL |
记录行中所有列的旧值 | 无唯一约束时使用,但会增加消息体积 |
NOTHING |
不记录标识信息 | 无主键表的默认值;可复制INSERT,不能复制UPDATE与DELETE |
12.1.3.2 配置与验证
使用ALTER TABLE ... REPLICA IDENTITY配置:
模式保存在pg_class.relreplident中,取值为d(default)、n(nothing)、f(full)或i(index):
当使用USING INDEX时,具体索引并不存于pg_class.relreplident,而是在pg_index.indisreplident中标记。
12.1.4 复制来源
**复制来源(Replication Origin)**标识一次数据变更来自哪里,主要有两个用途:
- 跟踪复制进度: 订阅者应用外部变更时,把发布者的提交LSN记录到自己的WAL中,使中断后能从正确位置继续。
- 阻止无限复制环: 双向复制中,节点A发送到B的变更可能又被B发回A。给变更盖上来源标记,可以区分本地变更与复制得到的变更。
origin_id是订阅者本地分配的标识,不是集簇级或全局唯一键,其具体数字对其他节点没有意义:0表示事务最初在本节点执行;非零表示本节点正在重放上游变更。
12.1.4.1 使用复制来源阻止无限循环
订阅端表仍可写,因此两个节点可以同时作为发布者与订阅者,形成双活复制。
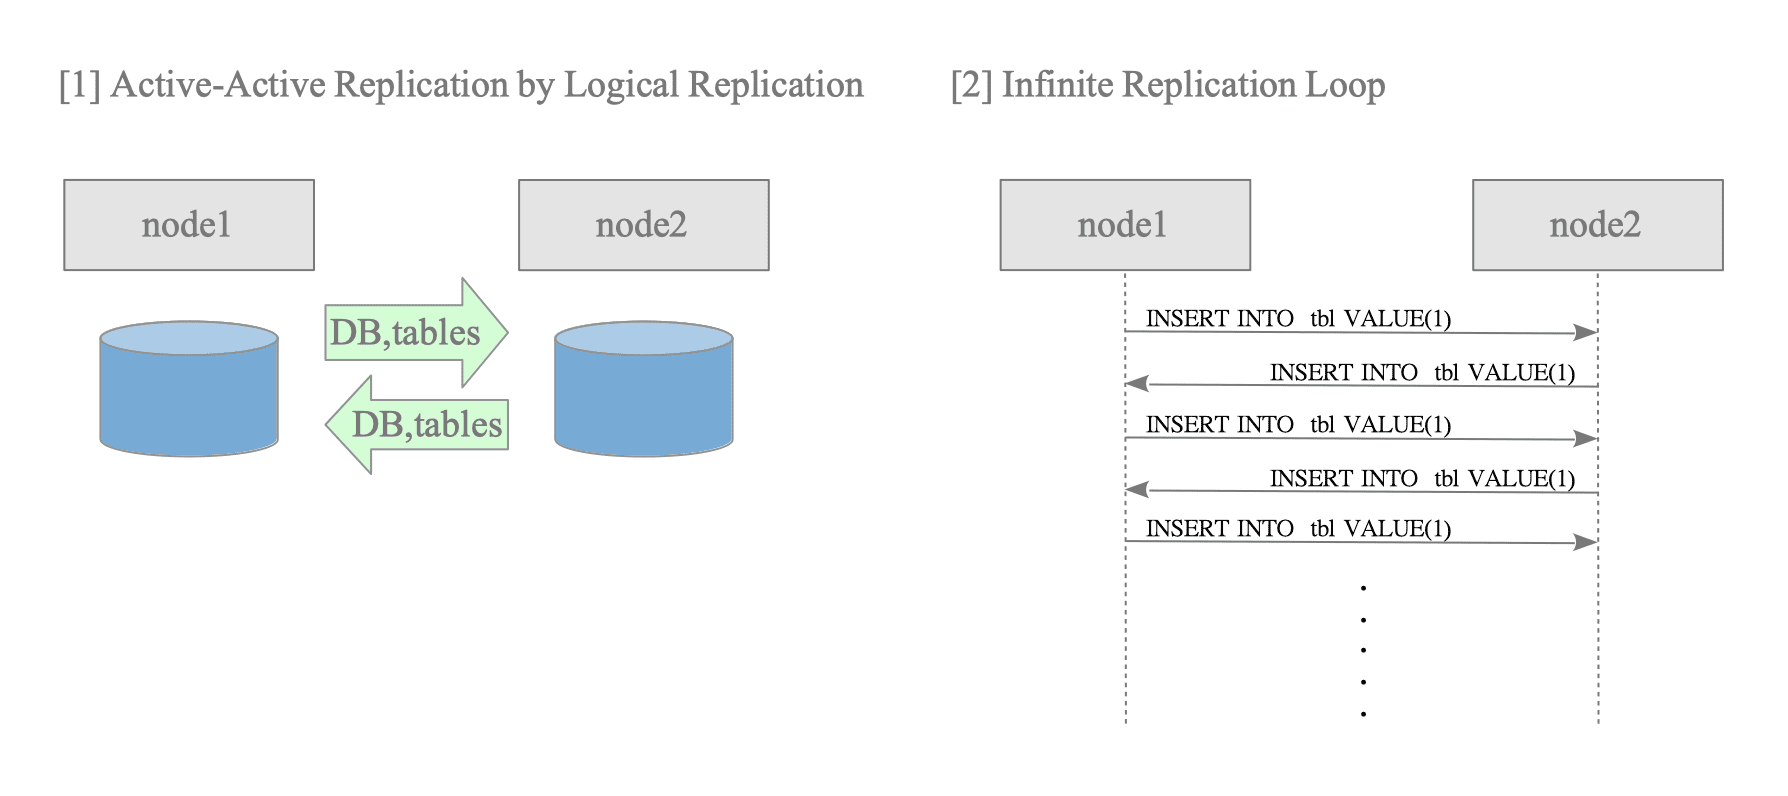
PostgreSQL 16以前会无条件转发所有解码变更,双向配置中同一变更会在节点之间不断往返。PostgreSQL 16增加了订阅参数origin:
origin='any'(默认):无论WAL来自本地事务还是外部消息应用,都继续发送。origin='none':过滤由外部节点消息应用所生成的WAL。
apply worker提交时,会在COMMIT或ABORT WAL记录上附加非零origin_id;walsender在ReorderBuffer中解码事务时读取来源。如果配置为none且发现来源标识,就跳过整个事务。
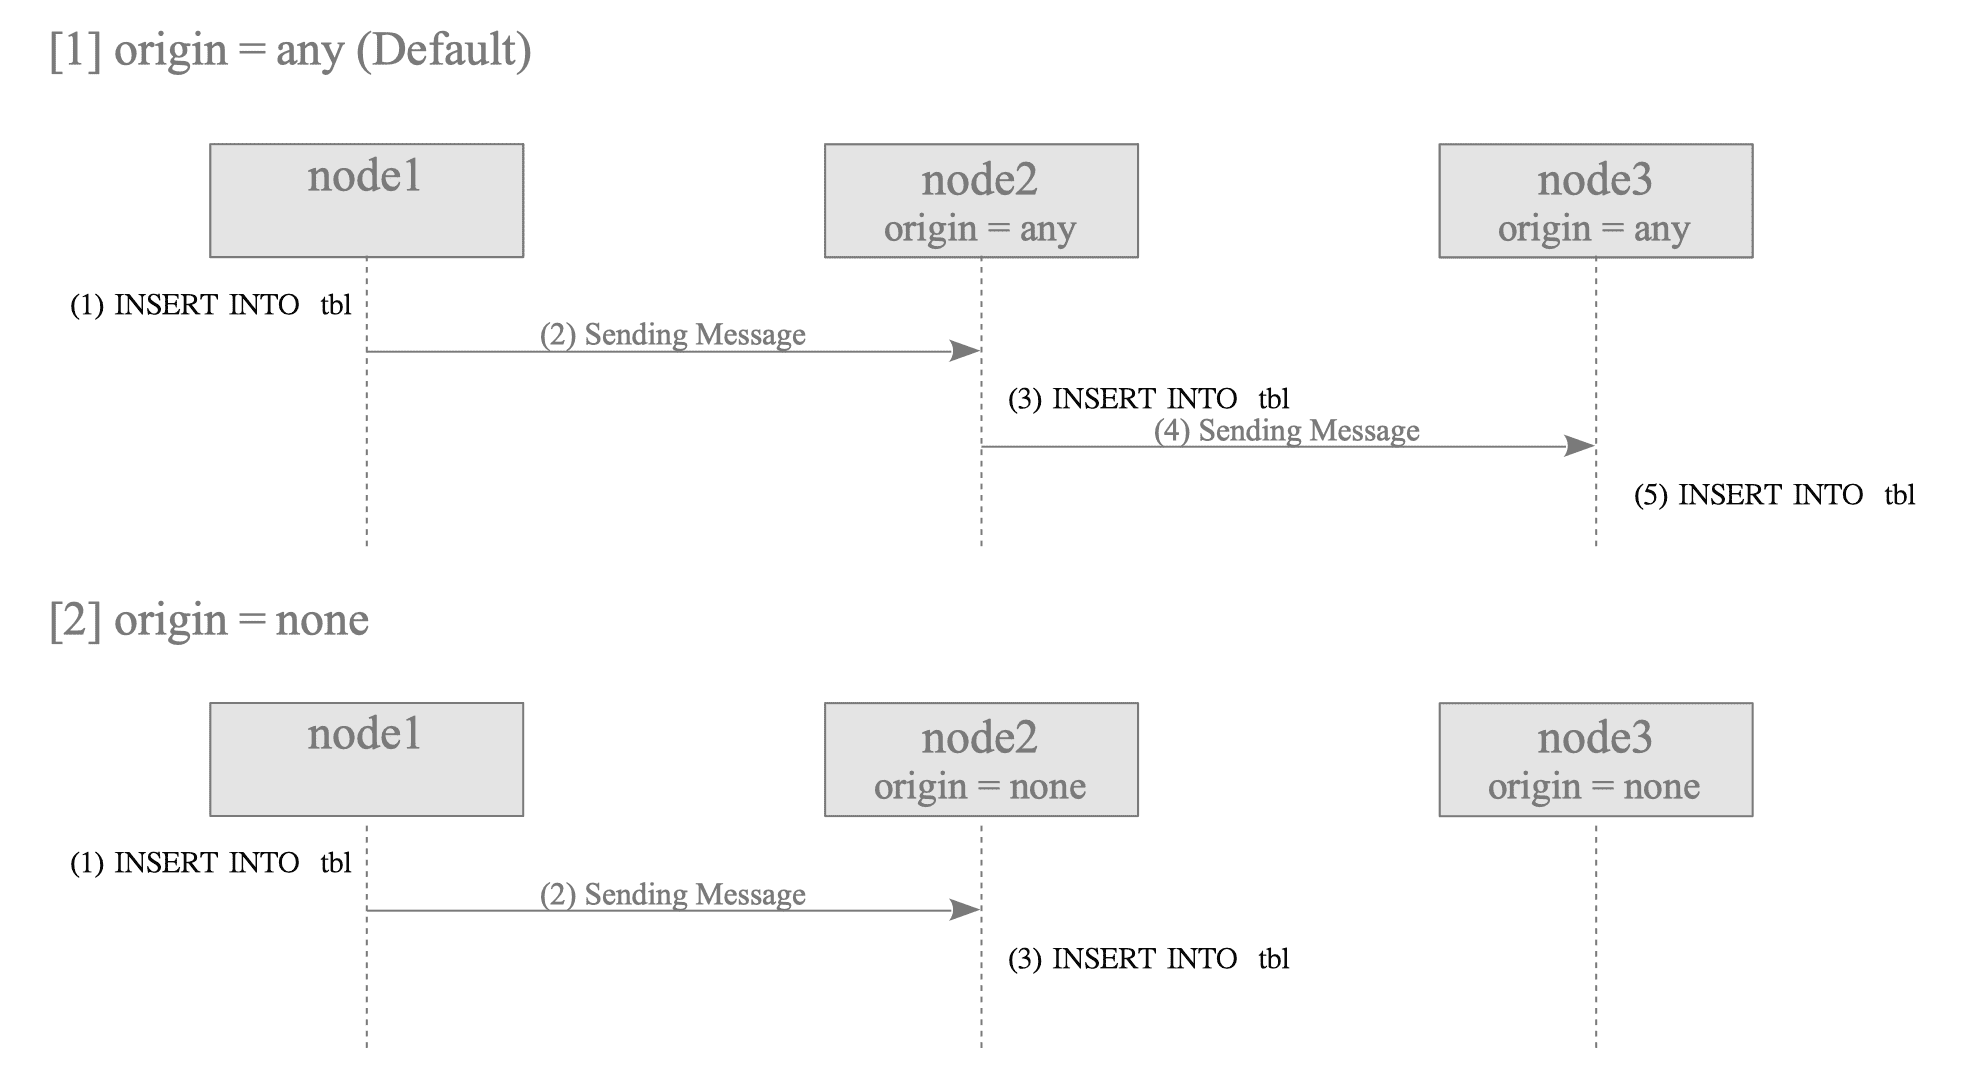
在Node 1 → Node 2 → Node 3的级联场景中,any允许Node 2继续转发带来源标记的变更;none则让Node 2应用变更但不再发往Node 3。所有参与节点都配置origin='none'即可避免双向拓扑中的无限循环。
12.1.5 逻辑复制槽
逻辑复制槽比物理槽多出若干属性,后续最重要的是:
plugin: 逻辑解码输出插件名,例如pgoutput。database: 复制槽所属数据库。物理槽作用于整个实例,逻辑槽严格限定在单个数据库。confirmed_flush_lsn: 订阅端apply worker已经确认收到数据的位置。发布者不再需要保留该LSN之前已提交事务的解码数据。
逻辑槽还包含catalog_xmin、two_phase等字段,详见pg_replication_slots官方文档。
12.1.6 冲突
逻辑复制不复制DDL,也不会像物理流复制那样受到发布者VACUUM的影响,因此不会出现流复制的那些冲突。逻辑复制冲突主要来自订阅端应用程序的并发写入。例如,一行先在订阅端被本地删除,随后发布者又尝试更新同一行,就会产生update_missing冲突。
PostgreSQL能够检测的完整冲突列表参见逻辑复制冲突官方文档。
12.2 启动逻辑复制
下面假设发布者已经存在需要复制的表,订阅者也已创建结构相同但尚无数据的表:
建立逻辑复制需要两条命令:在发布者执行CREATE PUBLICATION,在订阅者执行CREATE SUBSCRIPTION。
12.2.1 创建发布
CREATE PUBLICATION把发布信息写入pg_publication、pg_publication_rel和pg_publication_namespace,并在需要时更新pg_class:
系统视图pg_publication_tables展示发布与所属表之间的映射。
12.2.2 创建订阅
订阅者使用CREATE SUBSCRIPTION创建订阅:
整个过程分为三个阶段:创建订阅并默认请求发布者上的逻辑复制槽;连接apply worker与发布者walsender;同步发布中的表。
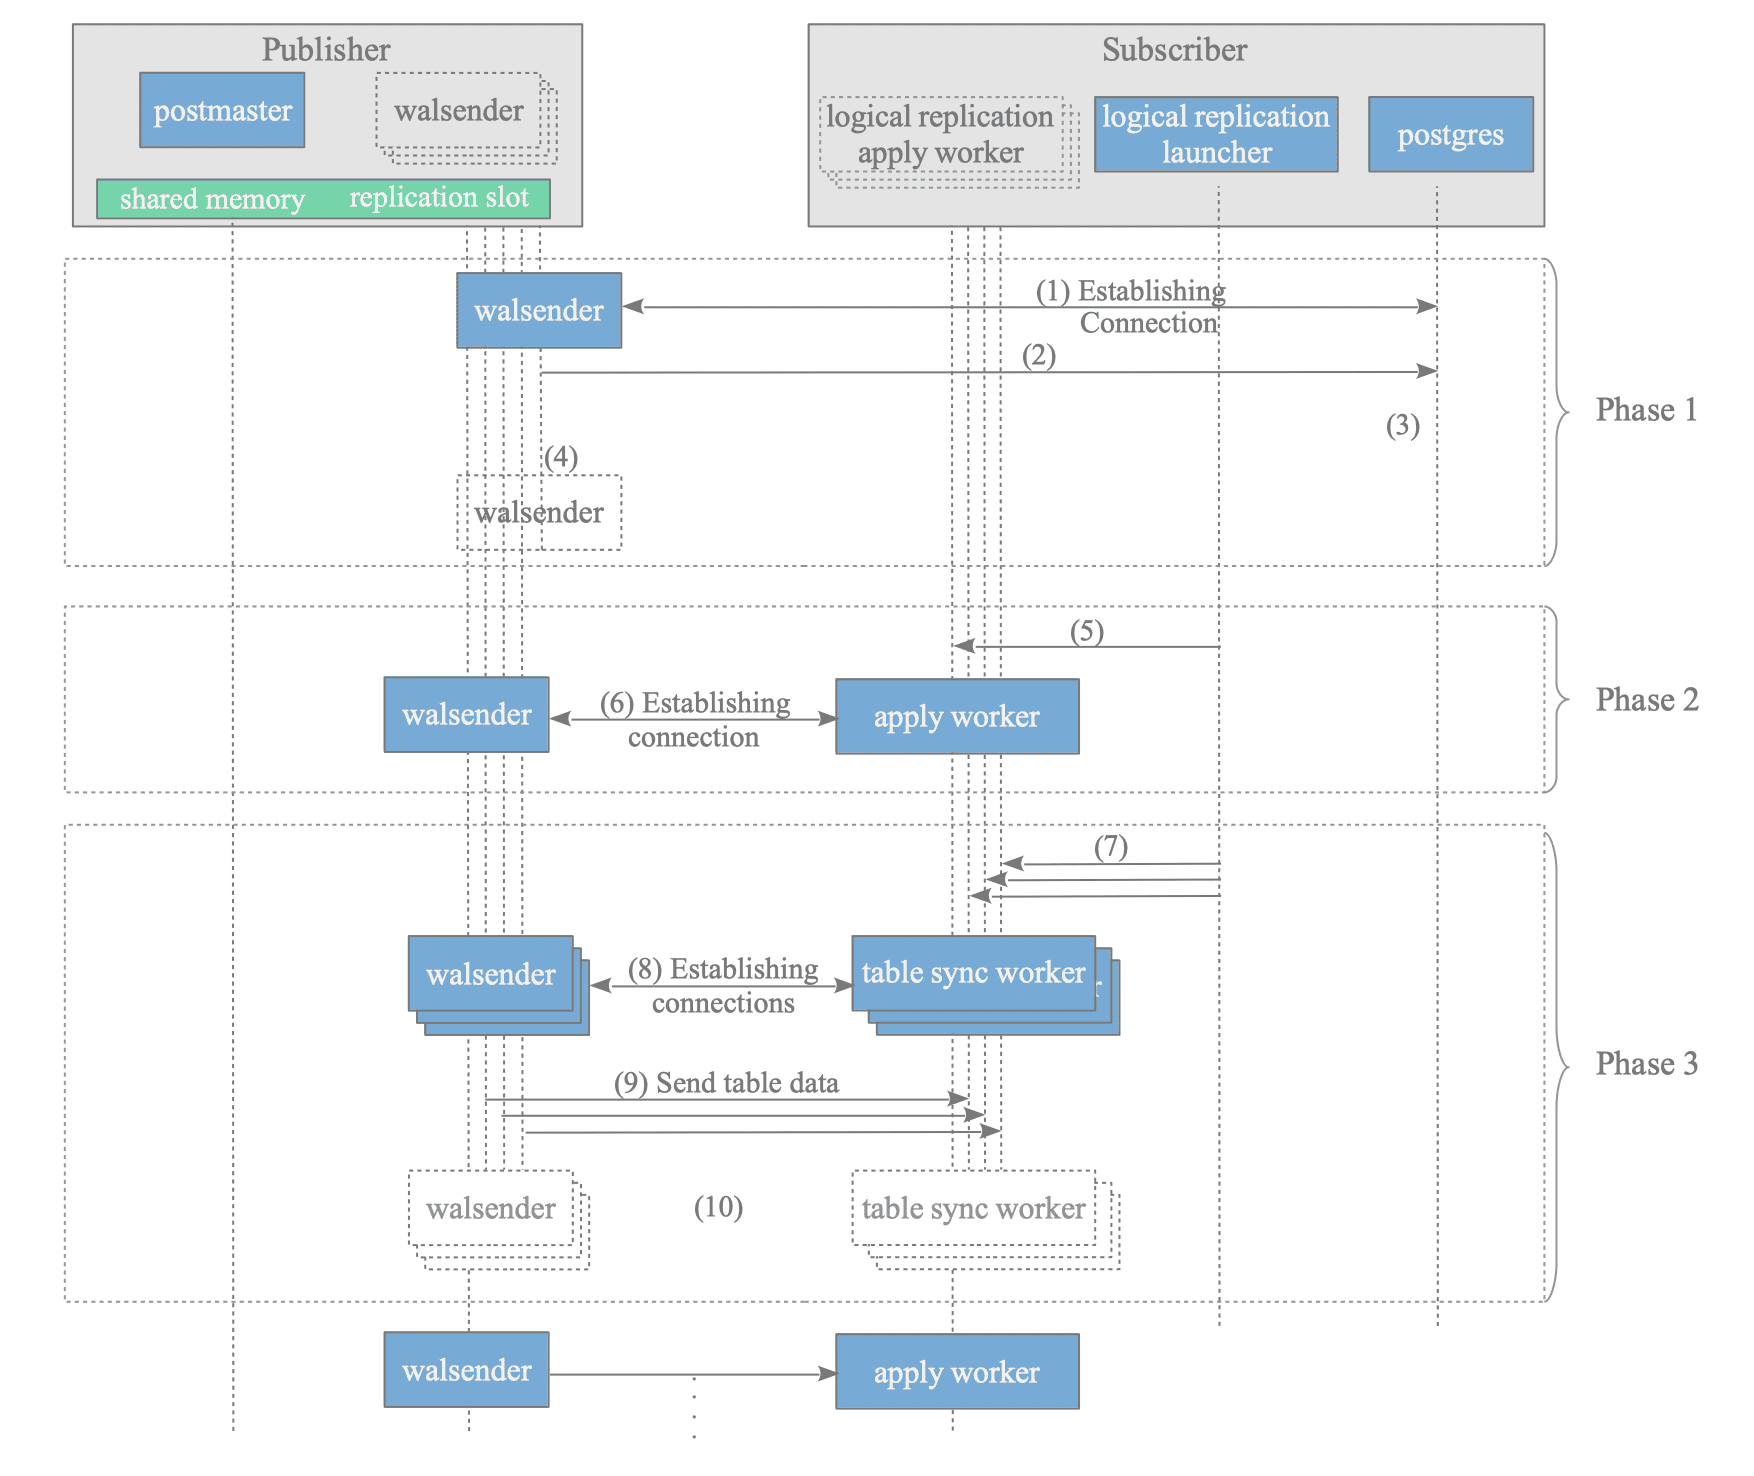
12.2.2.1 阶段一:创建元数据和复制槽
订阅端首先完成两项工作:把订阅元数据写入pg_subscription与pg_subscription_rel;默认请求发布者创建逻辑复制槽。
- 执行
CREATE SUBSCRIPTION的postgres进程连接发布者walsender。 - 它检查指定发布是否存在,取得目标表的模式和OID并验证结构兼容性;如果没有指定复用现有槽,则请求创建新槽。
- 把订阅信息写入
pg_subscription和pg_subscription_rel。 - 发布者终止这条初始化连接所用的walsender。
发布者上会出现使用pgoutput的逻辑槽:
12.2.2.2 阶段二:启动后台进程
- Logical Replication Launcher启动apply worker。
- apply worker连接发布者walsender,并初始化复制来源;若
pg_replication_origin中还没有对应项,则创建一个。
此后,发布者walsender与订阅者apply worker会持续运行,负责发送和应用增量变更。
12.2.2.3 阶段三:同步表
Logical Replication Launcher启动专门的table sync worker,从发布者取得目标表的现有行。为了提高效率,launcher会在配置上限内尽可能并发启动多个同步worker。
- launcher启动table sync worker。
- table sync worker连接发布者上的walsender。
- walsender发送表数据,table sync worker把数据插入订阅端目标表。
- 表追上主复制流后,table sync worker及其walsender终止,后续变更交给主apply worker。
walsender与table sync worker使用COPY ... TO STDOUT和COPY ... FROM STDIN协议高效传输并插入表数据,内部实现见tablesync.c。
PostgreSQL 17还提供
pg_createsubscriber,可以把物理备库转换为逻辑订阅者。
12.3 ReorderBuffer结构
每个walsender都会分配一块ReorderBuffer区域,其内存使用受logical_decoding_work_mem限制,默认64 MB。
ReorderBuffer由三个核心组件组成:ReorderBuffer、ReorderBufferTXN与ReorderBufferChange。
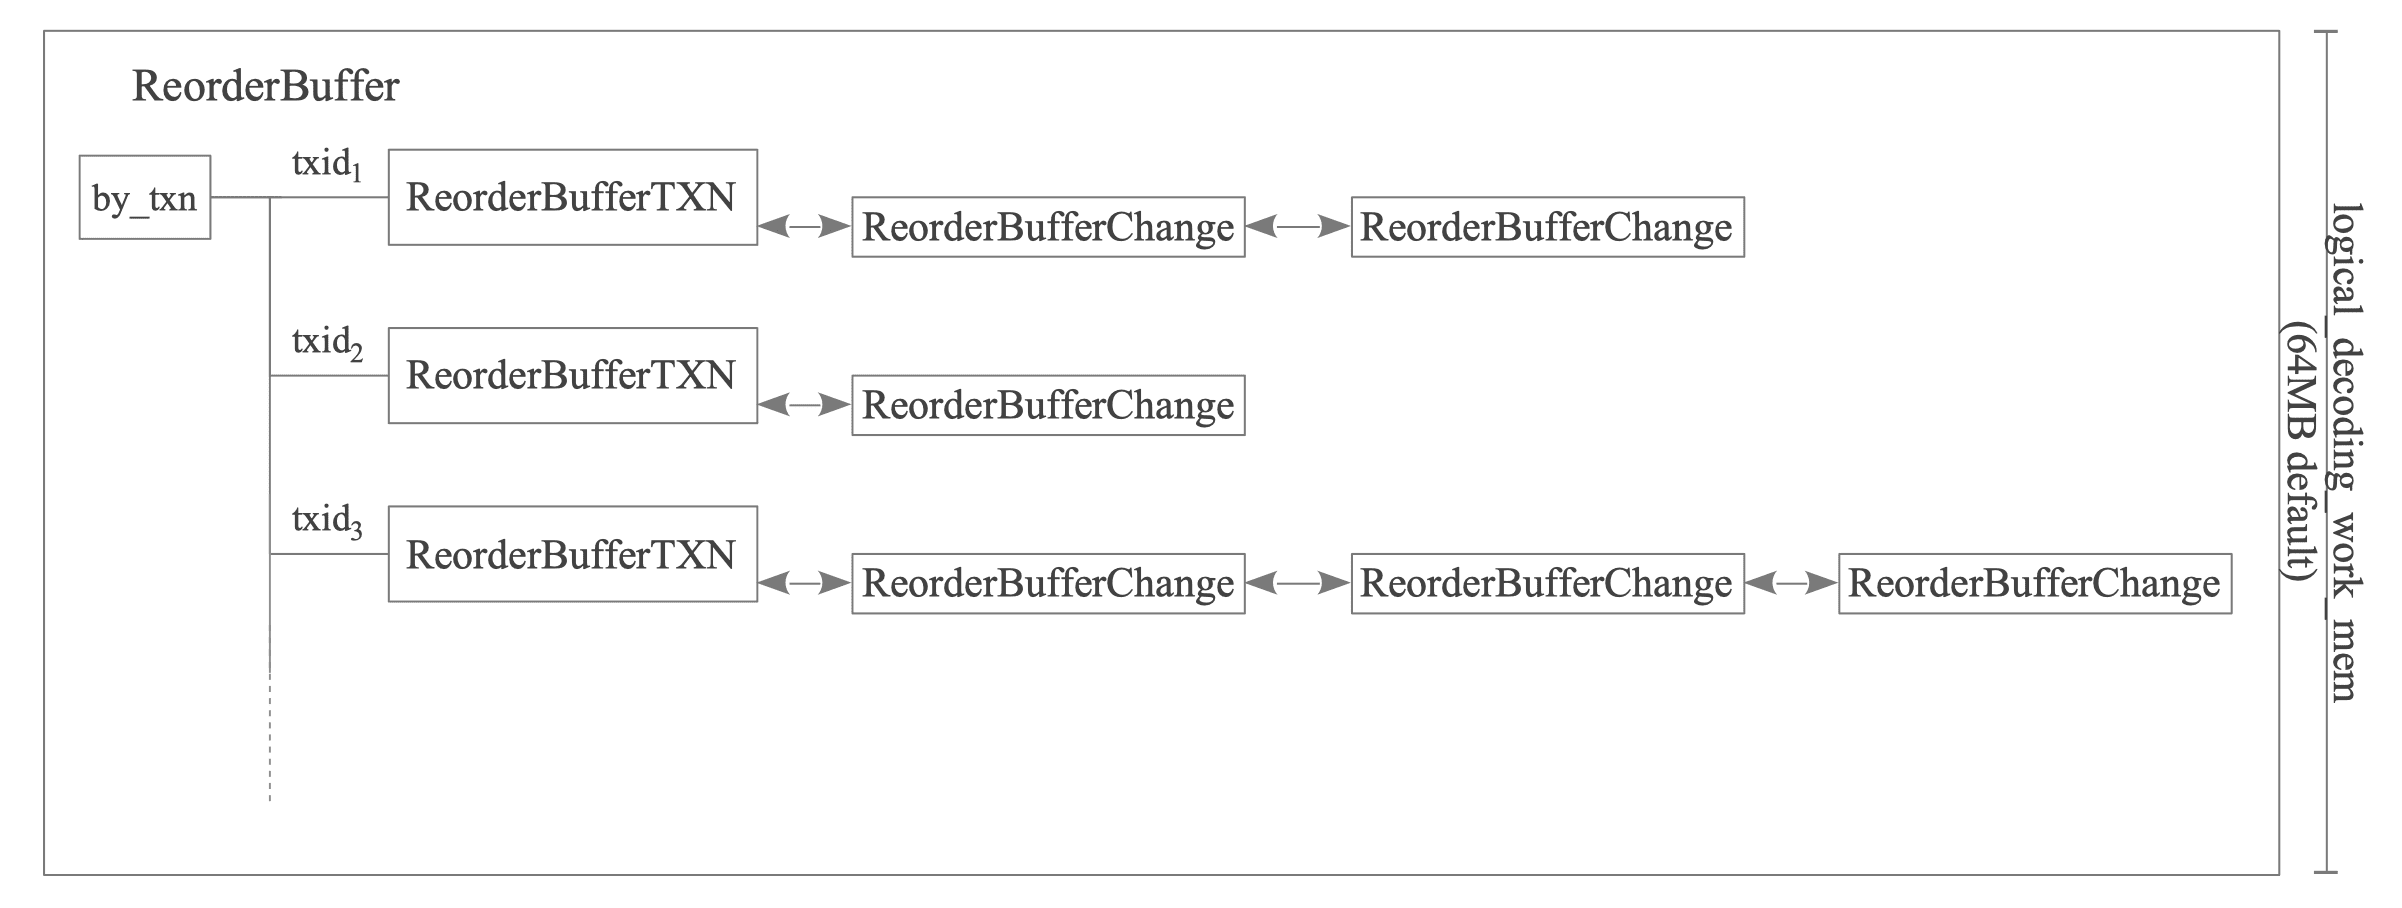
ReorderBuffer最重要的成员是以事务ID为键的by_txn散列表。每个表项都是一个ReorderBufferTXN,保存某个事务的元数据和实际WAL变更。每次INSERT、UPDATE、DELETE等修改则表示为ReorderBufferChange,按LSN顺序追加到对应事务的changes双向链表。
12.3.1 ReorderBuffer
该结构保存逻辑解码的主上下文:
| 字段 | 类型 | 含义 |
|---|---|---|
by_txn |
HTAB * |
从txid映射到ReorderBufferTXN的散列表,用于快速查找活动事务。 |
12.3.2 ReorderBufferTXN
该结构管理单个事务及其变更:
| 字段 | 类型 | 含义 |
|---|---|---|
first_lsn |
XLogRecPtr |
此事务第一条变更记录的LSN。 |
final_lsn |
XLogRecPtr |
此事务提交或中止记录的LSN。 |
origin_id |
RepOriginId |
事务最初产生处的复制来源ID。 |
origin_lsn |
XLogRecPtr |
事务在来源发布者上的提交LSN。 |
base_snapshot |
Snapshot |
解码事务时使用的历史快照,确保扫描系统目录时可见性正确。 |
changes |
dlist_head |
按LSN顺序保存ReorderBufferChange的双向链表。 |
base_snapshot对于刚创建复制槽或事务修改系统目录时尤其重要;后文主要关注稳定运行阶段的数据流,因此不再展开。
12.3.3 ReorderBufferChange
该结构表示一次独立数据修改,主要字段如下:
| 字段 | 类型 | 含义 |
|---|---|---|
lsn |
XLogRecPtr |
产生该变更的WAL记录LSN。 |
action |
ReorderBufferChangeType |
INSERT、UPDATE、DELETE、TRUNCATE等操作类型。 |
data |
union |
与操作类型对应的数据。 |
data.tp.rlocator |
RelFileLocator |
被修改关系的表空间OID、数据库OID和relfilenode编号。 |
data.tp.oldtuple |
HeapTuple |
UPDATE或DELETE需要时保存的旧元组,取决于副本标识。 |
data.tp.newtuple |
HeapTuple |
INSERT或UPDATE后的新元组。 |
核心结构可以简化为:
12.4 WAL数据过滤与缓冲
本节介绍walsender如何通过多级过滤决定哪些WAL记录可以进入ReorderBuffer,并用一个并发事务示例展示ReorderBuffer如何累积变更;随后说明副本标识如何决定UPDATE、DELETE记录中的元组数据,以及超过内存上限后的磁盘溢出机制。
12.4.1 过滤
walsender通过多道过滤门决定是否解码一条WAL记录并把它加入ReorderBuffer的changes链表:
- 数据库OID: 立即丢弃不属于目标数据库的WAL记录。
- 来源ID/回调: PostgreSQL 16起,在数据进入ReorderBuffer之前检查来源。配置
origin='none'时,丢弃来自其他节点(origin_id > 0)的变更,阻止无限复制环。 - 发布缓存: PostgreSQL 15起,在缓冲前按表过滤;不属于发布的表,以及被行过滤器排除的行,都不会进入缓冲区。
- 关系类型/物理结构: 过滤索引更新。逻辑复制只关心行级变化;订阅端修改元组后,本地索引机制会自动更新索引。
只有通过全部过滤门的变更才会存入ReorderBuffer。
PostgreSQL 14及以前: 旧版本先检查数据库OID,再解码并缓冲所有变更,直到
COMMIT时才按发布定义过滤。这种惰性过滤会让ReorderBuffer暂时保存最终必然丢弃的数据,浪费内存。
12.4.2 WAL数据缓冲
下面用两个并发事务说明walsender如何从原始WAL重建逻辑变更。
12.4.2.1 目标关系
tbl_a与tbl_b都使用主键作为默认副本标识:
12.4.2.2 交错事务场景
两个事务txid=840与841按以下时间线交错执行:
事务隔离级别不会影响逻辑解码。隔离级别在事务运行时控制元组可见性;逻辑解码处理的则是已经完成可见性检查、写入WAL的历史结果,它只负责按事务重组这些结果。
12.4.2.3 ReorderBuffer状态变化
T1:txid=840向tbl_a插入
系统为txid=840创建ReorderBufferTXN,把first_lsn设为该INSERT记录的LSN,并把变更加入changes链表。
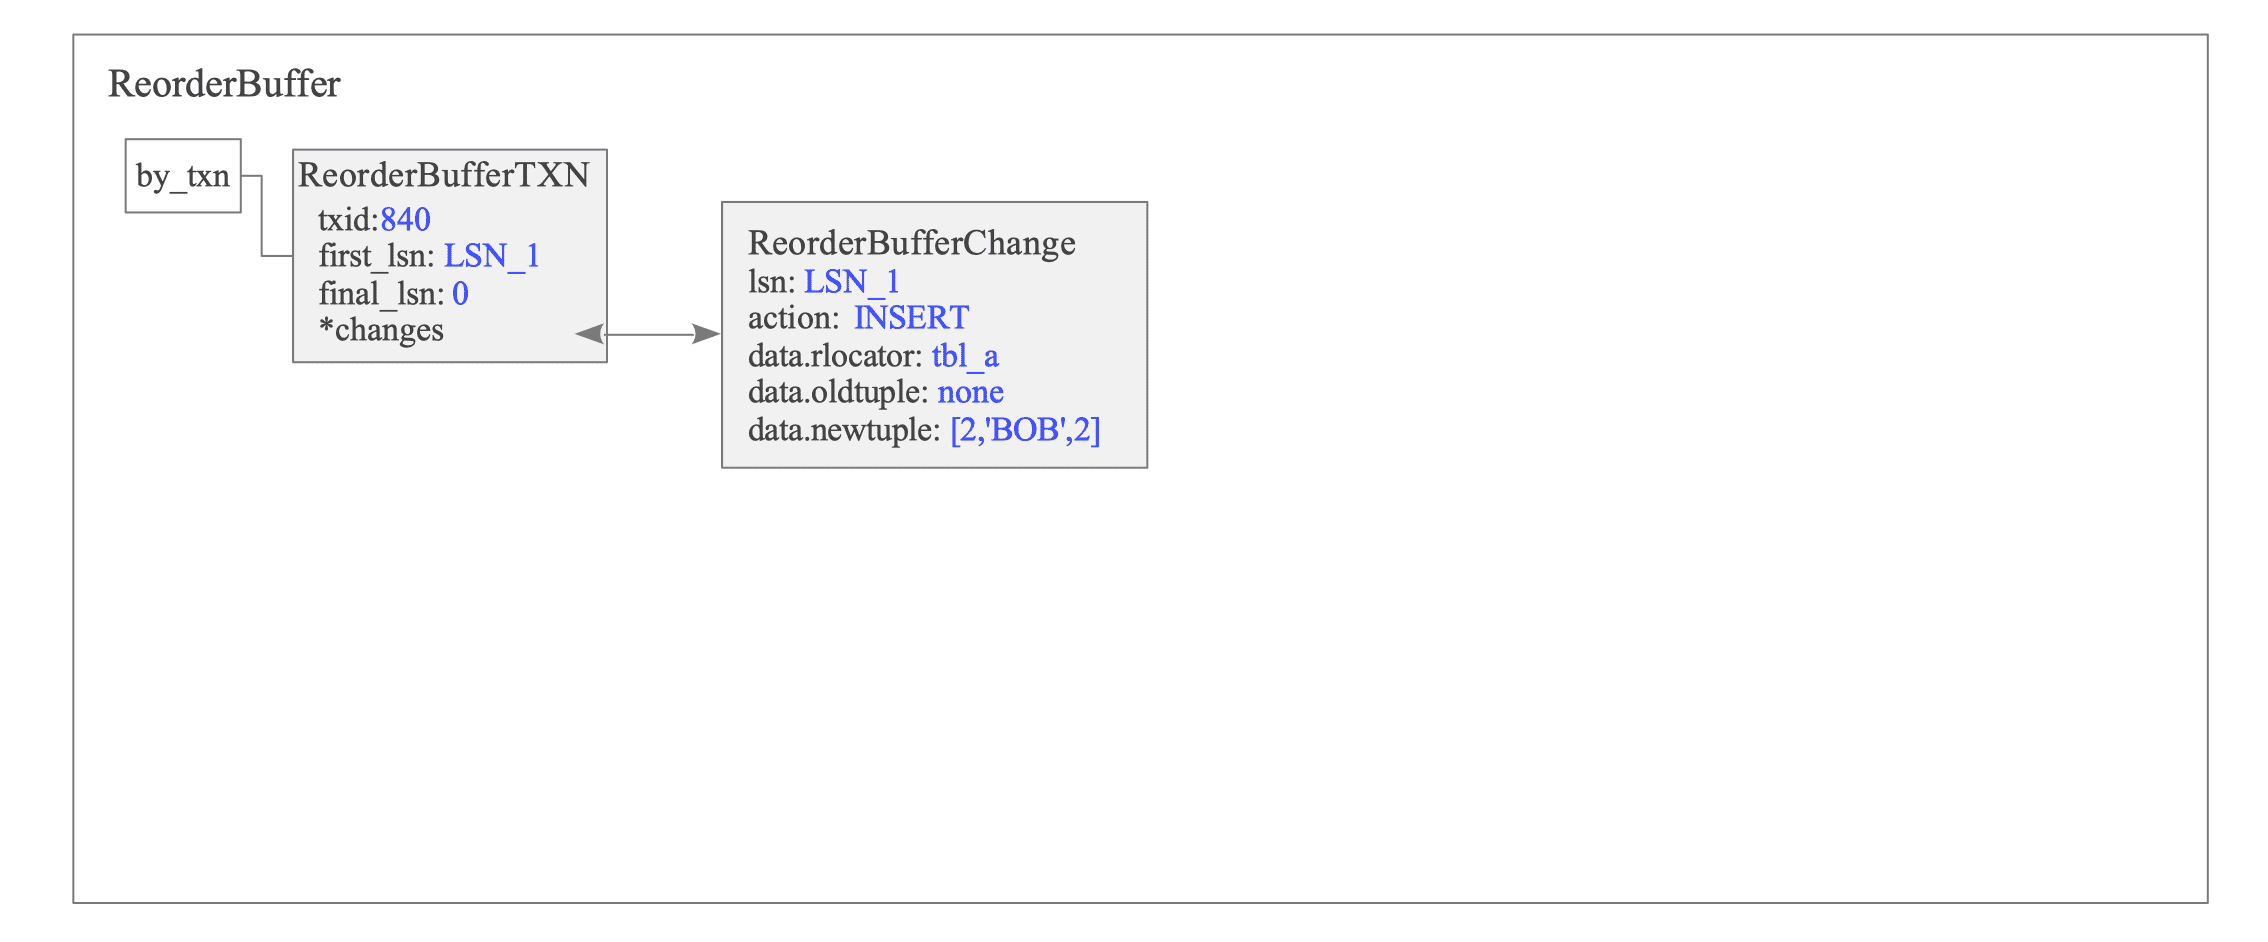
ReorderBufferChange保存LSN、INSERT等动作类型、目标表空间/数据库/关系OID和实际元组数据。
当
wal_level=logical时,整页写入的main data部分包含实际被修改的元组。walsender可以直接从main data取得元组,而无需解析整个页面块,从而降低逻辑解码开销。
T2:txid=841向tbl_a插入
系统为txid=841创建另一份ReorderBufferTXN。两个事务的变更存入相互独立的子链表。
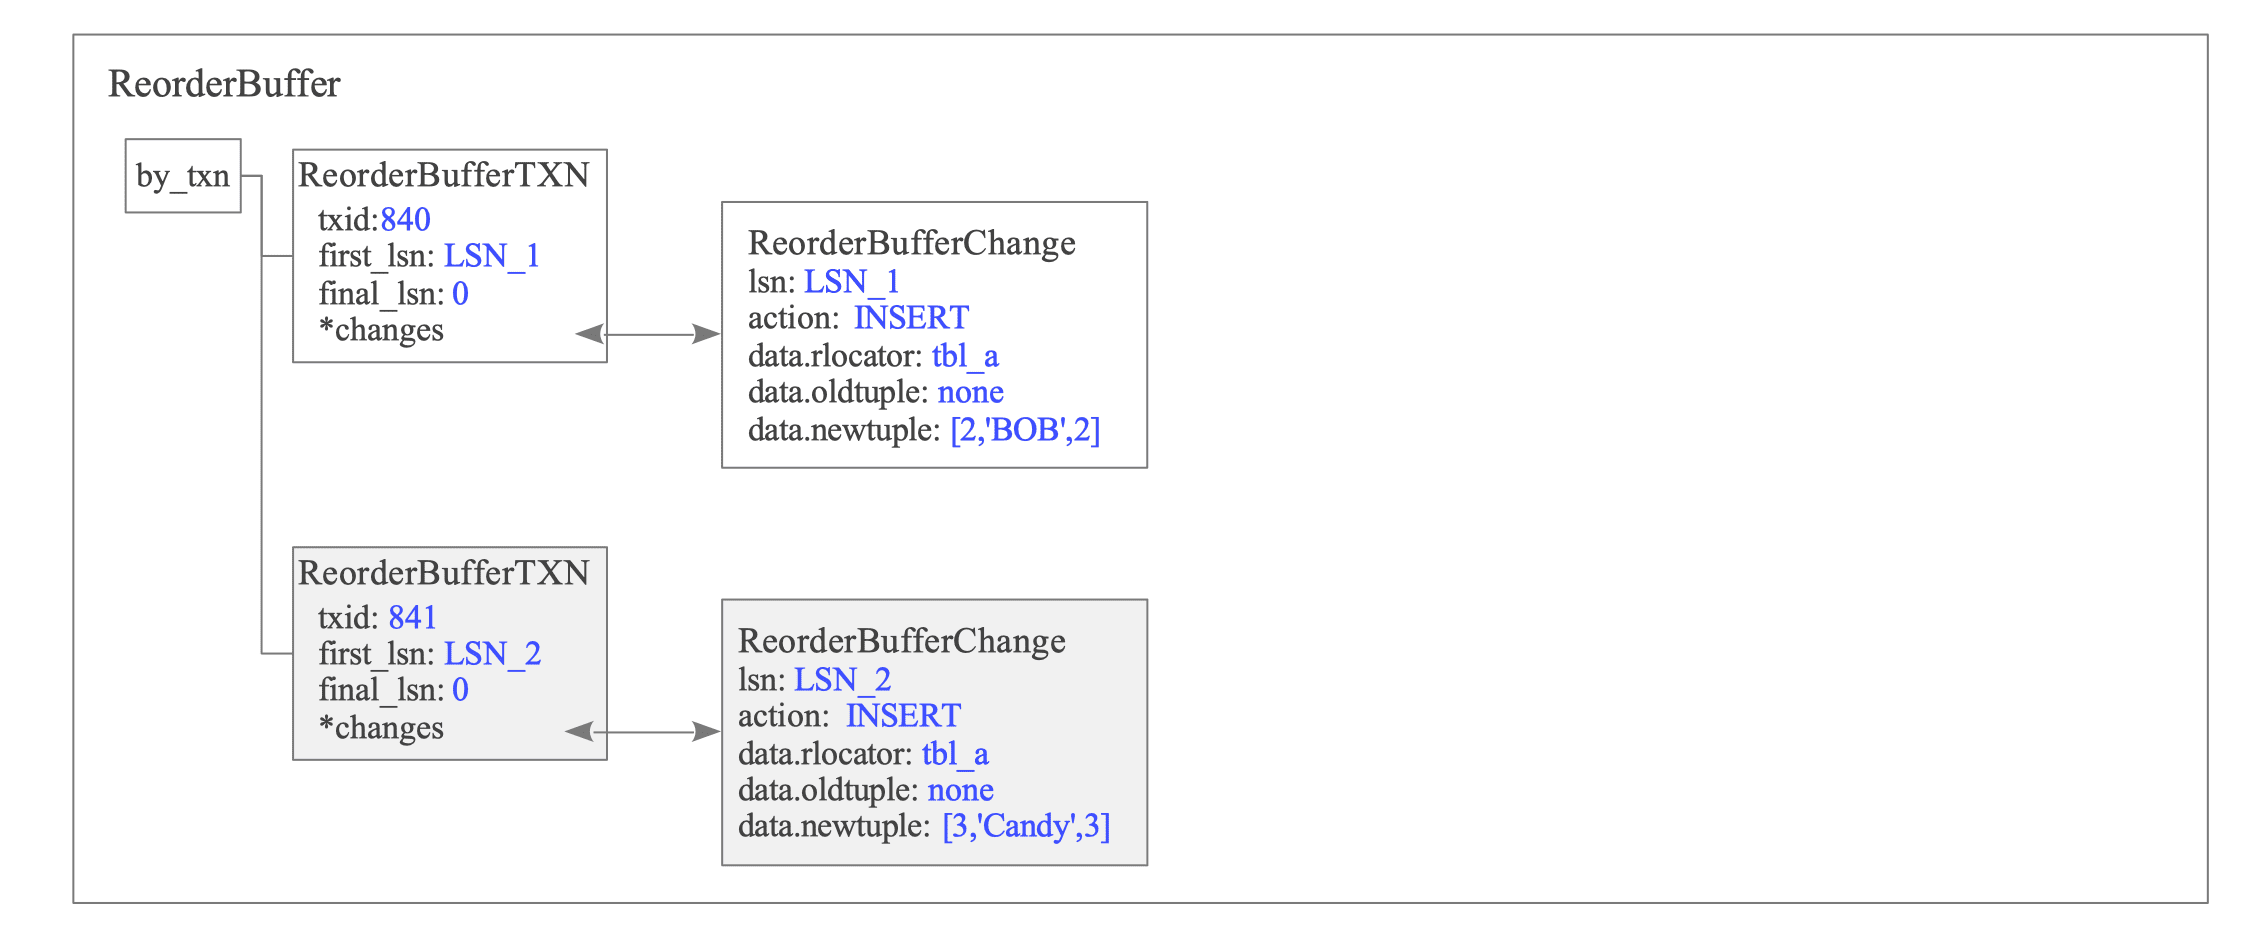
T3:txid=840向tbl_b插入
新的INSERT变更追加到txid=840自己的changes链表。
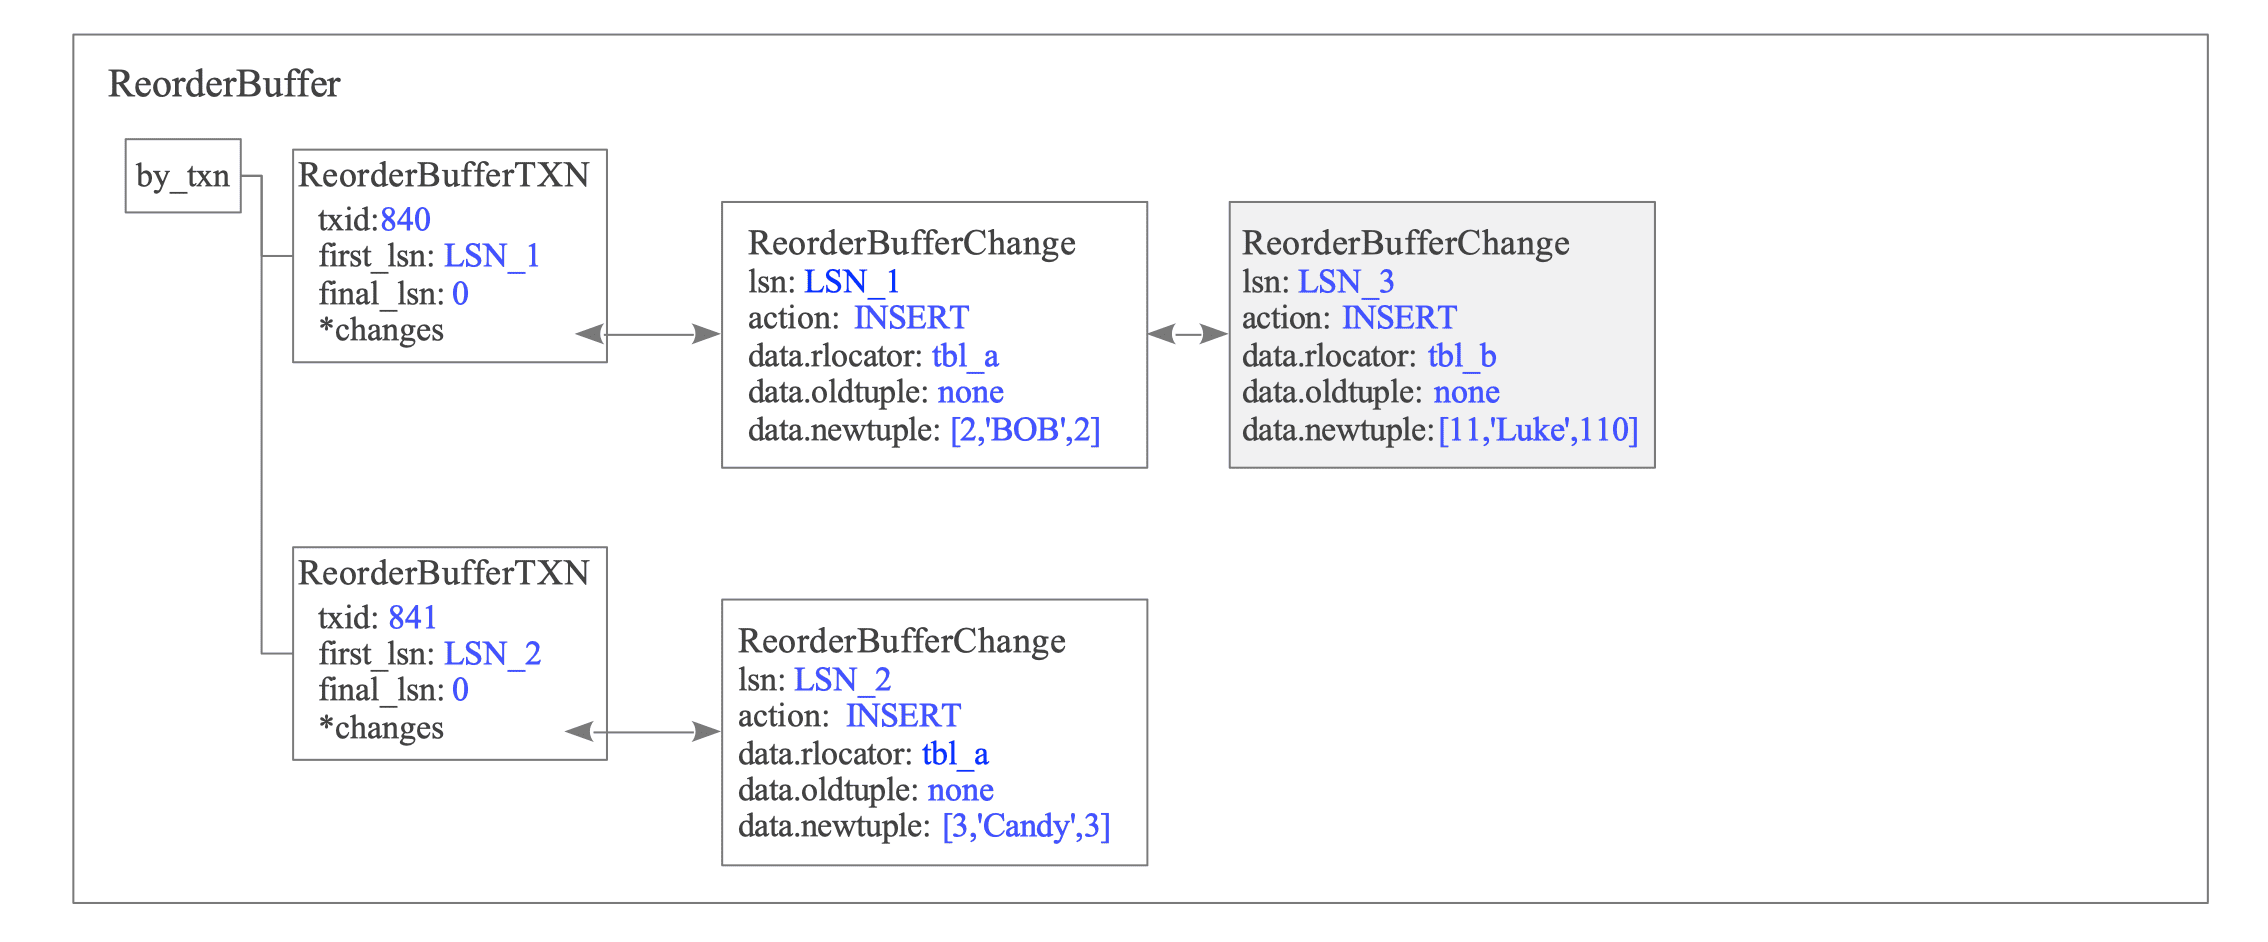
T4与T5:txid=841两次更新tbl_a
第一次与第二次UPDATE依次追加到txid=841的变更链表。
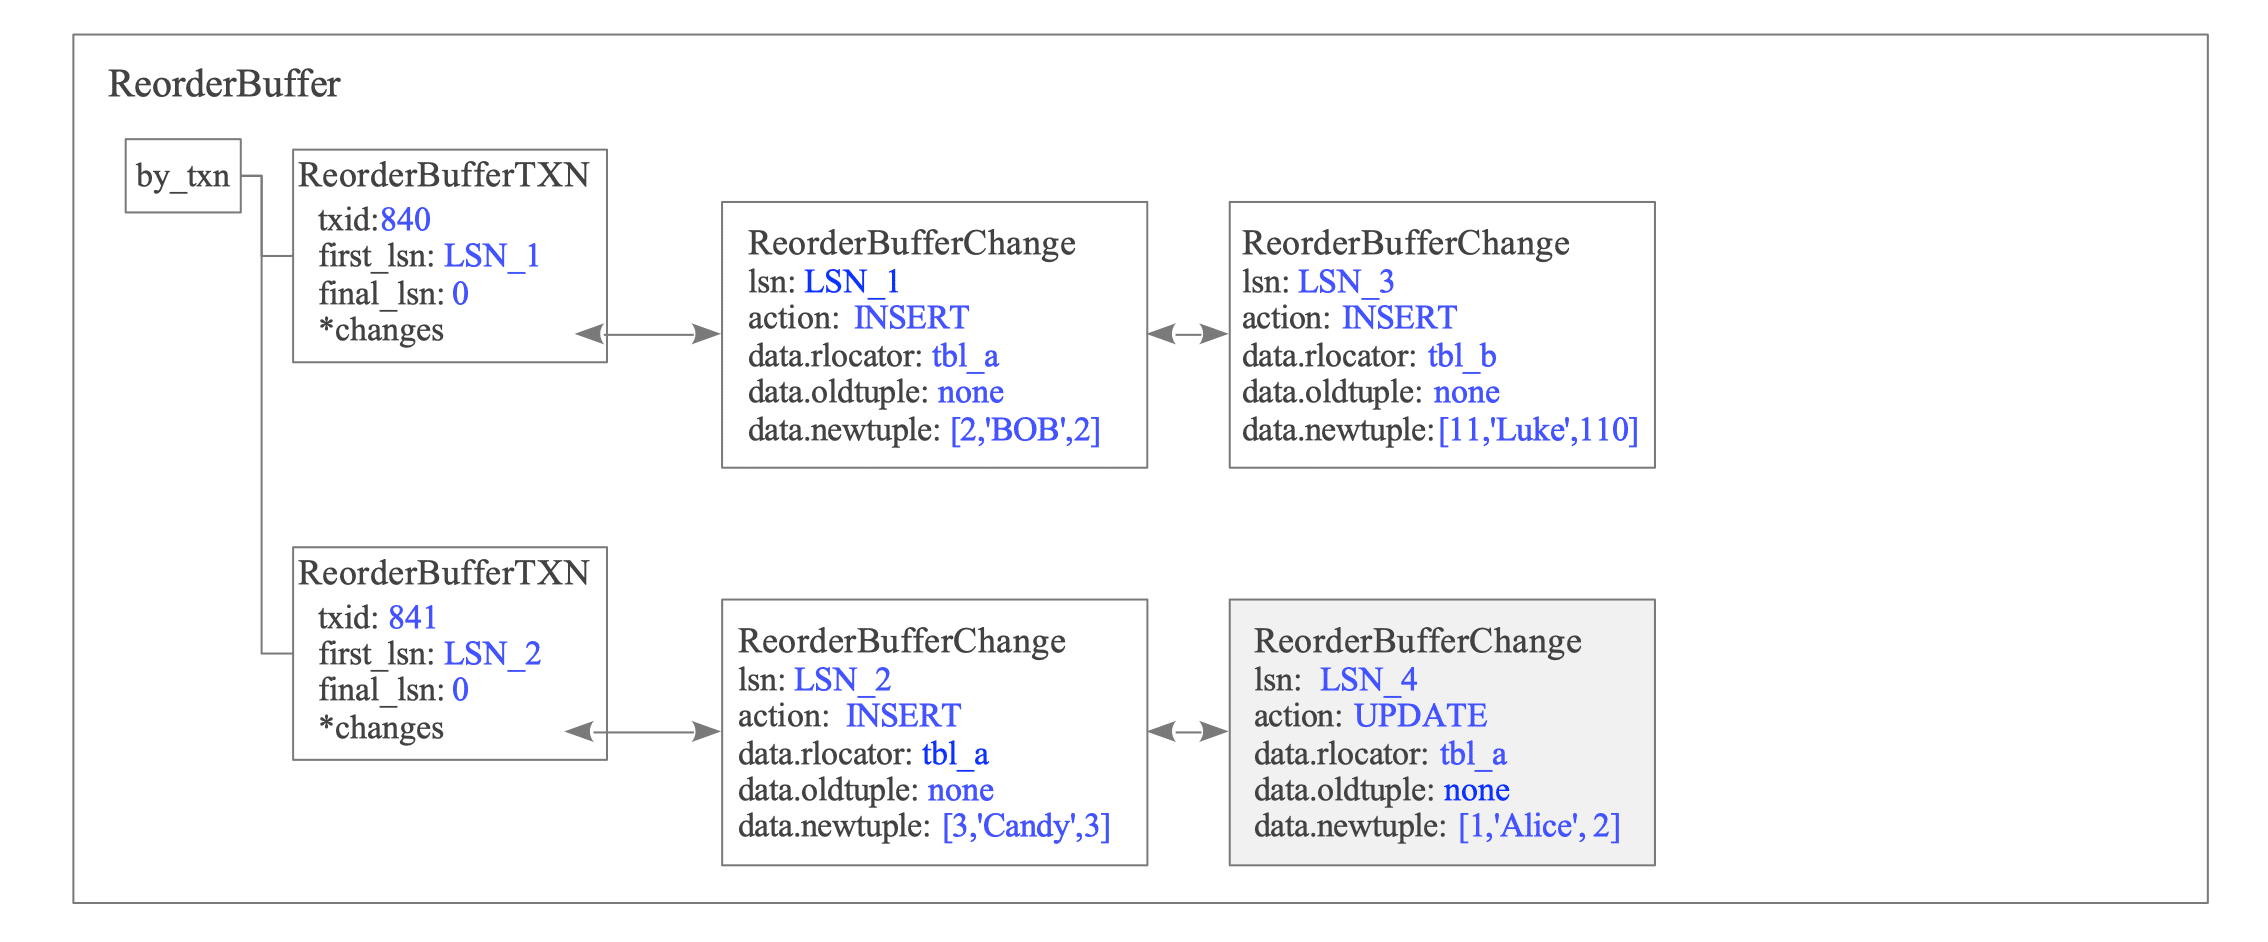
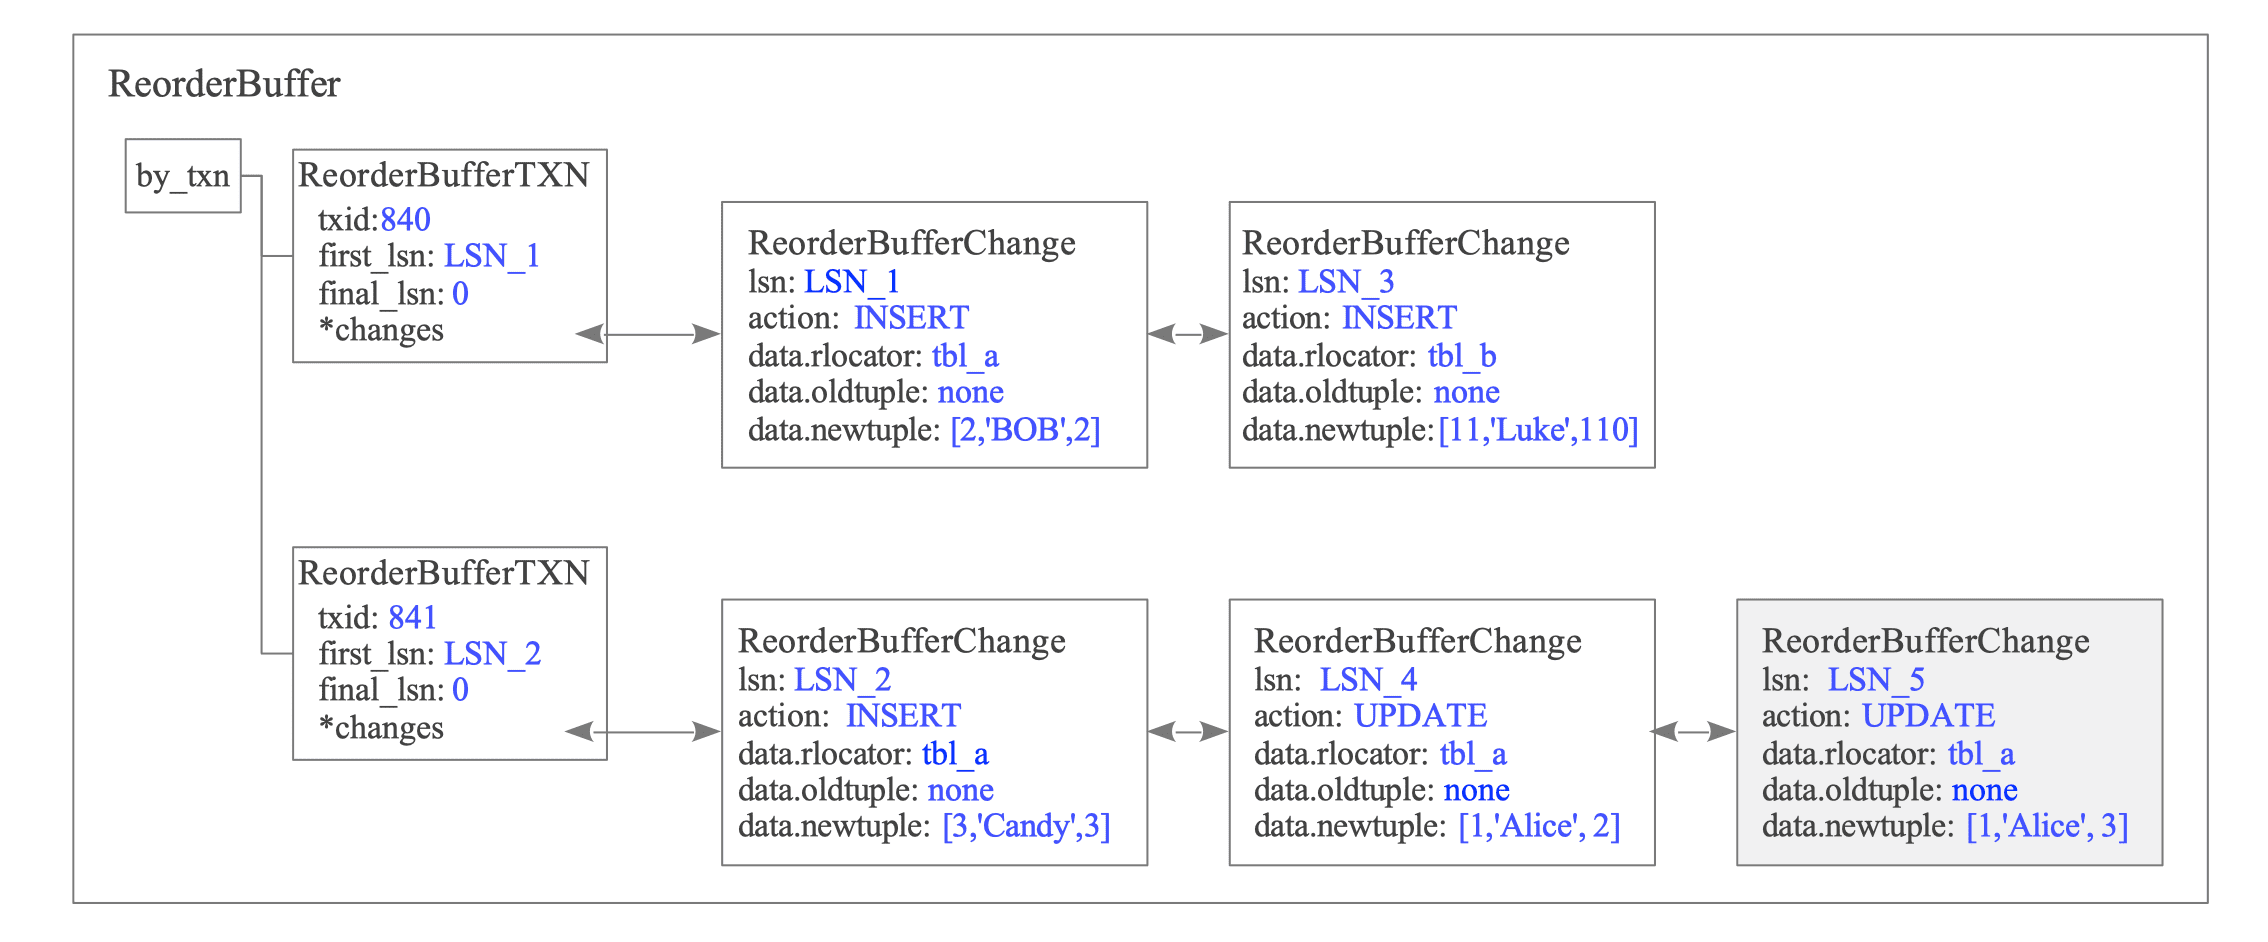
在REPLICA IDENTITY DEFAULT下,只有主键列被修改时才需要oldtuple。本例的主键id未变,订阅者可使用newtuple中的id=1找到目标元组,因此省略oldtuple。
T6:txid=840删除tbl_b中的行
DELETE记录追加到txid=840的链表,只保存作为副本标识的主键数据。
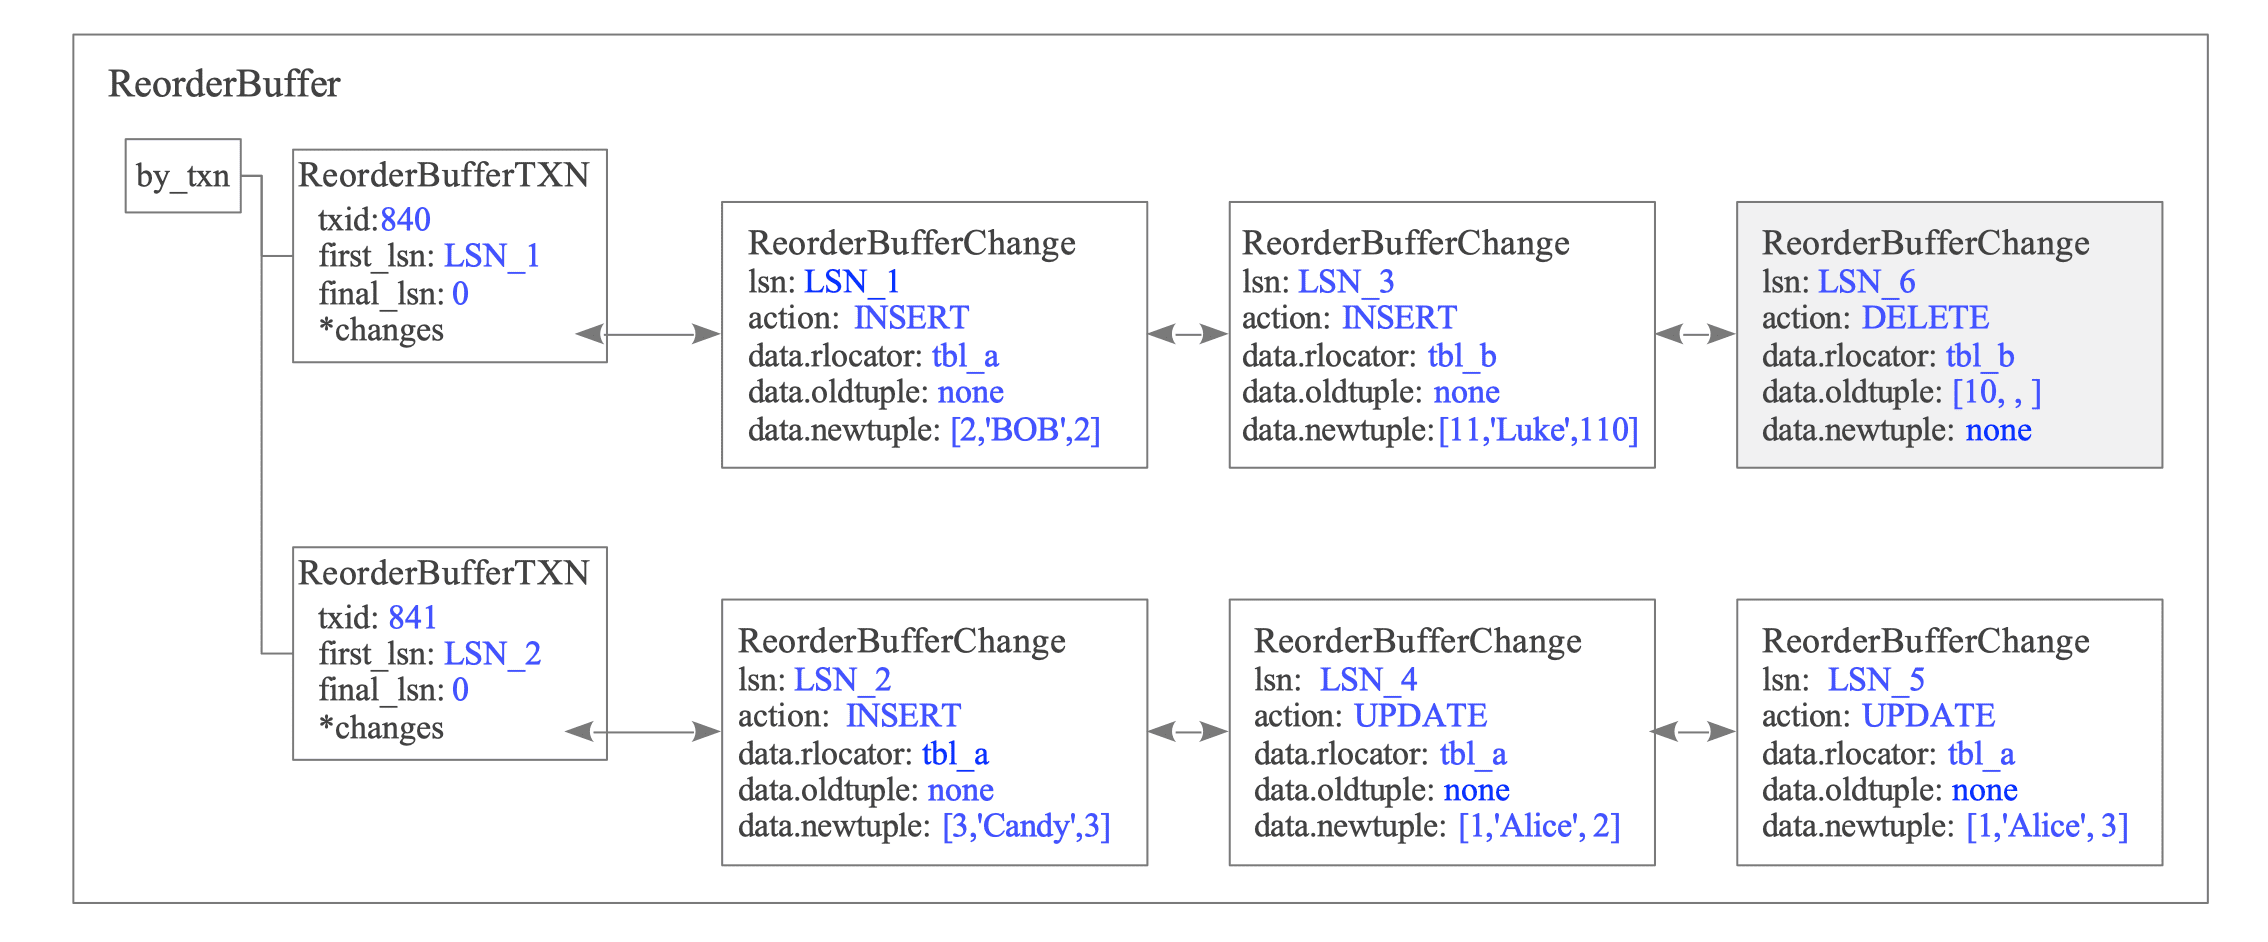
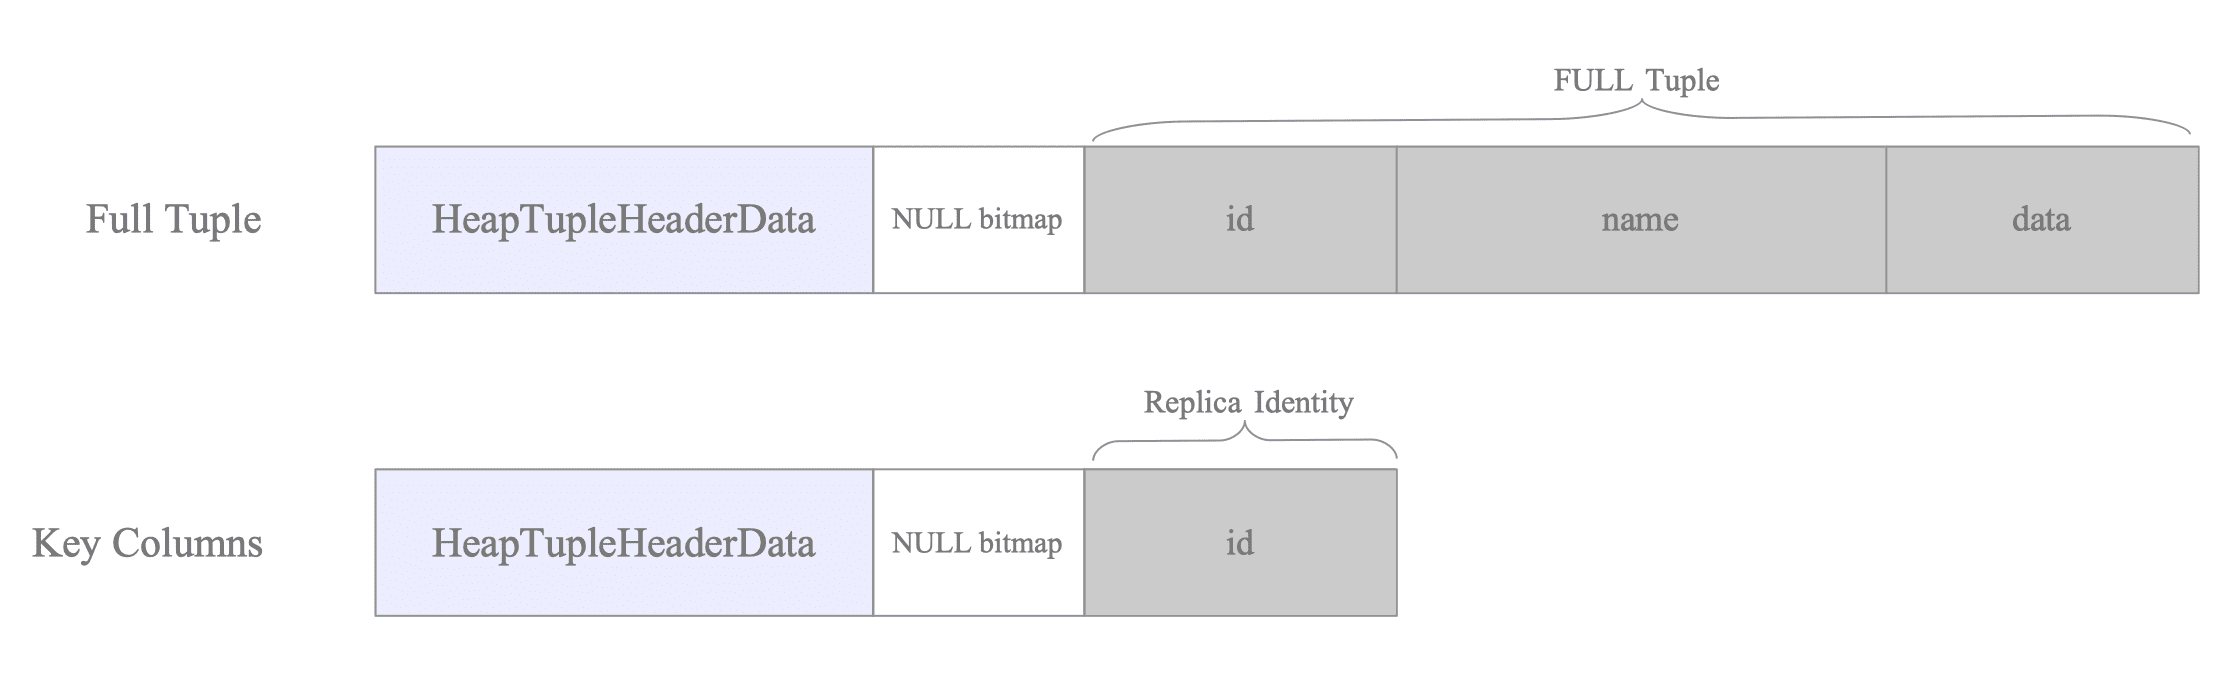
订阅者删除目标元组只需要键值;省略name、data等非键列既减少ReorderBuffer内存,也降低网络流量。
T7与T8:事务提交
txid=840提交时,ReorderBuffer从链表头开始遍历其变更。输出插件把每条变更编码为复制消息并发送;完成后移除该ReorderBufferTXN。
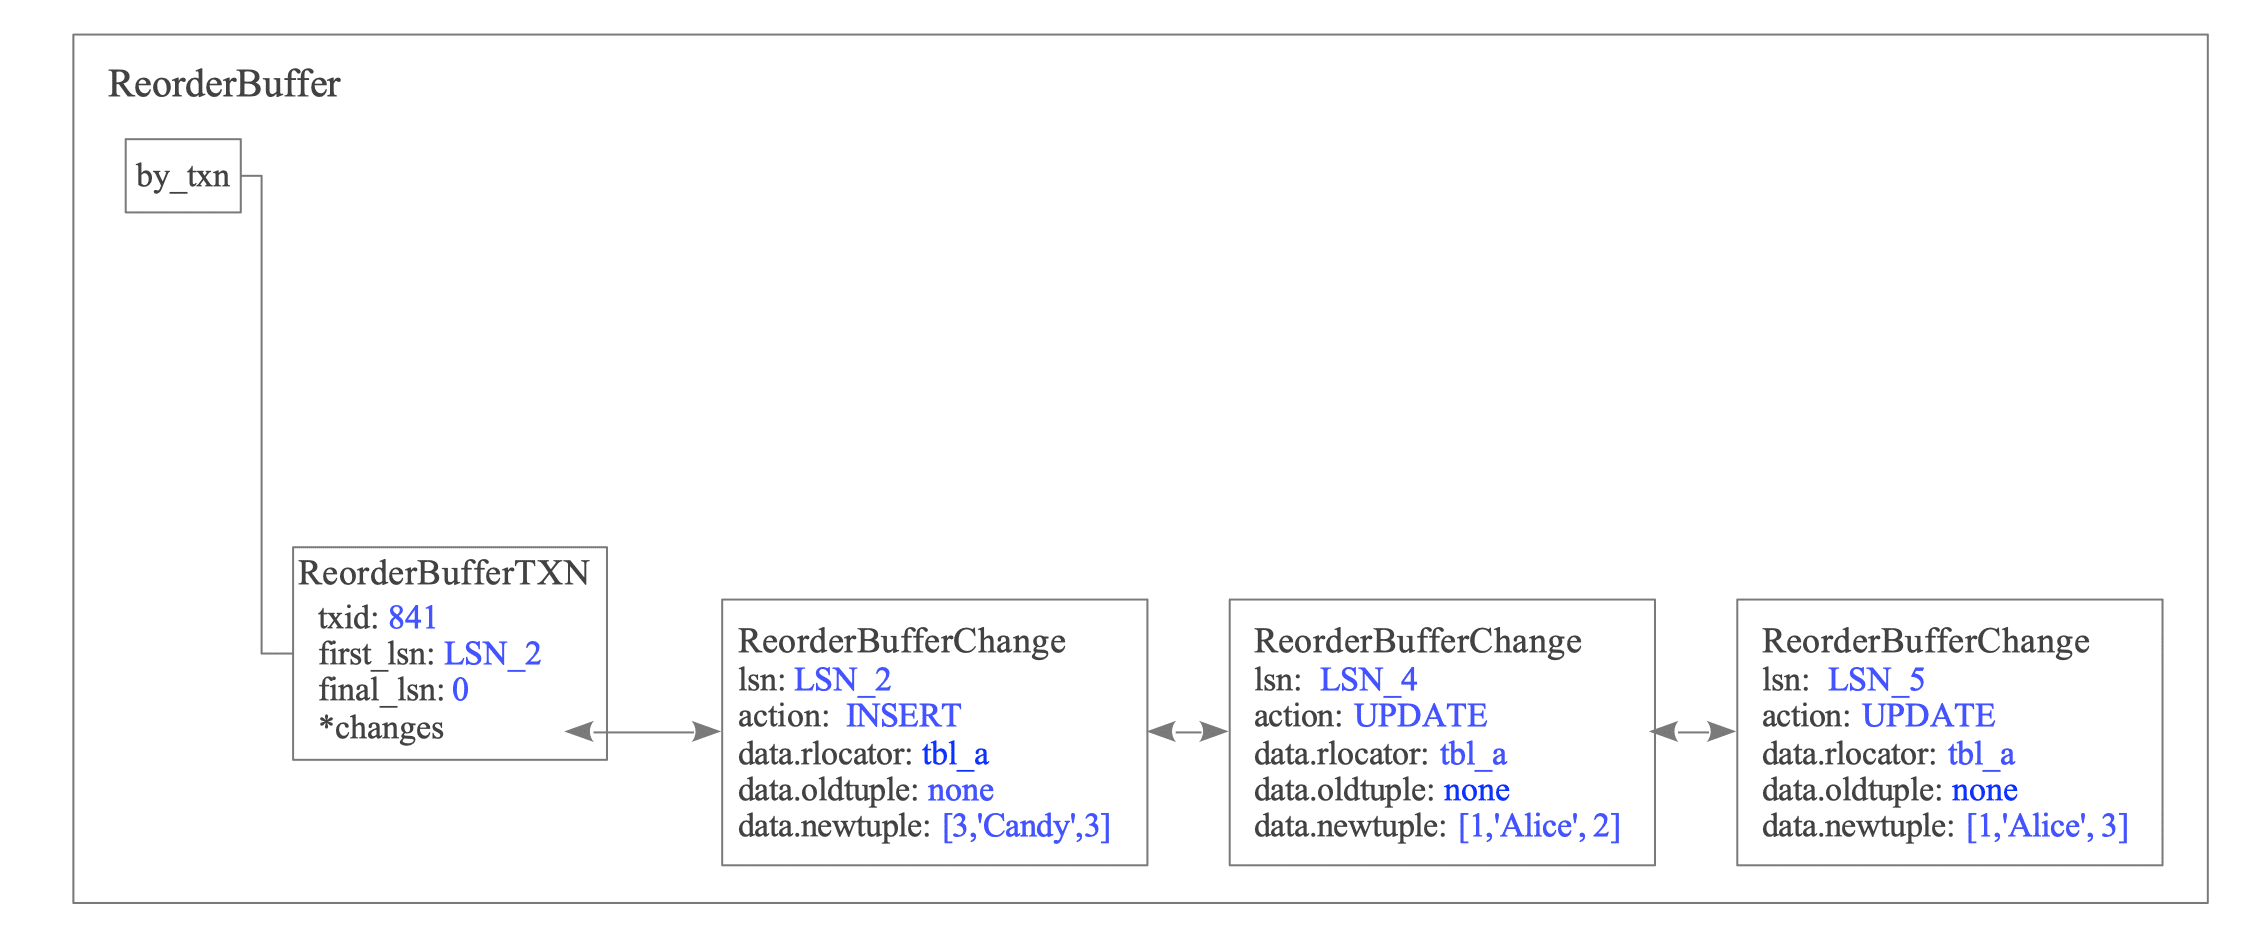
txid=841在T8提交时也按同样方式重组并发送。
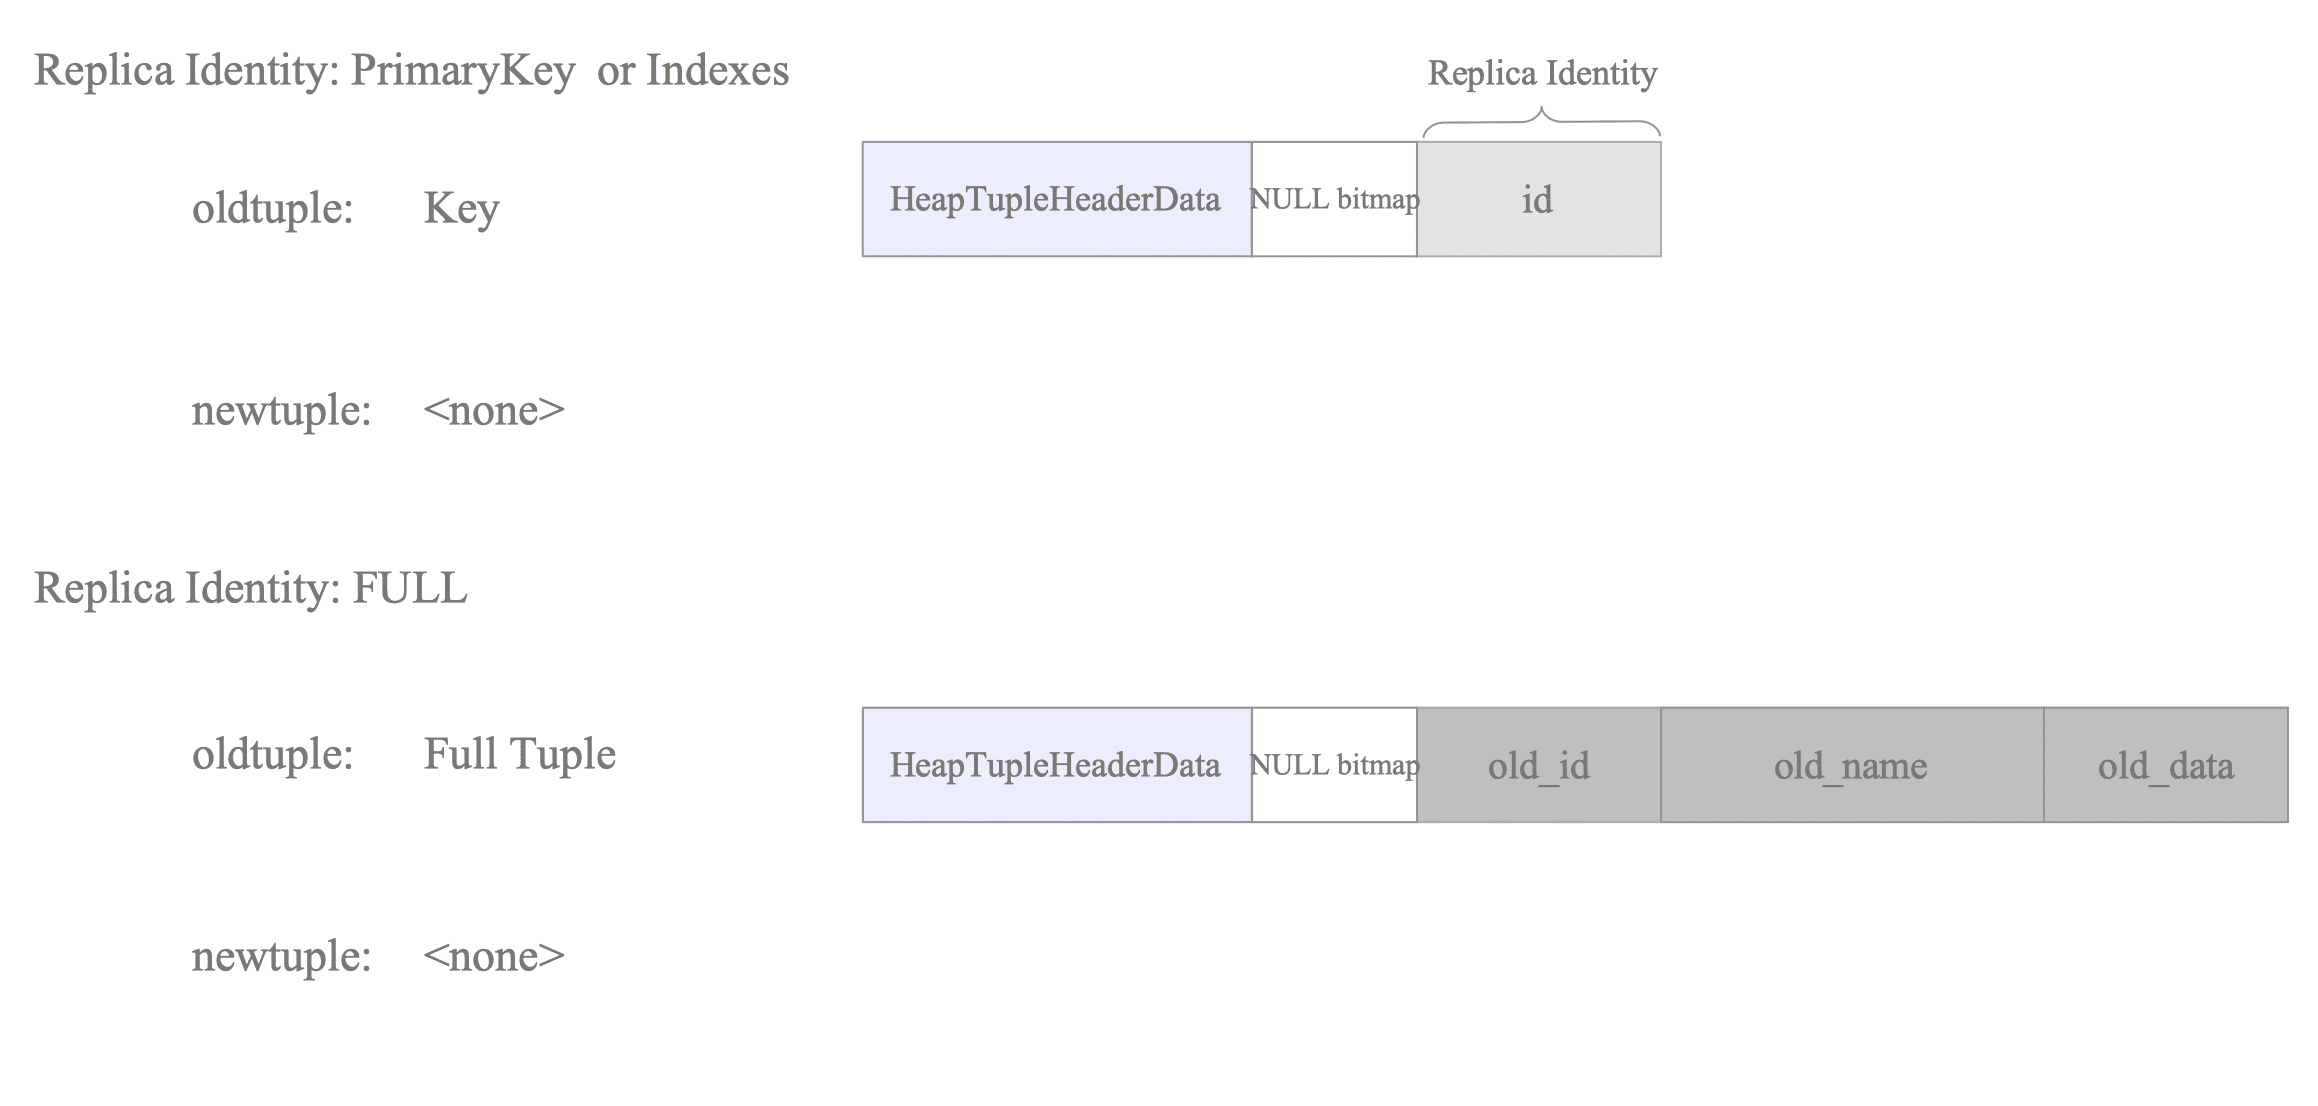
12.4.3 副本标识与解码元组
UPDATE和DELETE写入WAL的元组内容由目标表的副本标识决定。
12.4.3.1 UPDATE
当副本标识为主键或指定索引时:
| 更新类型 | oldtuple |
newtuple |
|---|---|---|
| 只更新非键列 | 无 | 完整新元组 |
| 更新键列 | 旧键值 | 完整新元组 |
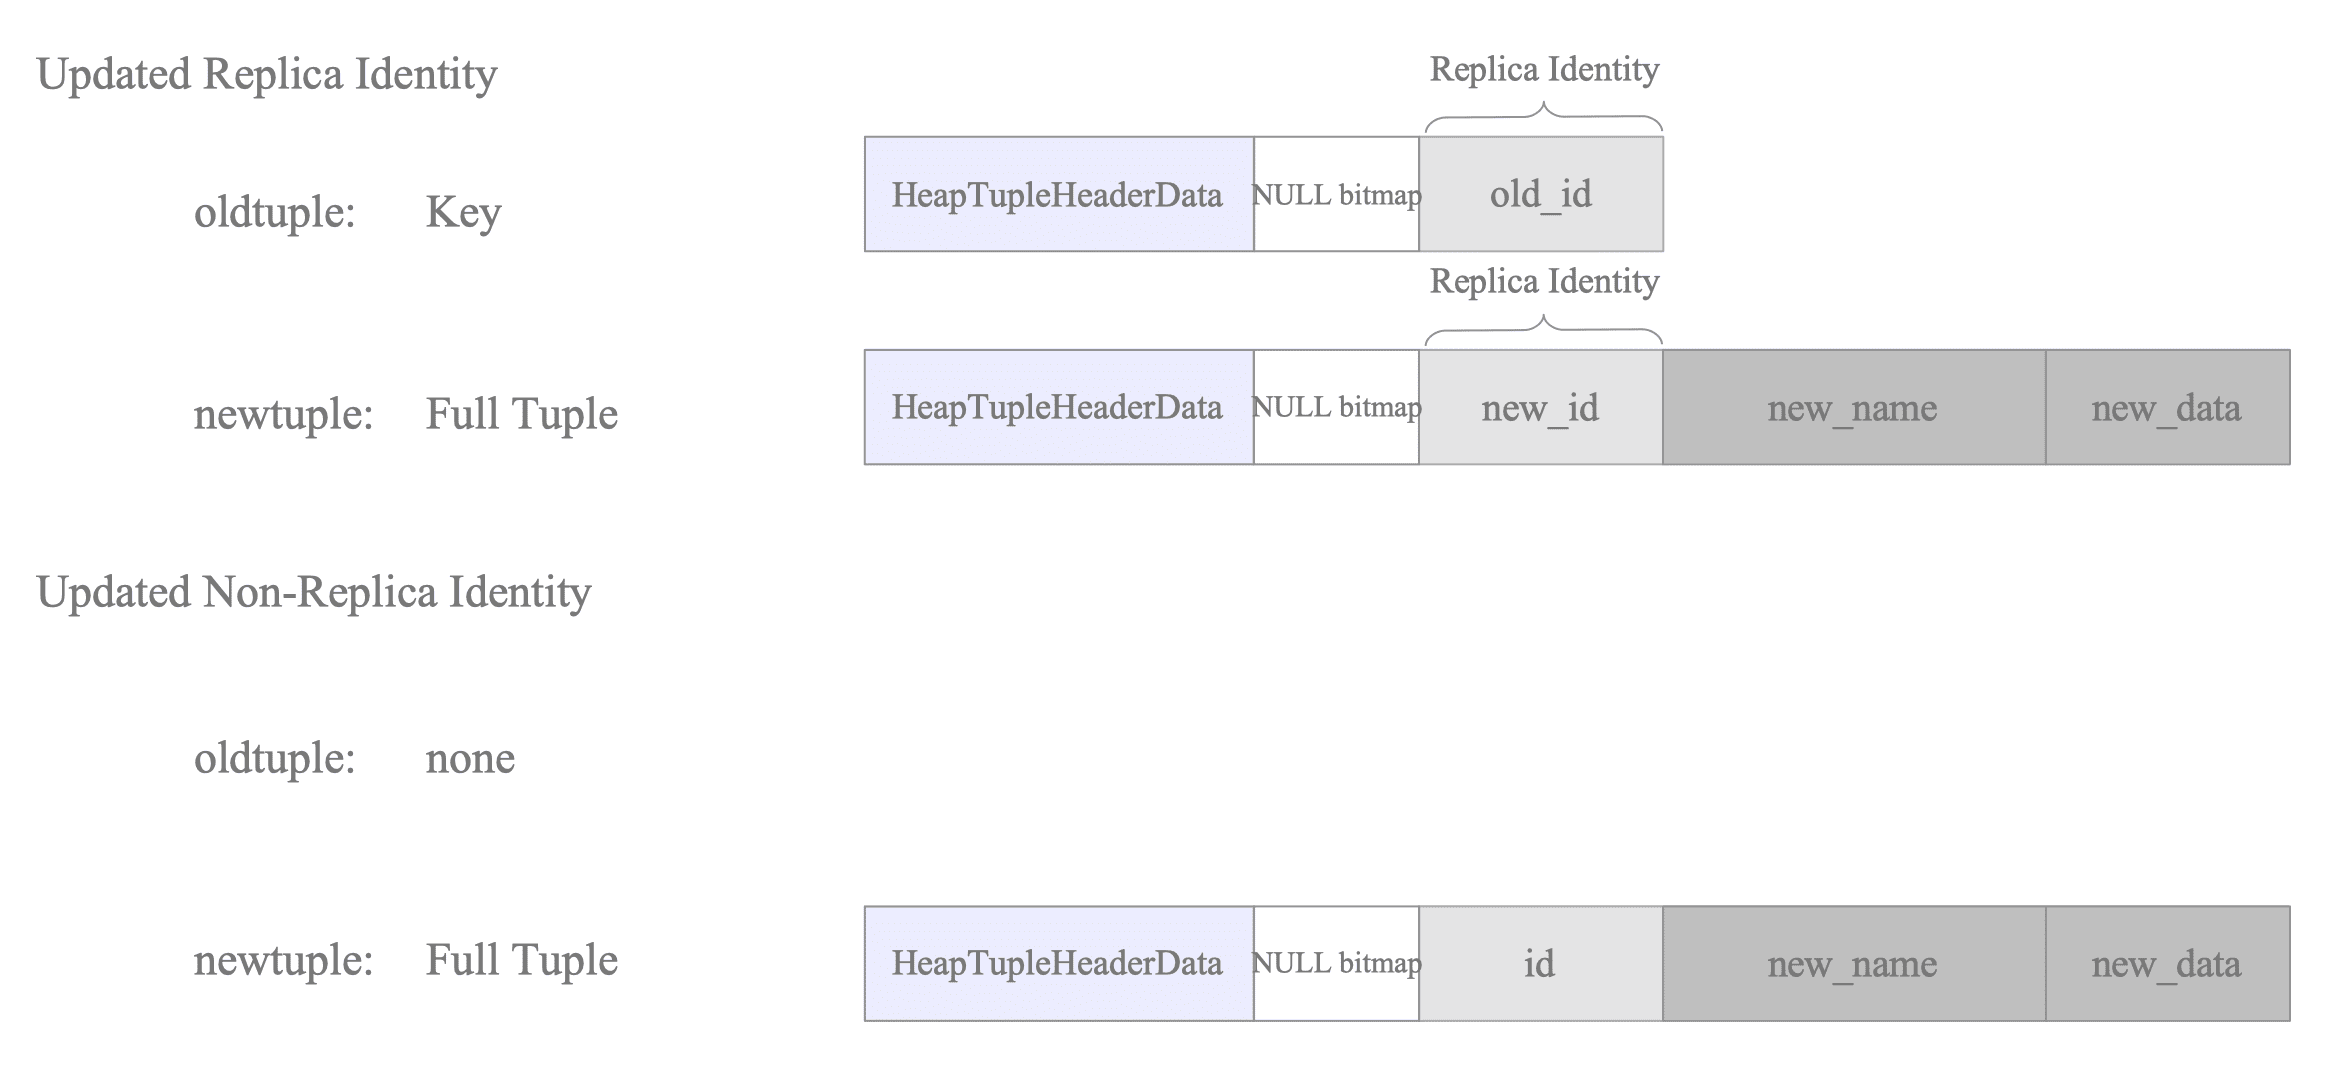
如果更新副本标识中的键列,订阅者需要用oldtuple中的旧键定位原行:
若只修改非键列,oldtuple为空,订阅者可使用newtuple中仍未改变的键:
apply worker并不会拼接或执行文本SQL;它复用执行器基础设施,但绕过解析与计划阶段,直接使用索引扫描或顺序扫描查找并修改目标元组。
REPLICA IDENTITY FULL则让oldtuple保存更新前的完整元组,newtuple保存更新后的完整元组:
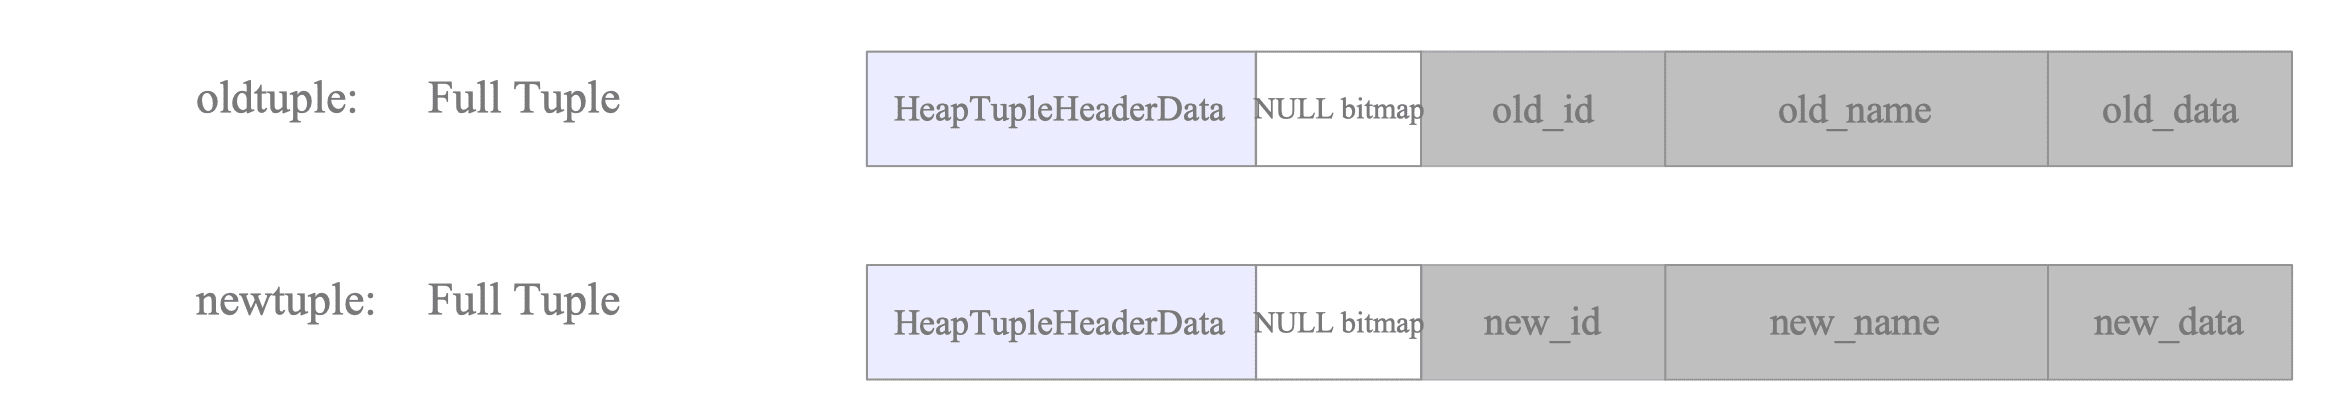
没有正式唯一键时,订阅者需要比较所有列来定位目标行:
12.4.3.2 DELETE
DELETE没有后续状态,因此只记录oldtuple:
| 副本标识 | oldtuple |
newtuple |
|---|---|---|
| 主键/索引 | 键列 | 无 |
FULL |
完整旧元组 | 无 |
12.4.4 ReorderBuffer内存管理与磁盘溢出
为了避免大事务耗尽内存,当全部缓冲事务的累计内存超过logical_decoding_work_mem时,ReorderBuffer会把部分变更溢出到磁盘(spill-to-disk)。
12.4.4.1 溢出算法
- 每加入一条
ReorderBufferChange,累计内存增加相应大小。 - 将当前用量与
logical_decoding_work_mem比较。 - 超出阈值时,找到当前积累变更最多的“最重”事务。
- 把该事务的全部已缓冲变更序列化到
$PGDATA/pg_replslot/<slot_name>中的.spill文件。 - 释放这些变更占用的内存,但保留
ReorderBufferTXN元数据。 - 把事务标为
serialized=true,提交解码时再从磁盘读回。
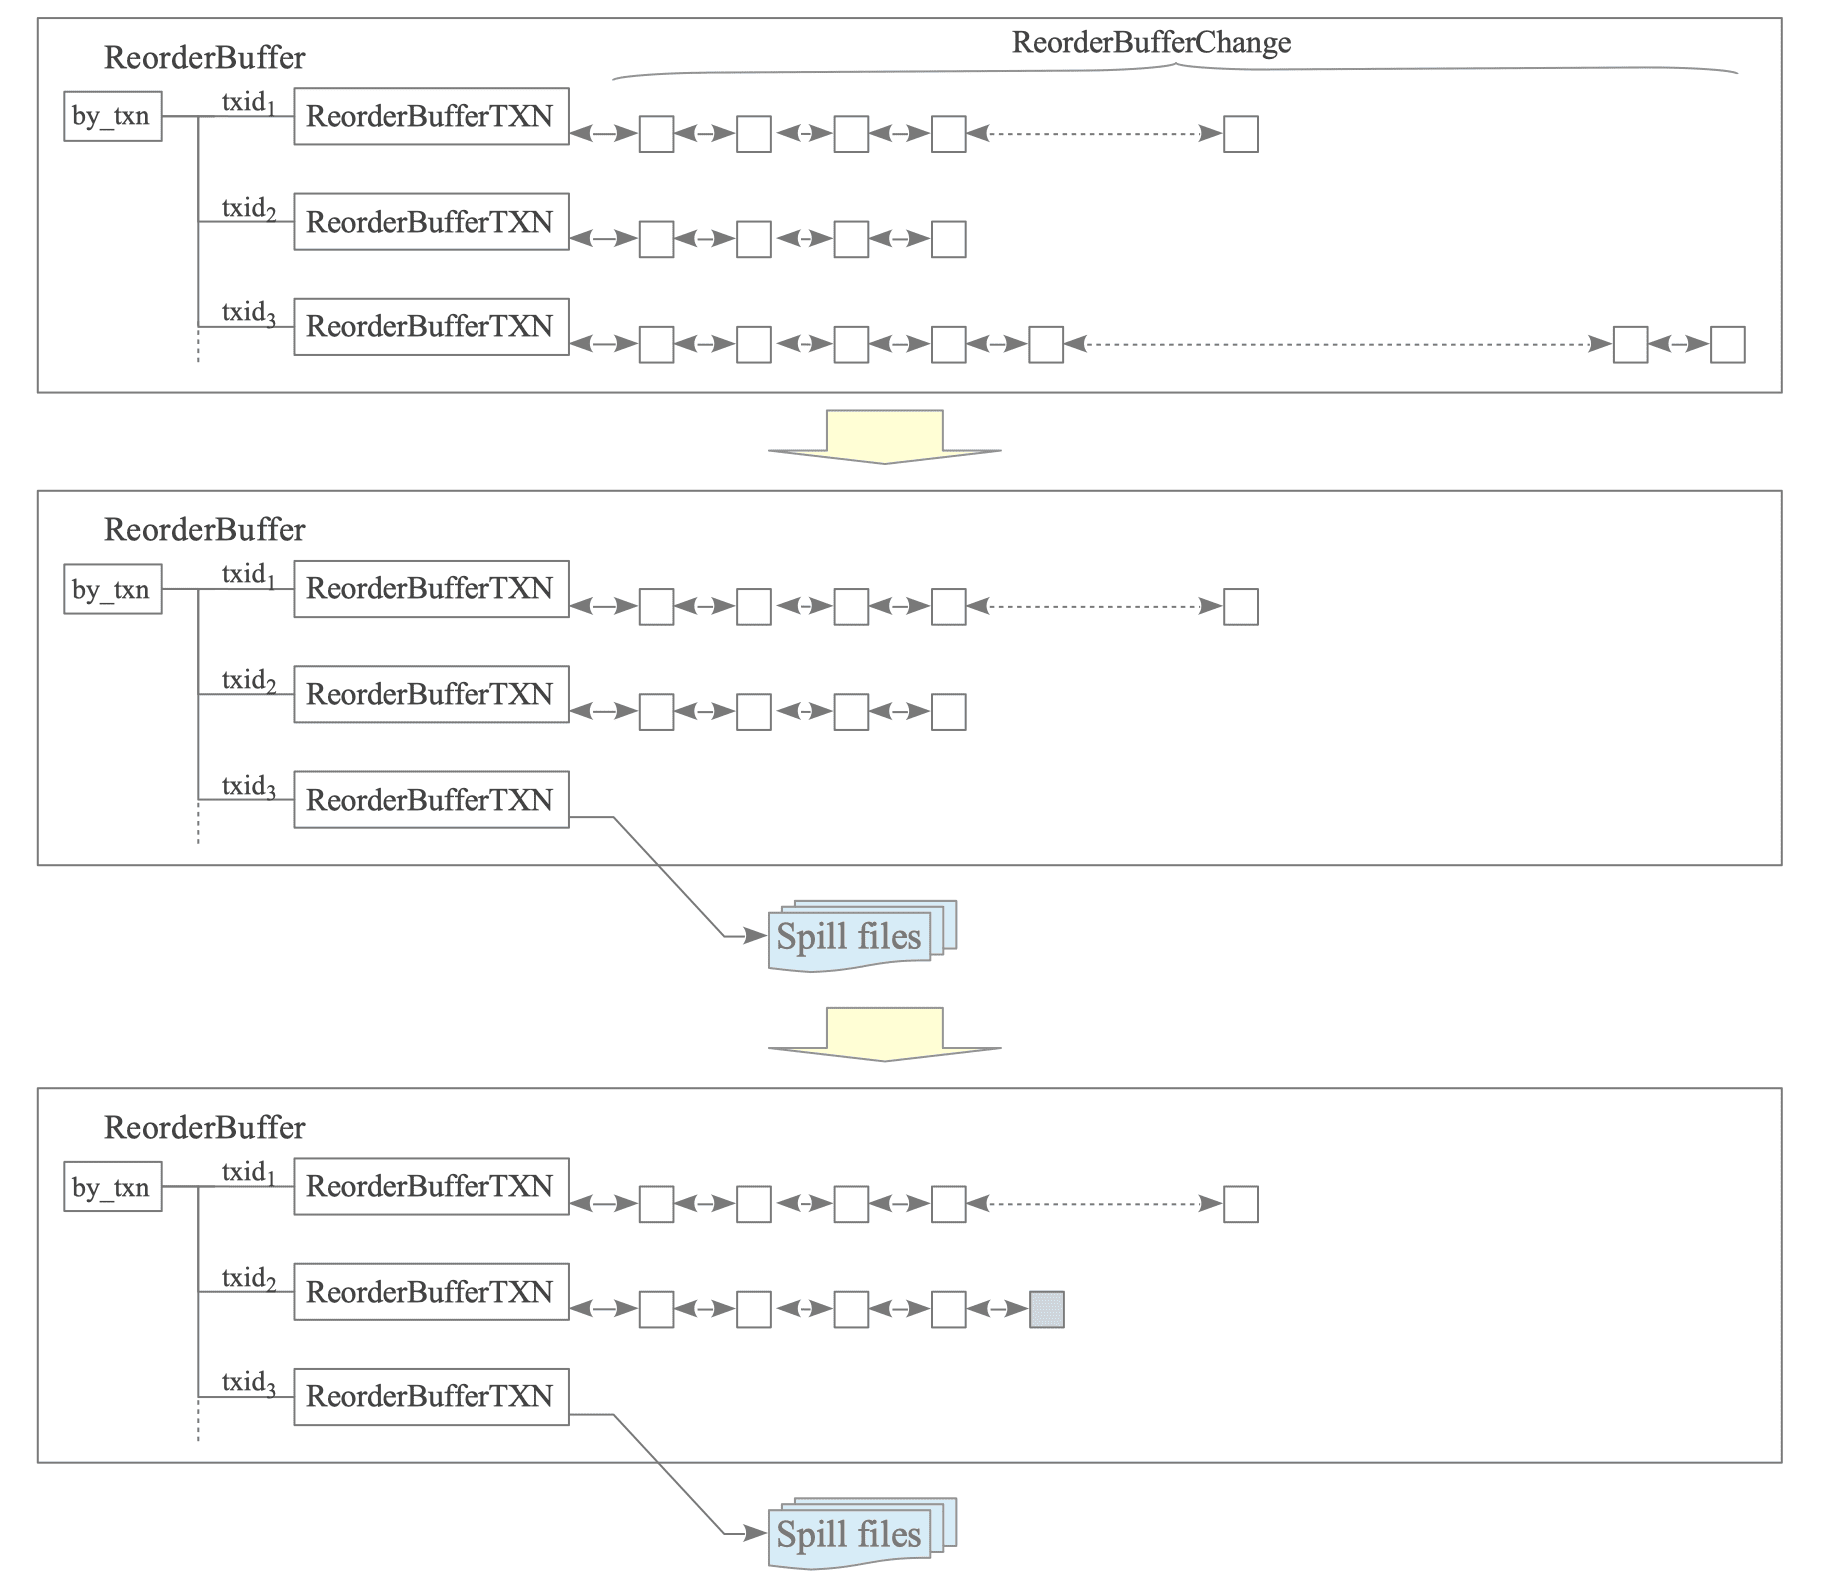
PostgreSQL只溢出最重事务,而不是同时刷新所有事务,以较少的磁盘I/O把内存维持在上限内。
12.4.4.2 溢出文件
溢出文件位于复制槽目录:
命名格式为xid-[XID]-lsn-[LSN_HIGH]-[LSN_LOW].spill:XID使用十进制;LSN高32位和低32位使用十六进制。
12.5 逻辑解码输出插件:pgoutput
输出插件把ReorderBuffer已经组织、排序好的变更数据序列化为订阅者能够理解的格式,主要完成两项工作:
- 最终过滤与转换: 再次根据发布配置检查目标表、操作类型、行过滤器和列列表,丢弃无关数据,并按协议要求编码为文本或二进制。
- 生成消息: 构造
BEGIN、DML、TRUNCATE、COMMIT等消息序列,交给walsender发送。
这一机制是可插拔的;自定义插件可以输出不同格式或实现特殊逻辑。标准PostgreSQL逻辑复制使用官方插件pgoutput。下文列出核心消息结构;完整的协议版本差异参见逻辑复制消息格式。
12.5.1 TupleData公共子消息
TupleData在DML消息中表示元组内容:
| 字段 | 类型 | 含义 |
|---|---|---|
num_cols |
Int16 |
元组列数。 |
kind |
Byte1 |
n=NULL;u=未改变的TOAST值;t=文本格式;b=二进制格式。 |
length |
Int32 |
t或b值的字节长度。 |
value |
Byte*n* |
实际列值。 |
12.5.2 事务控制
12.5.2.1 Begin(B)
标识事务开始,并携带最终LSN、提交时间与事务ID:
final_lsn通常是提交LSN;两阶段提交时则是prepare LSN。commit_timestamp是从PostgreSQL纪元(2000-01-01)开始计算的微秒时间戳。
12.5.2.2 Commit(C)
标识事务结束。订阅者收到后,把此前累积的变更作为一个原子单元在本地提交:
flags当前保留且为0;commit_lsn是提交记录LSN,end_lsn是事务末尾LSN。
12.5.3 DML消息
12.5.3.1 Origin(O)
多节点复制中用于说明事务最初产生的位置:
一个事务中可以出现多个Origin消息;origin_lsn是来源服务器上的提交LSN。
12.5.3.2 Relation(R)
提供表的元数据,通常在会话中第一次发送某表的DML消息前发送,把关系OID映射到模式、表名和列定义:
replica_identity对应pg_class.relreplident的d、n、f、i;列flags=1表示该列属于副本标识键。
12.5.3.3 Insert(I)
N表示随后是新元组,rel_id对应此前Relation消息中的关系OID。
12.5.3.4 Update(U)
消息形态取决于副本标识以及键列是否改变:
K表示随后是旧键,O表示完整旧元组,两者互斥;N始终标记新元组。
12.5.3.5 Delete(D)
订阅者使用给出的旧键或完整旧元组定位并删除记录。
12.5.3.6 Truncate(T)
表示批量清空一张或多张表:
options的位0表示CASCADE,位1表示RESTART IDENTITY;后续重复num_relations个关系OID。
12.5.4 流控制消息
发布者为支持大事务流式传输而分段发送数据时,使用以下消息。
12.5.4.1 Stream Start(S)
标识一个流片段开始;first_segment=1表示这是该XID的首段。
12.5.4.2 Stream Stop(E)
标识当前流片段结束。
12.5.4.3 Stream Commit(c)
标识流式事务提交,字段与普通Commit消息类似,但额外显式携带txid。
12.5.4.4 Stream Abort(A)
标识流式事务或子事务中止。subxid在顶层事务中等于txid;abort_lsn与abort_timestamp只在支持并行流式应用的协议v4及以后出现。
12.6 事务重组与消息发送
本节说明ReorderBuffer如何重组累积的变更,并通过输出插件发送给订阅者apply worker。
12.6.1 事务重组概要
walsender在WAL中发现COMMIT记录后,ReorderBuffer开始重组事务:
- 找到已提交事务的
ReorderBufferTXN。 - 如果存在子事务,把子事务变更链表合并到顶层事务。
- 按LSN排序最终变更列表,保证时间顺序。
- 检查提交或中止记录中的复制来源;存在时把来源信息加入复制消息。
- 依次遍历变更并交给
pgoutput等输出插件。 - 释放
ReorderBufferTXN与所有ReorderBufferChange对象。
不含子事务时,单个事务链表天然按LSN排序,只需正向遍历。若事务中止,ReorderBuffer会立即丢弃该事务及全部变更,不交给输出插件。
12.6.1.1 示例
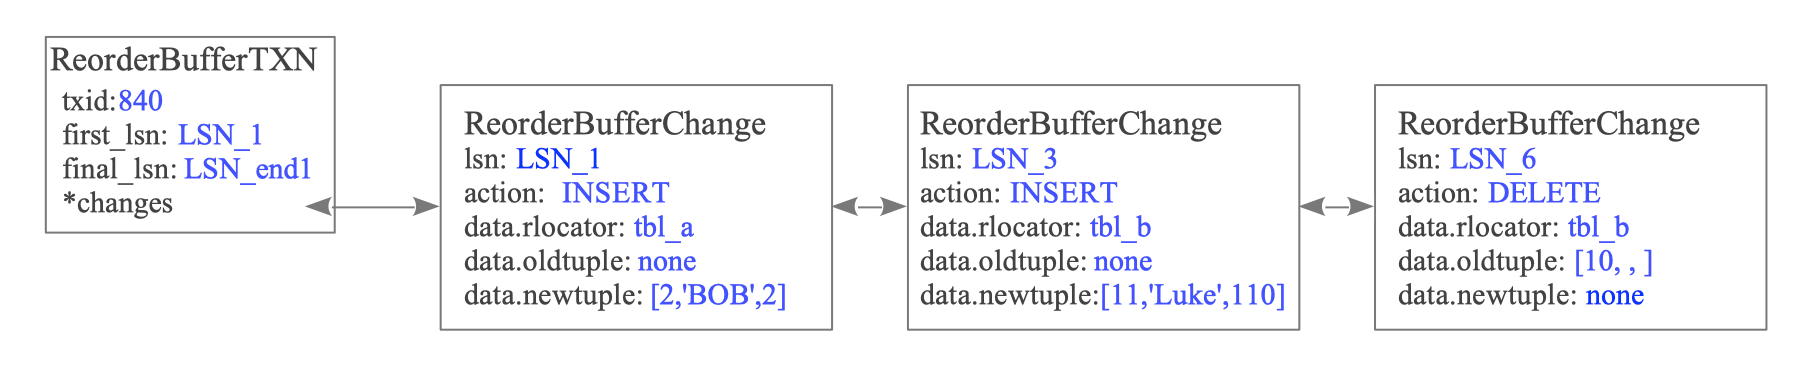
txid=840经pgoutput生成的消息序列为:
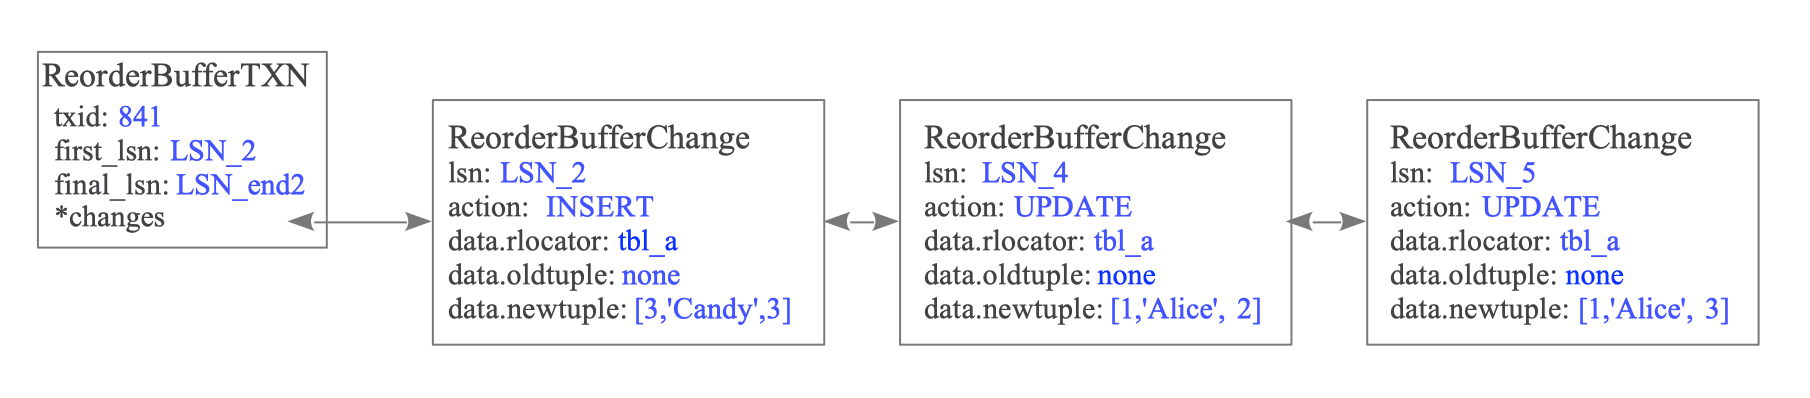
txid=841的消息序列为:
Relation(R)消息只在当前walsender会话尚未发送过该表元数据,或表定义发生变化时发送,以避免重复传输。
12.6.2 发送消息
输出插件完成序列化后,消息会封装进逻辑复制协议并经网络发送。
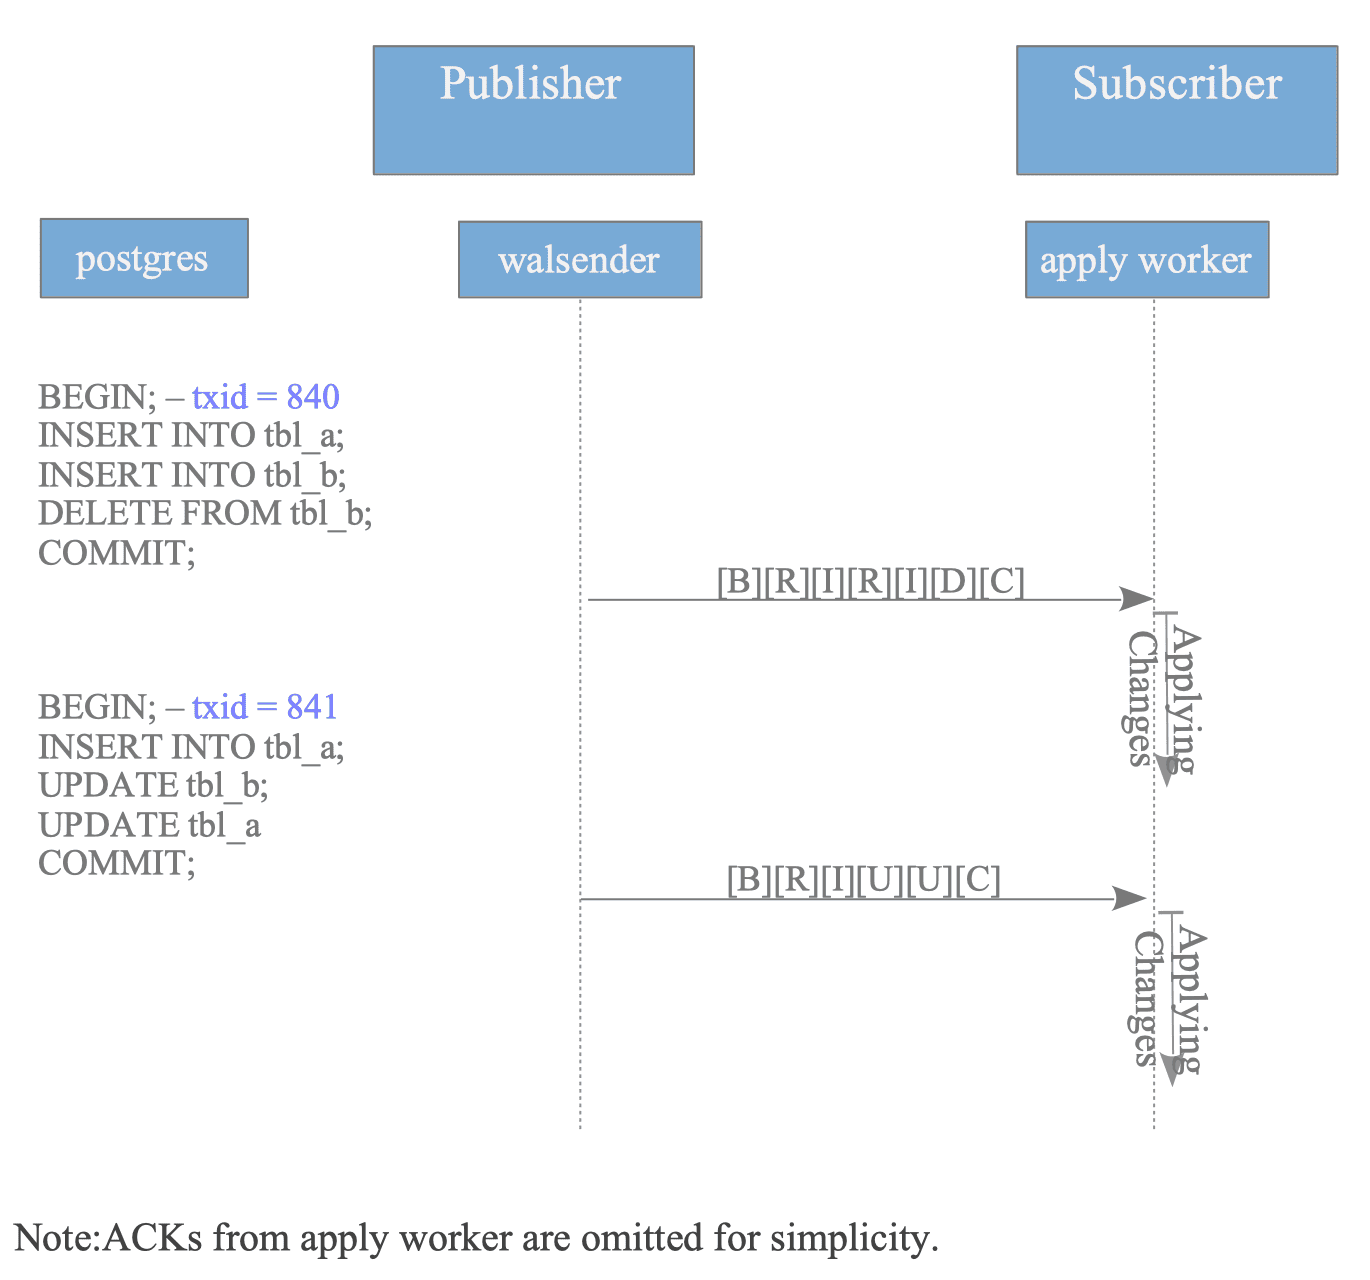
普通事务只有在发布者提交后,apply worker才会收到从Begin到Commit的完整连续序列。
pgoutput消息是二进制格式,不能直接作为文本查看。调试时可以把pg_recvlogical输出交给od:
若希望查看可读输出,可以使用test_decoding插件:
12.6.3 大事务流式传输
当streaming为on或parallel且ReorderBuffer达到内存上限时,PostgreSQL不再把变更写入发布端本地spill文件,而是立即发送给订阅端apply worker或leader apply worker。
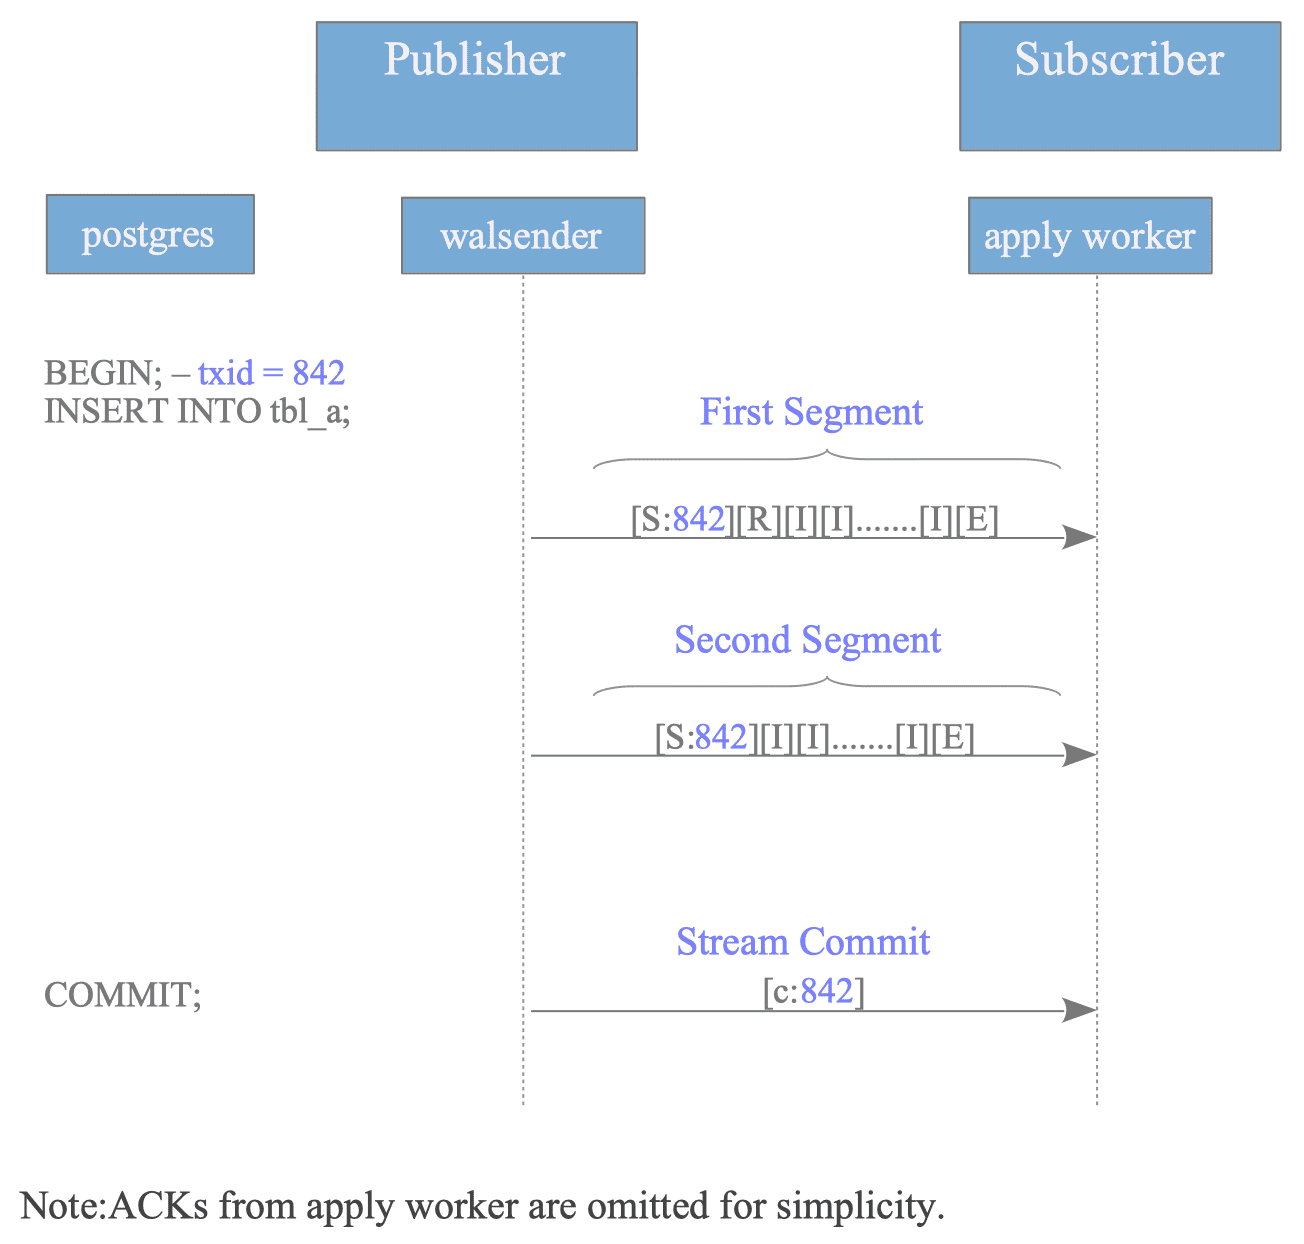
假设溢出时txid=842占用内存最多,发布者先重排它的变更,再用Stream Start(S)与Stream Stop(E)包住形成一个片段。首段的S取代普通事务的Begin消息。
12.6.3.1 第一段
后续再次达到阈值时继续发送新片段,first_segment改为0。
12.6.3.2 第二段
12.6.3.3 流式提交
发布者最终提交txid=842时发送Stream Commit:
若事务中止,则发送Stream Abort(A),通知订阅端丢弃此前收到的全部片段。
12.7 Apply Worker与事务重放
apply worker负责把发布者发送的逻辑变更重放到订阅者本地表。本节先介绍普通模式,再说明大事务流式处理与并行apply worker。
12.7.1 普通模式(streaming=off)
订阅端apply worker执行以下主要工作:
- 来源过滤: 检查消息来源,决定应用还是跳过,防止复制环。
- LSN跳过检查(幂等性): 把事务LSN与
pg_replication_origin_status中持久化的remote_lsn比较;已经应用过的事务直接跳过。 - 分派: 按消息类型交给
INSERT、UPDATE、DELETE等处理器。 - 冲突检测: 检测更新目标行不存在、唯一约束冲突等问题。会产生错误的冲突将停止复制;
update_missing、delete_missing等缺行冲突则记录后跳过相应操作。
12.7.1.1 来源过滤与LSN跟踪
是否应用事务取决于订阅参数origin及消息中的origin_id。当前实现中,如果配置origin='none'且origin_id>0,apply worker跳过重放;否则继续。
12.7.1.2 消息分派与重放
假设发布者向tbl_a插入一行,消息流为:
处理流程如下:
- Begin: 开启本地事务,记录发布者提交LSN和时间戳,并把
session_replication_role设为replica,使本地触发器和约束按其复制角色运行。 - Relation: 接收表定义,更新
RelationSyncCache,依据模式名与表名把发布端OID映射到本地表OID。 - Insert: 把二进制元组转为本地表格式,调用内部插入逻辑直接写表并更新索引;该操作也会在订阅者生成自己的WAL。
- Commit: 提交本地事务,把对应发布者的
origin_id附加到提交WAL;更新复制来源的已应用LSN,并向walsender返回已刷盘ACK。
订阅端提交WAL会附带发布者元数据:origin_id、作为origin_lsn的final_lsn,以及作为origin_timestamp的提交时间。UPDATE与DELETE还需要使用索引或顺序扫描直接查找目标元组。
12.7.1.3 REPLICA IDENTITY FULL优化
PostgreSQL 15及以前,REPLICA IDENTITY FULL表在应用UPDATE或DELETE时必须顺序扫描定位目标元组,大表开销很高。PostgreSQL 16起,apply worker可以使用现有的合适索引;FindLogicalRepLocalIndex()会寻找能够定位行的非部分B-tree索引,显著减少顺序扫描。
12.7.2 流式模式(streaming=on)
此模式下,apply worker在最终提交前就会分段收到尚在进行中的事务。假设txid=842是分两段发送的大事务,而txid=843是普通小事务:
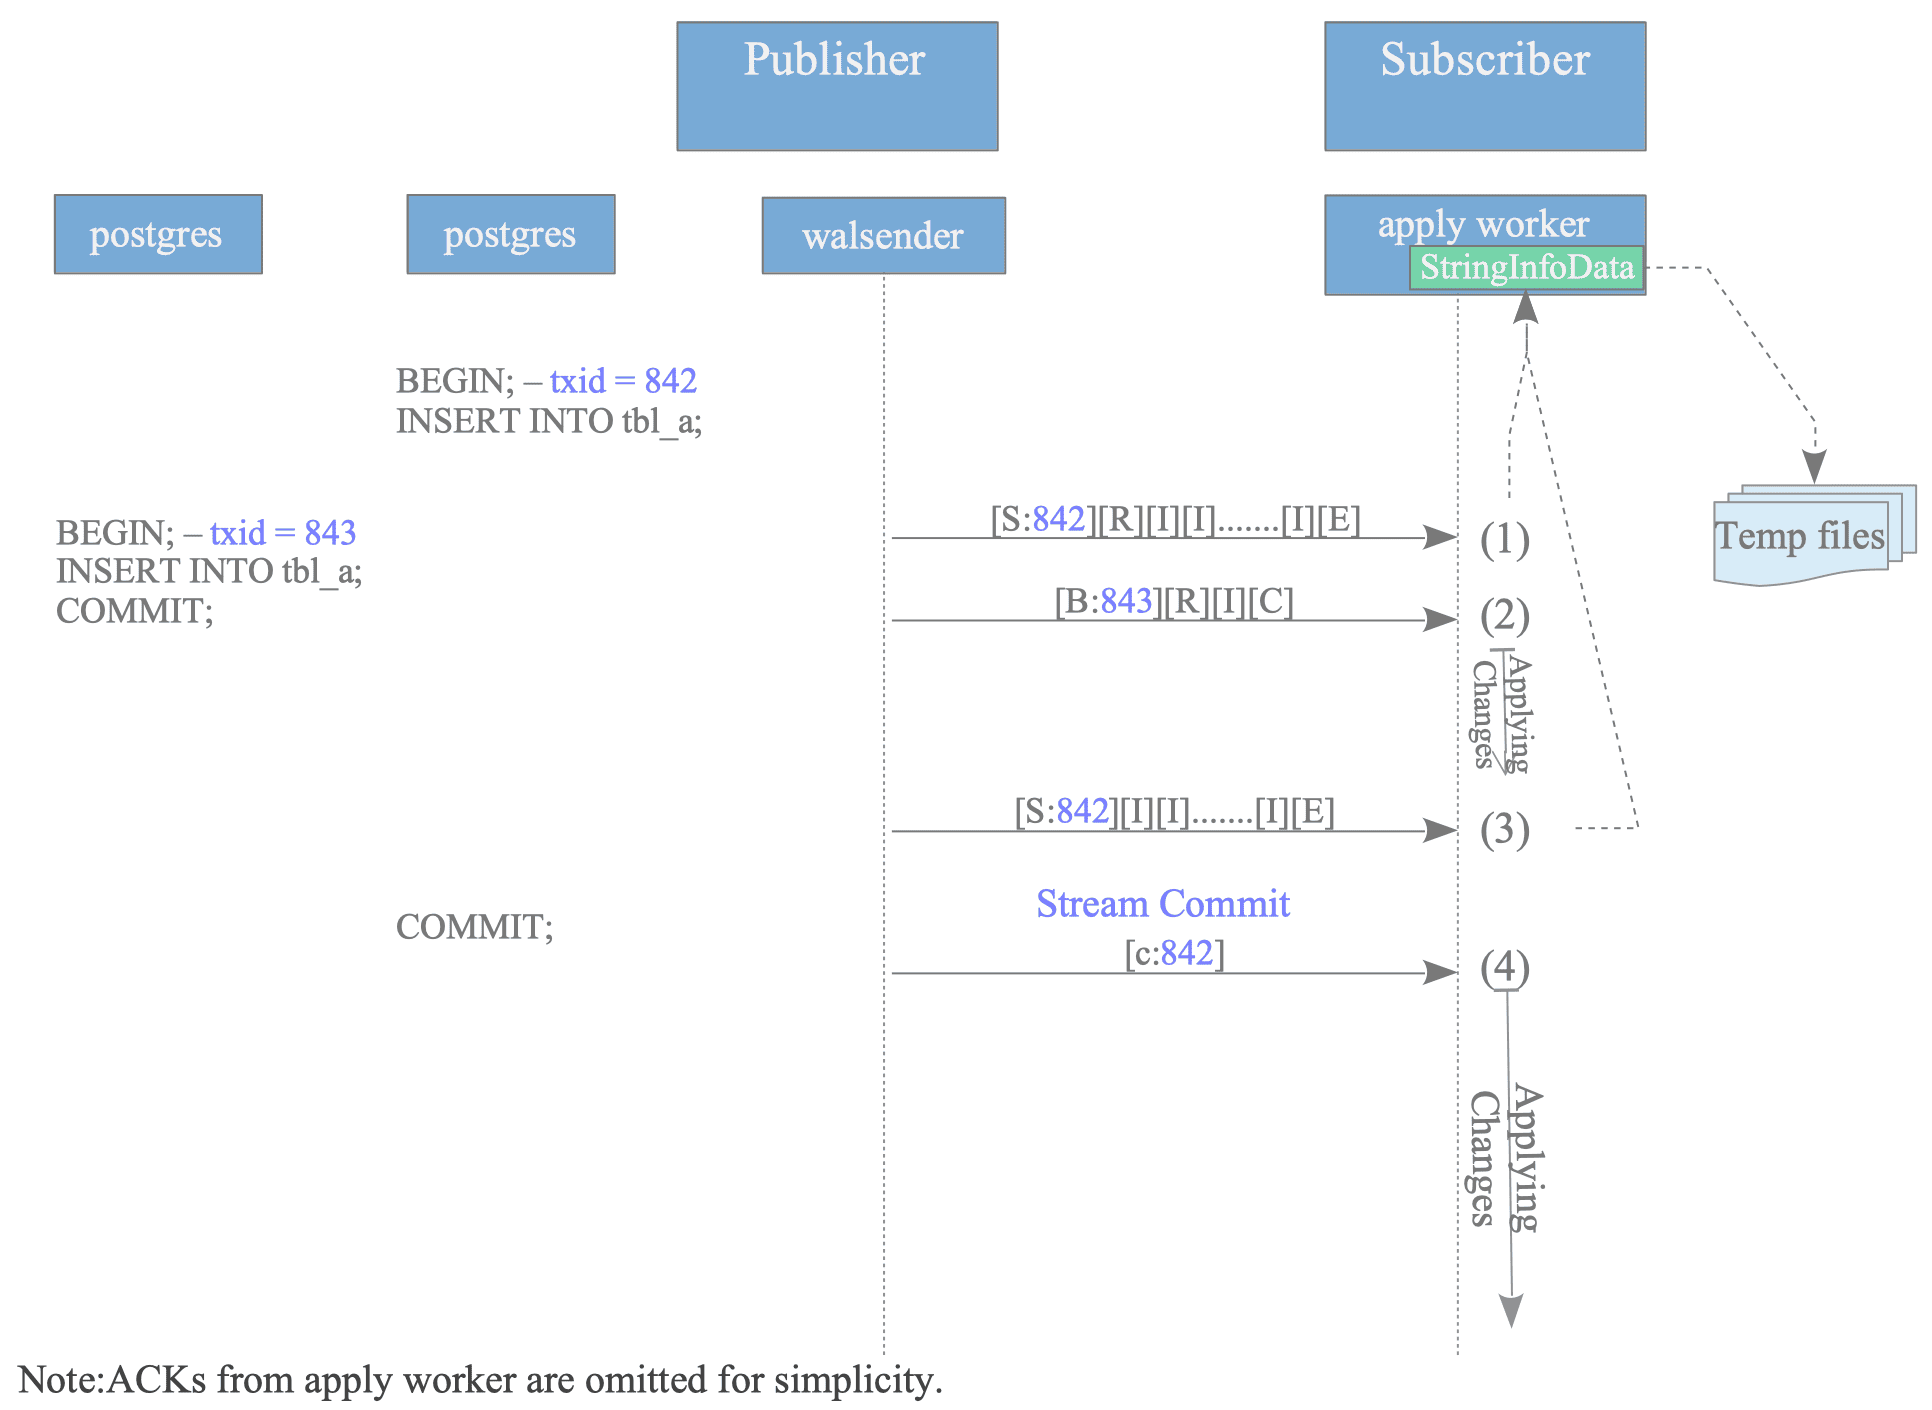
- 收到
txid=842首段后,用StringInfoData original_msg在内存中累积消息。 - 普通
txid=843到达后,立即解码并应用。 txid=842第二段追加到原有缓冲区。- 收到Stream Commit后,解码
txid=842的全部累积变更并顺序重放。
因此,普通消息立即处理,流式片段则先缓冲到提交消息到达。
12.7.2.1 内存压力与临时文件
流式变更缓存同样受logical_decoding_work_mem限制。超过上限后,apply worker把数据写入$PGDATA/base/pgsql_tmp/下的临时文件:
例如订阅OID为16403、事务ID为767、apply worker PID为2212:
事务提交或中止后,PostgreSQL自动删除这些临时文件。
12.7.3 并行Apply Worker(streaming=parallel)
PostgreSQL 16引入并行应用,允许订阅端并发重放多个事务。与streaming=on先缓冲到提交不同,被分配到parallel apply worker的变更会在到达时立即应用。
- leader apply worker: 维持walsender连接,并为收到的变更分派parallel worker。
- parallel apply worker: 由leader启动并并发应用事务。
- worker上限: 由
max_parallel_apply_workers_per_subscription控制。 - 退化机制: 活跃流式事务超过上限时,leader对额外事务退回
streaming=on,把片段缓存在内存或磁盘直到提交。
12.7.3.1 并行重放序列
假设txid=845是分两段发送的大事务,txid=846是单元组事务:
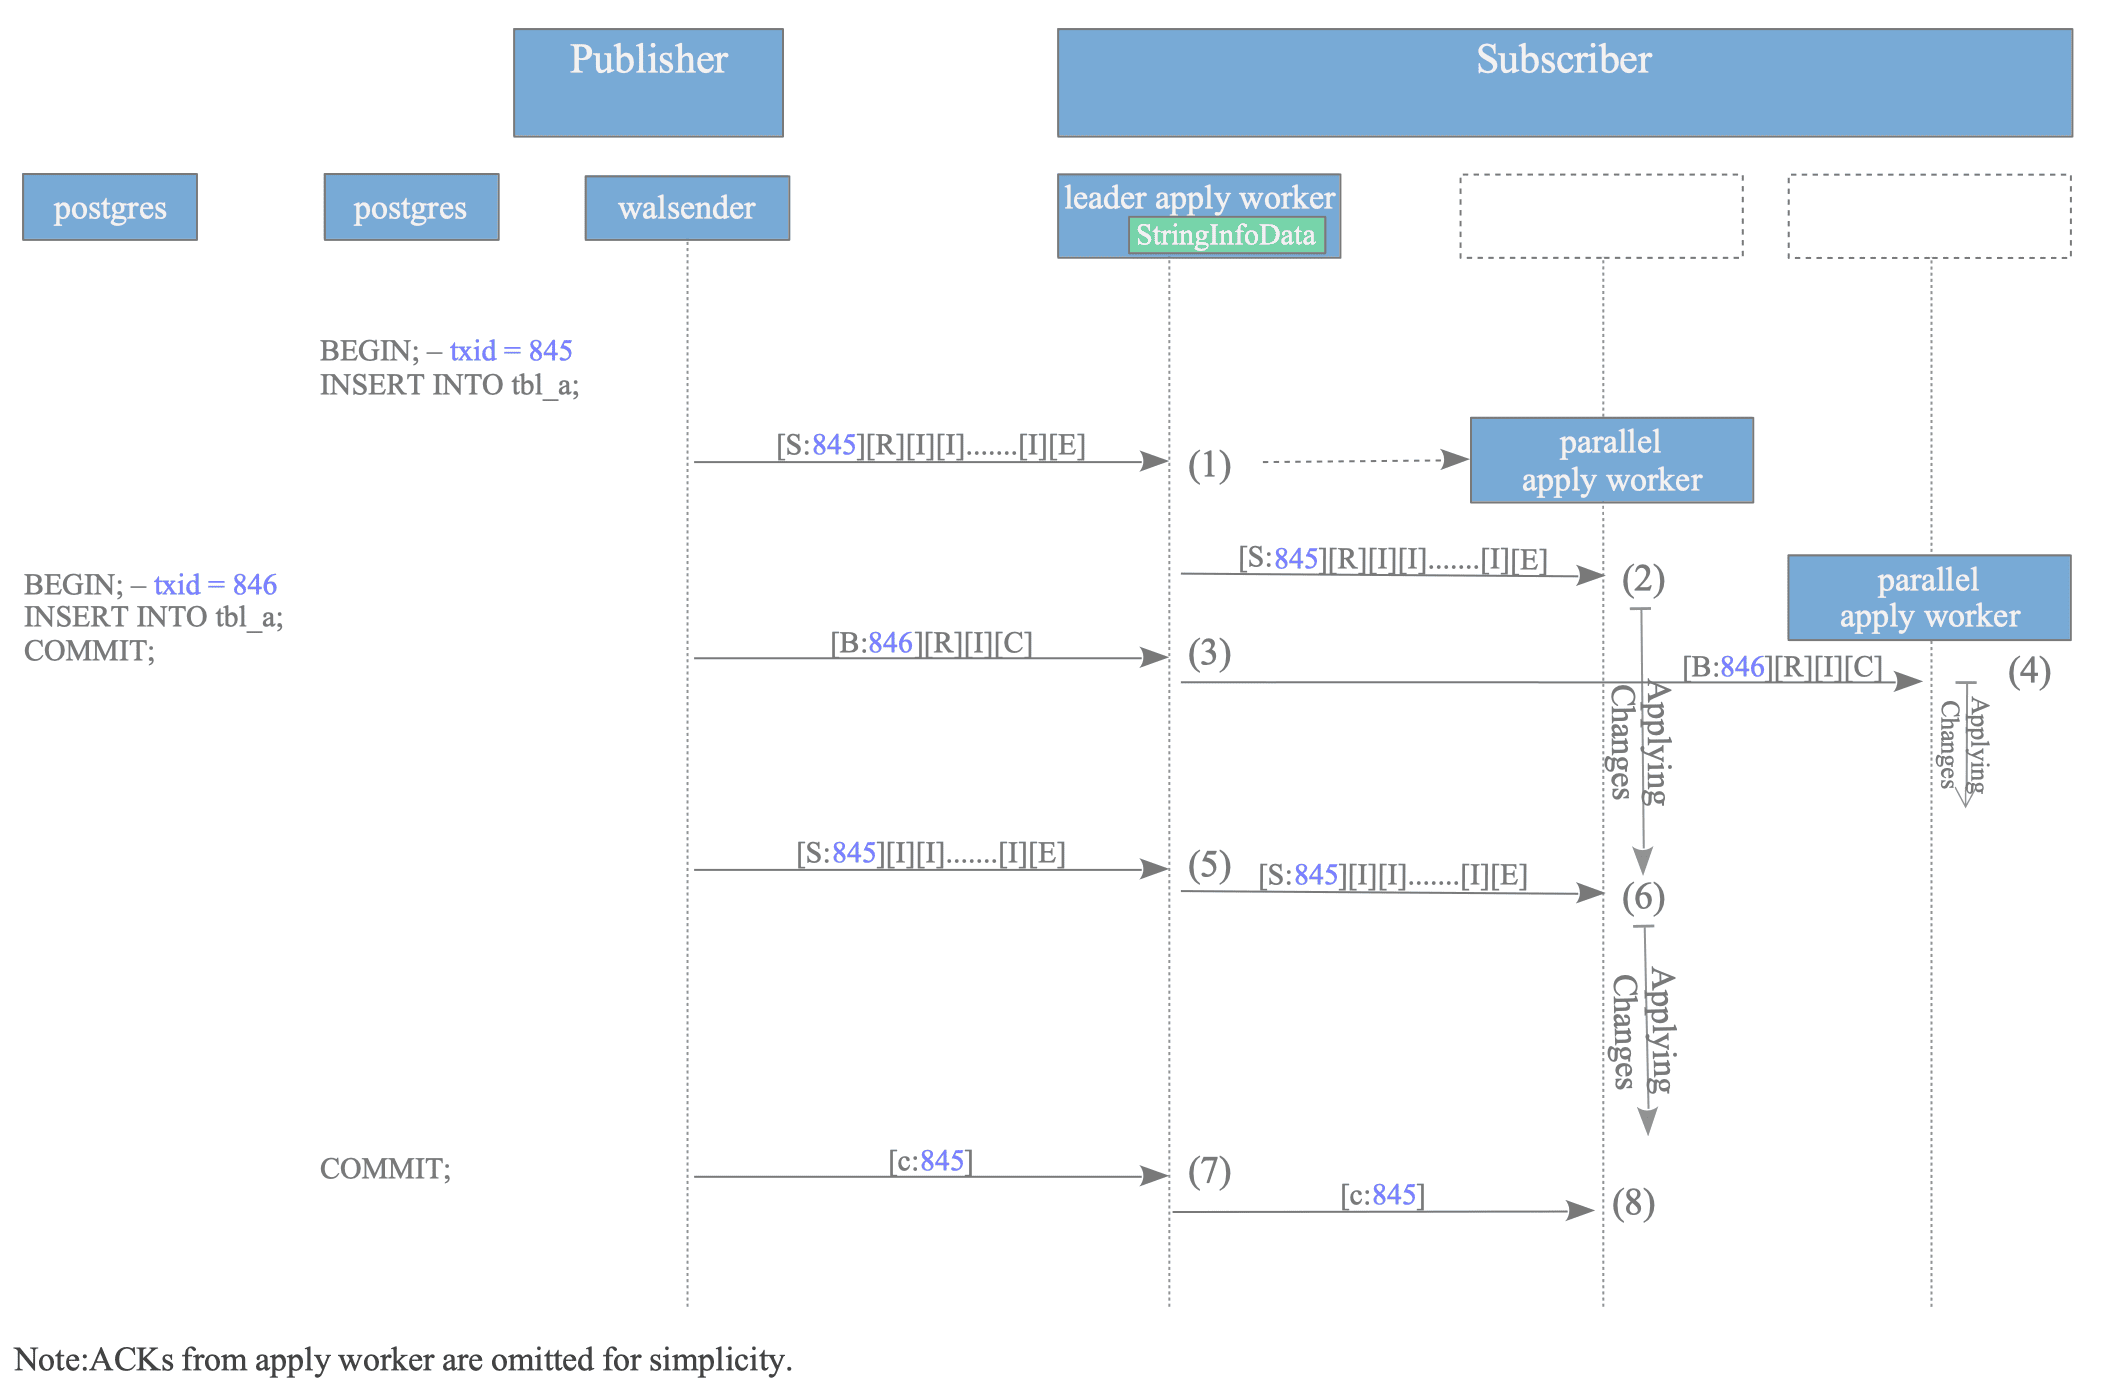
- leader收到
txid=845首段,启动或分配一个parallel worker。 - 把首段交给该worker,立即开始应用。
- 收到
txid=846后,为它启动或分配另一个worker并立即应用。 txid=845第二段到达后,转给原先分配的worker继续应用。- leader收到
txid=845的Stream Commit,通知该worker提交本地事务并回到就绪状态。
如果事务已经分配worker,后续片段始终转给同一worker;没有分配且仍低于上限时启动新worker;达到上限时则由leader缓冲并在提交后串行应用。
12.8 重启与崩溃恢复的内部机制
本节先说明逻辑复制如何管理WAL位置,再介绍订阅者正常重启与崩溃恢复的序列。
12.8.1 WAL数据管理
复制进度以WAL的LSN为基准。物理流复制的主备共享同一套WAL空间;逻辑复制的发布者与订阅者各自使用独立LSN,因此必须维护两套WAL空间之间的映射。
PostgreSQL由订阅者负责这项映射:发布者始终使用自己的LSN,订阅者记录本地LSN与从发布者收到的远端LSN之间的对应关系。
12.8.1.1 发布者与订阅者的LSN状态
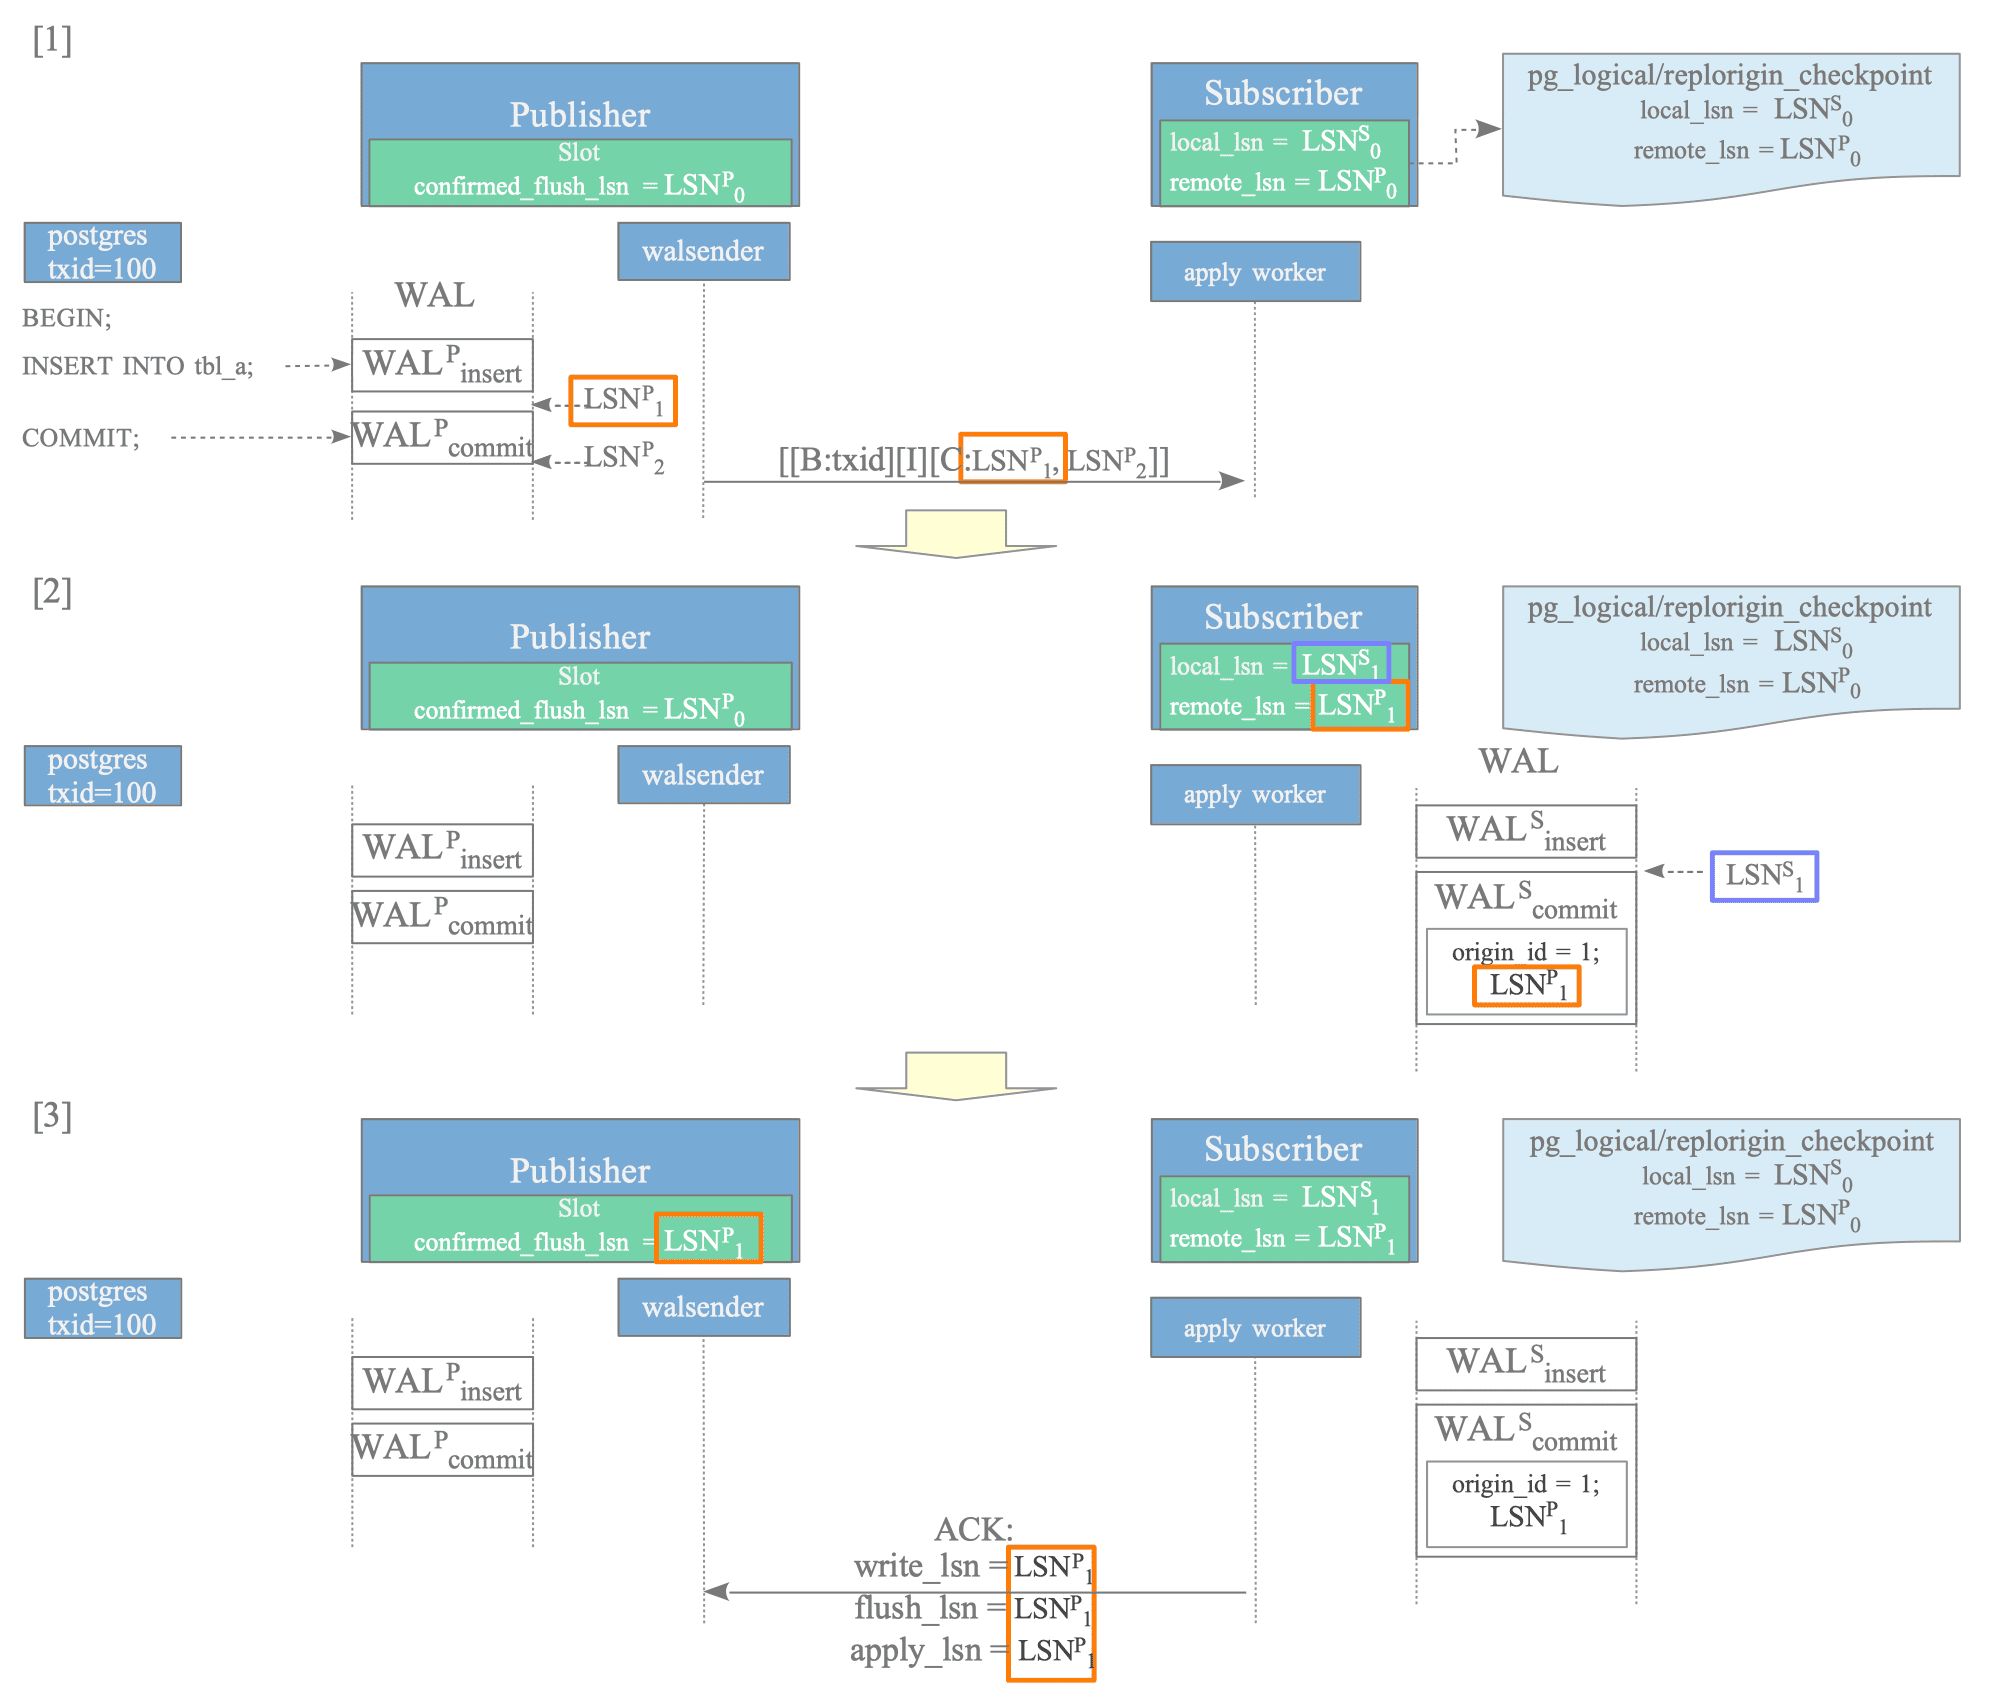
发布者在逻辑复制槽中维护confirmed_flush_lsn:它表示复制槽消费者已经确认接收的位置;在此位置之前提交的事务不再需要提供给复制。复制槽状态保存在内存中,通常在检查点时持久化。
订阅者提交或中止由复制产生的本地事务时,会在自己的WAL中记录发布者元数据:origin_id、发布者提交LSN与提交时间。同时在内存中维护:
local_lsn: 订阅者本地提交记录的LSN。remote_lsn: 与该提交对应的发布者final_lsn。
这些值可通过pg_replication_origin_status查看,并在每次检查点写入$PGDATA/pg_logical/replorigin_checkpoint。订阅者意外崩溃时,该文件中的最新映射可能落后;恢复过程会扫描WAL自动重建。
12.8.1.2 正常事务中的LSN流
- 复制槽当前
confirmed_flush_lsn为。发布者执行txid=100的INSERT,提交WAL从开始,到结束;pgoutput在Begin中发送final_lsn=LSN^P_1,在Commit中发送commit_lsn=LSN^P_1、end_lsn=LSN^P_2。 - 订阅者内存最初保存
local_lsn=LSN^S_0、remote_lsn=LSN^P_0。apply worker应用变更,并在订阅者WAL的写入提交记录,其中包含origin_id和发布者;内存映射随即更新为,但replorigin_checkpoint要到下次检查点才更新。 - 事务完成后,订阅者返回包含
write_lsn、flush_lsn与apply_lsn的ACK;这些值使用发布者WAL空间,本例均为。发布者据此把复制槽的confirmed_flush_lsn推进到。
12.8.2 重启序列
任一端正常重启导致复制停止后,逻辑复制会自动恢复。
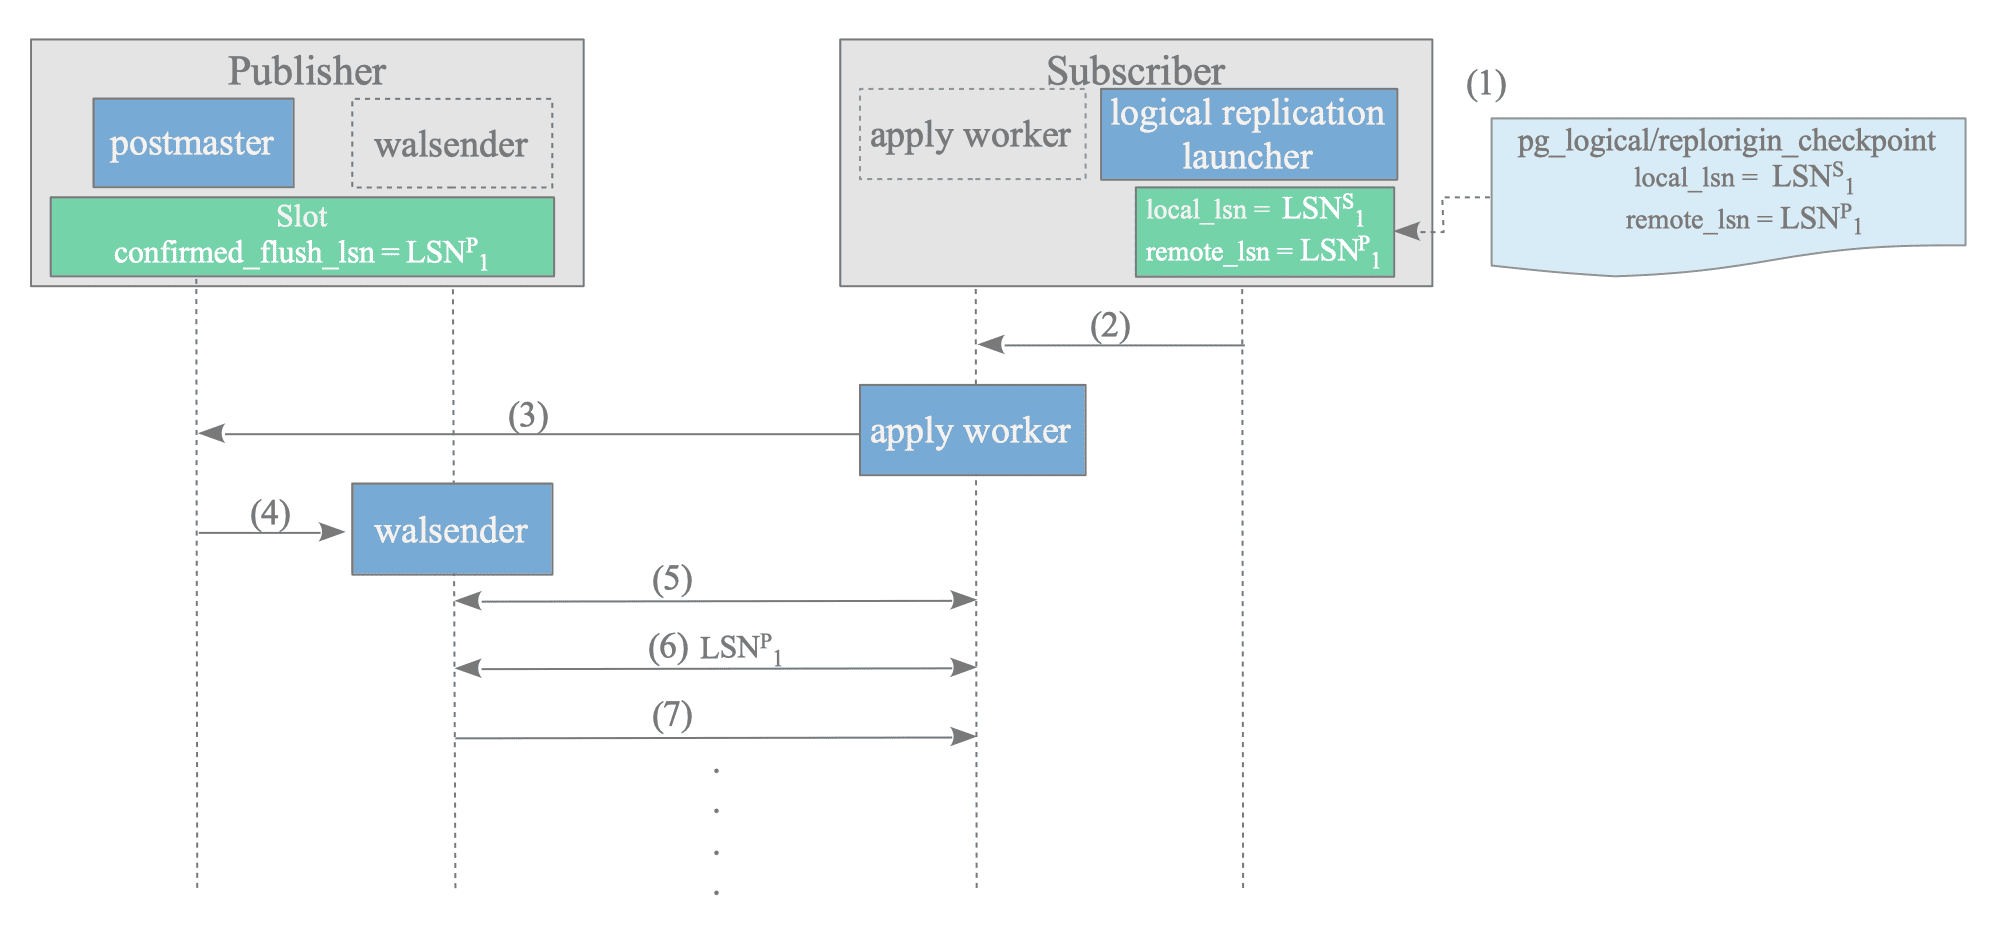
- 订阅者读取
replorigin_checkpoint,初始化local_lsn和remote_lsn。 - logical replication launcher启动apply worker。
- apply worker向发布者请求连接。
- 发布者postmaster启动walsender。
- apply worker与walsender建立连接。
- 双方使用
remote_lsn协商起点;订阅者发送远端位置,walsender从发布者WAL中的该位置开始解码。 - 复制从指定LSN继续。
12.8.3 崩溃恢复序列
订阅者崩溃时,replorigin_checkpoint中的映射只反映上一次检查点,可能已经过期。因此连接发布者前必须扫描本地WAL,重建最新映射。
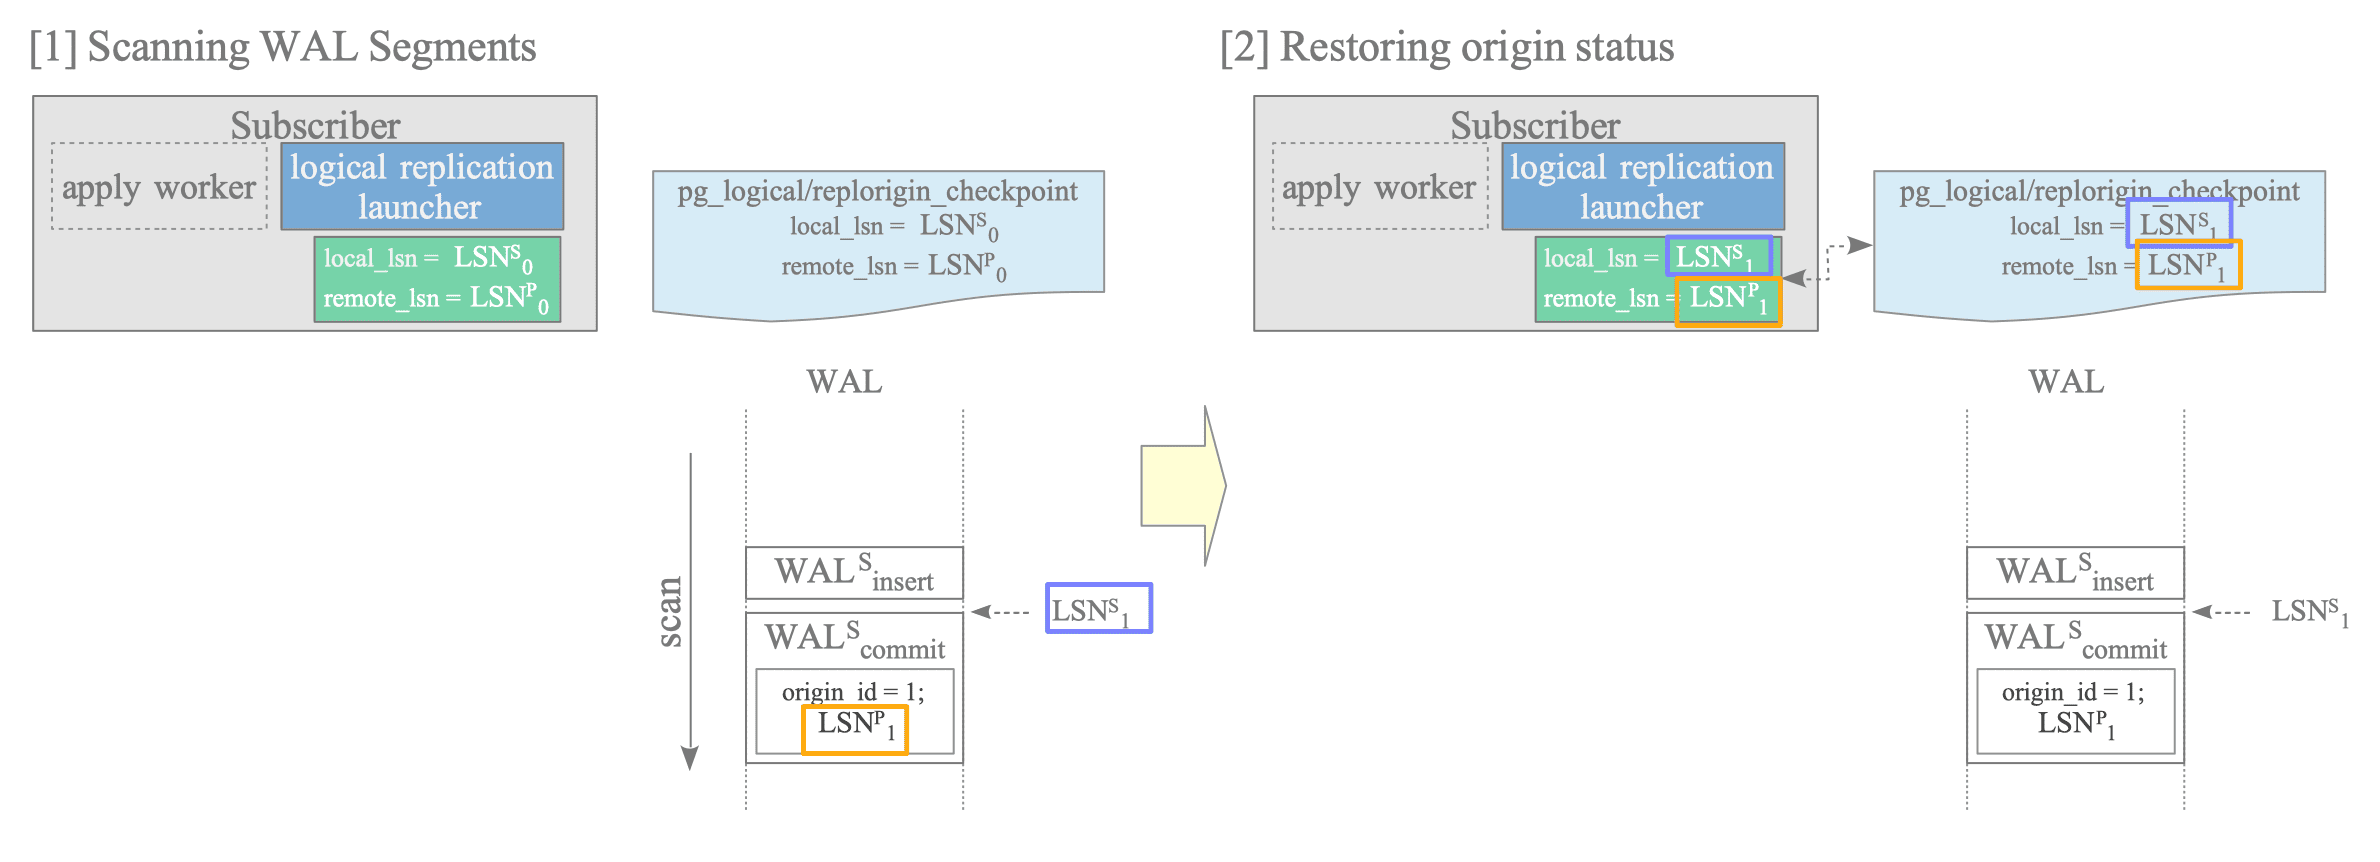
- 扫描WAL段: 在常规崩溃恢复过程中,从源自发布者的提交记录中提取
origin_id与origin_lsn。 - 恢复来源状态: 恢复完成后,把最新
origin_lsn及其对应的订阅者提交LSN恢复到内存,分别作为新的remote_lsn与local_lsn,并重建replorigin_checkpoint。 - 随后进入普通重启序列,与发布者重新建立连接。