10 基础备份与时间点恢复
在线数据库备份大致可分为两类:逻辑备份和物理备份。它们有着各自的优点和缺点。尽管各有优劣,但逻辑备份有一个缺点:执行需要花费太多时间。特别是对于大型数据库而言,需要花费很长时间进行备份,而从备份数据中恢复数据库可能需要更长的时间。相反的是,物理备份可以在相对较短的时间内备份和恢复大型数据库,因此在实际系统中,它是一个非常重要而实用的功能。
在PostgreSQL中,自8.0版本开始提供在线的全量物理备份,整个数据库集簇(即物理备份数据)的运行时快照称为基础备份(base backup)。
PostgreSQL还在8.0版中引入了时间点恢复(Point-In-Time Recovery, PITR)。这一功能可以将数据库恢复至任意时间点,这是通过使用一个基础备份和由持续归档生成的归档日志来实现的。例如,即使你犯了一个严重的错误(例如TRUNCATE所有的表),此功能使您可以将数据库恢复至错误发生之前的时刻。
本章描述了以下主题:
- 什么是基础备份
- PITR的工作原理
- 时间线标识(TimelineID)是什么
- 时间线历史文件是什么
- 增量备份的原理、创建方式与内部格式
在7.4或更早版本中,PostgreSQL仅支持逻辑备份(全量逻辑备份、部分逻辑备份,数据导出)。
10.1 基础备份
版本说明: PostgreSQL 15起使用
pg_backup_start()与pg_backup_stop();PostgreSQL 14及以前的名称分别为pg_start_backup()与pg_stop_backup()。下面的历史译文保留旧名称,新增部分使用当前内部函数名称。
首先,使用底层命令进行基本备份的标准过程如下所示:
-
发出
pg_start_backup命令 -
使用你想用的归档命令获取数据库集簇的快照
-
发出
pg_stop_backup命令
这个简单的过程对于DBA来说很容易操作,因为它不需要特殊工具,只需要常用工具(如复制命令或类似的归档工具)来创建基本备份。此外,在此过程中,不需要获取表上的锁,所有用户都可以在不受备份操作影响的情况下发起查询。相对于其他开源关系型数据库,这是一个巨大的优势。
更简单的方式是使用pg_basebackup命令来做基础备份,不过在它内部也是使用这些底层命令来工作的。
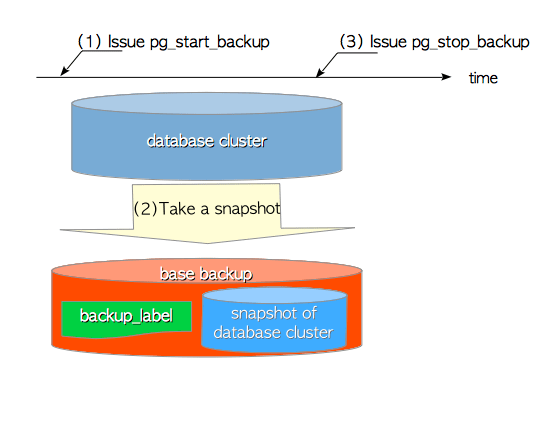
由于这些命令对显然是理解PITR的关键点之一,我们将在以下小节中探讨它们。
pg_start_backup和pg_stop_backup命令定义在:src/backend/access/transam/xlogfuncs.c。
10.1.1 pg_start_backup
pg_start_backup开始为制作基础备份进行准备工作。如第9.8节所述,恢复过程从重做点开始,因此pg_start_backup必须执行检查点,以便在制作基础备份的开始时刻显式创建一个重做点。此外,这次检查点的位置必须保存在不同于pg_control的其他文件中,因为在备份期间可能会进行多次常规检查点。因此pg_start_backup执行下列四个操作:
- 强制进入整页写入模式。
- 切换到当前的WAL段文件(8.4或更高版本)。
- 执行检查点。
- 创建
backup_label文件 —— 该文件创建于基本目录顶层中,包含有关该基本备份本身的关键信息,例如检查点位置。
第三和第四个操作是该命令的核心。第一和第二个操作是为了更可靠地恢复数据库集簇。
备份标签backup_label文件包含以下六个项目(11或更新版本为七个项目):
- 检查点位置(
CHECKPOINT LOCATION) —— 该命令所创建检查点的LSN位置。 - WAL开始位置(
START WAL LOCATION) —— 这不是给PITR用的,而是为第11章描述的流复制准备的。它被命名为START WAL LOCATION,因为复制模式下的备用服务器在初始启动时只读取一次该值。 - 备份方法(
BACKUP METHOD) —— 这是用于进行此基本备份的方法。 (pg_start_backup或pg_basebackup) - 备份来源(
BACKUP FROM) —— 说明此备份是从主库还是备库拉取。 - 开始时间(
START TIME)—— 这是执行pg_start_backup时的时间戳。 - 备份标签(
LABEL) —— 这是pg_start_backup中指定的标签。 - 开始时间线(
START TIMELINE) —— 这是备份开始的时间线。这是为了进行正常性检查,在版本11中被引入。
备份标签
一个9.6版本中备份标签的实际例子如下所示:
可以想象,当使用此基础备份恢复数据库时,PostgreSQL从backup_label文件中取出检查点位置CHECKPOINT LOCATION,然后从归档日志中的合适位置读取检查点记录,然后从检查点记录中获取重做点的位置,最后从重做点开始进行恢复过程(下一节将介绍细节)。
10.1.2 pg_stop_backup
pg_stop_backup执行以下五个操作以完成备份。
- 如果
pg_start_backup打开了整页写入,那么关闭整页写入。 - 写入一条备份结束的XLOG记录。
- 切换WAL段文件。
- 创建一个备份历史记录文件 —— 此文件包含
backup_label文件的内容,以及已执行pg_stop_backup的时间戳。 - 删除
backup_label文件 —— 从基础备份恢复需要backup_label文件,不过一旦被复制,原始的数据库集簇中就不需要它了。
备份历史文件的命名方法如下所示:
10.1.3 pg_basebackup
pg_basebackup是创建在线备份的工具。PostgreSQL 16及以前只支持整个数据库集簇的全量备份;PostgreSQL 17又增加了第10.5节介绍的增量备份。
执行远程备份时,pg_basebackup使用第11章介绍的walsender进程。例如,下面的命令从主机192.168.1.10创建一份全量备份,并保存至本地目录/usr/local/pgsql/backup/full:
图10.1-1展示了pg_basebackup创建全量备份的处理序列。该图对应新版英文原著的图10.2;为避免与中文旧译本已有的图10.2冲突,这里采用补充编号。
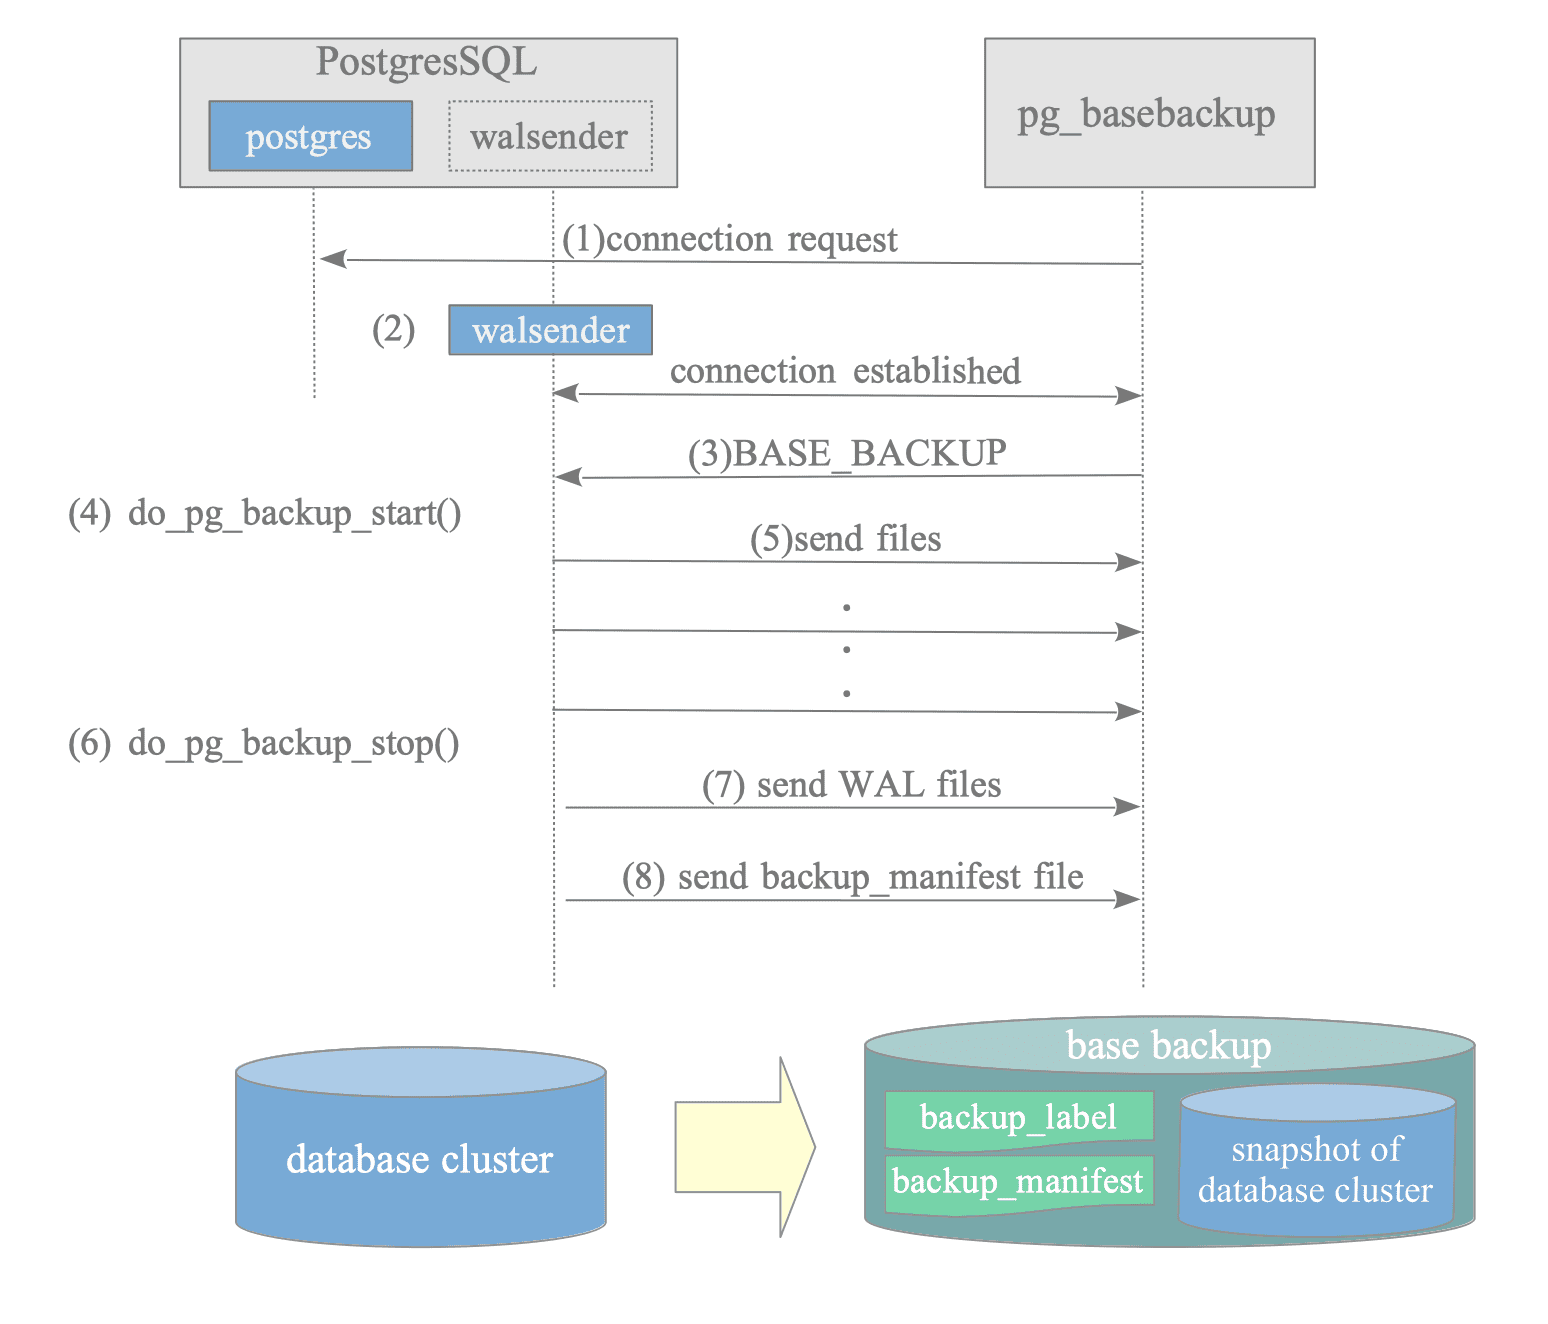
- 连接请求:
pg_basebackup请求连接PostgreSQL服务器上的walsender。 - 创建walsender进程: 服务器创建walsender并建立连接。
- 基础备份请求:
pg_basebackup请求备份。 - 执行
do_pg_backup_start(): walsender调用该函数。 - 发送全部文件: walsender发送数据库集簇中的所有文件,但暂不发送
pg_wal中的WAL文件。 - 执行
do_pg_backup_stop(): walsender调用该函数。 - 发送WAL文件: 如果
--wal-method不是none,walsender发送pg_wal中的WAL文件。 - 发送
backup_manifest: walsender创建并发送备份清单。
第5步暂不发送WAL,是为了让pg_basebackup在最后取得完整的WAL段;第6步中的do_pg_backup_stop()会切换当前WAL段,确保备份期间生成的所有WAL都已刷入pg_wal目录。
为什么使用walsender?
pg_basebackup并不直接执行复制,但开发该工具时,可以接受外部程序连接的进程只有postgres与walsender,因此项目扩展了walsender协议来支持基础备份。
10.1.3.1 备份清单文件
备份清单是一个JSON文件,包含备份的元数据与校验信息。主要字段如下:
| 字段 | 含义 |
|---|---|
PostgreSQL-Backup-Manifest-Version |
备份清单格式版本。 |
System-Identifier |
数据库集簇的系统标识。 |
Files |
所有备份文件的路径、大小、修改时间、校验算法及校验值。 |
WAL-Ranges |
备份期间的时间线与LSN范围;Start-LSN是do_pg_backup_start()触发检查点所生成的重做点,End-LSN是do_pg_backup_stop()生成WAL记录的LSN。 |
Manifest-Checksum |
清单文件自身的校验值。 |
备份清单示例如下:
10.2 时间点恢复(PITR)的工作原理
图10.2展示了PITR的基本概念。 PITR模式下的PostgreSQL会在基础备份上重放归档日志中的WAL数据,从pg_start_backup创建的重做点开始,恢复至你想要的位置为止。在PostgreSQL中,要恢复到的位置,被称为恢复目标(recovery target)。
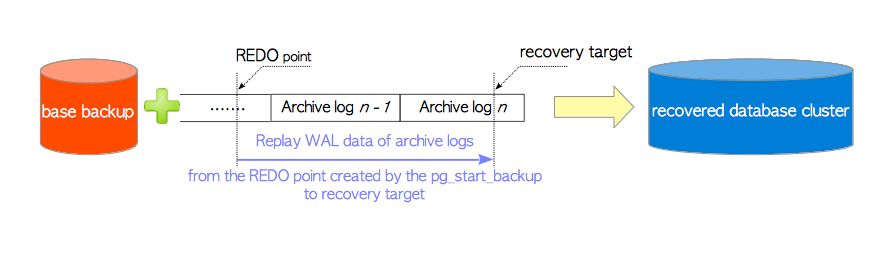
PITR是这样工作的。假设你在GMT时间2018-07-16 12:05:00进行了误操作。你应该删除当前的数据库集簇,并使用之前制作的基础备份恢复一个新的集簇。然后创建recovery.conf文件,将参数recovery_target_time配置为误操作发生的时间点(在本例中,也就是12:05 GMT)。recovery.conf文件如下所示:
当PostgreSQL启动的时候,如果数据库集簇中存在recovery.conf和backup_label文件,它就会进入恢复模式。
PITR过程几乎与第九章中描述的常规恢复过程一模一样,唯一的区别只有以下两点:
- 从哪里读取WAL段/归档日志?
- 正常恢复模式 —— 来自基础目录下的
pg_xlog子目录(10或更新版本,pg_wal子目录)。 - PITR模式 —— 来自配置参数
archive_command中设置的归档目录。
- 正常恢复模式 —— 来自基础目录下的
- 从哪里读取检查点位置?
- 正常恢复模式 —— 来自
pg_control文件。 - PITR模式 —— 来自
backup_label文件。
- 正常恢复模式 —— 来自
PITR流程概述如下:
-
为了找到重做点,PostgreSQL使用内部函数
read_backup_label从backup_label文件中读取CHECKPOINT LOCATION的值。 -
PostgreSQL从
recovery.conf中读取一些参数值;在此示例中为restore_command和recovery_target_time。 -
PostgreSQL开始从重做点重放WAL数据,重做点的位置可以简单地从
CHECKPOINT LOCATION的值中获得。 PostgreSQL执行参数restore_command中配置的命令,将归档日志从归档区域拷贝到临时区域,并从中读取WAL数据(复制到临时区域中的日志文件会在使用后删除)。在本例中,PostgreSQL从重做点读取并重放WAL数据,直到时间戳
2018-7-16 12:05:00为止,因为参数recovery_target_time被设置为该时间戳。如果recovery.conf中没有配置恢复目标,则PostgreSQL将重放至归档日志的末尾。 -
当恢复过程完成时,会在
pg_xlog子目录(10或更高版本为pg_wal子目录)中创建时间线历史文件,例如00000002.history;如果启用了日志归档功能,则还会在归档目录中创建相同的命名文件。以下各节介绍了此文件的内容和作用。
提交和中止操作的记录包含每个操作完成时的时间戳(两个操作的XLOG数据部分分别在xl_xact_commit和xl_xact_abort中定义)。因此,如果将目标时间设置为参数recovery_target_time,只要PostgreSQL重放提交或中止操作的XLOG记录,它可以选择是否继续恢复。当重放每个动作的XLOG记录时,PostgreSQL会比较目标时间和记录中写入的每个时间戳;如果时间戳超过目标时间,PITR过程将完成。
函数
read_backup_label定义于src/backend/access/transam/xlog.c中。 结构xl_xact_commit和xl_xact_abort定义于src/backend/access/transam/xlog.c。
为什么可以用一般归档工具做基础备份?
尽管数据库集簇可能是不一致的,但恢复过程是使数据库集簇达成一致状态的过程。由于PITR是基于恢复过程的,所以即使基础备份是一堆不一致的文件,它也可以恢复数据库集簇。因此我们可以在没有文件系统快照功能,或其他特殊工具的情况下,使用一般归档工具做基础备份。
10.3 时间线与时间线历史文件
PostgreSQL中的时间线用于区分原始数据库集簇和恢复生成的数据库集簇,它是PITR的核心概念。在本节中,描述了与时间线相关的两件事:时间线标识(TimelineID),以及时间线历史文件(Timeline History Files)。
10.3.1 时间线标识(TimelineID)
每个时间线都有一个相应的时间线标识,一个四字节的无符号整型,从1开始计数。
每个数据库集簇都会被指定一个时间线标识。由initdb命令创建的原始数据库集簇,其时间线标识为1。每当数据库集簇恢复时,时间线标识都会增加1。例如在前一节的例子中,从原始集簇中恢复得到的集簇,其时间线标识为2。
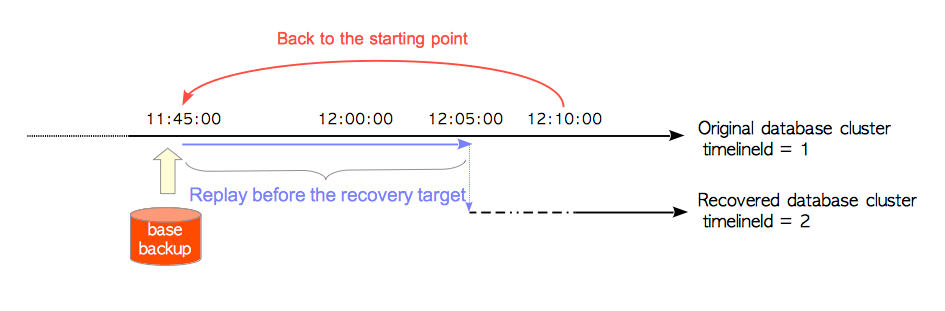
图10.3从时间线标识的角度展示了PITR过程。首先,我们删除当前的数据库集簇,并替换为过去的基础备份,以便返回到恢复的起始点,这一步在图中用红色曲线箭头标识。接下来,我们启动PostgreSQL服务器,它通过跟踪初始时间线(时间线标识1),从pg_start_backup创建的重做点开始,重放归档日志中的WAL数据,直到恢复目标达成,这一步在图中用蓝色直线箭头标识。接下来,恢复得到的数据库集簇将被分配一个新的时间线标识2,而PostgreSQL将运行在新的时间线上。
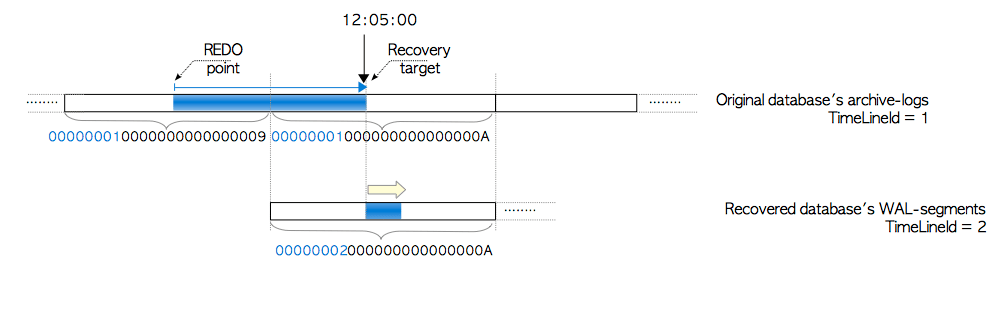
正如第九章中简要提到的,WAL段文件名的前8位数字等于创建这些段文件的数据库集簇的时间线标识。当时间线标识发生变化时,WAL段文件名也会相应改变。
让我们从WAL段文件的角度重新审视恢复过程。假设我们使用两个归档日志文件来恢复数据库:
,以及 。新恢复得到的数据库集簇被分配了时间线标识2,而PostgreSQL就会从 开始创建WAL段。如图10.4所示。
10.3.2 时间线历史文件
当PITR过程完成时,会在归档目录和pg_xlog子目录(10或更高版本为pg_wal子目录)下创建名称为00000002.history的时间线历史文件。该文件记录了当前时间线是从哪条时间线分叉出来的,以及分叉的时间。
该文件的命名规则如下所示:
时间线历史文件至少包含一行,每行由以下三项组成:
- 时间线标识 —— 曾用于恢复的归档日志的时间线。
- LSN —— 发生WAL段切换的LSN位置。
- 原因 —— 可读的时间线发生变化的原因解释。
具体示例如下所示:
含义如下:
数据库集簇(时间线标识为2)基于时间线标识为1的基础备份,并在
2018-7-9 12:05:00.861324+00之前,通过重放检查点日志,恢复至0/A000198的位置。
通过这种方式,每个时间线历史文件都会告诉我们每个恢复所得的数据库集簇的完整历史,而且它也会在PITR过程中使用。下一节将描述具体细节。
时间线历史文件的格式在9.3版本中发生变化。9.3前后的格式如下所示,但相对简略。
9.3及后续版本:
9.2及先前版本
10.4 时间点恢复与时间线历史文件
时间线历史文件在第二次及后续PITR过程中起着重要作用。通过尝试第二次恢复,我们将探索如何使用它。
同样,假设您在12:15:00又犯了一个错误,错误发生在时间线ID为2的数据库集簇上。在这种情况下为了恢复数据库集簇,你需要创建一个如下所示的recovery.conf文件:
参数recovery_target_time被设置为您犯下新错误的时间,而recovery_target_timeline被设置为2,以便沿着这条时间线恢复。
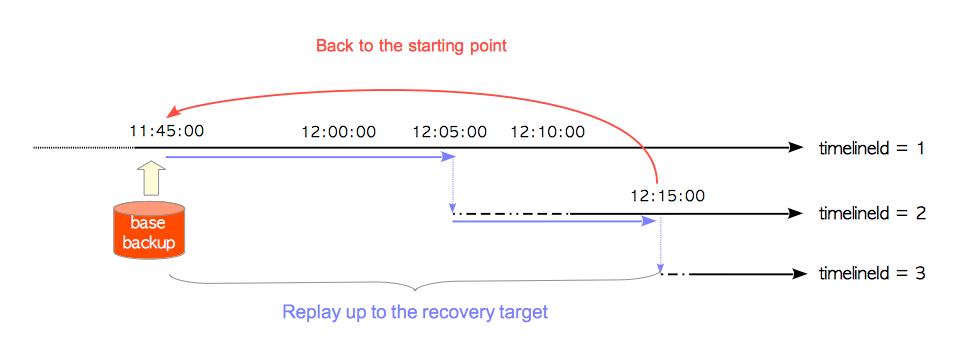
重启PostgreSQL服务器并进入PITR模式,数据库会沿着时间线标识2进行恢复。如图10.5所示。
-
PostgreSQL从
backup_label文件中读取CHECKPOINT LOCATION的值。 -
从
recovery.conf中读取一些参数值;在此示例中为restore_command,recovery_target_time和recovery_target_timeline。 -
PostgreSQL读取时间线历史文件
00000002.history,该文件对应参数recovery_target_timeline的值。 -
PostgreSQL通过以下步骤重放WAL数据:
- 对于从重做点到
LSN 0/A000198(该值写在00000002.history文件中)之间的WAL数据,PostgreSQL会(从合适的归档日志中)读取并重放TimelineID=1的WAL数据。 - 对于从
LSN 0/A000198,到时间戳2018-7-9 12:15:00之间的WAL数据,PostgreSQL会(从合适的归档日志中)读取并重放TimelineID=2的WAL数据。
- 对于从重做点到
-
当恢复过程完成时,当前的时间线标识将增加到3,并在
pg_xlog子目录(10及后续版本为pg_wal子目录)和归档目录中创建名为00000003.history的新时间线历史文件。
当你进行过超过一次的PITR时,应明确设置时间线标识,以便使用合适的时间线历史文件。
因此,时间线历史文件不仅仅是数据库集簇的历史日志,还是PITR过程的参考恢复指令。
10.5 增量备份
定期备份对于系统的正常运行至关重要。然而,保留多份全量备份会占用大量存储空间。
为解决这个问题,PostgreSQL 17(2024年)引入了增量备份。增量备份只保存相较于前一份备份发生过变化的文件部分。
以下小节将介绍增量备份的整体原理、使用pg_basebackup创建增量备份的过程,以及增量备份的内部数据格式。
10.5.1 增量备份概述
10.5.1.1 创建增量备份
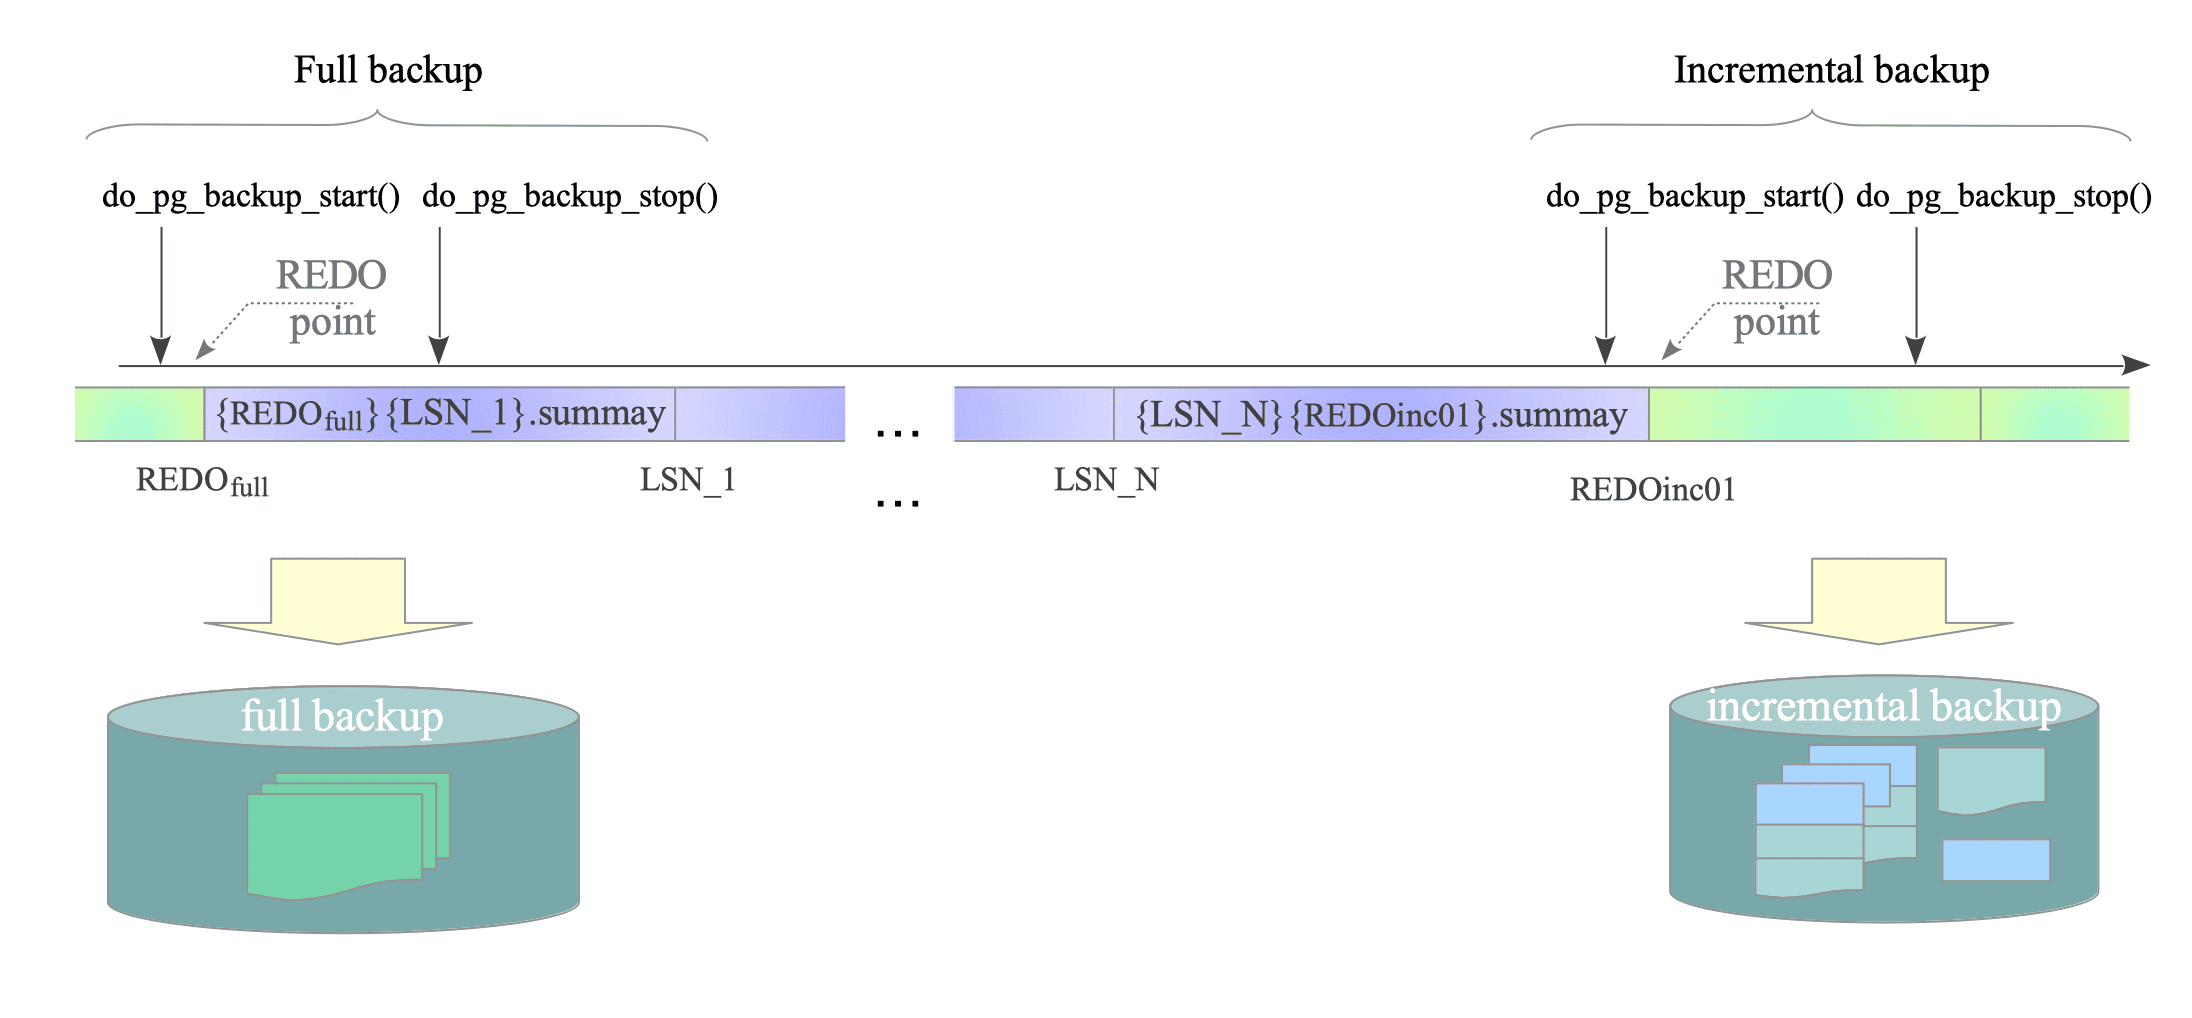
增量备份依赖一份全量备份和若干WAL汇总文件。这些汇总文件由第9.6.2节介绍的WAL汇总器进程生成。下面从最初的全量备份开始说明。
-
创建全量备份: 执行
do_pg_backup_start()后创建一份全量备份,其中包含所有关系文件。假设这份全量备份的重做点为。 -
跟踪变更: WAL汇总器进程跟踪所有数据库块的变更,并将这些修改写入WAL汇总文件。
-
创建增量备份: 假设本次增量备份的重做点为。PostgreSQL利用与之间生成的汇总文件,只保存发生过变化的块,而不是保存完整的关系文件。
这个过程有两点需要注意:
- 关系文件和可见性映射(VM)文件会以增量备份文件的形式保存,而空闲空间映射(FSM)文件始终会被完整备份。这是因为WAL汇总器不会跟踪FSM分支。
- 如果某个关系是在前一份备份之后创建的,系统会备份整个关系文件。
增量备份文件采用以下命名规则:
- 关系文件:
INCREMENTAL.{oid} - 可见性映射:
INCREMENTAL.{oid}_vm
例如,表t1的OID为16551,那么它对应的增量备份文件名就是INCREMENTAL.16551。
下面的例子展示了表t1的全量备份文件与增量备份文件:
10.5.1.2 重构备份
PostgreSQL提供了pg_combinebackup工具,用于将增量备份及其所依赖的备份重构为一份基础备份。
假设全量备份位于/usr/local/pgsql/backup/full,增量备份位于/usr/local/pgsql/backup/inc01,可以先用以下命令检查将其重构至/usr/local/pgsql/reconstructed的过程:
译者注:
-n(--dry-run)只会演练重构过程,并不会写出备份。若要真正生成/usr/local/pgsql/reconstructed,应去掉-n选项。
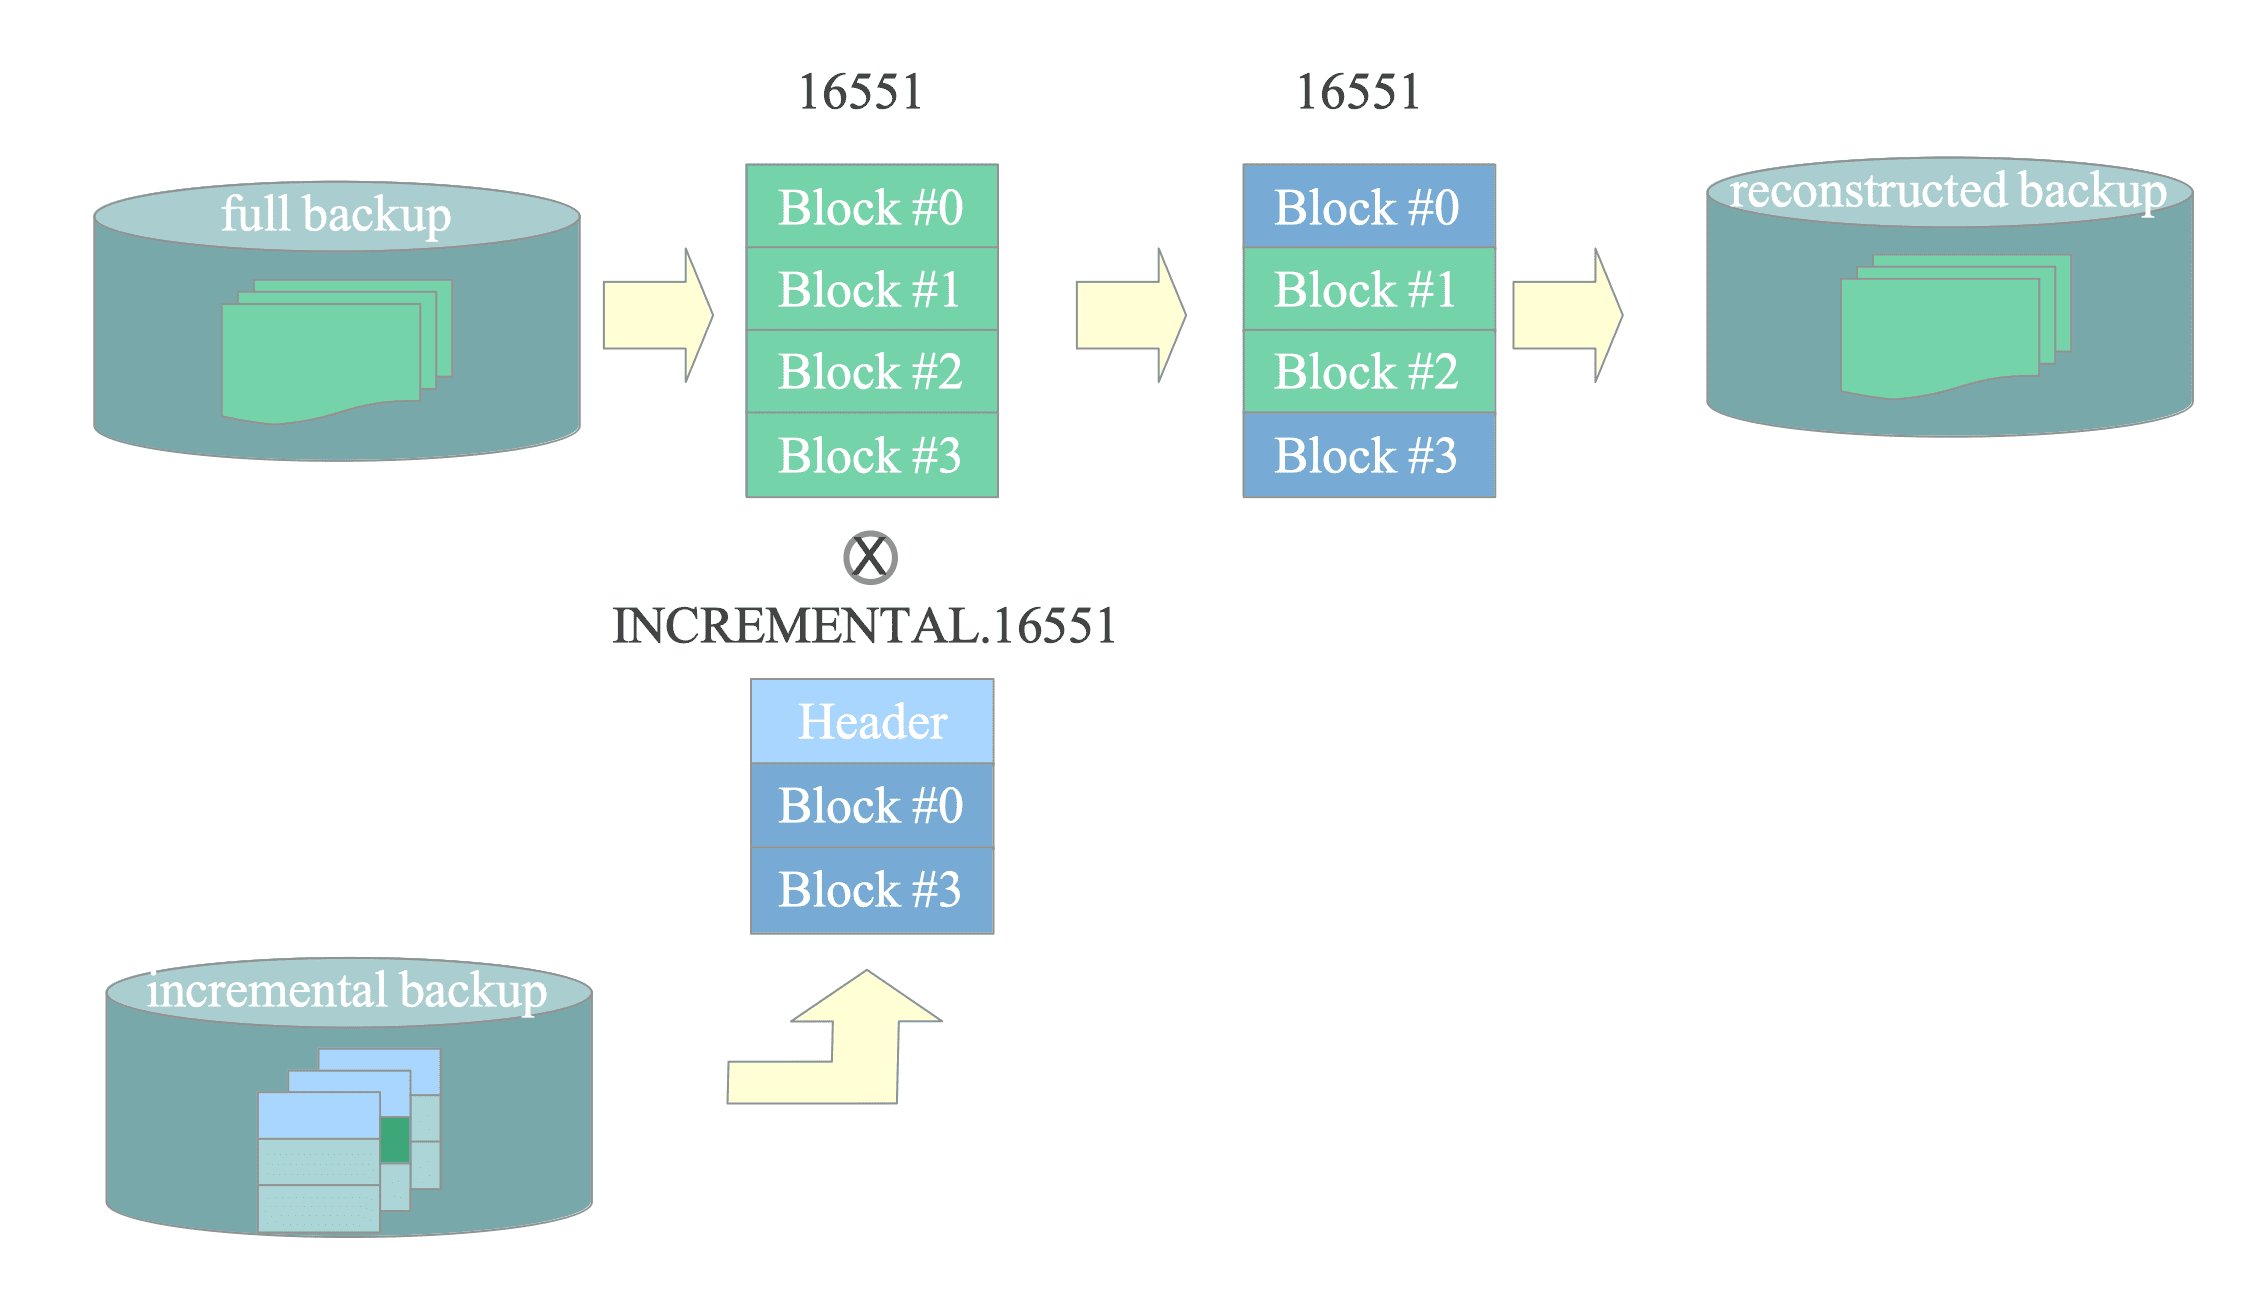
图10.8展示了pg_combinebackup重构基础备份的方式。简而言之,pg_combinebackup会把增量备份文件中记录的块变更应用到原始关系文件上。
例如,全量备份中包含表t1的关系文件16551,增量备份中包含INCREMENTAL.16551,那么pg_combinebackup会使用增量文件中的变更块(例如第0号块和第3号块)覆盖原始的16551文件。
10.5.2 如何创建增量备份
创建增量备份时,需要使用--incremental选项,并在其后指定前一份备份的清单文件路径。
例如,若要以前一份位于/usr/local/pgsql/backup/full的全量备份为基准,从主机192.168.1.10创建一份增量备份,并将其保存至本地目录/usr/local/pgsql/backup/inc01,可以执行:
图10.9展示了pg_basebackup以增量备份模式运行时的处理序列。
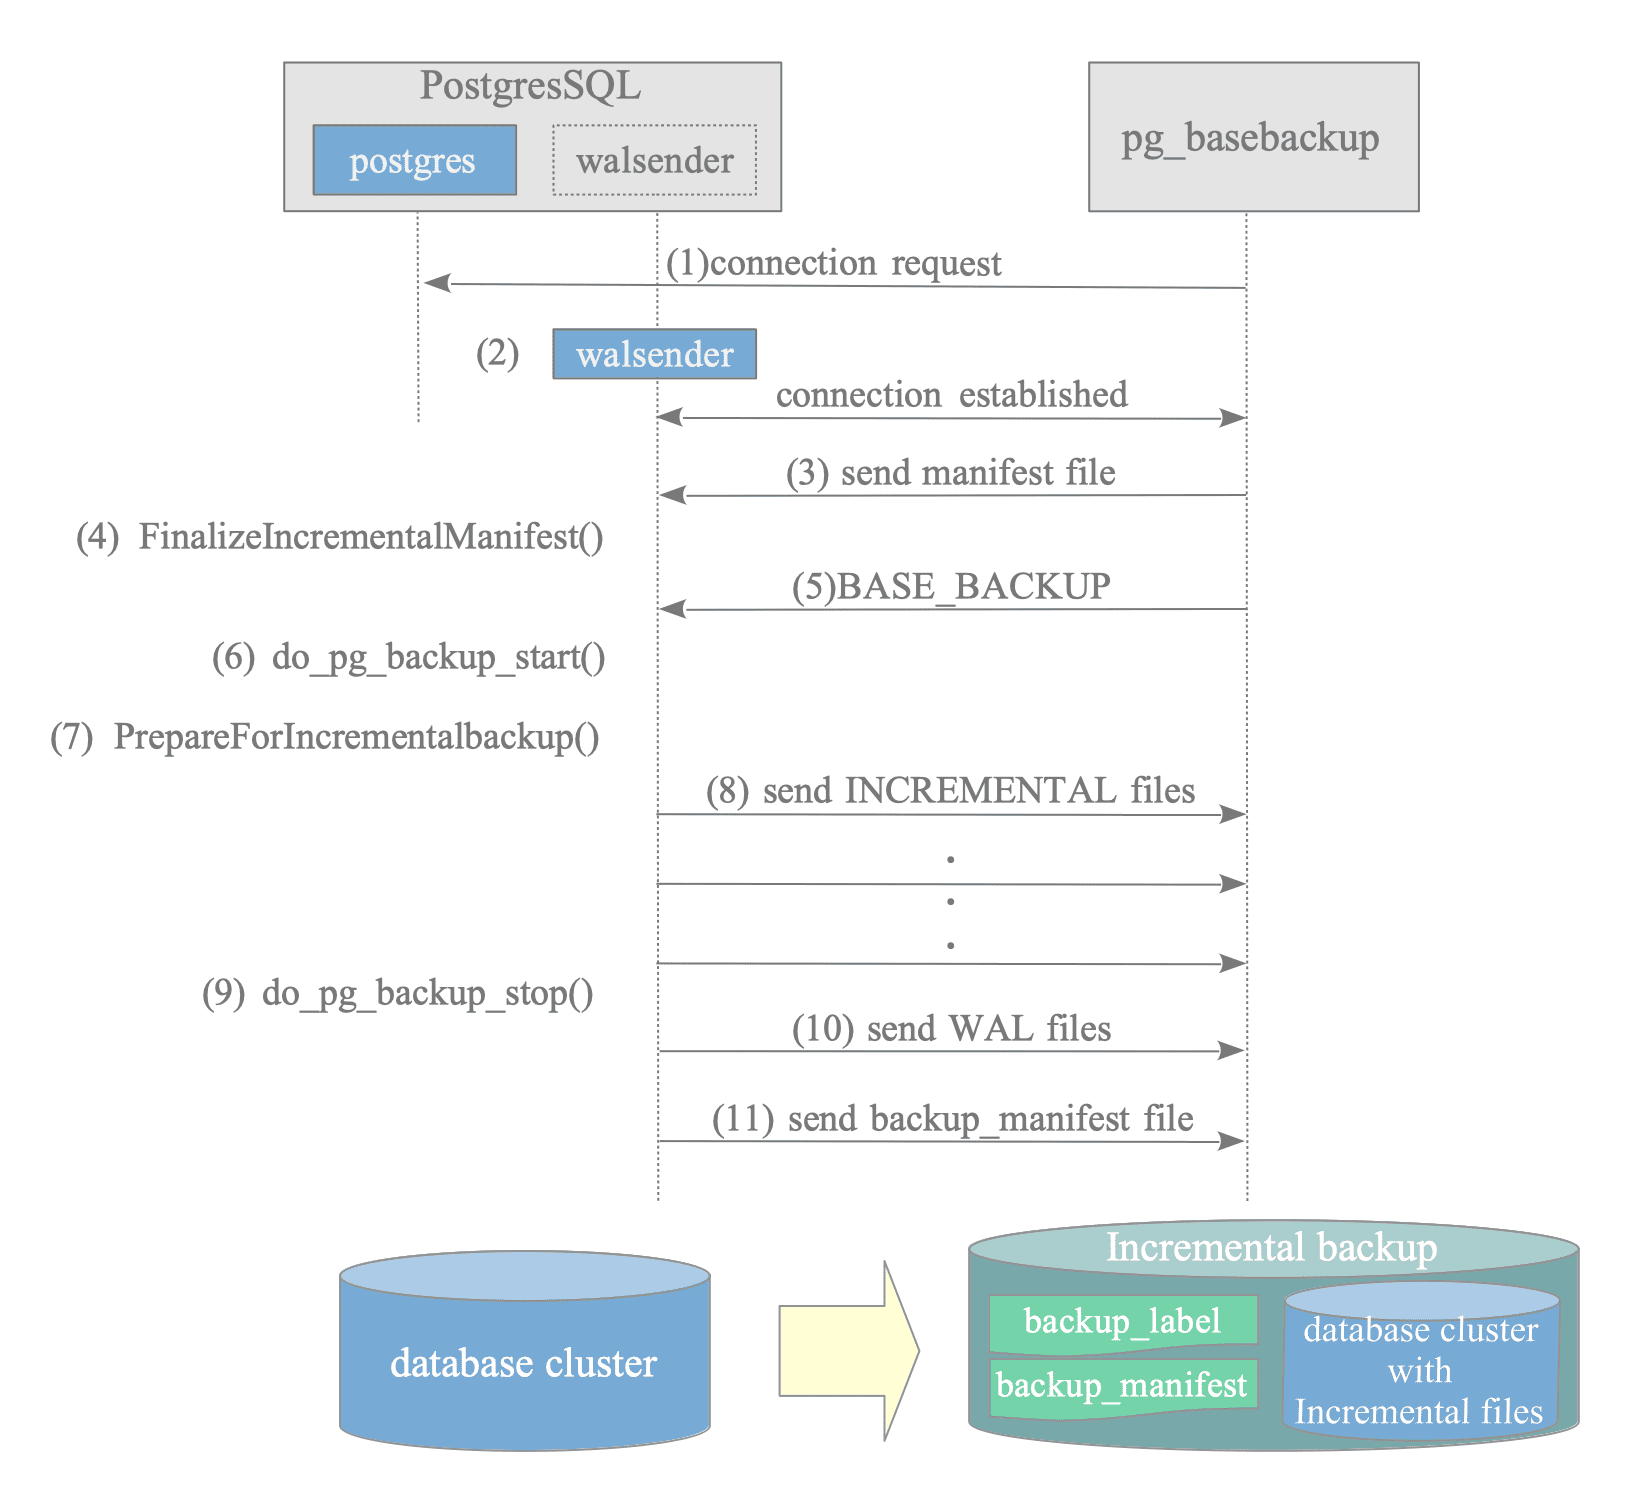
- 连接请求
- 创建walsender进程
- 发送备份清单文件:
pg_basebackup发送前一份备份的backup_manifest文件。 - 初始化增量备份参数:
walsender进程调用
FinalizeIncrementalManifest(),从前一份备份的清单文件中取得时间线与起始LSN。 - 请求基础备份
- 执行
do_pg_backup_start() - 识别变更块:
walsender进程调用
PrepareForIncrementalBackup(),生成所有已变更关系块的列表。它会分析从起始LSN(第4步取得)到最新重做点(第6步生成)之间的汇总文件,从中识别这些变更。 - 发送
INCREMENTAL文件: walsender进程发送增量备份文件,而不是完整的关系文件和可见性映射文件。这些增量文件由一个首部块和若干变更块组成,具体内容由第7步生成的列表决定。 - 执行
do_pg_backup_stop() - 发送WAL文件
- 发送
backup_manifest文件
在第8步中,如果某个关系是在前一份备份之后创建的,walsender会发送完整的关系文件。
若要继续创建下一份增量备份,可以再次执行pg_basebackup,并让--incremental指向前一份增量备份的清单文件:
10.5.3 INCREMENTAL文件的格式
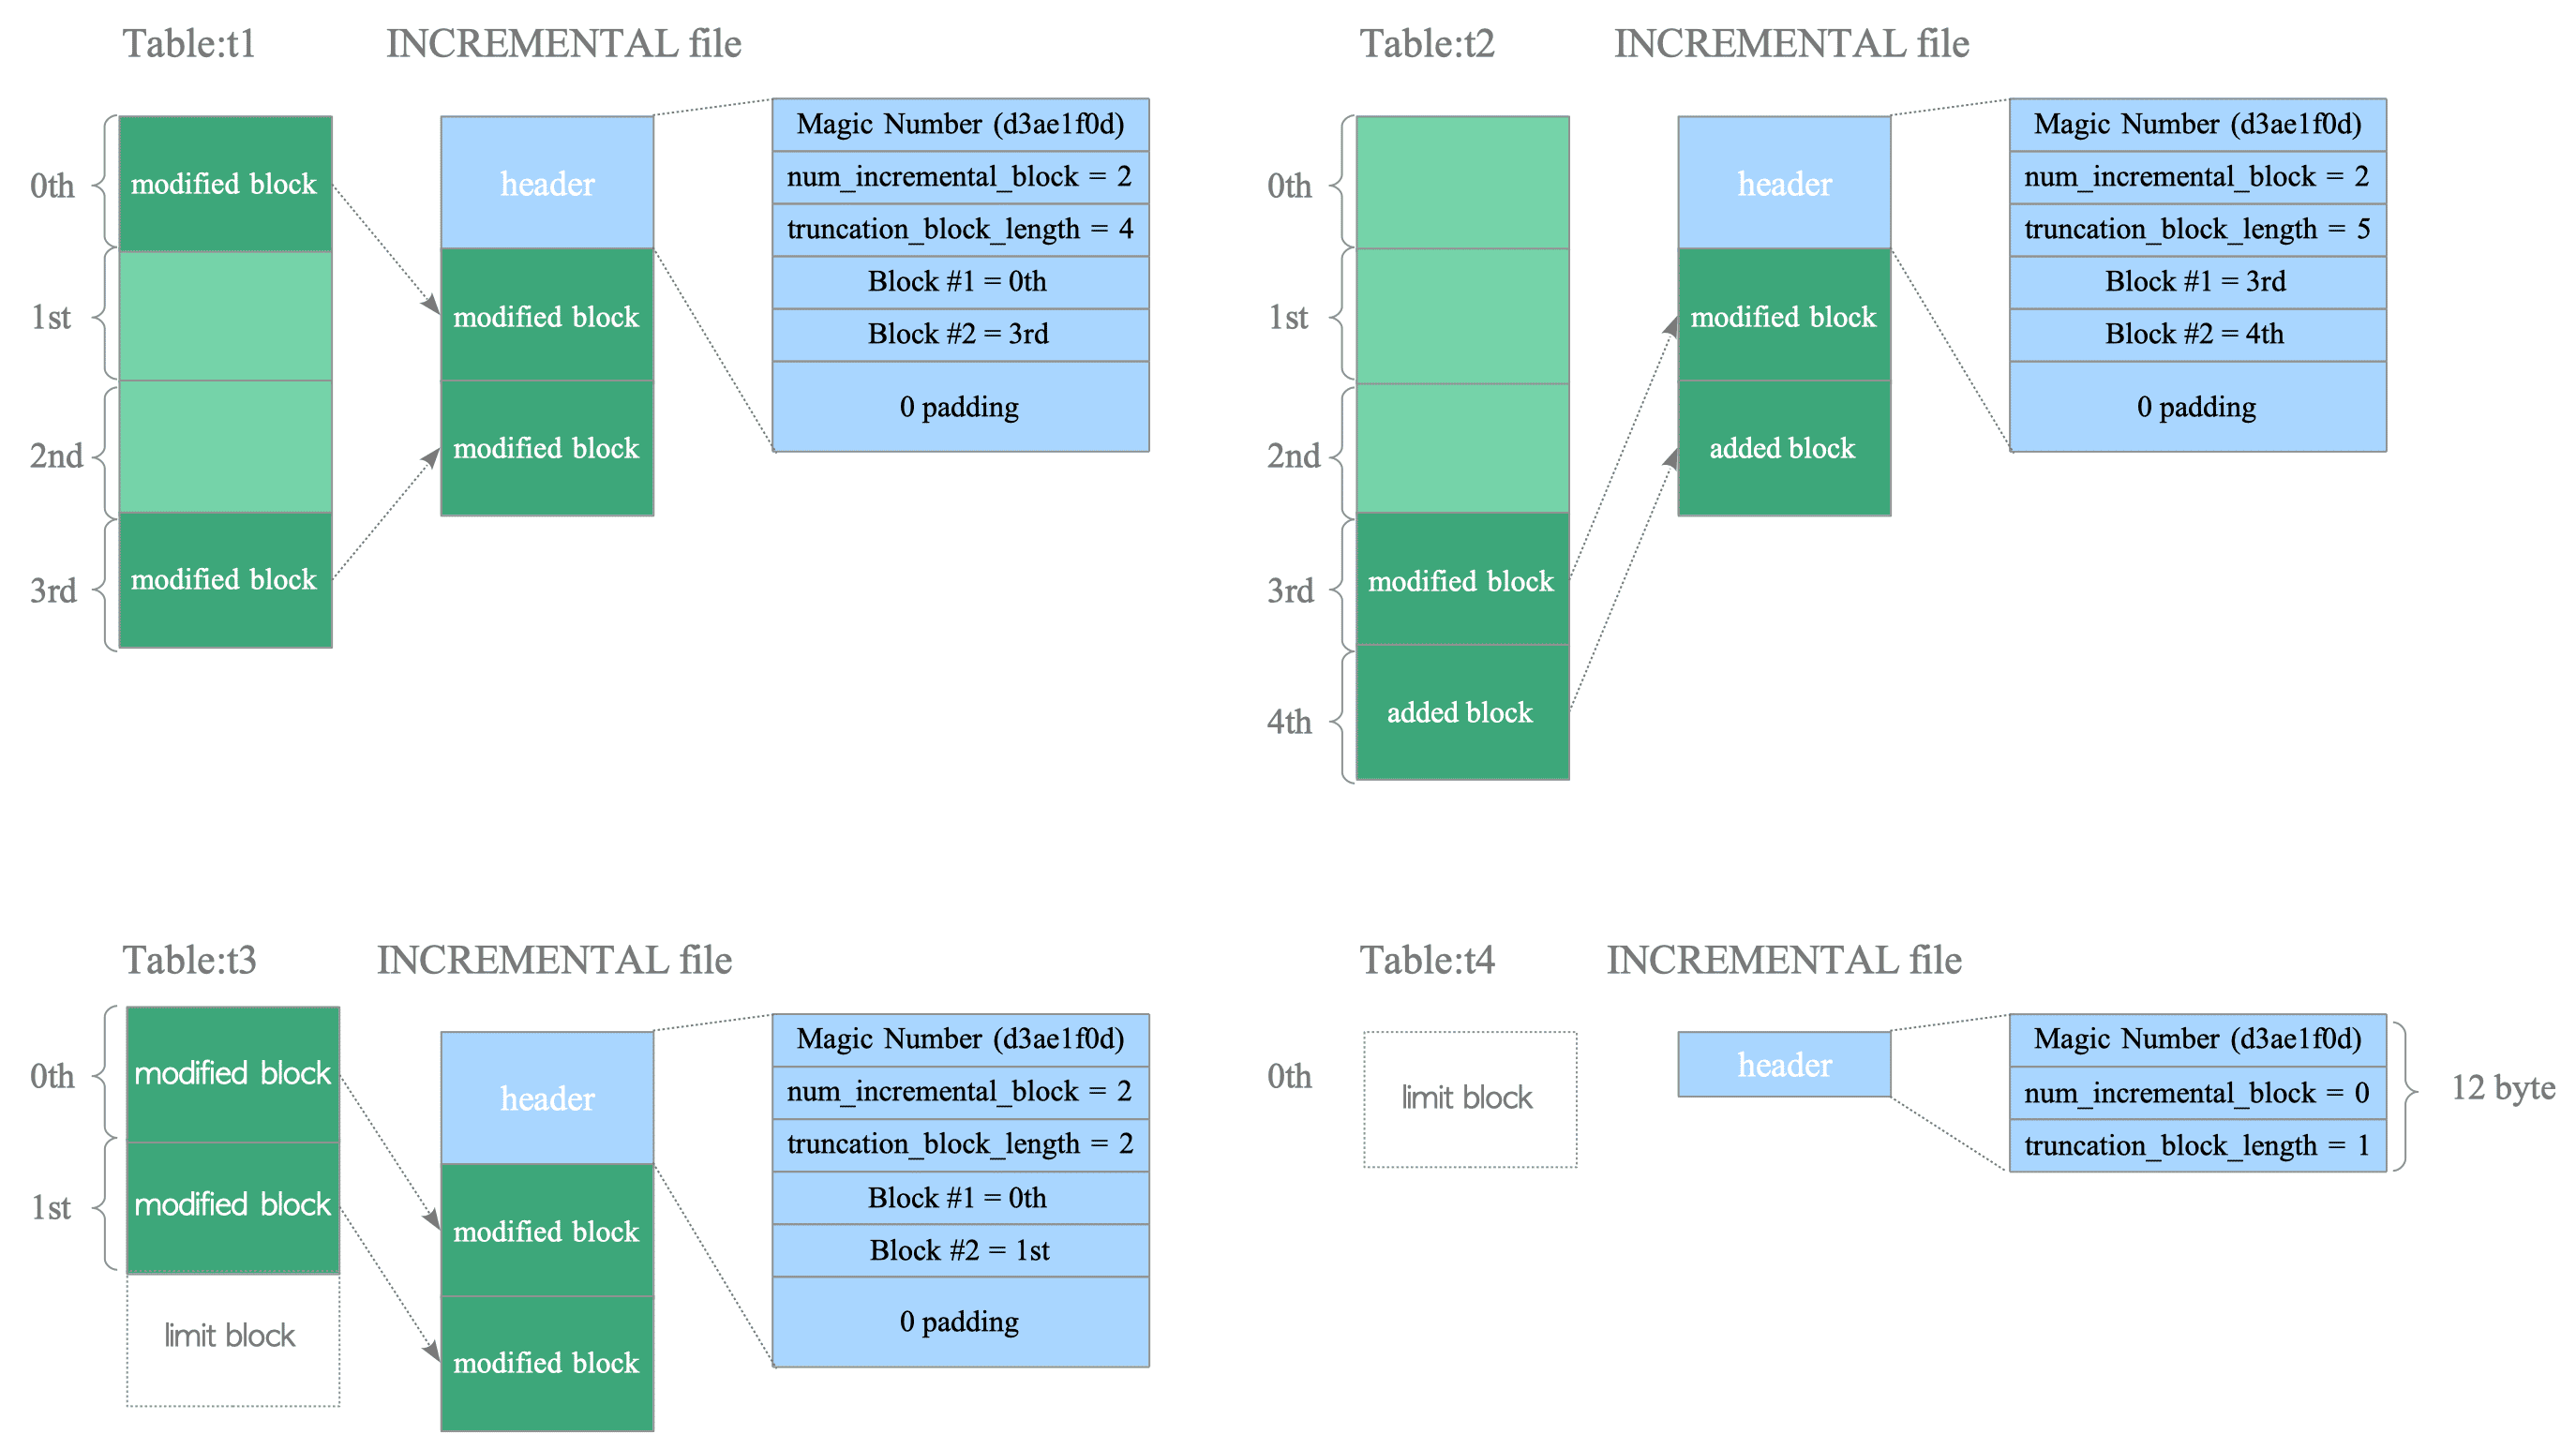
一个INCREMENTAL文件通常由一个首部块和若干变更块组成,每个块的大小都是8 KB。
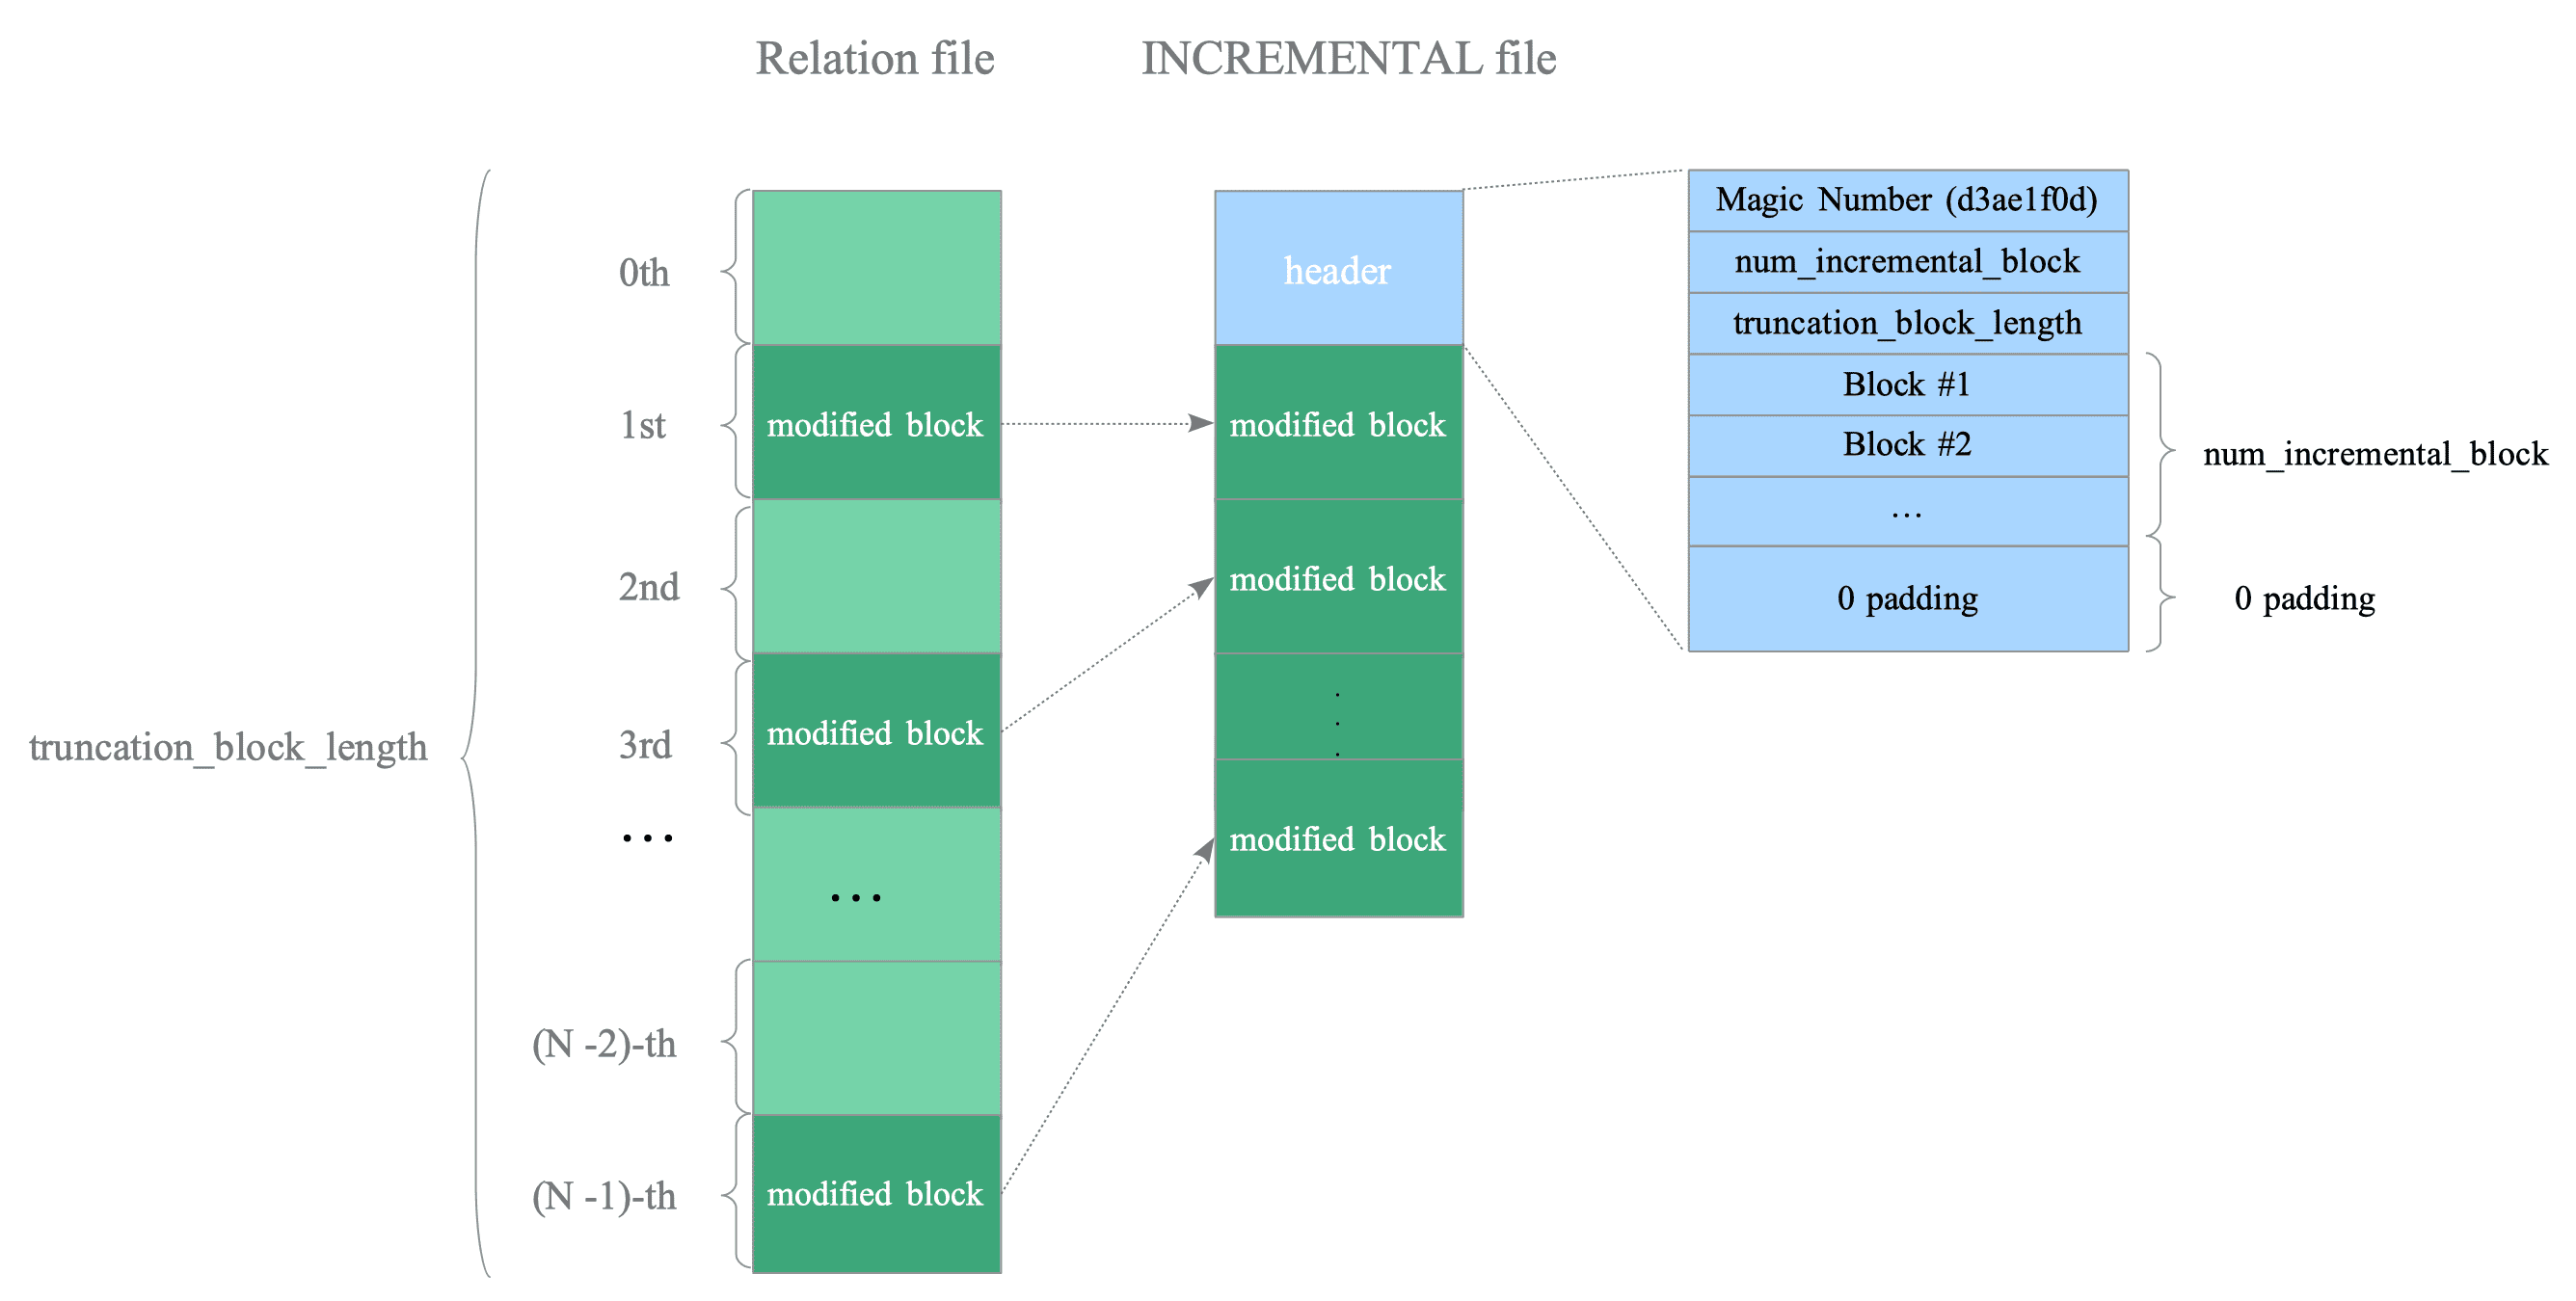
首部块包含四类信息:
- 魔数(Magic Number): 首部以
0xd3ae1f0d开头,用于标识这是一个增量备份文件。 num_incremental_block: 变更块的数量。truncation_block_length: 该值通常表示此文件所对应表或可见性映射的当前块数;如果WAL汇总信息记录了更靠后的边界块,它也可能大于文件的当前块数,详情参见源代码。- 变更块编号列表: 保存发生过变化的块编号。例如,如果第0号块和第3号块发生了变化,这里就会记录
0和3。
首部块通常为8 KB,或者是8 KB的整数倍。PostgreSQL会在块编号列表之后补零,使首部保持8 KB对齐;如果列表超过8 KB,则会增加额外的首部块。
如果一张表被截断、删除或没有发生变化,增量文件可能不需要携带任何变更块。此时num_incremental_block为0,整个INCREMENTAL文件只有12字节,只包含魔数、num_incremental_block和truncation_block_length三个字段;truncation_block_length记录重构后文件的截断边界,在图10.11的表t4示例中其值为1。
图10.11展示了四种INCREMENTAL文件的例子,对应的WAL汇总文件内容详见第9.6.2.2节。