11 流复制
PostgreSQL在9.1版本中实现了流复制。它属于所谓的一主多从类型的复制,而这两个术语 —— 主(master)和从(slave),在PostgreSQL中通常分别被称为主(primary)和备(standby)。
译注:存储数据库副本的每个节点称为副本(replica)。每一次对数据库的写入操作都需要传播到所有副本上,否则副本就会包含不一样的数据。最常见的解决方案被称为基于领导者的复制(leader-based replication),也称主动/被动(active/passive) 或 主/从(master/slave)复制。其中,副本之一被指定为领导者(leader),也称为 主库(master)、首要(primary)。当客户端要向数据库写入时,它必须将请求发送给领导者,领导者会将新数据写入其本地存储。其他副本被称为追随者(followers),亦称为只读副本(read replicas)、从库(slaves)、次要(secondaries)或热备(hot standby)。
这种原生复制功能是基于日志传输实现的,这是一种通用的复制技术:主库不断发送WAL数据,而每个备库接受WAL数据,并立即重放日志。
本章将介绍以下主题,重点介绍流复制的工作原理:
- 流复制是如何启动的
- 数据是如何在主备之间传递的
- 主库如何管理多个备库
- 主库如何检测到备库的失效
- 复制槽如何保留流复制所需的WAL
尽管在9.0版本中最初实现的复制功能只能进行异步复制,它很快就在9.1版中被新的实现(如今采用的)所替代,可以支持同步复制。
11.1 流复制的启动
在流复制中,有三种进程协同工作。首先,主库上的walsender(WAL发送器)进程将WAL数据发送到备库;同时,备库上的walreceiver(WAL接收器)在接收这些数据,而备库上的startup进程可以重放这些数据。 其中walsender和walreceiver 之间使用单条TCP连接进行通信。
在本节中,我们将探讨流复制的启动顺序,以了解这些进程如何启动并且它们之间是如何建立连接的。图11.1显示了流复制的启动顺序图:
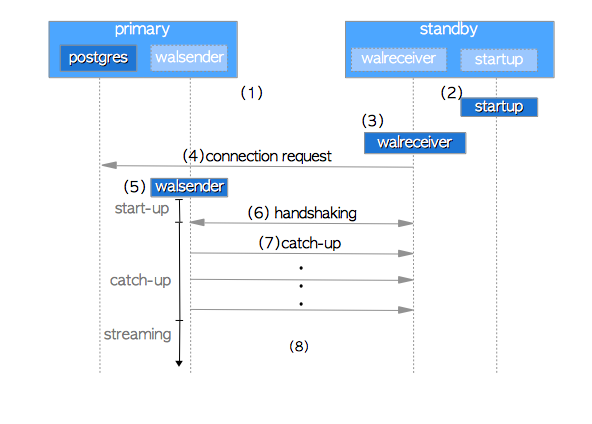
- 启动主库服务器和备库服务器。
- 备库服务器启动一个startup进程。
- 备库服务器启动一个walreceiver进程。
- walreceiver向主库服务器发送连接请求。如果主库尚未启动,walreceiver会定期重发该请求。
- 当主库服务器收到连接请求时,将启动walsender进程,并建立walsender和walreceiver之间的TCP连接。
- walreceiver发送备库数据库集簇上最新的LSN。在IT领域中通常将该阶段称作握手(handshaking)。
- 如果备库最新的LSN小于主库最新的LSN(备库的LSN < 主库的LSN),则walsender会将前一个LSN到后一个LSN之间的WAL数据发送到walreceiver。这些WAL数据由存储在主库
pg_xlog子目录(版本号为10+的更名为pg_wal)中的WAL段提供。最终,备库重放接收到的WAL数据。在这一阶段,备库在追赶主库,因此被称为 追赶(catch-up) 阶段。 - 最终,流复制开始工作。
每个walsender进程都维护了连接上的walreceiver或其他应用程序的复制进度状态(请注意,不是连接到walsender的walreceiver或应用程序的本身的状态)。如下是其可能的状态:
- 启动(start-up) —— 从启动walsender到握手结束。如图11.1(5)-(6)。
- 追赶(catch-up) —— 处于追赶期间,如图11.1(7)。
- 流复制(streaming)—— 正在运行流复制。如图11.1(8)。
- 备份(backup)—— 处于向
pg_basebackup等备份工具发送整个数据库集簇文件的过程中。
系统视图pg_stat_replication显示了所有正在运行的walsenders的状态,如下例所示:
如上结果所示,有两个walsender正在运行,其正在向连接的备库发送WAL数据,另一个walsender在向pg_basebackup应用发送所有数据库集簇中的文件。
在备库长时间停机后,如果重启会发生什么?
在9.3版及更早版本中,如果备库所需的WAL段在主库上已经被回收了,备库就无法追上主库了。这一问题并没有可靠的解决方案,只能为参数
wal_keep_segments配置一个较大的值,以减少这种情况发生的可能性,但这只是权宜之计。在9.4及后续版本中,可以使用 复制槽(replication slot) 来预防此问题发生。复制槽是一项提高WAL数据发送灵活性的功能,主要是为 逻辑复制(logical replication) 而提出的,同时也能解决这类问题——复制槽通过暂停回收过程,从而保留
pg_xlog(10及后续版本的pg_wal)中含有未发送数据的WAL段文件,详情请参阅官方文档。
11.2 如何实施流复制
流复制有两个方面:日志传输和数据库同步。因为流复制基于日志,日志传送显然是其中的一个方面 —— 主库会在写入日志记录时,将WAL数据发送到连接的备库。同步复制中需要数据库同步 —— 主库与多个备库通信,从而同步整个数据库集簇。
为准确理解流复制的工作原理,我们应该探究下主库如何管理多个备库。为了尽可能简化问题,本节描述了一个特例(即单主单备系统),而下一节将描述一般情况(单主多备系统)。
11.2.1 主从间的通信
假设备库处于同步复制模式,但配置参数hot_standby已禁用,且wal_level为'archive'。主库的主要参数如下所示:
另外,在9.5节中提到,有三个情况触发写WAL数据,这里我们只关注事务提交。
假设主库上的一个后端进程在自动提交模式下发出一个简单的INSERT语句。后端启动事务,发出INSERT语句,然后立即提交事务。让我们进一步探讨此提交操作如何完成的。如图11.2中的序列图:
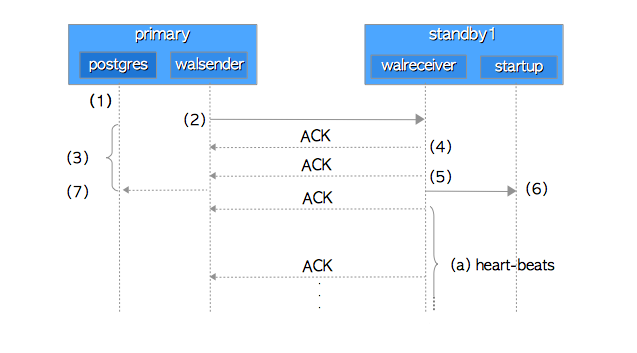
- 后端进程通过执行函数
XLogInsert()和XLogFlush(),将WAL数据写入并刷新到WAL段文件中。 - walsender进程将写入WAL段文件的WAL数据发送到walreceiver进程。
- 在发送WAL数据之后,后端进程继续等待来自备库的ACK响应。更确切地说,后端进程通过执行内部函数
SyncRepWaitForLSN()来获取锁存器(latch),并等待它被释放。 - 备库上的walreceiver通过
write()系统调用,将接收到的WAL数据写入备库的WAL段,并向walsender返回ACK响应。 - walreceiver通过系统调用(例如
fsync())将WAL数据刷新到WAL段中,向walsender返回另一个ACK响应,并通知 启动进程(startup process ) 相关WAL数据的更新。 - 启动进程重放已写入WAL段的WAL数据。
- walsender在收到来自walreceiver的ACK响应后释放后端进程的锁存器,然后,后端进程完成
commit或abort动作。 锁存器释放的时间取决于参数synchronous_commit。如果它是'on'(默认),当接收到步骤(5)的ACK时,锁存器被释放。而当它是'remote_write'时,接收到步骤(4)的ACK时,即被释放。
如果配置参数
wal_level是'hot_standby'或'logical',则PostgreSQL会根据COMMIT或ABORT操作的记录,写入热备功能相关的WAL记录。(在这个例子中,PostgreSQL不写那些记录,因为它是'archive'。)
每个ACK响应将备库的内部信息通知给主库。包含以下四个项目:
- 已写入最新WAL数据的LSN位置。
- 已刷新最新WAL数据的LSN位置。
- 启动进程已经重放最新的WAL数据的LSN。
- 发送此响应的时间戳。
walreceiver不仅在写入和刷新WAL数据时返回ACK响应,而且还定期发送备库的心跳响应。因此,主库始终掌握所有连接备库的状态。
执行如下查询,可以显示所连接备库的相关LSN信息。
心跳的间隔设置为参数
wal_receiver_status_interval,默认为10秒。
11.2.2 备库故障检测
流复制使用两种常见的故障检测过程,不需要任何特殊硬件。
- 备库服务器失效: 当检测到walsender与walreceiver之间的连接断开,或者底层网络函数无法读写walreceiver套接字并返回错误时,主库会立即判定备库或walreceiver失效。
- 硬件或网络失效: 如果walreceiver在
wal_sender_timeout所规定的时间内没有返回任何结果,主库就会判定备库失效。默认超时为60秒,因此从故障发生到被确认之间最多可能存在这一长度的延迟。
取决于故障类型,有些故障能够立即发现,有些则存在检测延迟。如果同步备库发生后一类故障,即使还有多个潜在备库正常工作,主库也会在确认故障前暂停事务处理。
PostgreSQL 9.2及更早版本中,
wal_sender_timeout参数名为replication_timeout。
11.2.3 发生故障时的行为
在本小节中,将介绍在同步备库发生故障时,主库的行为方式,以及主库会如何处理该情况。
即使同步备库发生故障,且不再能够返回ACK响应,主库也会继续等待响应。因此,正在运行的事务无法提交,而后续查询也无法启动。换而言之,实际上主库的所有操作都已停止(流复制不支持发生超时时自动降级回滚到异步模式的功能)。
有两种方法可以避免这种情况。其中之一是使用多个备库来提高系统可用性,另一个是通过手动执行以下步骤从同步模式切换到异步模式。
-
将参数
synchronous_standby_names的值设置为空字符串。 -
使用
reload选项执行pg_ctl命令。
上述过程不会影响连接的客户端。主库继续事务处理,以及会保持客户端与相应的后端进程之间的所有会话。
11.2.4 备库查询与WAL重放冲突
备库可以独立执行SELECT,但某些主库操作产生的WAL与备库查询之间会发生冲突。例如,主库删除一张备库正在读取的表。
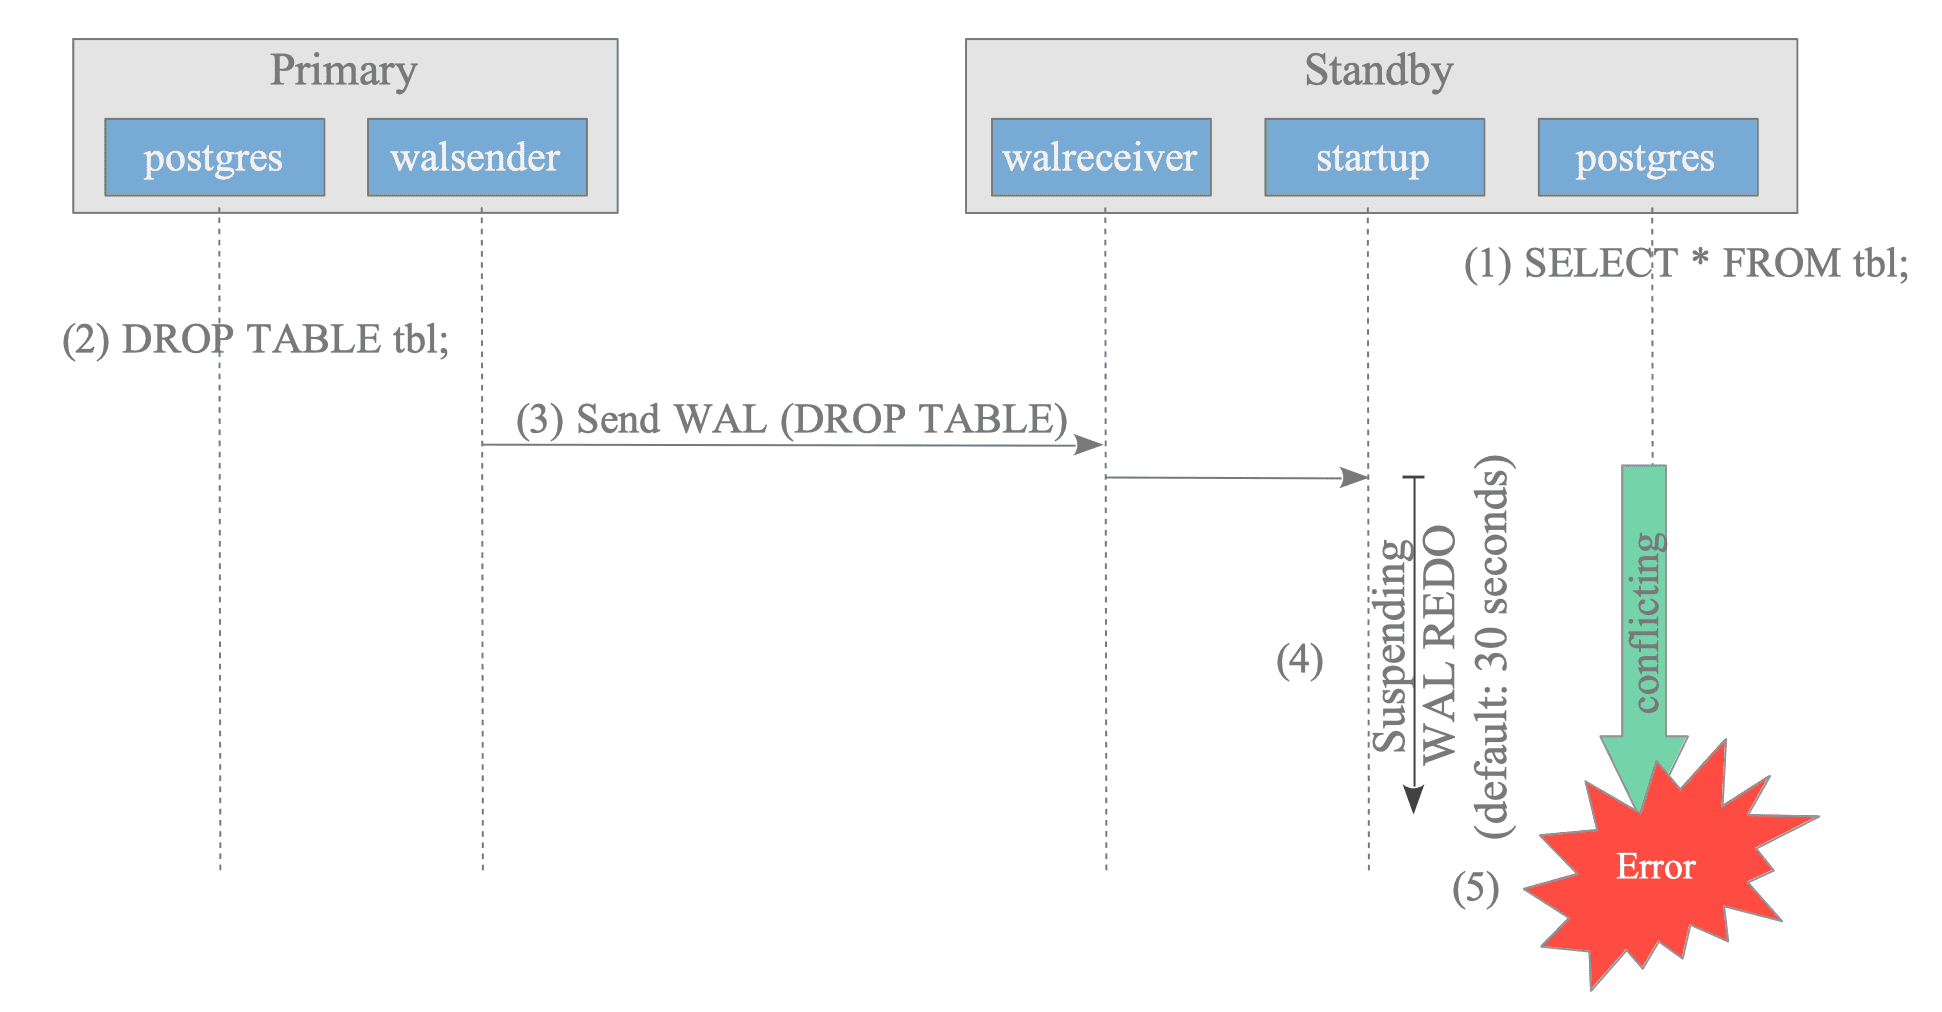
-
备库正在查询一张表。
-
主库执行
DROP TABLE并发送相关WAL。 -
备库暂缓重放,默认最多等待30秒,由
max_standby_archive_delay或max_standby_streaming_delay配置。 -
指定时间内查询仍未结束,就取消查询并返回:
冲突来自主库DROP TABLE获取AccessExclusiveLock时生成的WAL。恢复冲突主要包括三类:主库上的访问独占锁;删除数据库或表空间;重放VACUUM清理记录时,备库事务仍能看到将被删除的行,或仍在访问相应页面。
11.2.4.1 缓解锁冲突
提高max_standby_archive_delay和max_standby_streaming_delay可以让备库延迟WAL重放,降低查询被取消的概率,但不能彻底消除冲突;等待期间其他备库会话也看不到最新数据,因此需要在查询可用性与复制延迟之间权衡。
11.2.4.2 避免VACUUM冲突
在主库开启hot_standby_feedback,可以根据备库反馈延迟删除备库仍需要的旧行版本。反馈间隔由wal_receiver_status_interval控制,默认10秒。
代价是主库无法及时清理旧元组,可能增加表与索引膨胀及WAL使用。备库可通过pg_stat_database_conflicts查看冲突类型与次数。
11.3 管理多个备库
本节描述了存在多个备库时,流复制是如何工作的。
11.3.1 同步优先级与同步状态
主库为自己管理的每一个备库指定一个同步优先级(sync_priority) 与 同步状态(sync_state)。(上一节并没有提到这一点,即使主库只管理一个备库,也会指定这些值。)
同步优先级(sync_priority) 表示备库在同步模式下的优先级,它是一个固定值。较小的值表示较高的优先级,而0是一个特殊值,表示“异步模式”。备库优先级是一个有序列表,在主库配置参数 synchronous_standby_names中依序给出。例如在以下配置中,standby1和standby2的优先级分别为1和2。
(未列于此参数中的备库处于异步模式,优先级为0)
同步状态(sync_state) 是备库的状态,它因所有在列备库的运行状态及其优先级而异,以下是可能的状态:
- 同步(Sync) 状态的备库,是所有正在工作中的备库中,具有最高优先级的同步备库的状态(异步模式除外)。
- 潜在(Potential) 状态的备库,是所有工作备库(异步备库除外)中,优先级等于或低于2的闲置同步备库。如果同步备库失效,潜在备库中有着最高优先级的那个将替换为同步备库。
- 异步(Async) 状态的备库是固定的。主库以与潜在备库相同的方式处理异步备库,只是它们的
sync_state永远不会是sync或potential。
执行以下查询来显示备库的优先级和状态:
最近有几个开发者尝试实现“多个同步备库”。详情参见此处。
11.3.2 主库如何管理多个备库
主库仅等待来自同步备库的ACK响应。换句话说,主库仅确保同步备库写入并刷新WAL数据。因此在流复制中,只有同步备库的状态是与主库始终一致且同步的。
图11.3展示了潜在备库的ACK响应早于首要备库ACK响应的情况。这时主库并不会完成当前事务的COMMIT操作,而是继续等待首要备库的ACK响应。而当收到首要备库的响应时,后端进程释放锁存器并完成当前事务的处理。
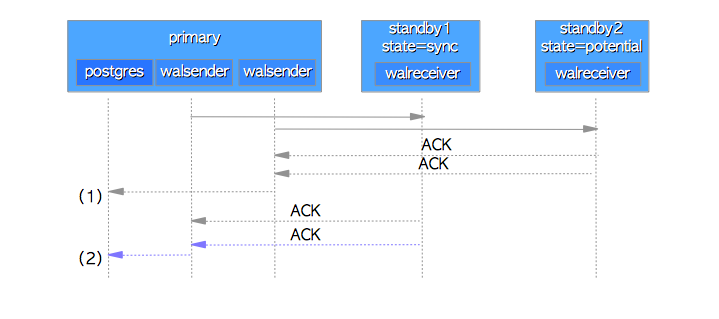
备库1与备库2的同步状态分别为
sync和potential。
- 尽管从潜在备库接收到ACK响应,但主库的后端进程会继续等待来自同步备库的ACK响应。
- 主库的后端进程释放锁存器,完成当前的事务处理。
在相反的情况下(即首要从库的ACK响应返回早于潜在从库的响应),主库会立即完成当前事务的COMMIT操作,而不会去确认潜在从库是否已经写入和刷盘了WAL数据。
11.3.2.1 基于法定人数的同步复制
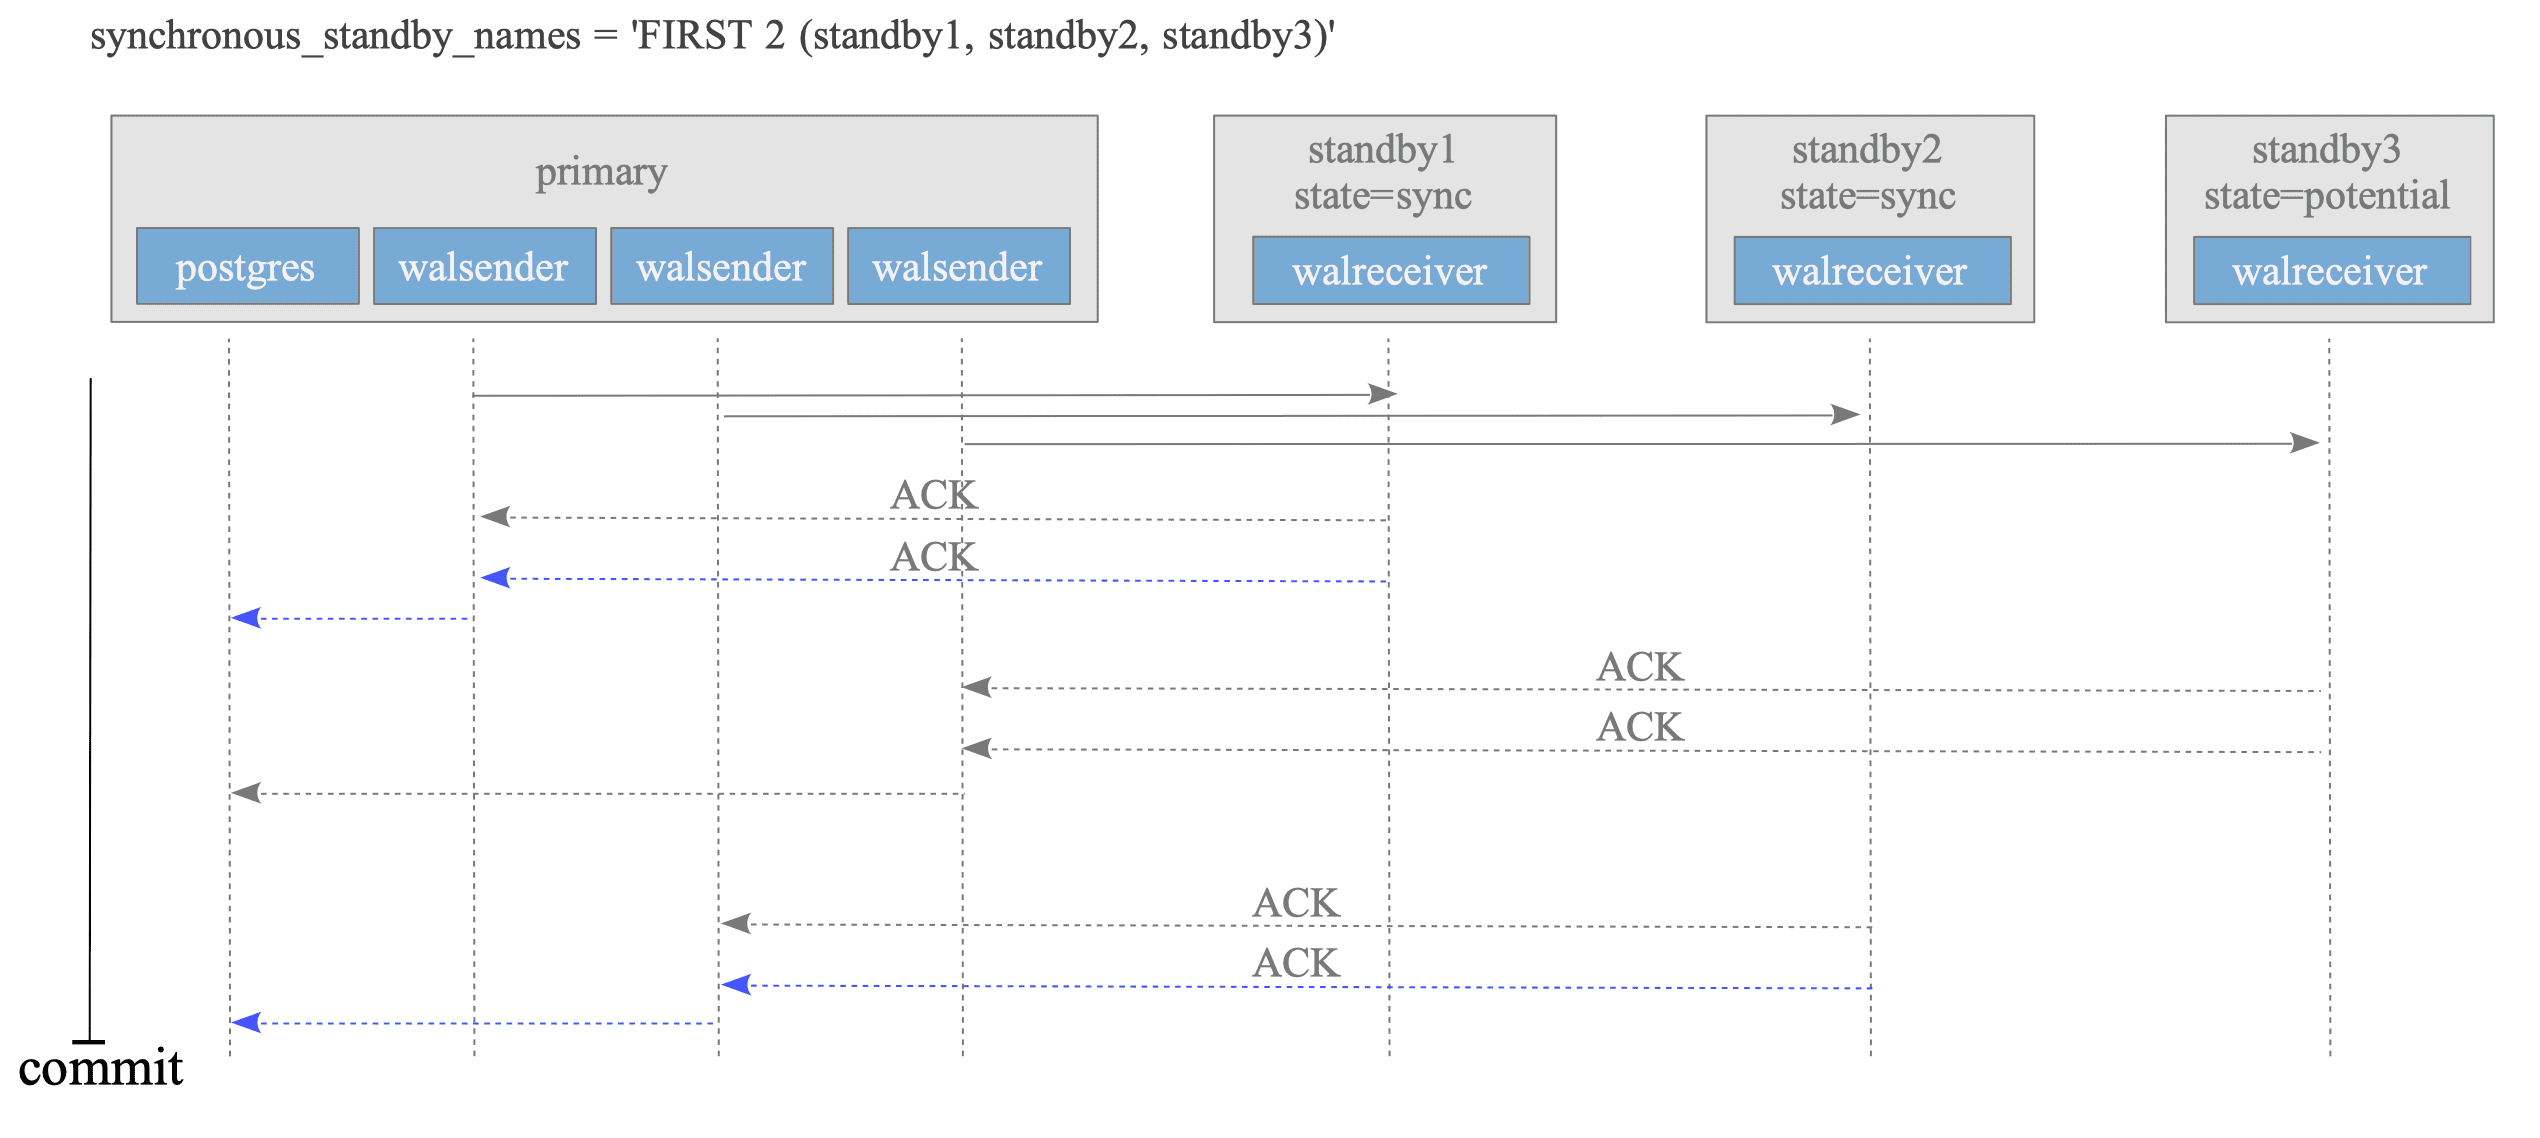
PostgreSQL 9.6开始支持同时等待多个按优先级选择的同步备库;PostgreSQL 10进一步加入ANY关键字,形成真正不依赖列表顺序的法定人数(quorum)提交。当前语法分为ANY与FIRST两种模式。
ANY模式
列表中任意num_sync个备库返回ACK后即可提交。例如:
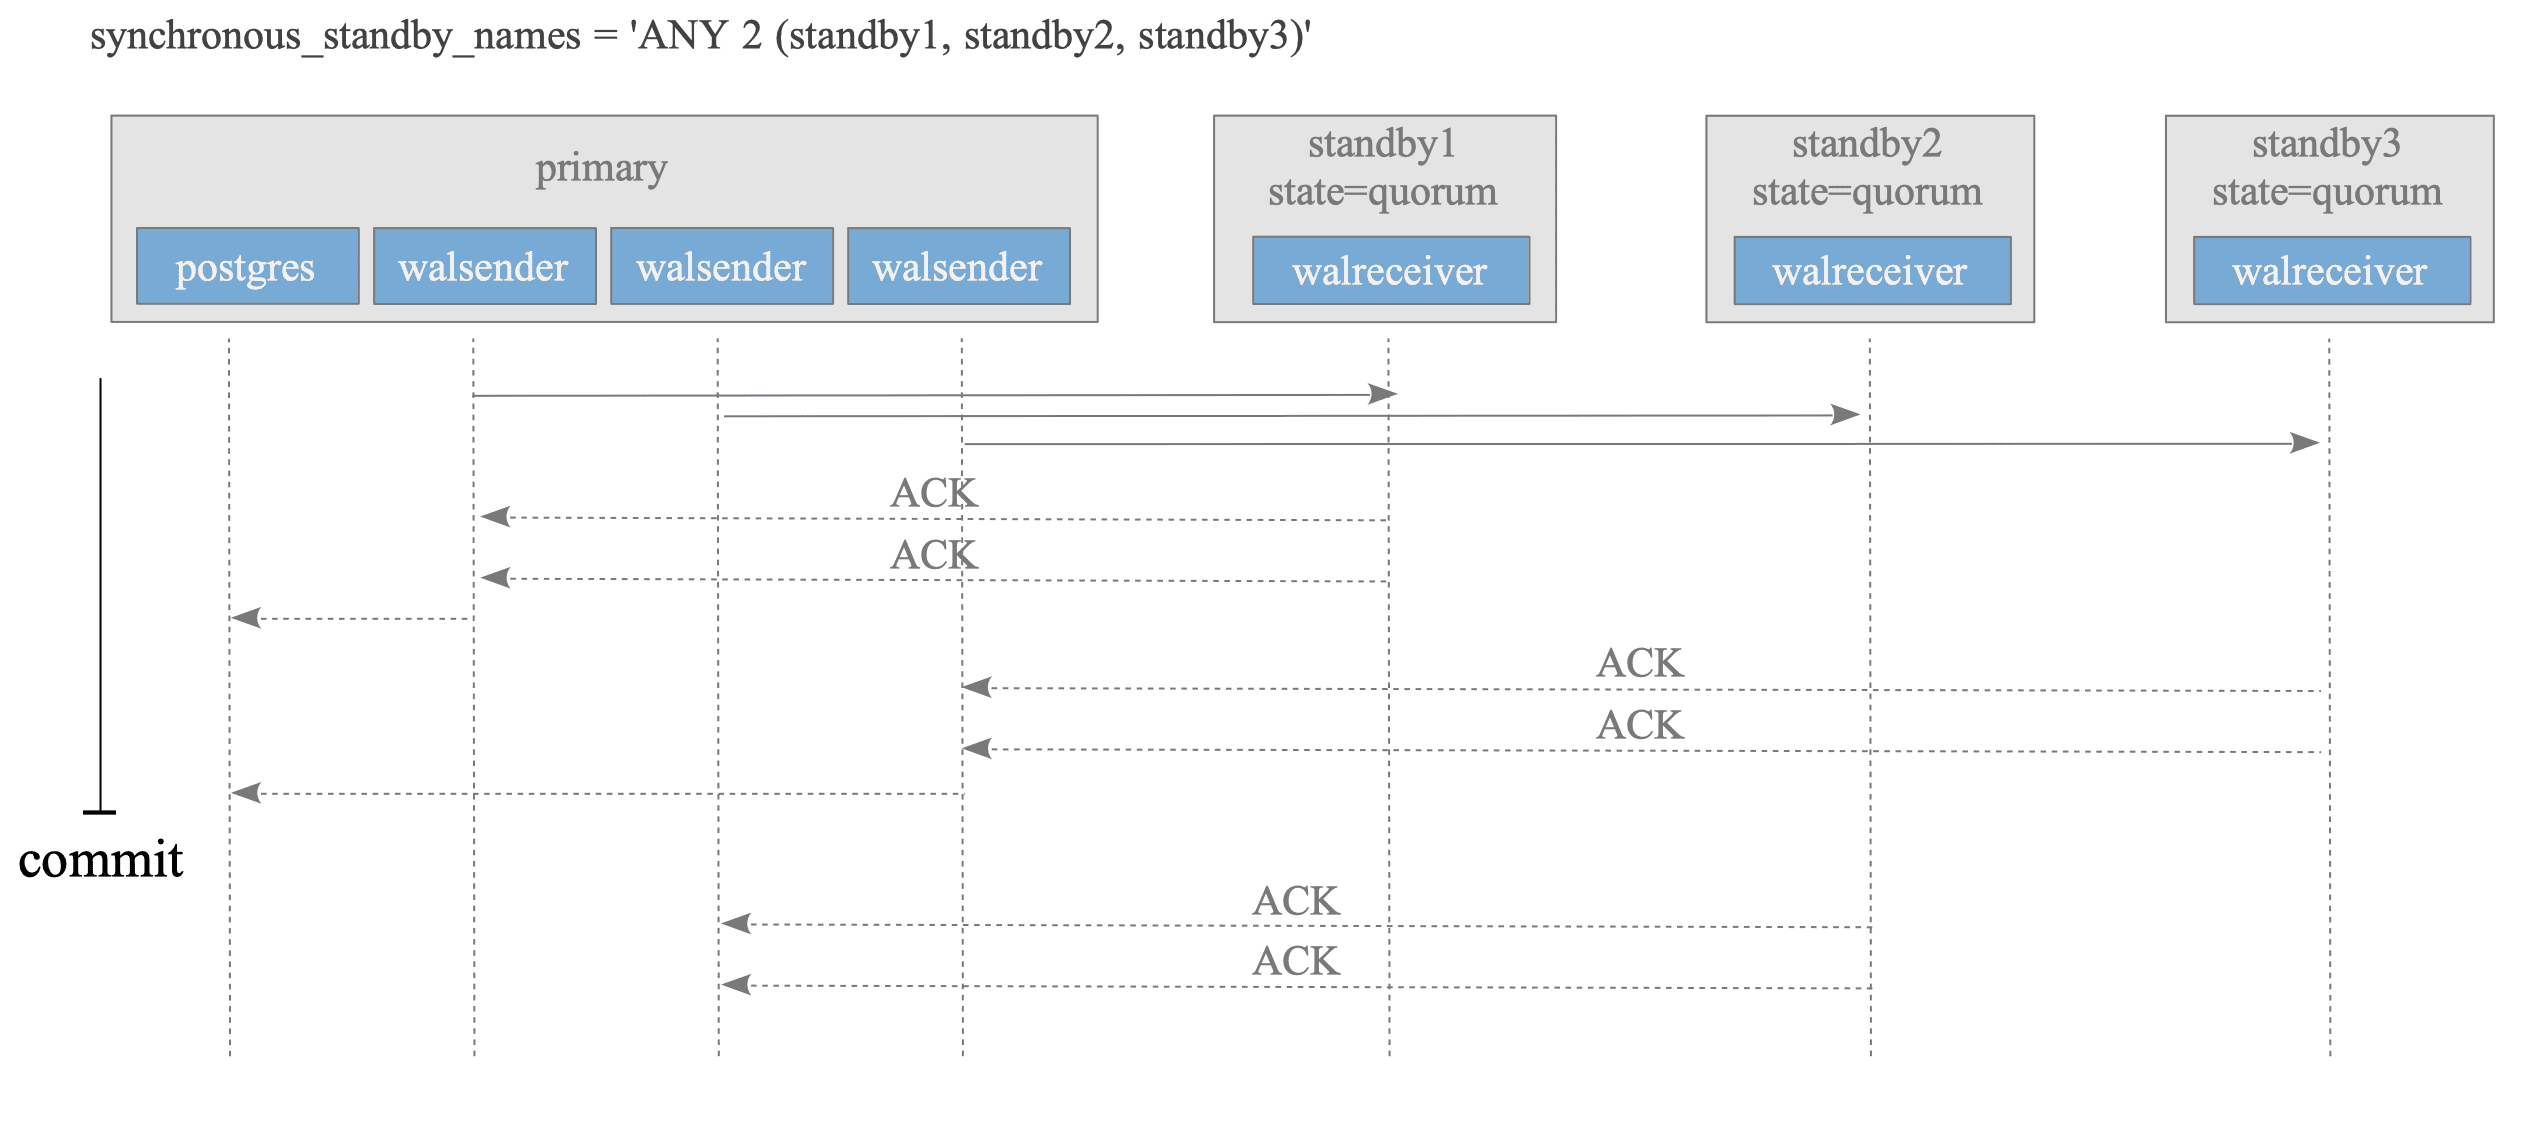
这些备库的sync_state均为quorum,sync_priority相同。
FIRST模式
主库等待列表中优先级最高的前num_sync个备库。例如:
即使standby3先返回,主库仍要等待standby1和standby2。
11.3.3 发生故障时的行为
我们再来看看当从库发生故障时主库的表现。
当潜在或异步备库发生故障时,主库会终止连接到故障备库的walsender进程,并继续进行所有处理。换而言之,主库上的事务处理不会受到这两种备库的影响。
当同步备库发生故障时,主库将终止连接到故障备库的walsender进程,并使用具有最高优先级的潜在备库替换首要同步备库,如图11.4。与上述的故障相反,主库将会暂停从失效点到成功替换同步备库之间的查询处理。(因此备库的故障检测对于提高复制系统可用性至关重要,故障检测将在下一节介绍)
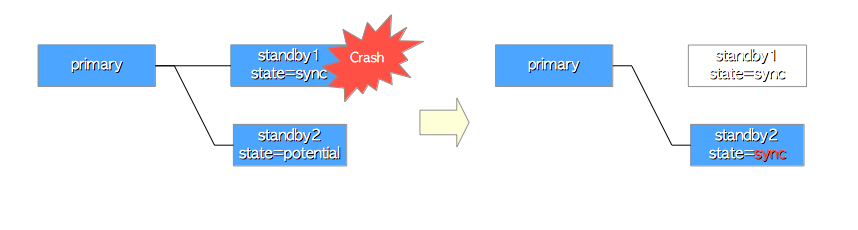
在任何情况下,如果一个或多个备库在同步模式下运行,主库始终只会保留一个同步备库,而同步备库始终与主库保持一致且同步的状态。
11.4 复制槽
如第11.1节所述,PostgreSQL 9.4引入的**复制槽(replication slot)**可以确保复制完成之前,仍然需要的WAL段和旧元组版本不会被清理。本节介绍复制槽在物理流复制中的机制;复制槽也是逻辑复制的基础,但逻辑场景将在第12章讨论。
11.4.1 复制槽在流复制中的优势
流复制并不强制要求复制槽,但与只使用wal_keep_size相比,它有两个优势:
- 保证所需WAL段不丢失: 复制槽跟踪备库仍然需要的WAL并阻止其被删除。只配置
wal_keep_size时,如果备库长时间未读取,PostgreSQL仍可能删除它后来需要的段。 - 只保留最低必要数量: 复制槽让
pg_wal只保留确实需要的段,并删除无用段;wal_keep_size则无论是否需要,都固定保留指定容量。
max_slot_wal_keep_size: 复制槽可能无限期保留WAL,最坏情况下会耗尽存储空间。PostgreSQL 13增加了max_slot_wal_keep_size,限制检查点时复制槽允许在pg_wal中保留的最大WAL容量。它与wal_keep_size的区别在于:前者是“按需保留,但设置上限”,后者是“无论是否需要,固定保留”。
11.4.2 复制槽相关进程与文件
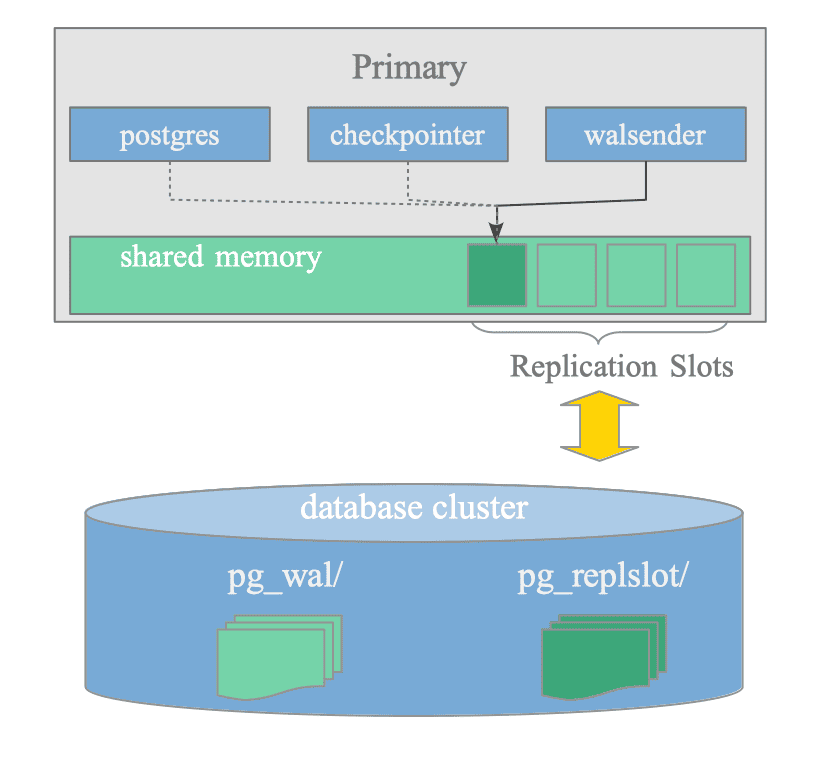
复制槽存放在共享内存中分配的区域。图11.8展示了复制槽及相关进程和文件。
11.4.2.1 相关进程
- walsender: 持续更新对应复制槽,使其反映备库当前接收WAL的进度。
- 检查点后台进程: 在检查点期间读取复制槽,以判断哪些WAL段可以删除。
- postgres后端: 通过系统视图
pg_replication_slots显示槽信息。
11.4.2.2 相关文件
pg_replslot目录下的状态文件: walsender定期把复制槽的持久状态保存到这里。服务器重启时,PostgreSQL重新把这些信息载入内存,恢复复制槽状态。pg_wal目录下的WAL段文件。
11.4.3 数据结构
复制槽由slot.h中的ReplicationSlot结构定义。该结构同时服务物理复制与逻辑复制,和物理流复制最相关的字段可以简化为:
active_pid: 当前管理该槽的walsender PID。data:ReplicationSlotPersistentData定义的持久数据,其中最重要的是槽名name和restart_lsn。restart_lsn是该槽未来仍可能需要的最老LSN;检查点进程会读取所有槽中最小的restart_lsn,据此决定哪些WAL段不能删除。
持久数据会定期写入pg_replslot目录,其主要结构如下:
物理复制槽的database为InvalidOid,逻辑复制槽则保存所属数据库OID。confirmed_flush、plugin、two_phase和failover等字段主要用于逻辑复制。
11.4.4 启用复制槽
图11.9展示了启用物理复制槽的顺序。
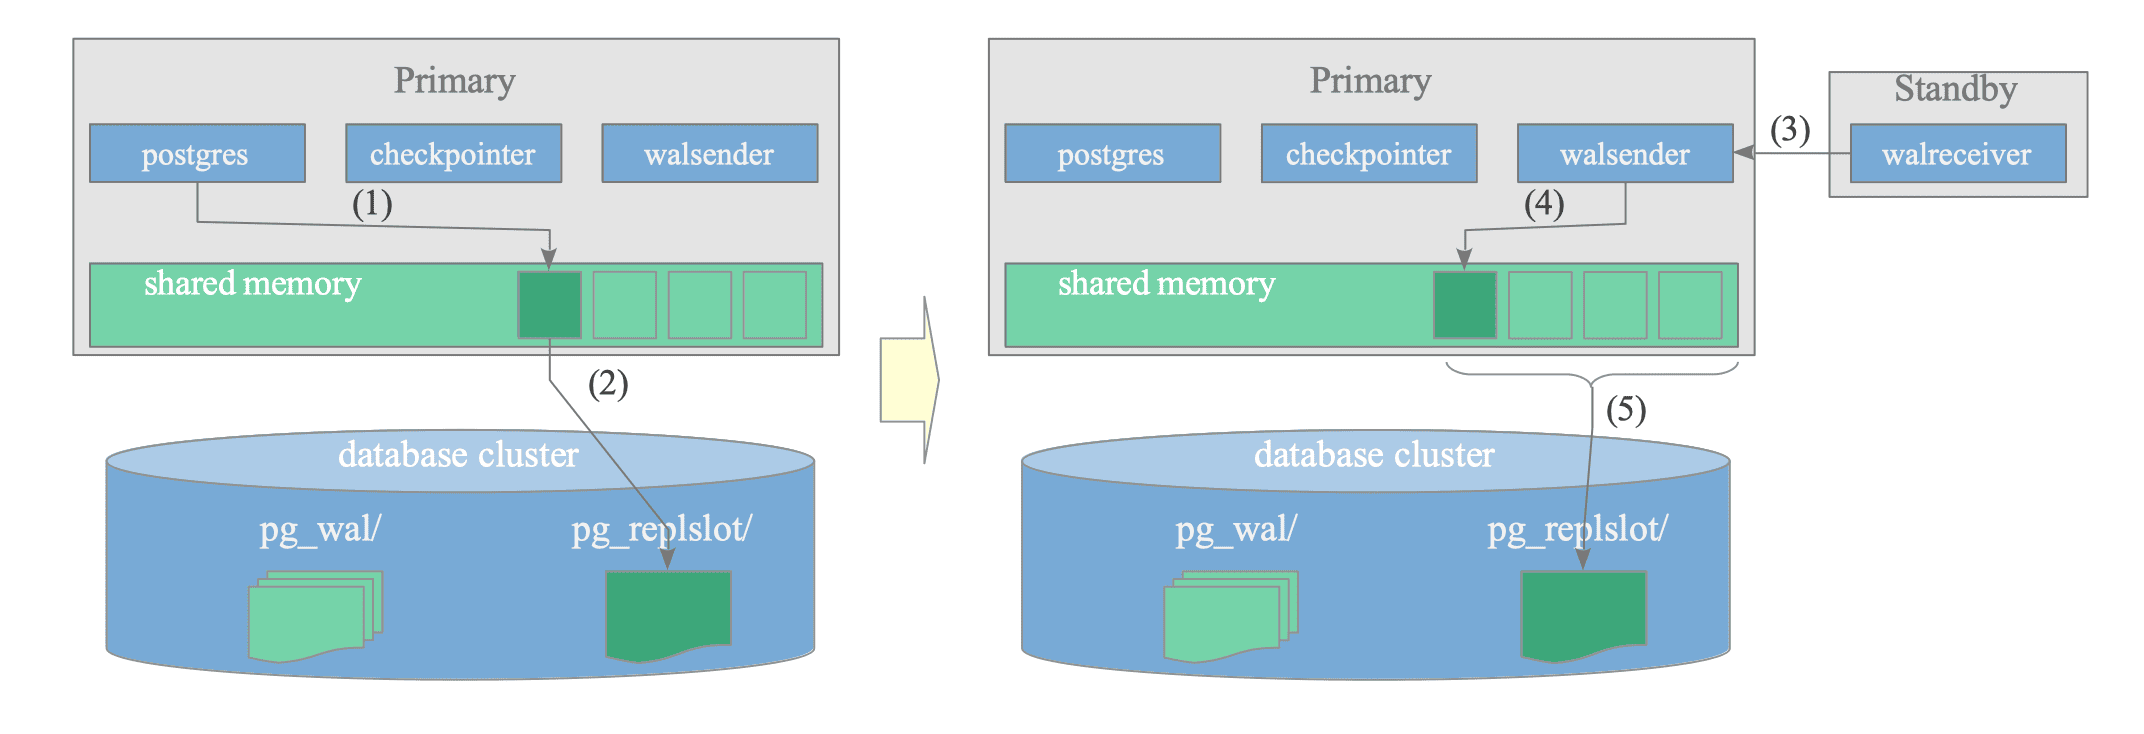
-
使用
pg_create_physical_replication_slot()创建物理复制槽。除槽名外,其他数据先使用默认值: -
PostgreSQL把
ReplicationSlotPersistentData中的持久部分写入pg_replslot。槽名对应一个子目录,状态保存在其中的state文件: -
让备库重新连接主库,并把
primary_slot_name设为该槽名:然后重新加载配置:
-
连接建立后,walsender更新
active_pid、restart_lsn等复制槽字段。 -
更新后的持久状态再次写入
pg_replslot。
11.4.5 管理复制槽
复制槽建立在共享内存中后,walsender会持续更新它,使其反映对应备库的当前状态。可以使用pg_replication_slots查看:
主库会定期把复制槽详情保存到pg_replslot下的state文件。主库重启时,再从这些文件恢复内存中的复制槽状态。